Os jobs em lote no Realtime Compute for Apache Flink têm mecânicas de execução diferentes dos jobs de streaming, com alocação de recursos, transmissão de dados e recuperação de falhas distintas. Este guia explica essas diferenças e mostra como configurar recursos e paralelismo para obter o melhor desempenho dos seus jobs em lote.
O Realtime Compute for Apache Flink oferece suporte ao processamento em lote no desenvolvimento de rascunhos, O&M de jobs, workflows, gerenciamento de filas e perfilamento de dados. Para um tutorial completo de ponta a ponta, consulte Introdução rápida ao processamento em lote .
Diferenças entre jobs em lote e jobs de streaming
Compreender essas diferenças ajuda a configurar jobs em lote corretamente e evitar armadilhas comuns.
Modo de execução
Jobs de streaming processam fluxos de dados contínuos e ilimitados com baixa latência. Os dados fluem entre operadores no modo pipeline; assim, todas as subtarefas de todos os operadores são implantadas e executadas simultaneamente.
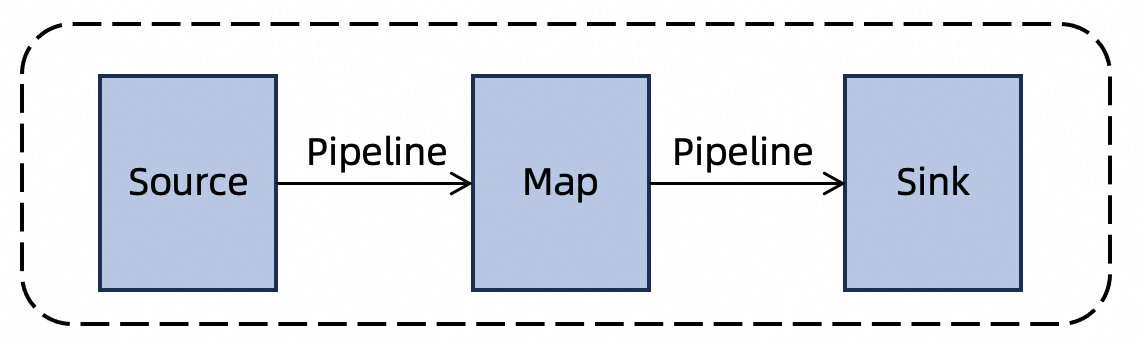
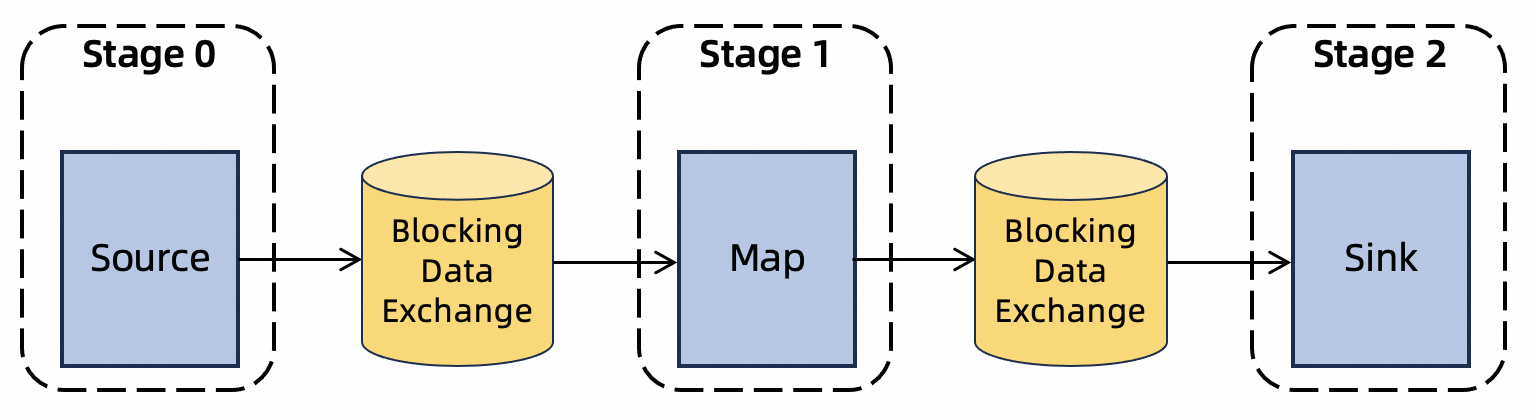
Jobs em lote processam conjuntos de dados limitados com alto throughput. Um job é executado em várias fases:
Fases independentes são executadas em paralelo para maximizar a utilização de recursos.
Fases dependentes aguardam: as subtarefas downstream iniciam somente após a conclusão das subtarefas upstream.
Transmissão de dados
Jobs de streaming mantêm dados intermediários na memória e os passam diretamente entre operadores. Como os dados não são persistidos, lentidão downstream causa backpressure nos operadores upstream.
Jobs em lote gravam resultados intermediários em armazenamento externo antes que os operadores downstream os consumam. Por padrão, os resultados ficam armazenados no disco local de cada TaskManager. Se o remote shuffle service estiver ativado, os resultados serão direcionados para esse service.
Requisitos de recursos
Jobs de streaming exigem alocação de todos os recursos antes da inicialização, pois cada subtarefa é executada ao mesmo tempo.
Jobs em lote não pré-alocam recursos. O Realtime Compute for Apache Flink agenda subtarefas em lotes conforme os dados de entrada ficam disponíveis, permitindo executar um job em lote com apenas um slot.
Recuperação de falhas
Jobs de streaming retomam a partir do último checkpoint ou savepoint. Como os dados intermediários não são persistidos, todas as subtarefas reiniciam.
Jobs em lote armazenam resultados intermediários em disco; portanto, apenas a subtarefa com falha e suas subtarefas downstream precisam reiniciar, sem necessidade de retrocesso completo. Jobs em lote não possuem mecanismo de checkpoint, então as subtarefas reiniciadas começam do início de sua fase.
Configurar recursos
CPU e memória
Defina CPU e memória para o JobManager e TaskManagers em Resources na aba Configuration.
|
Componente |
Recomendado |
Mínimo |
|
JobManager |
1 núcleo de CPU, 4 GiB de memória |
0,5 núcleo de CPU, 2 GiB de memória |
|
TaskManager (por slot) |
1 núcleo de CPU, 4 GiB de memória |
0,5 núcleo de CPU, 2 GiB de memória |
Para um TaskManager com n slots, aloque n núcleos de CPU e 4n GiB de memória.
O espaço em disco é proporcional aos núcleos de CPU: cada núcleo fornece 20 GiB, com mínimo de 20 GiB e máximo de 200 GiB por TaskManager.
Por padrão, cada TaskManager em um job em lote possui um slot. Para reduzir a sobrecarga de agendamento do TaskManager, defina os slots por TaskManager como 2 ou 4. Lembre-se de que mais slots em um único TaskManager significam que mais subtarefas compartilham seu disco local. Se o espaço em disco acabar, o job falhará e reiniciará. Consulte Sem espaço disponível no dispositivo para soluções.
Para jobs com topologia de grande escala ou roteamento de rede complexo, aumente os recursos além dos padrões com base na sua carga de trabalho.
Se encontrar problemas relacionados a recursos, consulte Solução de problemas de memória do Apache Flink.
Número máximo de slots
Configure um limite máximo de slots para restringir os recursos que um job em lote pode consumir e evitar que ele prejudique outros jobs. Para detalhes de configuração, consulte Como limitar o número de TaskManagers?
Configurar paralelismo
Defina o paralelismo em Resources na aba Configuration.
Paralelismo global
O paralelismo global define o limite superior de quantas subtarefas um operador pode executar em paralelo. Insira um valor no campo Parallelism.
Inferência automática de paralelismo
No Realtime Compute for Apache Flink com Ververica Runtime (VVR) 8,0 ou posterior, a inferência automática de paralelismo está ativada por padrão para jobs em lote. Esse recurso analisa o volume total de dados consumido por cada operador e o volume médio de dados configurado por subtarefa e infere automaticamente um paralelismo adequado.
O paralelismo global definido atua como o upper limit para o paralelismo inferido.
Configure os seguintes parâmetros em Parameters na aba Configuration:
|
Parâmetro |
Descrição |
Padrão |
|
|
Ativa a inferência automática de paralelismo. |
|
|
|
Paralelismo mínimo inferido. |
|
|
|
Paralelismo máximo inferido. Se não for definido, o paralelismo global será usado. |
|
|
|
Volume médio de dados que cada subtarefa deve processar. O paralelismo inferido é dimensionado com base no total de dados do operador dividido por este valor. |
|
|
|
Paralelismo para operadores source. Como o volume de dados source não pode ser medido antes da leitura, defina este valor explicitamente. Se não for definido, o paralelismo global será usado. |
|
Perguntas frequentes
Como limitar o número de TaskManagers?
TaskManagers (TMs) são criados e liberados dinamicamente em jobs em lote. Com paralelismo de 16 e um slot por TaskManager, o job inicia 16 TMs. Conforme as subtarefas terminam e seus TMs são liberados, novos TMs são criados para operadores subsequentes. Portanto, a contagem total pode exceder brevemente 16 (por exemplo, 17, 18 ou 19). Esse é um comportamento normal de agendamento elástico.
Para impor um limite estrito, configure o número máximo de slots para o job. Isso restringe quantos TMs podem ser executados ao mesmo tempo.
Qual a diferença entre paralelismo e slots?
Paralelismo define o número máximo de instâncias de subtarefas que um operador pode executar simultaneamente.
Slot é a unidade de alocação de recursos. O total de slots disponíveis determina quantas subtarefas podem ser executadas simultaneamente em todo o job.
Jobs de streaming usam compartilhamento de slots por padrão e solicitam slots equivalentes ao paralelismo global na inicialização, permitindo que todas as subtarefas comecem imediatamente.
Jobs em lote não pré-alocam slots. A concorrência real é limitada pelos slots disponíveis, mesmo que o paralelismo global esteja configurado com um valor maior.
Por exemplo: um job de streaming com paralelismo 4 requer 4 slots antecipadamente. Um job em lote com paralelismo 4 executa no máximo 4 subtarefas se houver 4 slots disponíveis; as subtarefas restantes aguardam a liberação de slots.
O que fazer se um job em lote travar?
Monitore o uso de memória, a utilização de CPU e a atividade de threads dos seus TaskManagers. Consulte Monitorar desempenho do job.
|
Sintoma |
Onde verificar |
Ação |
|
Alto uso de memória ou pausas frequentes de GC |
Métricas de memória |
Aumente a memória do TaskManager |
|
Thread consumindo muita CPU |
Métricas de CPU e threads |
Identifique a thread problemática nos rastreamentos de pilha de threads |
|
Job sem progresso |
Rastreamentos de pilha de threads |
Analise gargalos de execução por operador |
Sem espaço disponível no dispositivo
Quando um job em lote falha com No space left on device, os TaskManagers esgotaram o espaço em disco local ao armazenar arquivos de resultados intermediários. O espaço em disco é proporcional aos núcleos de CPU: cada núcleo fornece 20 GiB, até 200 GiB por TaskManager.
Resolva o problema com uma das seguintes abordagens:
Reduza os slots por TaskManager. Menos slots significam menos subtarefas concorrentes em um único nó, o que reduz os dados intermediários gravados no disco local.
Aumente os núcleos de CPU por TaskManager. Mais núcleos expandem o espaço em disco disponível proporcionalmente.
Próximos passos
Introdução rápida ao processamento em lote — tutorial completo de ponta a ponta dos principais recursos de processamento em lote
Configure custom parameters for job running — referência completa para parâmetros de job