O Realtime Compute for Apache Flink abrange diversos cenários de processamento de big data em tempo real, organizados por departamento de negócios e área técnica.
Fontes de dados e integração
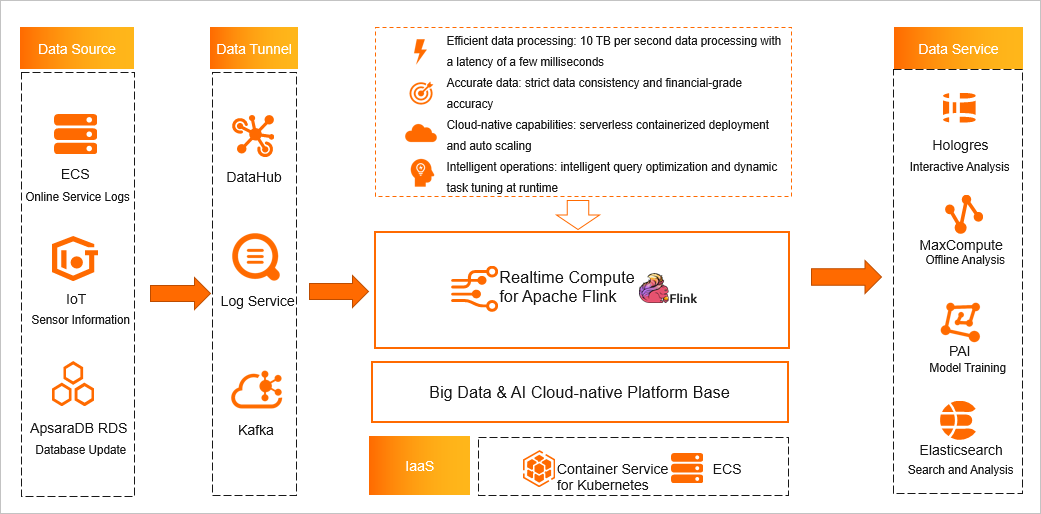
Como mecanismo de computação de fluxo, o Flink é amplamente utilizado no processamento de dados em tempo real. As fontes de dados típicas incluem logs de serviços online de instâncias do Elastic Compute Service (ECS) e dados de sensores de cenários de Internet das Coisas (IoT). O Flink também pode assinar atualizações de binary logging (binlog) de bancos de dados relacionais, como ApsaraDB RDS (RDS) e PolarDB. Serviços como DataHub, Simple Log Service (SLS) e Kafka coletam esses dados de fluxo e os encaminham ao Realtime Compute for Apache Flink para processamento. Em seguida, é possível gravar os resultados em serviços downstream, como MaxCompute, Hologres para análise interativa, Platform for AI e Elasticsearch.
Cenários departamentais
Do ponto de vista empresarial, o Realtime Compute for Apache Flink é utilizado nos seguintes cenários:
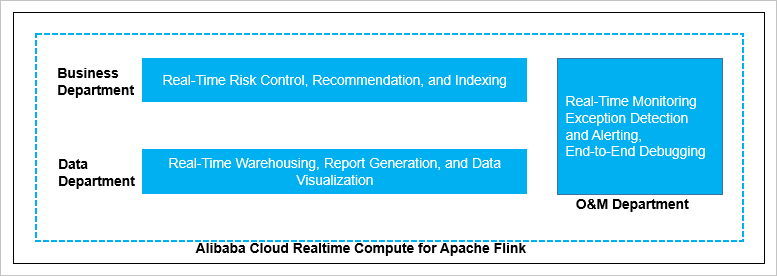
Departamentos de negócios: controle de risco em tempo real, recomendações em tempo real e criação de índices em tempo real para mecanismos de busca.
Departamentos de dados: data warehousing em tempo real, relatórios em tempo real e painéis em tempo real.
Departamentos de operações e manutenção (O&M): monitoramento em tempo real, detecção de anomalias e alertas em tempo real, além de depuração de ponta a ponta.
Áreas técnicas
Sob a perspectiva técnica, o Realtime Compute for Apache Flink cobre quatro casos de uso principais:
ETL em tempo real e fluxos de dados
Os processos de extração, transformação e carga (ETL) em tempo real e os fluxos de dados transferem informações de um ponto a outro instantaneamente. Esse processo pode incluir tarefas de limpeza e integração de dados. Exemplos comuns abrangem a criação de índices de busca em tempo real e a execução de ETL para um data warehouse em tempo real.
Análise de dados em tempo real
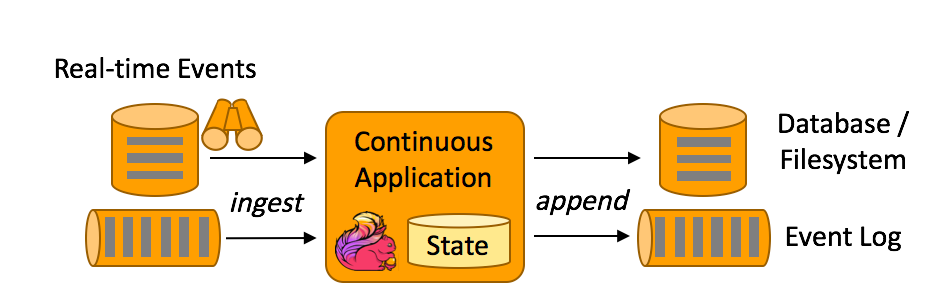
A análise de dados em tempo real extrai e integra informações de dados brutos para apoiar decisões de negócios conforme os eventos ocorrem. Métricas típicas incluem os 10 product mais vendidos por dia, tempo médio de rotatividade do armazém, taxa média de cliques em documentos e taxa de abertura de notificações push. Os resultados aparecem em relatórios ou painéis em tempo real.
Aplicações orientadas a eventos
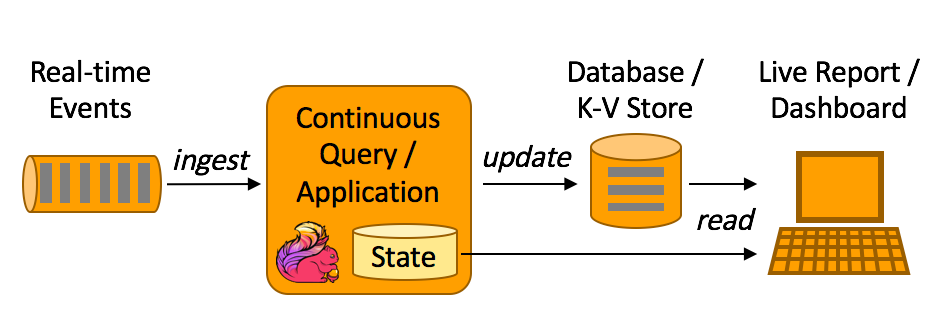
Aplicações orientadas a eventos processam ou respondem a eventos assinados e frequentemente mantêm estado interno entre esses eventos. Quando uma ação do usuário aciona uma regra — por exemplo, uma regra de controle de risco — o sistema captura o evento, analisa o comportamento atual e histórico do usuário e decide se deve tomar alguma medida. Exemplos comuns incluem detecção de fraudes, sistemas de controle de risco e detecção de anomalias de O&M.
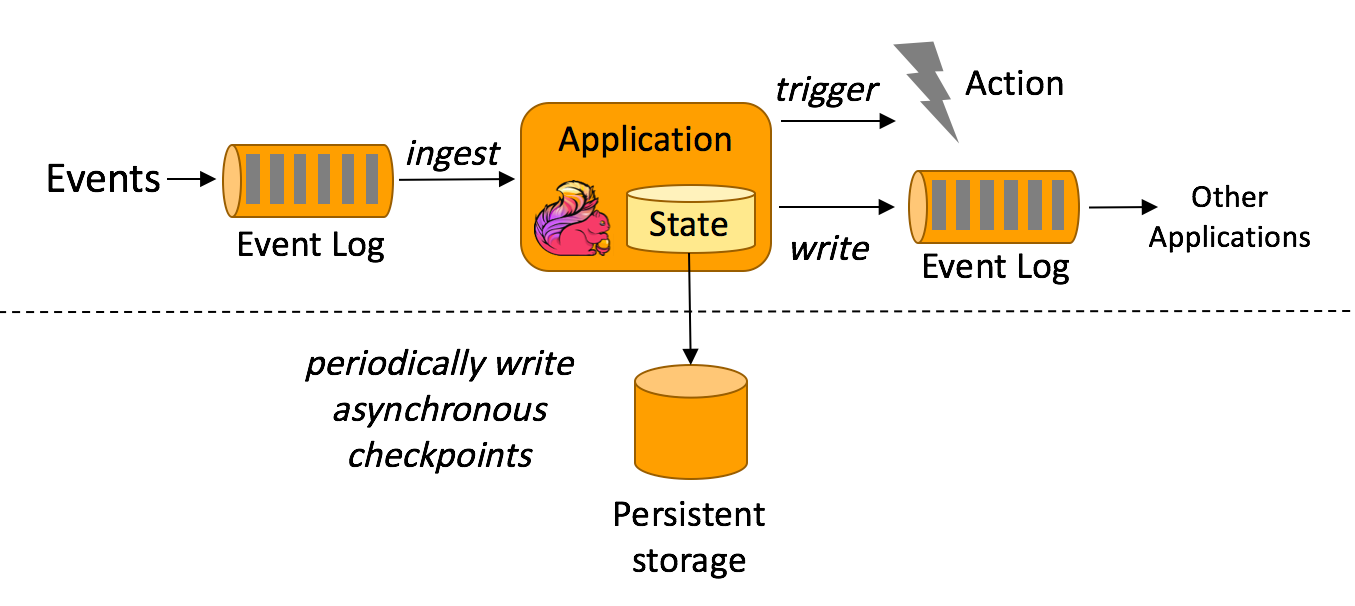
Sistema de controle de risco
O Realtime Compute for Apache Flink processa tarefas complexas de fluxo e lote, fornecendo APIs para cálculos matemáticos avançados e regras de processamento de eventos complexos. Isso permite que as empresas analisem dados em tempo real e fortaleçam suas capacidades de controle de risco — por exemplo, detectando padrões anormais de clique em um aplicativo ou identificando alterações irregulares em fluxos de dados de IoT.
Os fluxogramas na seção de áreas técnicas acima foram obtidos no site oficial do Apache Flink .