Este tópico descreve como usar o service de large language model integrado em jobs do Flink SQL para análise de sentimento em streaming e vetorização, sem precisar solicitar uma chave de API própria.
Informações gerais
O Flink AI service oferece large language models (LLMs) integrados e gerenciados. Você não precisa solicitar uma chave de API. Referencie os modelos integrados diretamente nos jobs do Flink SQL para ative a inferência de IA em streaming e a vetorização. As seções a seguir descrevem dois casos de uso principais dos modelos:
-
Modelo chat/completions: Um modelo chat/completions é um LLM baseado na geração de diálogos e na compreensão de texto. Seu uso é comum em cenários como análise de sentimento, reconhecimento de intenção e sistemas de perguntas e respostas.
Análise de sentimento: Classifica sentimentos em tempo real em comentários de redes sociais do seu negócio para identificar se a opinião do usuário é positiva, negativa ou neutra.
Atendimento ao cliente inteligente: Oferece interações em linguagem natural para sistemas de atendimento inteligente, usando recursos de geração de diálogos.
Moderação de conteúdo: Detecta automaticamente conteúdo sensível ou violações de políticas em textos para tornar as auditorias de segurança de conteúdo mais eficientes.
-
Modelo de embedding: Converte texto em representações vetoriais de alta dimensão. As aplicações mais comuns incluem busca semântica, sistemas de recomendação e construção de grafos de conhecimento.
Busca semântica: Permite pesquisas semânticas baseadas em relevância ao vetorizar descrições de product ou consultas de usuários.
Sistemas de recomendação: Usa a vetorização de texto para descobrir associações entre os interesses dos usuários e as características dos product, melhorando a precisão das recomendações.
Grafo de conhecimento: Converte texto não estruturado em formato vetorial para simplificar a extração subsequente de conhecimento e a modelagem de relacionamentos.
Pré-requisitos
Você ativou um workspace do Flink. Para mais informações, consulte Activate Realtime Compute for Apache Flink.
Você ativou o Flink AI service. Para mais informações, consulte Flink AI service (built-in models).
Limitações
Requer Ververica Runtime (VVR) 11,7 ou superior.
A política de limitação de taxa da plataforma de service de modelos limita o throughput do operador ML_PREDICT. Ao atingir o limite de tráfego, o job do Flink pode sofrer backpressure ou reiniciar devido a timeouts.
Etapa 1: Registrar um modelo integrado
Para mais informações, consulte Model settings.
Modelo Chat/completions
O código SQL de exemplo abaixo demonstra como registrar um modelo de texto integrado do Flink:
CREATE MODEL ai_analyze_sentiment
INPUT (`input` STRING)
OUTPUT (`content` STRING)
WITH (
    'provider' = 'dashscope',
    'task' = 'chat/completions',
    'model' = 'qwen3.5-flash',
    'system-prompt' = 'Classify the text below into one of the following labels: [positive, negative, neutral, mixed]. Output only the label.'
);
Modelo de Embedding
O código SQL de exemplo a seguir ilustra o registro de um modelo de embedding integrado do Flink:
CREATE MODEL embedding_model
INPUT (`input` STRING)
OUTPUT (`embeddings` ARRAY<FLOAT>)
WITH (
    'provider' = 'dashscope',
    'task' = 'embeddings',
    'model' = 'text-embedding-v4'
);
Etapa 2: Crie um job
Crie um rascunho para um job de streaming SQL. Para mais detalhes, consulte Flink SQL jobs.
Etapa 3: Escrever um job SQL para análise com LLM
Modelo Chat/completions
Use a função de IA ML_PREDICT para chamar o modelo ai_analyze_sentiment registrado e analisar o sentimento de críticas de filmes.
Copie o SQL de exemplo abaixo para o editor SQL.
-- Create a temporary sink table.
CREATE TEMPORARY TABLE print_sink(
  id BIGINT,
  movie_name VARCHAR,
  predict_label VARCHAR,
  actual_label VARCHAR
) WITH (
  'connector' = 'print',   -- Use the print connector.
  'logger' = 'true'        -- Display the results in the console.
);

-- Create a temporary data view to construct test data.
-- | id | movie_name | comment   | actual_label |
-- | 1  | Her Story     | My favorite part was when the kid guessed the sounds. It is one of the most romantic narratives I have seen in movies. Very gentle and loving. | POSITIVE |
-- | 2  | The Dumpling Queen   | Unremarkable.  | NEGATIVE |
CREATE TEMPORARY VIEW movie_comment(id, movie_name, user_comment, actual_label)
AS VALUES (1, 'Her Story', 'My favorite part was when the kid guessed the sounds. It is one of the most romantic narratives I have seen in movies. Very gentle and loving.', 'positive'), (2, 'The Dumpling Queen', 'Unremarkable.', 'negative');

INSERT INTO print_sink
SELECT id, movie_name, content as predict_label, actual_label
FROM ML_PREDICT(
  TABLE movie_comment,
  MODEL ai_analyze_sentiment,  -- The registered Flink built-in text model.
  DESCRIPTOR(user_comment));
Modelo de Embedding
Use a função de IA ML_PREDICT para invocar o embedding_model registrado, gerar embeddings para as críticas de filmes e gravar os resultados no Milvus (public preview).
Copie o seguinte exemplo de SQL para o editor SQL.
-- Create a temporary sink table named milvus_sink.
CREATE TEMPORARY TABLE milvus_sink
(
    id STRING,
    movie_name STRING,
    user_comment STRING,
    embeddings ARRAY<FLOAT>,
    PRIMARY KEY (id) NOT ENFORCED
)
WITH (
    'connector' = 'milvus',
    'endpoint' = '<YOUR-ENDPOINT>',
    'port' = '<YOUR-PORT>',
    'userName' = '<YOUR-USERNAME>',
    'password' = '<YOUR-PASSWORD>',
    'databaseName' = 'default',
    'collectionName' = 'movie-comment-embeddings'
);

-- Create a temporary data view to construct test data.
-- | id | movie_name | comment |
-- | 1 | Her Story |My favorite part was when the kid guessed the sounds. It is one of the most romantic narratives I have seen in movies. Very gentle and loving.|
-- | 2 | The Dumpling Queen | Unremarkable. |
CREATE TEMPORARY VIEW movie_comment(id, movie_name,  user_comment)
AS VALUES ('1', 'Her Story', 'My favorite part was when the kid guessed the sounds. It is one of the most romantic narratives I have seen in movies. Very gentle and loving.'), ('2', 'The Dumpling Queen', 'Unremarkable.');

INSERT INTO
    milvus_sink
SELECT
    id,
    movie_name,
    user_comment,
    embeddings
FROM
    ML_PREDICT (
        TABLE movie_comment,
        MODEL embedding_model,  -- The registered Flink built-in embedding model.
        DESCRIPTOR (user_comment)
    );
Etapa 4: Implantar e iniciar o job
Implante e inicie o job. Para obter mais informações, consulte Flink SQL jobs.
Etapa 5: Visualize os resultados da análise
Modelo Chat/completions
-
Verifique se o status do job é FINISHED.
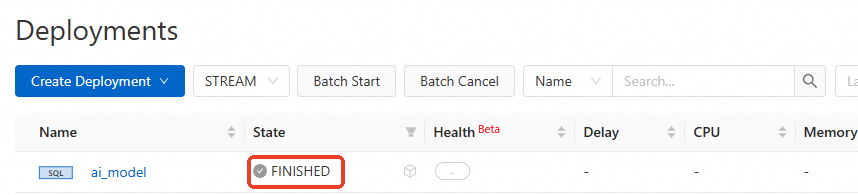
No console de , acesse a página Deployments e clique em no nome do job desejado.
Na aba Logs, clique em na subaba Task Managers e selecione o current TaskManager.
-
Clique em Logs e pesquise logs relacionados ao PrintSinkOutputWriter.
O rótulo previsto pelo modelo
predict_labelcorresponde ao rótulo realactual_label.Na aba Task Managers, selecione Running Logs à esquerda. Os logs exibem a saída do PrintSinkOutputWriter, como
+I[1, Her Story, positive, positive]e+I[2, The Dumpling Queen, negative, negative]. Isso indica que predict_label corresponde a actual_label.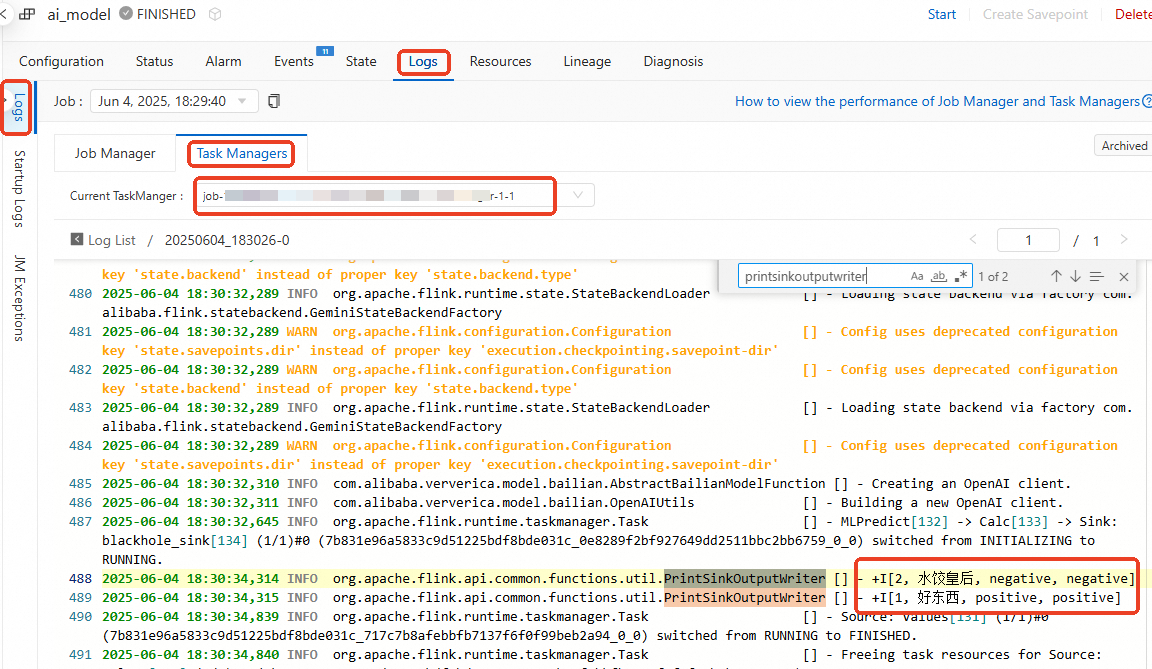
Documentos relacionados
Instruções de Data Definition Language (DDL) para modelos de IA: Configure a model
Funções de IA: ML_PREDICT
Service de busca vetorial: Milvus (public preview)