A equipe do Alibaba Cloud Elasticsearch desenvolveu o plugin aliyun-knn (aliyun), um plugin de motor de busca vetorial baseado na biblioteca de vetores Proxima da alibaba DAMO Academy. Este plugin permite implementar rapidamente a busca vetorial em casos de uso como busca de imagens, fingerprinting de vídeo, reconhecimento facial, reconhecimento de fala e recomendação de product. Este tópico descreve como usar o plugin aliyun-knn.
Este guia destina-se a clientes que usam o plugin knn em instâncias legadas do Elasticsearch.
Para novos casos de uso de busca vetorial, recomendamos comprar uma instância do Elasticsearch (versão 8.15 ou posterior) e usar os recursos nativos de busca vetorial do motor.
Contexto
-
Casos de uso
O motor de busca vetorial do Alibaba Cloud Elasticsearch possui um histórico comprovado em aplicações de produção em grande escala, incluindo Pailitao, Image Search, amostragem de fingerprinting de vídeo para Qutoutiao, recomendações "Guess You Like", busca personalizada e busca cross-media.
-
Como funciona
O recurso de busca vetorial no Alibaba Cloud Elasticsearch é um plugin construído sobre o mecanismo de extensão do Elasticsearch. O plugin é totalmente compatível com as versões nativas do Elasticsearch, garantindo uma curva de aprendizado suave. Os índices vetoriais suportam gravações incrementais em tempo real e consultas near real-time (NRT). Eles também oferecem todos os recursos distribuídos nativos do Elasticsearch, incluindo suporte a múltiplas réplicas e recuperação de erros.
NotaO plugin de busca vetorial do Alibaba Cloud Elasticsearch não suporta migração de dados com um snapshot do OSS ou o DataWorks. Recomendamos usar o Logstash.
-
Algoritmos
O motor de busca vetorial suporta os algoritmos Hierarchical Navigable Small World (HNSW) e linear. Esses algoritmos são adequados para casos de uso com conjuntos de dados pequenos, mantidos em memória, em uma única máquina. A tabela a seguir compara o desempenho desses dois algoritmos.
Tabela 1. Comparação de desempenho dos algoritmos HNSW e linear
Os dados desta tabela foram medidos em um ambiente Alibaba Cloud Elasticsearch V6.7.0. O ambiente de teste apresentou a seguinte configuração:
Configuração da instância: Dois nós de dados, cada um com 16 núcleos, 64 GB de memória e um disco em cloud SSD de 100 GB.
Conjunto de dados: vetores float SIFT de 128 dimensões.
Volume total de dados: 20 milhões de registros.
Configuração do índice: parâmetros padrão.
Métrica de desempenho
HNSW
Linear
Recall Top-10
98,6%
100%
Recall Top-50
97,9%
100%
Recall Top-100
97,4%
100%
Latência (p99)
0,093s
0,934s
Latência (p90)
0,018s
0,305s
NotaNesta tabela, p significa percentil. Por exemplo, a Latência (p99) representa o tempo máximo para o sistema retornar 99% das consultas.
Pré-requisitos
-
O método de instalação do plugin aliyun-knn varia conforme a versão do seu cluster Alibaba Cloud Elasticsearch e a versão do kernel. Para mais detalhes, consulte a tabela a seguir.
Versão do Elasticsearch
Versão do kernel
Descrição
6.7.0
Anterior a 1.2.0
-
Por favor, instale manualmente o plugin aliyun-knn na página Plug-ins. Para mais informações, consulte Install or uninstall default plug-ins.
-
O sistema não suporta recursos como busca baseada em script e aquecimento de índice. Se precisar desses recursos, use um cluster que tenha uma versão de kernel do Alibaba Cloud Elasticsearch. Para mais informações, consulte Kernel version release notes.
-
Ao criar um índice vetorial, o sistema suporta apenas a métrica de distância padrão
SquaredEuclidean. Não especifique uma métrica de distância usando o parâmetrodistance_method.
6.8
N/A
7.4
N/A
7.7
N/A
6.7.0
1.2.0 ou posterior
-
O plugin aliyun-knn está integrado ao plugin apack, instalado por padrão. Para instalar ou desinstalar o plugin aliyun-knn, gerencie o plugin apack. Para mais informações, consulte Use the physical replication feature of the apack plug-in.
-
Para usar recursos avançados como busca baseada em script, aquecimento de índice e funções estendidas, atualize a versão do kernel para 1.3.0 ou posterior. Para obter instruções, consulte Upgrade versions.
-
Se ocorrer um erro de análise de mapeamento ao criar um índice vetorial, atualize a versão do kernel para 1.3.0 ou posterior e tente novamente.
7.10.0
1.4.0 ou posterior
-
O plugin aliyun-knn está integrado ao plugin apack, instalado por padrão. Para instalar ou desinstalar o plugin aliyun-knn, gerencie o plugin apack. Para mais informações, consulte Use the physical replication feature of the apack plug-in.
-
Se a versão secundária do kernel for 1.4.0 ou posterior, o plugin apack estará na versão mais recente e não exigirá atualização. Para verificar a versão do plugin, execute o comando GET _cat/plugins?v.
Outras versões
N/A
O sistema não suporta busca vetorial.
NotaA kernel version é diferente da versão do plugin apack. Para verificar a versão do plugin apack, execute o comando GET _cat/plugins?v.
-
-
Planeje seu índice.
Algoritmo
Casos de uso
Em memória
Outros
hnsw
-
Conjuntos de dados pequenos em uma única máquina.
-
Requisitos de baixa latência.
-
Requisitos de alto recall.
Sim
-
O algoritmo hnsw baseia-se na ideia de que "o vizinho de um vizinho provavelmente também é um vizinho". A métrica de distância deste algoritmo deve satisfazer a desigualdade triangular (a soma de dois lados de um triângulo é maior que o terceiro lado). Por exemplo, espaços vetoriais de produto interno não satisfazem a desigualdade triangular. Portanto, converta-os para espaços euclidianos ou esféricos para usar o método de busca hnsw.
-
Após gravar os dados, execute o forceMerge periodicamente em horários de menor movimento para reduzir a latência da consulta.
linear
-
Busca por força bruta.
-
Recall de 100%.
-
A latência aumenta com o volume de dados.
-
Use para comparações de linha de base.
Sim
Nenhum.
-
-
Planeje seu cluster.
Parâmetro
Descrição
Especificação do nó de dados (obrigatório)
16 núcleos e 64 GB ou superior.
NotaCriar um índice com o plugin aliyun-knn consome muitos recursos. Clusters com especificações baixas podem se tornar gargalos e afetar a estabilidade. Use um cluster com especificações de 16 núcleos e 64 GB ou superior.
Tipo de nó
O cluster deve ter nós mestres dedicados.
Memória off-heap do cluster
Mais que o dobro do tamanho total dos dados vetoriais no cluster.
Exemplo: um índice contém um campo float de 960 dimensões e 400 documentos. Como um float ocupa 4 bytes, calculamos a memória usada para dados vetoriais da seguinte forma: 960 × 400 × 4 = 1,5 MB. Portanto, a memória off-heap deve exceder 3 MB (1,5 MB × 2).
Nota-
Se você executar uma operação de force merge, o sistema carrega tanto os dados antigos quanto os novos na memória simultaneamente. Nesse caso, dobre o valor calculado usando a fórmula anterior.
-
Para clusters com 64 GB de memória ou mais, o tamanho da memória off-heap é aproximadamente igual à memória total menos 32 GB (memória off-heap ≈ memória total - 32 GB).
Throughput de gravação
Criar um índice vetorial é uma tarefa que consome muita CPU. Para um nó de dados de 16 núcleos e 64 GB, limite o pico de throughput de gravação a 5.000 tps por nó.
Além disso, durante uma consulta vetorial, o sistema carrega todos os arquivos de índice na memória. Portanto, evite gravações de grande volume enquanto atende a consultas de negócios. Isso ajuda a evitar reinicializações de shard por pressão de memória.
NotaEsses valores são estimativas. Baseie seu planejamento na sua carga de trabalho real, execute testes de carga com antecedência e provisione memória suficiente.
-
Limitações
O sistema não suporta o plugin aliyun-knn em instâncias da versão 6.7 com o recurso de armazenamento elástico compartilhado ativado.
Para instalar o plugin aliyun-knn, os nós de dados da sua instância do Alibaba Cloud Elasticsearch devem ter 16 núcleos e 64 GB ou mais. Se os seus nós não atenderem a esse requisito, atualize as especificações deles. Para mais informações, consulte Upgrade the configuration of a cluster.
O plugin aliyun-knn é incompatível com alguns recursos avançados do kernel AliES, como o recurso de replicação física. Se esse recurso estiver ativado, desative-o antes de usar o plugin. Para obter instruções, consulte Use the physical replication feature of the apack plug-in.
Não use snapshots do OSS ou o DataWorks para migração de dados em instâncias que usam o plugin aliyun-knn. Recomendamos usar o Logstash.
Crie um índice vetorial
-
Faça login no console do Kibana do seu cluster Elasticsearch.
Para obter instruções, consulte Log on to the Kibana console.
NotaOs exemplos aqui usam o Elasticsearch V6.7.0. As operações podem variar ligeiramente para outras versões.
No painel de navegação à esquerda, escolha .
-
Na aba Console, execute o seguinte comando para criar um índice vetorial.
PUT test { "settings": { "index.codec": "proxima", "index.vector.algorithm": "hnsw" }, "mappings": { "_doc": { "properties": { "feature": { "type": "proxima_vector", "dim": 2, "vector_type": "float", "distance_method": "SquaredEuclidean" } } } } }NotaAdicione outros tipos de campo suportados pelo Elasticsearch ao índice vetorial.
Se ocorrer um erro de análise de mapeamento ao criar o índice vetorial:
"type": "mapper_parsing_exception", "reason": "Mapping definition for [feature] has unsupported parameters: [distance_method : SquaredEuclidean]", atualize o kernel para a versão mais recente e tente novamente.
Tipo
Parâmetro
Padrão
Descrição
setting
index.codec
proxima
Especifique se o sistema deve criar um índice kNN proxima na camada subjacente. Valores válidos:
-
proxima (Recomendado): o sistema cria um índice kNN proxima na camada subjacente para suportar a busca vetorial.
-
null: não cria um índice kNN proxima. Em vez disso, cria apenas um índice direto (forward index). Nesse caso, os campos do tipo proxima_vector suportam apenas busca baseada em script e não suportam busca hnsw ou linear.
NotaPara grandes conjuntos de dados em que a latência da consulta não é a preocupação principal, remova este parâmetro ou defina-o como null. Isso permite realizar consultas vetoriais kNN usando busca baseada em script. O sistema suporta a busca baseada em script se a sua instância for V6.7.0 com a versão 1.2.1 ou posterior do plugin apack, ou V7.10.0 com a versão 1.4.0 ou posterior do plugin apack.
index.vector.algorithm
hnsw
O algoritmo de busca vetorial. Valores válidos:
-
hnsw: O algoritmo HNSW.
-
linear: O algoritmo linear.
index.vector.general.builder.offline_mode
false
Especifique se o sistema deve usar o modo de otimização offline para criar o índice kNN. Valores válidos:
-
false: Desativa o modo de otimização offline.
-
true: ative o modo de otimização offline. Este modo reduz a fragmentação de segmentos durante as gravações e melhora o throughput de gravação.
Nota-
Para ativar o modo de otimização offline, sua instância deve ser V6.7.0 com a versão do plugin apack 1.2.1 ou posterior, ou V7.10.0 com a versão do plugin apack 1.4.0 ou posterior. Índices criados no modo de otimização offline não suportam busca de dados baseada em script.
-
Recomendamos ativar o modo de otimização offline para importações em massa únicas de um conjunto de dados completo.
mapping
type
proxima_vector
O tipo de campo vetorial. Por exemplo, defina o campo feature como proxima_vector para especificar que feature é um campo vetorial.
dim
2
A dimensão do vetor. Este parâmetro é obrigatório. O valor deve ser um número inteiro de 1 a 2048.
vector_type
float
O tipo de dados do vetor. Valores válidos:
-
float: Ponto flutuante.
-
short: Inteiro curto.
-
binary: Binário.
Para o tipo binary, represente os dados vetoriais como uma matriz de inteiros de 32 bits sem sinal (uint32) e garanta que o valor de dim seja um múltiplo de 32.
Por exemplo, se os seus dados de negócios forem o valor binário de 64 bits 1000100100100101111000001001111101000011010010011010011010000100, o vector gravado será [-1994006369, 1128900228].
NotaO sistema suporta todos os três tipos de dados vetoriais em instâncias V6.7.0 com a versão 1.2.1 ou posterior do plugin apack, ou V7.10.0 com a versão 1.4.0 ou posterior. Versões anteriores suportam apenas o tipo float.
distance_method
SquaredEuclidean
A função de distância. Valores válidos:
-
SquaredEuclidean: Distância euclidiana (sem raiz quadrada).
-
InnerProduct: Produto interno.
-
Cosine: Similaridade de cosseno.
-
Hamming: Distância de Hamming (apenas para o tipo binary).
Nota-
O sistema suporta todas as quatro funções de distância em instâncias V6.7.0 com a versão 1.2.1 ou posterior do plugin apack, ou V7.10.0 com a versão 1.4.0 ou posterior. Versões anteriores suportam apenas a função padrão SquaredEuclidean. Não especifique outras funções de distância usando o parâmetro
distance_method. -
Para mais informações sobre funções de distância, consulte Distance functions.
-
Como a função
Hammingtem uma implementação especial, o sistema não suporta consultasknnpadrão ao usar índiceshnswoulinear. O sistema suporta apenas consultas baseadas em script compatíveis com script_score. Teste as instruções de consulta em diferentes cenários para garantir que sejam adequadas aos seus requisitos de negócios específicos.
NotaExecute o comando GET /_cat/plugins?v para verificar a versão do plugin apack. Se a versão não atender aos requisitos, envie um ticket para solicitar uma atualização.
A busca vetorial kNN também fornece parâmetros de consulta avançados. Para mais informações, consulte Advanced parameters.
-
Execute o seguinte comando para adicionar um documento.
POST test/_doc { "feature": [1.0, 2.0] }NotaPara todos os tipos de matriz, exceto binary, o comprimento da matriz deve corresponder a dim. Para o tipo binary, converta os dados vetoriais em uma matriz de inteiros de 32 bits sem sinal (uint32) e garanta que dim seja um múltiplo inteiro de 32.
Busca vetorial
-
Busca padrão
Execute o seguinte comando para uma busca padrão.
GET test/_search
{
  "query": {
    "hnsw": {
      "feature": {
        "vector": [1.5, 2.5],
        "size": 10
      }
    }
  }
}
A tabela a seguir descreve os parâmetros comuns.
Parâmetro
Descrição
hnsw
O algoritmo de busca vetorial. Deve corresponder ao algorithm especificado quando você criou o índice.
vector
O vetor de consulta. O comprimento da matriz deve ser o mesmo que o dim especificado no mapping quando você criou o índice.
size
Especifique o número de documentos a serem retornados.
Nota-
O parâmetro size em uma busca vetorial é diferente do parâmetro size integrado do Elasticsearch. O primeiro controla o número de documentos retornados pelo plugin kNN, enquanto o último controla o número total de documentos retornados por toda a consulta. Ao executar uma consulta, o sistema primeiro usa o parâmetro size da busca vetorial para recuperar o número especificado de principais documentos. Em seguida, aplica o parâmetro size integrado do Elasticsearch aos resultados antes de retornar o conjunto final de documentos.
-
Recomendamos definir o parâmetro size da busca vetorial com o mesmo valor do parâmetro size integrado do Elasticsearch, que tem como padrão 10.
NotaA busca vetorial kNN também fornece parâmetros de consulta avançados. Para mais informações, consulte Advanced parameters.
-
-
Consulta por script
Use consultas por script vetorial apenas com script_score. Por exemplo, use script_score para pontuar cada documento retornado com base na fórmula
1/(1+l2Squared(params.queryVector, doc['feature'])). O comando a seguir mostra um exemplo.GET test/_search { "query": { "match_all": {} }, "rescore": { "query": { "rescore_query": { "function_score": { "functions": [{ "script_score": { "script": { "source": "1/(1+l2Squared(params.queryVector, doc['feature'])) ", "params": { "queryVector": [2.0, 2.0] } } } }] } } } } }A consulta por script vetorial kNN não suporta funções fornecidas pelo X-Pack. O sistema suporta apenas as seguintes funções:
Função
Descrição
l2Squared(float[] queryVector, DocValues docValues)Função de distância euclidiana.
hamming(float[] queryVector, DocValues docValues)Função de distância de Hamming.
-
cosineSimilarity(float[] queryVector, DocValues docValues) -
cosine(float[] queryVector, DocValues docValues)
Função de similaridade de cosseno.
NotaPara o Alibaba Cloud Elasticsearch V6.7, use a função
cosineSimilarity(float[] queryVector, DocValues docValues). Para a V7.10, use a funçãocosine(float[] queryVector, DocValues docValues).NotaPara usar o recurso de consulta por script, sua configuração deve atender a um dos seguintes requisitos: versão do cluster 6.7.0 com o plugin apack V1.2.1 ou posterior, ou versão do cluster 7.10.0 com o plugin apack V1.4.0 ou posterior. Execute o comando GET /_cat/plugins?v para verificar a versão do plugin apack. Se a versão não atender aos requisitos, envie um ticket para solicitar uma atualização.
-
Parâmetros da função:
float[] queryVector: O vetor de consulta.
DocValues docValues: O vetor do documento.
O sistema não suporta consultas por script vetorial para índices criados com o modo de otimização offline (
index.vector.builder.offlineMode = true).
-
-
Aquecimento de índice
Um índice kNN realiza uma busca completa em memória, o que pode causar alta latência de consulta a partir de uma inicialização a frio, no momento em que o sistema carrega o índice pela primeira vez. O recurso de aquecimento de índice do plugin kNN evita isso pré-carregando um índice na memória local antes de atender às solicitações de busca, reduzindo significativamente a latência de inicialização a frio.
-
Aqueça todos os índices vetoriais.
POST _vector/warmup -
Aqueça um índice vetorial específico.
POST _vector/{indexName}/warmup
NotaPara usar o recurso de aquecimento de índice, sua configuração deve atender a um dos seguintes requisitos: versão do cluster 6.7.0 com o plugin apack V1.2.1 ou posterior, ou versão do cluster 7.10.0 com o plugin apack V1.4.0 ou posterior. Execute o comando GET _cat/plugins?v para verificar a versão do plugin apack. Se a versão não atender aos requisitos, envie um ticket para solicitar uma atualização.
Se o seu cluster contiver muitos índices vetoriais grandes, mas sua aplicação realizar buscas vetoriais apenas em um subconjunto deles, aqueça apenas esses índices específicos para melhorar o desempenho da busca em memória.
-
Pontuação vetorial
A busca vetorial usa uma fórmula de pontuação unificada baseada em uma distance metric function, que afeta diretamente a classificação da busca.
Fórmula de pontuação:
score = 1 / (função de distância vetorial + 1)
Por padrão, o mecanismo de pontuação vetorial usa a distância euclidiana ao quadrado.
Na prática, otimize seus dados vetoriais e melhore a pontuação trabalhando de trás para frente a partir da pontuação da consulta para determinar a distância entre os vetores.
Funções de medição de distância
Diferentes funções de medição de distância usam mecanismos de pontuação diferentes. A tabela a seguir detalha as funções de medição de distância suportadas pelo plugin aliyun-knn.
|
Função de distância |
Descrição |
Fórmula de pontuação |
Melhor para |
Exemplo |
|
SquaredEuclidean (Distância euclidiana ao quadrado) |
A distância euclidiana é a distância em linha reta entre dois pontos em um espaço multidimensional. No espaço 2D e 3D, corresponde à distância física. |
Para dois vetores n-dimensionais, A = [A1, A2, ..., An] e B = [B1, B2, ..., Bn]:
Nota
Por padrão, a pontuação vetorial usa a distância euclidiana ao quadrado. |
A distância euclidiana reflete a diferença absoluta nos valores dos componentes do vetor. É mais bem utilizada para análises em que a magnitude das diferenças é significativa, como a análise de similaridade ou variância no valor do usuário com base em métricas de comportamento. |
Para os vetores 2D [0,0] e [1,2], a distância euclidiana ao quadrado é (1-0)² + (2-0)² = 5. |
|
Cosine (similaridade de cosseno) |
A similaridade de cosseno avalia a similaridade entre dois vetores calculando o cosseno do ângulo entre eles. |
Para dois vetores n-dimensionais, A = [A1, A2, ..., An] e B = [B1, B2, ..., Bn]:
|
A similaridade de cosseno foca na orientação dos vetores em vez de sua magnitude, tornando-a insensível a valores absolutos. É ideal para comparar o interesse do usuário com base em classificações de conteúdo, pois pode corrigir inconsistências nas escalas de classificação entre diferentes usuários. |
Para os vetores 2D [1,1] e [1,0], a similaridade de cosseno é 0,707. |
|
InnerProduct (produto interno) |
O produto interno, também conhecido como produto escalar, é uma operação que combina dois vetores de números reais para produzir um único valor escalar. |
Para dois vetores n-dimensionais, A = [A1, A2, ..., An] e B = [B1, B2, ..., Bn]:
|
O produto interno considera tanto o ângulo quanto a magnitude de dois vetores. Ao normalizar os vetores, o produto interno equivale à similaridade de cosseno. |
Para os vetores 2D [1,1] e [1,5], o produto interno é (11) + (15) = 6. |
|
Hamming (apenas para vetores binários) |
Na teoria da informação, a distância de Hamming entre duas strings de igual comprimento é o número de posições nas quais os caracteres correspondentes diferem. |
Para duas strings binárias de n bits, x e y:
|
É tipicamente usada para detecção e correção de erros em transmissões de dados, em que conta o número de bits diferentes entre duas palavras binárias para estimar o erro de transmissão. |
Por exemplo, a distância de Hamming entre 1011101 e 1001001 é 2. Nota
Ao usar o plugin aliyun-knn, represente os dados vetoriais binários como uma matriz de inteiros de 32 bits sem sinal (uint32) e garanta que o valor do parâmetro |
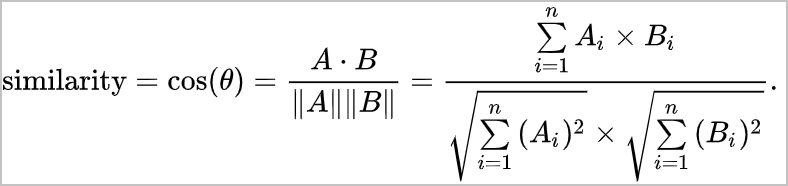
Para usar múltiplas funções de medição de distância, certifique-se de que seu cluster atenda a um dos seguintes requisitos: versão do cluster 6.7.0 com o plugin apack V1.2.1 ou posterior, ou versão do cluster 7.10.0 com o plugin apack V1.4.0 ou posterior. Execute o comando GET _cat/plugins?v para verificar a versão do seu plugin apack. Se a versão não atender aos requisitos, o sistema suporta apenas a função de medição de distância kNN SquaredEuclidean. Se precisar usar outras funções de distância, envie um ticket para solicitar uma atualização do plugin.
Especifique a função de medição de distância usando o parâmetro distance_method no mapping do índice.
Parâmetros do circuit breaker
|
Parâmetro |
Descrição |
Padrão |
|
indices.breaker.vector.native.indexing.limit |
Se o uso de memória off-heap exceder este limiar, o sistema aciona o circuit breaker e bloqueia as operações de gravação. As gravações são retomadas após a conclusão do processo de criação em segundo plano e a liberação de memória. Um circuit breaker acionado indica que o consumo de memória do sistema está muito alto. Recomendamos reduzir o throughput de gravação. |
70% |
|
indices.breaker.vector.native.total.limit |
Define a porcentagem máxima de memória off-heap que as criações de índice vetorial em segundo plano podem usar. Se o uso de memória off-heap exceder este limite, os shards podem reiniciar. |
80% |
Os parâmetros do circuit breaker vetorial fazem parte da configuração do cluster. Visualize as configurações executando o comando GET _cluster/settings. Não altere os limiares do circuit breaker.
Parâmetros avançados
Tabela 2. Parâmetros de criação (hnsw)
|
Parâmetro |
Descrição |
Padrão |
|
index.vector.hnsw.builder.max_scan_num |
Controla o escopo da busca do vizinho mais próximo durante a construção do grafo para garantir o desempenho no pior caso. |
100000 |
|
index.vector.hnsw.builder.neighbor_cnt |
O número de vizinhos para cada nó no grafo da camada 0. Recomendamos um valor de 100. Um valor maior melhora a qualidade da construção do grafo, mas aumenta o tamanho do índice offline. |
100 |
|
index.vector.hnsw.builder.upper_neighbor_cnt |
O número máximo de vizinhos para cada nó nas camadas superiores do grafo HNSW (todas as camadas, exceto a camada 0). Recomendamos definir este valor como metade do valor de neighbor_cnt. O valor máximo é 255. |
50 |
|
index.vector.hnsw.builder.efconstruction |
Controla o tamanho da lista dinâmica de candidatos para vizinhos mais próximos durante a construção do grafo. Um valor maior melhora a qualidade do grafo offline, mas retarda a criação do índice. Recomendamos um valor inicial de 400. |
400 |
|
index.vector.hnsw.builder.max_level |
O número total de camadas no grafo HNSW, incluindo a camada 0 e as camadas superiores. Por exemplo, para 10 milhões de documentos com um scaling_factor de 30, o número de camadas é ceil(log₃₀(10.000.000)), que é 5. Este parâmetro tem um impacto menor na eficácia. Recomendamos um valor inicial de 6. |
6 |
|
index.vector.hnsw.builder.scaling_factor |
O fator de escala exponencial entre as camadas. Este valor está tipicamente entre 10 e 100. Um scaling_factor maior resulta em menos camadas. Recomendamos um valor inicial de 50. |
50 |
Configure os parâmetros anteriores nas settings do índice. O sistema os suporta apenas para o algoritmo hnsw.
Tabela 3. Parâmetros de busca (hnsw)
|
Parâmetro |
Descrição |
Padrão |
|
ef |
Controla o tamanho da lista dinâmica de candidatos a explorar durante a busca online. Um valor maior melhora o recall, mas degrada o desempenho. Recomendamos um valor entre 100 e 1000. |
100 |
Exemplo de consulta:
GET test/_search
{
  "query": {
    "hnsw": {
      "feature": {
        "vector": [1.5, 2.5],
        "size": 10,
        "ef": 100
      }
    }
  }
}
Perguntas frequentes
-
P: Como avalio a taxa de recall de uma consulta?
R: crie dois índices com configurações idênticas, um usando o algoritmo HNSW e o outro usando o algoritmo de busca linear. A partir de um cliente, envie os mesmos dados vetoriais para ambos os índices. Após a atualização dos índices, use o mesmo vetor de consulta para recuperar os IDs de documentos de ambos. A taxa de recall é o número de IDs de documentos intersectados de ambos os índices dividido pelo número total de IDs do índice de busca linear.
-
P: O que devo fazer se ocorrer um erro
circuitBreakingExceptiondurante as gravações no cluster?R: Este erro indica que o uso de memória off-heap excedeu o limiar especificado por indices.breaker.vector.native.indexing.limit (70% por padrão), acionando o circuit breaker nas operações de gravação. O circuit breaker geralmente se redefine automaticamente após a conclusão da criação do índice em segundo plano e a liberação da memória. Recomendamos adicionar um mecanismo de nova tentativa (retry) ao seu cliente.
-
P: Por que o uso da CPU permanece alto após a interrupção das operações de gravação?
R: A criação do índice vetorial ocorre durante as fases de refresh ou flush. Mesmo após a interrupção do tráfego de gravação, as tarefas em segundo plano para a criação do índice vetorial podem continuar em execução. Essas tarefas liberam recursos de computação após a conclusão do ciclo final de refresh.
-
P: Ao consultar com o plugin aliyun-knn, recebo o seguinte erro:
class_cast_exception: class org.apache.lucene.index.SoftDeletesDirectoryReaderWrapper$SoftDeletesFilterCodecReader cannot be cast to class org.apache.lucene.index.SegmentReader (org.apache.lucene.index.SoftDeletesDirectoryReaderWrapper$SoftDeletesFilterCodecReader and org.apache.lucene.index.SegmentReader are in unnamed module of loader 'app'). O que devo fazer?R: Desative o recurso de replicação física para o índice. Para mais informações, consulte Use the physical replication feature of the apack plug-in.
-
P: O que posso fazer se a busca vetorial com o plugin aliyun-knn estiver lenta ou ocorrer circuit breaker relacionado à memória?
R: O plugin aliyun-knn realiza a busca vetorial usando vetores em memória, o que é um processo que consome muita memória. O sistema pode apresentar lentidão ou acionar o circuit breaker ao carregar índices grandes na memória. Como prática recomendada, limite o tamanho dos dados do seu índice à metade da memória disponível da máquina. Se não for possível reduzir o volume de dados e a memória permanecer insuficiente, upgrade the cluster configuration.
-
P: Em cenários kNN, uma consulta
must_not existsfalha ao filtrar documentos com um campo 'feature' vazio. Como posso escrever uma consulta para filtrar esses dados?R: O mecanismo de armazenamento para dados kNN é único e pode ser incompatível com certas consultas DSL. Use o seguinte script para filtrar os dados.
GET jx-similar-product-v1/_search
{
   "query": {
     "bool": {
       "must": {
         "script": {
           "script": {
             "source": "doc['feature'].empty",
             "lang": "painless"
             }
         }
       }
     }
   }
}