Use pipelines do Alibaba Cloud Logstash para sincronizar dados do Azure Event Hubs com uma instância do Alibaba Cloud Elasticsearch.
Procedimento
Etapa 1: Preparar o ambiente e as instâncias
-
Crie uma instância do Alibaba Cloud Elasticsearch e ative a indexação automática. Este exemplo usa uma instância da versão 7.10.
-
Crie uma instância do Alibaba Cloud Logstash e configure a transmissão de dados pela Internet. Este exemplo usa uma instância da versão 7.4.
Para mais informações, consulte
Criar uma instância do Alibaba Cloud Logstash
.
As instâncias do Alibaba Cloud Logstash são implantadas em uma VPC. A instância do Logstash precisa acessar a internet para se comunicar com o Azure Event Hubs. Para habilitar o acesso à internet, configure um NAT Gateway. Para mais informações, consulte
Configurar transmissão de dados pela Internet usando um NAT Gateway
.
NotaPara uma configuração de Logstash autogerenciado, use uma instância ECS na mesma VPC da instância do Alibaba Cloud Elasticsearch. Se você já tiver uma instância ECS adequada, não será necessário criar uma nova. Associe um Elastic IP Address (EIP) à instância ECS.
-
Prepare o ambiente do Azure Event Hubs.
Etapa 2: Criar e configurar um pipeline do Logstash
Acesse a página Logstash Clusters.
-
Acesse o cluster de destino.
Na barra de navegação superior, selecione a região onde o cluster está localizado.
Na página Logstash Clusters, localize o cluster e clique no respectivo ID.
No painel de navegação à esquerda, clique em Pipelines.
Clique em Create Pipeline.
-
Na página Create, insira um Pipeline ID e configure o pipeline.
Este exemplo usa a seguinte configuração de pipeline:
input {
  azure_event_hubs {
     event_hub_connections => ["Endpoint=sb://abc-****.****.cn/;SharedAccessKeyName=gem-****-es-consumer;SharedAccessKey=******;EntityPath=xxxxxx"]
     initial_position => "beginning"
     threads => 2
     decorate_events => true
     consumer_group => "group-kl"
     storage_connection => "DefaultEndpointsProtocol=https;AccountName=xxxxx;AccountKey=*******;EndpointSuffix=core.****.cn"
     storage_container => "lettie_container"
   }
}
filter {

}
output {
  elasticsearch {
    hosts => ["es-cn-tl****5r50005adob.elasticsearch.aliyuncs.com:9200"]
    index => "test-log"
    password => "xxxxxx"
    user => "elastic"
  }
}
Tabela 1. Parâmetros de entrada Parâmetro Descrição event_hub_connections Lista de strings de conexão dos event hubs de origem. A string de conexão inclui o EntityPath do event hub. Para mais informações, consulte event_hub_connections. Nota Cada event hub define seu próprio parâmetro event_hub_connections. Os demais parâmetros são compartilhados entre todos os event hubs.initial_position Posição no event hub onde a leitura de dados começa. Valores válidos: beginning (padrão), end e look_back. Para mais informações, consulte initial position . threads Número total de threads para processamento de eventos. Para mais informações, consulte threads. decorate_events Define se os metadados do event hub devem ser sincronizados. Os metadados incluem nome do event hub, consumer group, host do processador, partição, offset, número de sequência, timestamp e tamanho do evento. Para mais informações, consulte decorate events. consumer_group Grupo de consumidores usado para ler dados do event hub. Crie um consumer group dedicado para o Logstash e garanta que todos os nós do Logstash usem esse grupo para assegurar a coordenação adequada. Para mais informações, consulte consumer group. storage_connection String de conexão da conta de armazenamento Blob. Essa conta mantém os offsets entre reinicializações e permite que múltiplos nós do Logstash processem partições diferentes. Se este parâmetro for definido, o processamento retomará do último checkpoint após uma reinicialização. Caso contrário, o processamento iniciará na posição especificada pelo parâmetro initial_position. Para mais informações, consulte storage connection. storage_container Nome do contêiner de armazenamento usado para persistir offsets e coordenar múltiplos nós do Logstash. Para mais informações, consulte storage container. Nota Para evitar a sobrescrita de offsets, use um nome de storage_container diferente. Se você gravar os mesmos dados em serviços distintos, defina este parâmetro com um nome exclusivo para cada service.Tabela 2. Parâmetros de saída Parâmetro
Descrição
hosts
Endpoint do service Alibaba Cloud Elasticsearch. Defina o valor como
http://<ID da instância do Alibaba Cloud Elasticsearch>.elasticsearch.aliyuncs.com:9200.index
Nome do índice de destino.
user
Nome de usuário para acessar o service Elasticsearch. O valor padrão é elastic.
password
Senha do usuário especificado. No Alibaba Cloud Elasticsearch, a senha do usuário elastic é definida durante a criação da instância. Caso tenha esquecido a senha, redefina-a. Para mais informações, consulte Redefinir a senha de acesso de uma instância.
Para mais informações sobre as configurações do Config, consulte Arquivos de configuração do Logstash.
-
Clique em Next step e configure os parâmetros do pipeline.
Parâmetro
Descrição
Pipeline Workers
Número de threads de trabalho para as etapas de filtro e saída. Aumente este valor se houver acúmulo de eventos ou subutilização da CPU. Padrão: número de núcleos da CPU.
Pipeline Batch Size
Quantidade máxima de eventos que um worker coleta antes de executar filtros e saídas. Lotes maiores aumentam o uso de memória e podem exigir um tamanho maior para o heap da JVM (LS_HEAP_SIZE). Padrão: 125.
Pipeline Batch Delay
Tempo de espera em milissegundos antes de enviar um lote incompleto para uma thread de trabalho. Padrão: 50 ms.
Queue Type
Modelo de fila interna para buffer de eventos entre as etapas. Valores válidos:
-
MEMORY: Padrão. Usa uma fila em memória.
-
PERSISTED: Fila persistente baseada em disco.
Queue Max Bytes
Quantidade máxima de dados que a fila pode armazenar, em
MB. O valor deve ser um inteiro de1a253-1. Valor padrão:1024.NotaCertifique-se de que este valor seja menor que a capacidade total do disco.
Queue Checkpoint Writes
Número máximo de eventos gravados antes que um checkpoint seja forçado (apenas para fila persistente). 0 significa sem limite. Padrão: 1024.
AvisoSalvar e implantar a configuração aciona uma reinicialização da instância. Prossiga apenas quando isso não afetar seus negócios.
-
-
Clique em Save ou Save and Deploy.
Save: Salva a configuração do pipeline, mas não a aplica. Após salvar, você retorna à página Pipelines. Na seção Pipelines, clique em Deploy Now na coluna Actions para reiniciar a instância e aplicar a configuração.
Save and Deploy: Salva e implanta a configuração, reiniciando a instância para aplicar as alterações.
Etapa 3: Verificar o resultado
Faça logon no console do Kibana do cluster Elasticsearch e acesse a página inicial do Kibana.
No menu de navegação à esquerda, clique em Dev tools.
-
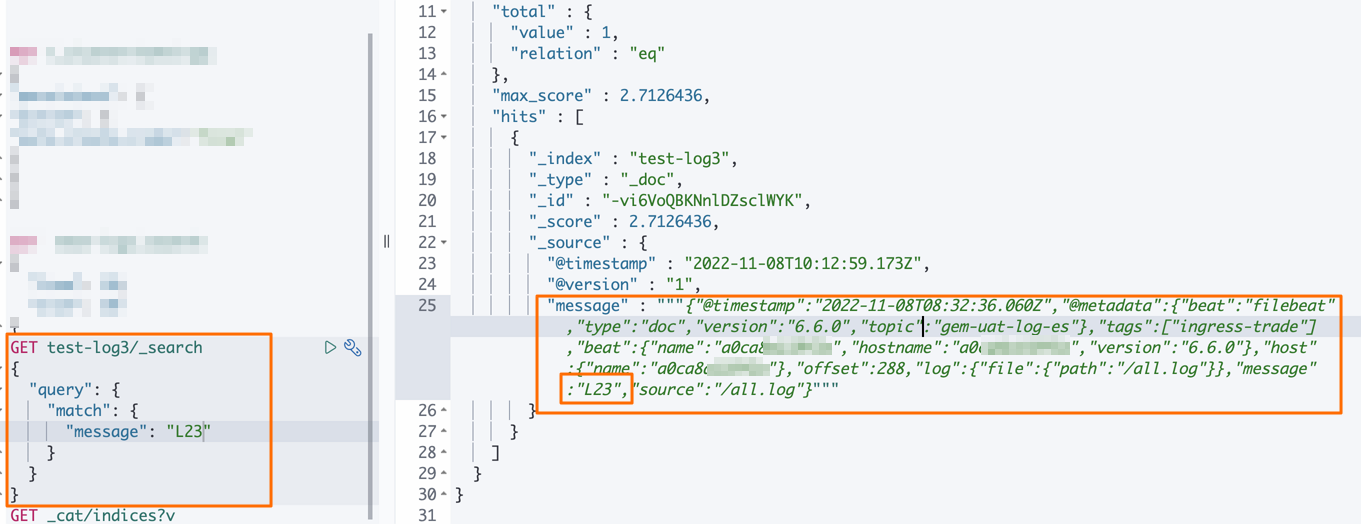
No Console, execute o comando abaixo para visualizar os dados sincronizados.
GET test-log3/_search
{
  "query":{
    "match":{
      "message":"L23"
     }
   }
}
O resultado esperado é o seguinte.