Este tópico descreve como migrar dados de índice do Amazon Web Services (AWS) ES para o Alibaba Cloud Elasticsearch. A solução utiliza migração baseada em snapshot: crie um snapshot dos dados do AWS ES no AWS S3, transfira os dados do snapshot para o Alibaba Cloud OSS e restaure os índices no Alibaba Cloud Elasticsearch.
Como funciona
A migração baseia-se no mecanismo de snapshot do Elasticsearch e não depende de um fornecedor de cloud específico: crie um snapshot no cluster de origem do AWS ES e armazene-o em um bucket do AWS S3, transfira os dados do snapshot para o Alibaba Cloud OSS e restaure os índices do OSS no cluster de destino do Alibaba Cloud Elasticsearch. Você também pode transferir os dados do snapshot entre clouds com a ferramenta Migration Implementation, aplicável também a dados de snapshot do ES armazenados no Tencent Cloud COS. A operação de restauração utiliza o recurso Manual Backup and Restoration do ES.
Um snapshot do ES só pode ser restaurado em um cluster que execute a mesma versão ou uma versão posterior. Essa restrição se aplica até a versão de patch. Para mais informações, consulte Compatibilidade de snapshots. Por exemplo, se o cluster de origem do AWS ES executar a versão 7.10.2 e você selecionar a 7.10.0 para o cluster de destino do Alibaba Cloud Elasticsearch, a operação de restauração falhará e retornará the snapshot was created with Elasticsearch version [7.10.2] which is higher than the version of this node [7.10.0]. Nesse caso, selecione uma versão posterior, como a 7.16.2.
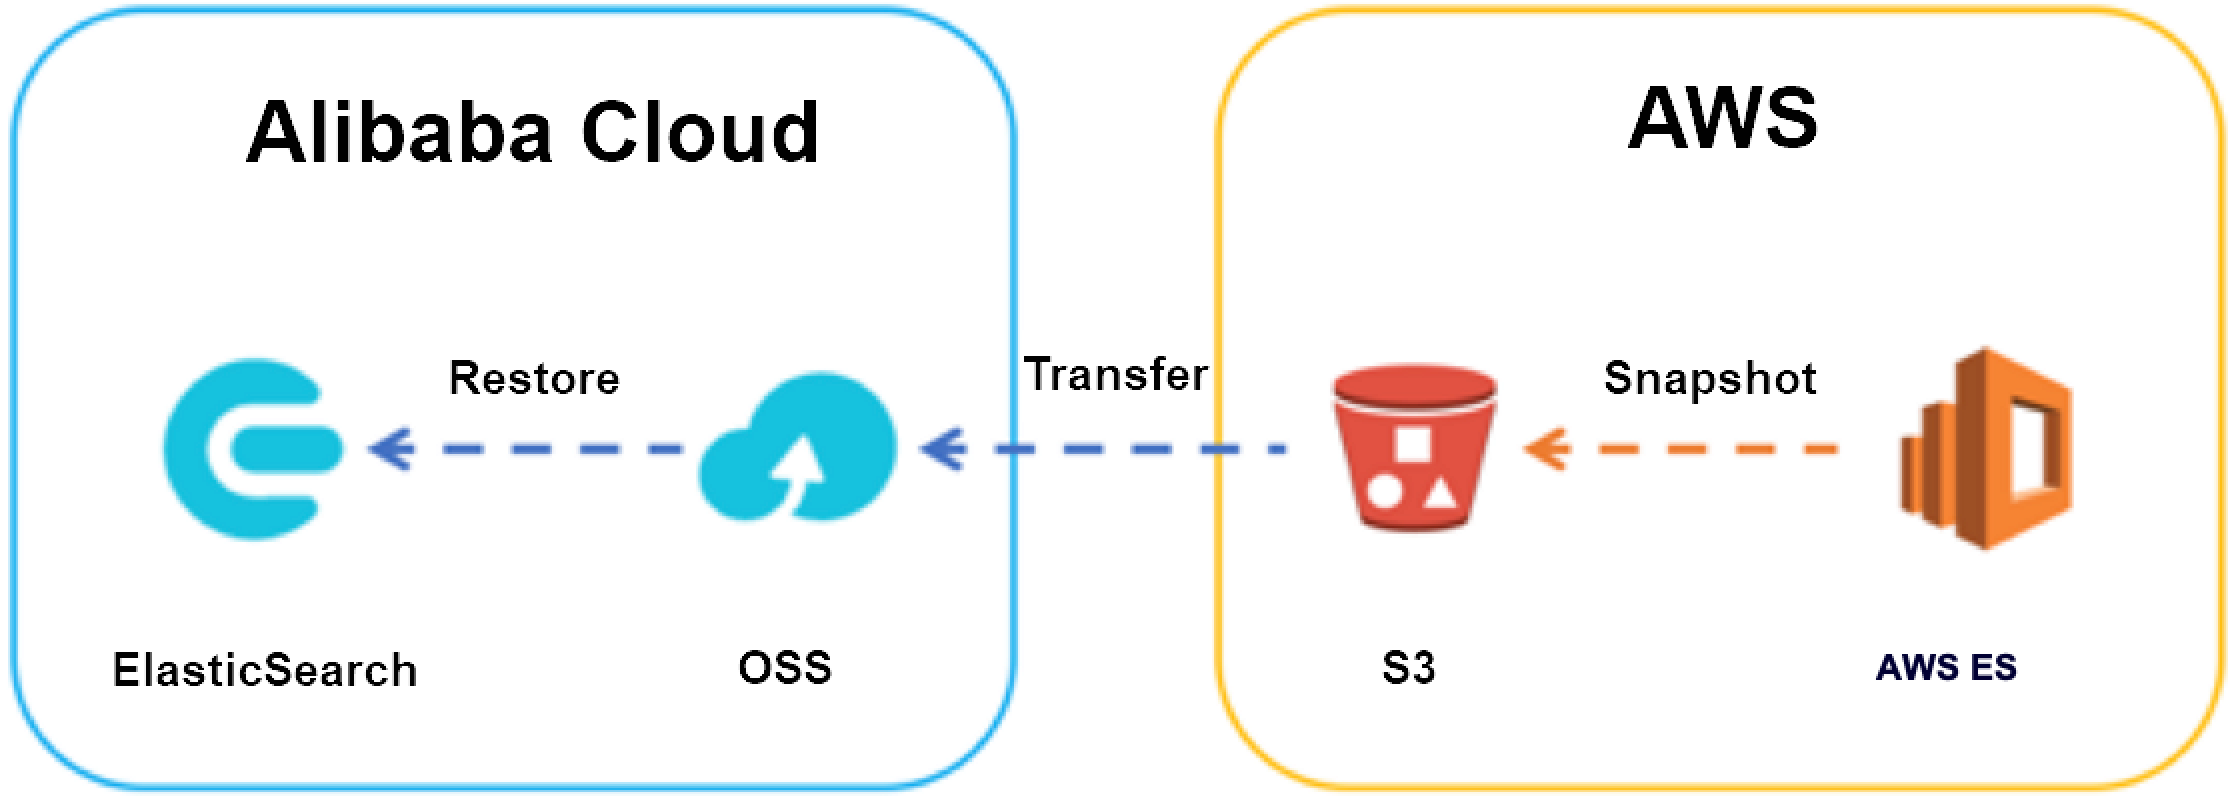
A migração consiste em quatro fases que correspondem diretamente aos quatro passos deste tópico:
Prepare os recursos: o domínio da AWS, o bucket do AWS S3, a função e a política do IAM na origem, além do cluster do Alibaba Cloud Elasticsearch e do bucket do OSS no destino.
Registre um repositório de snapshot que aponte para o bucket do S3 no AWS ES.
Migre o primeiro snapshot completo: crie o snapshot, transfira-o para o OSS, registre o repositório do OSS no Alibaba Cloud Elasticsearch e restaure os índices.
Migre snapshots incrementais e faça o switchover: interrompa as gravações no cluster de origem, crie o snapshot incremental, transfira-o para o OSS, restaure o snapshot, verifique a contagem de documentos e direcione o tráfego do service para o novo ambiente.
Passo 1: Preparar os recursos necessários para a migração
Apenas snapshots manuais armazenados em seu próprio bucket do AWS S3 podem ser migrados. Os snapshots criados automaticamente pela AWS todos os dias são retidos por 14 dias, não podem ser migrados para outro domínio e servem apenas para restaurar o domínio atual. Snapshots manuais são cobrados conforme as taxas padrão do AWS S3. Conclua as preparações a seguir antes de iniciar a migração.
Preparar os recursos de origem da AWS
-
Crie um domínio da AWS. O Amazon OpenSearch Service descontinuou versões antigas do Elasticsearch, como a 7.1.0.0. Utilize uma das versões disponíveis atualmente no console. Este tópico usa o Elasticsearch 7.10.2 como exemplo. Qualquer região é válida; este tópico utiliza us-east-1. Para mais informações, consulte Criando e gerenciando domínios do Amazon OpenSearch Service.
NotaSe o controle de acesso refinado estiver ativado para o domínio e o tipo de usuário mestre for IAM, ou se a política de acesso do domínio permitir apenas principais do IAM (por exemplo,
es:ESHttp*concedido apenas ao usuário raiz da conta), não será possível fazer login no console do Kibana do domínio pelo navegador. A solicitação retornará o erro 403User: anonymous is not authorized to perform: es:ESHttpGet. Nessa situação, execute todos os comandos do lado da AWS neste tópico como solicitações assinadas com o AWS Signature Version 4 (SigV4). Por exemplo, reutilize o cliente Python descrito no Passo 2. -
Crie um bucket do AWS S3 para armazenar os snapshots manuais e anote o Amazon Resource Name (ARN) do bucket. O ARN é utilizado em dois locais: na instrução Resource da política do IAM e no cliente Python que registra o repositório de snapshot.
O exemplo a seguir mostra um ARN.
arn:aws:s3:::eric-es-index-backups Prepare o índice que deseja migrar no AWS ES. Este tópico utiliza um índice chamado
movies.
Criar uma função do IAM e uma política do IAM
A função do IAM autoriza o AWS ES a acessar o bucket do S3, enquanto a política do IAM limita as ações que a função pode executar. É necessário criar ambos e anexar a política à função.
-
Crie uma função do IAM para autorizar o AWS ES. Essa função é obrigatória ao registrar o repositório de snapshot, e somente um usuário do IAM com permissões para assumir essa função poderá registrar o repositório.
A instrução
Servicena relação de confiança da função deve ser definida comoes.amazonaws.com, conforme mostrado no exemplo a seguir.{ "Version": "2012-10-17", "Statement": [ { "Sid": "", "Effect": "Allow", "Principal": { "Service": "es.amazonaws.com" }, "Action": "sts:AssumeRole" } ] }No console do IAM, escolha Roles no painel de navegação à esquerda, localize a função desejada, clique em Trust relationships e depois clique em Edit trust relationship para visualizar e editar a política de confiança.
NotaO AWS ES não aparece na lista suspensa Select role type ao criar uma função para um service da AWS no console do IAM. Selecione AWS EC2, crie a função e altere
ec2.amazonaws.comparaes.amazonaws.com. -
Crie uma política do IAM e anexe-a à função do IAM mencionada anteriormente para limitar as ações que a função pode realizar no bucket do S3.
A instrução Resource da política deve especificar o ARN do bucket do S3 que armazena os snapshots. O exemplo a seguir especifica o bucket
eric-es-index-backups.{ "Version": "2012-10-17", "Statement": [ { "Action": [ "s3:ListBucket" ], "Effect": "Allow", "Resource": [ "arn:aws:s3:::eric-es-index-backups" ] }, { "Action": [ "s3:GetObject", "s3:PutObject", "s3:DeleteObject" ], "Effect": "Allow", "Resource": [ "arn:aws:s3:::eric-es-index-backups/*" ] } ] }Após criar a política, verifique-a no console do IAM: escolha Policies no painel de navegação à esquerda, clique em Permissions para abrir a página de detalhes e confirme, na visualização JSON da aba Permissions, se o conteúdo corresponde ao exemplo anterior. O resumo em Policy summary indica que a política concede acesso Limitado: Listar, Ler e Gravar ao S3.
Em seguida, clique em Roles no painel de navegação à esquerda, selecione a função alvo e confirme na aba Permissions que a política está anexada.
Preparar os recursos de destino na Alibaba Cloud
Crie um cluster do Alibaba Cloud Elasticsearch na região China (Hangzhou). A versão do cluster deve ser igual ou superior à versão exata de patch do cluster de origem do AWS ES. Se o cluster de origem executar a 7.10.2, selecione a 7.16.2. Para mais informações, consulte Create an Alibaba Cloud Elasticsearch cluster.
Crie um bucket do OSS para receber os dados do snapshot transferidos do AWS S3. O bucket utilizado neste tópico reside na região China (Hangzhou), usa a classe de armazenamento Standard e ACL privado, mantendo os valores padrão para todos os outros parâmetros. Para mais informações, consulte Create buckets.
Passo 2: Registrar um repositório de snapshot no AWS ES
Snapshots manuais só podem ser criados após o registro de um repositório de snapshot apontando para o bucket do S3 no AWS ES. O usuário ou a função especificado na relação de confiança da função do IAM criada em Step 1: Prepare the resources required for the migration deve assinar a solicitação de registro com o AWS Signature Version 4 (SigV4). Como o comando curl não oferece suporte à assinatura de solicitações da AWS, utilize o cliente Python a seguir para registrar o repositório.
Preparar o script de registro
Baixe o arquivo register_snapshot_repository.py.
-
Modifique os valores dos parâmetros indicados pelos comentários no script e salve-o como snapshot.py.
A tabela a seguir descreve os parâmetros.
Parâmetro
Descrição
region
Região da AWS onde o repositório de snapshot será criado.
host
Endpoint do domínio do AWS ES.
aws_access_key_id
ID da credencial do IAM.
aws_secret_access_key
Chave da credencial do IAM.
service
Identificador do service da AWS usado para assinatura. Para o Amazon OpenSearch Service, incluindo suas versões do Elasticsearch, o valor é sempre
es.url
URL da solicitação para registrar o repositório de snapshot, no formato
https://{host}/_snapshot/{repository-name}. O nome do repositório deve ser idêntico ao nome usado durante a criação e restauração dos snapshots.payload
Deve incluir o nome e o ARN do bucket do S3 criado para a função do IAM em Step 1: Prepare the resources required for the migration.
Importante-
Recomendamos adicionar
"base_path": "<custom-prefix>"às configurações para que os arquivos de snapshot deste cluster fiquem armazenados sob o prefixo especificado, evitando compartilhar o caminho com snapshots de outros clusters no mesmo bucket do S3. Para mais informações, veja a descrição sobre unicidade do repositório na seção FAQ. Anote o prefixo: o valor debase_pathdefinido ao registrar o repositório do OSS no Alibaba Cloud Elasticsearch deve corresponder exatamente ao prefixo real dos dados de snapshot no OSS. -
Para ativar a criptografia no lado do servidor com chaves gerenciadas pelo S3 no repositório de snapshot, adicione
"server_side_encryption": trueao JSON de configurações. -
Caso o bucket do S3 esteja na região ap-southeast-1, utilize
"endpoint": "s3.amazonaws.com"em vez de"region": "ap-southeast-1".
-
Instalar as dependências e executar o registro
-
Instale as dependências exigidas pelo cliente Python de exemplo.
O cliente Python de exemplo envia solicitações usando requests e assina essas solicitações com requests-aws4auth. Instale ambas as dependências na máquina que executará o registro, em um ambiente Python 3.
pip install requests requests_aws4auth -
Execute o cliente Python para registrar o repositório de snapshot. Se o registro for bem-sucedido, o código de status HTTP 200 e
{"acknowledged" : true}serão retornados.python snapshot.py
Verificar o resultado do registro
-
Faça login no console do Kibana do domínio do AWS ES e execute o comando abaixo na página Dev Tools > Console para visualizar o resultado. Caso o controle de acesso refinado esteja ativado para o domínio, ou a política de acesso permita apenas principais do IAM impedindo o login no Kibana, execute o mesmo comando como uma solicitação assinada. Por exemplo, reutilize o cliente Python anterior e altere o método da solicitação para GET.
GET _snapshotA resposta retorna a configuração dos repositórios de snapshot registrados. O repositório criado automaticamente pelo sistema chama-se
cs-automated. Se a criptografia em repouso estiver ativada para o domínio, o repositório será nomeadocs-automated-enc.{ "eric-snapshot-repository": { "type": "s3", "settings": { "bucket": "eric-es-index-backups", "base_path": "eric-aws", "region": "us-east-1", "role_arn": "arn:aws:iam::xxx:role/eric-iam-role-es" } }, "cs-automated-enc": { "type": "s3" } }
Passo 3: Migrar o primeiro snapshot completo
Esta etapa migra todos os dados existentes no cluster de origem para o cluster de destino: crie um snapshot completo no AWS ES, transfira os dados do snapshot para o Alibaba Cloud OSS, registre o repositório do OSS no Alibaba Cloud Elasticsearch e restaure os índices.
Criar um snapshot completo no AWS ES
Execute os comandos do lado da AWS na página Dev Tools do console do Kibana do domínio do AWS ES. Se não for possível fazer login no console do Kibana do domínio pelo navegador, execute os mesmos comandos como solicitações assinadas com SigV4.
-
Crie um snapshot chamado
snapshot_movies_1para o índicemoviesno repositórioeric-snapshot-repository.PUT _snapshot/eric-snapshot-repository/snapshot_movies_1 { "indices": "movies" } -
Verifique o status do snapshot. Se
stateforSUCCESS, o snapshot foi criado com êxito.GET _snapshot/eric-snapshot-repository/snapshot_movies_1{ "snapshots": [ { "snapshot": "snapshot_movies_1", "uuid": "BlgKLvgoSpSgwBnbD4hIWg", "version_id": 7100299, "version": "7.10.2", "indices": [ "movies" ], "data_streams": [], "include_global_state": true, "state": "SUCCESS", "start_time": "2018-02-28T03:00:44.591Z", "start_time_in_millis": 1519786844591, "end_time": "2018-02-28T03:00:46.236Z", "end_time_in_millis": 1519786846236, "duration_in_millis": 1645, "failures": [], "shards": { "total": 5, "failed": 0, "successful": 5 } } ] } -
Confirme no console do AWS S3 que os arquivos do snapshot foram gerados.
Após a criação do snapshot, o bucket do S3 eric-es-index-backups conterá os arquivos gerados, incluindo a pasta
indices,index-0,index.latest,meta-BlgKLvgoSpSgwBhbD4hTWg.datesnap-BlgKLvgoSpSgwBhbD4hTWg.dat.
Transferir os dados do snapshot para o Alibaba Cloud OSS
Transfira os dados do snapshot do AWS S3 para o Alibaba Cloud OSS. Para mais informações, consulte Migrate applications from Amazon S3 to OSS.
Após concluir a transferência, confirme no console do OSS que os dados do snapshot estão no local correto.
O bucket do OSS contém os seguintes arquivos de snapshot: indices/ (pasta), index-0, index.latest, meta-BlgKLvgoSpSgwBhbD4hTWg.dat e snap-BlgKLvgoSpSgwBhbD4hTWg.dat.
Registrar um repositório de snapshot do OSS no Alibaba Cloud Elasticsearch
-
Crie um repositório de snapshot.
Durante uma migração de snapshot do Elasticsearch, garanta que cada cluster utilize um repositório ou caminho de snapshot dedicado. Se vários clusters compartilharem o mesmo repositório, a restauração de dados poderá falhar e ocorrer perda de dados.
Faça login no console do Kibana do cluster de destino do Alibaba Cloud Elasticsearch (Log on to the Kibana console) e execute o comando a seguir na página Dev Tools > Console para criar um repositório de snapshot com o mesmo nome. O valor de
base_pathdeve corresponder ao prefixo real dos dados de snapshot após a transferência para o OSS. Se nenhumbase_pathtiver sido configurado para o repositório no lado da AWS e os arquivos de snapshot estiverem no diretório raiz do bucket, não configurebase_pathaqui também.PUT _snapshot/eric-snapshot-repository { "type": "oss", "settings": { "base_path": "my/snapshot/directory", "endpoint": "http://oss-cn-hangzhou-internal.aliyuncs.com", "access_key_id": "your AccessKeyID", "secret_access_key": "your AccessKeySecret", "bucket": "eric-oss-aws-es-snapshot-s3", "compress": true } } -
Verifique o status do snapshot chamado
snapshot_movies_1.GET _snapshot/eric-snapshot-repository/snapshot_movies_1Se
statena resposta forSUCCESS, o Alibaba Cloud Elasticsearch consegue ler o snapshot do repositório do OSS. Casosnapshot_missing_exceptionseja retornado, verifique sebase_pathcorresponde ao prefixo real dos dados de snapshot no OSS.NotaAnote a hora de início e a hora de término deste snapshot. Esses valores são necessários para migrar os dados do snapshot incremental. Exemplo:
"start_time_in_millis": 1519786844591
"end_time_in_millis": 1519786846236
Restaurar os índices e verificar os dados
Execute o comando a seguir no console do Kibana do cluster do Alibaba Cloud Elasticsearch para restaurar o snapshot.
POST _snapshot/eric-snapshot-repository/snapshot_movies_1/_restore
{
    "indices": "movies"
}
Execute o comando abaixo para verificar a disponibilidade do índice movies.
GET movies/_recoveryApós a conclusão da restauração, o número de documentos no índice movies será igual ao número existente no domínio do AWS ES.
Também é possível verificar os dados no console do Kibana do cluster do Alibaba Cloud Elasticsearch: na página Discover, selecione o índice movies. Neste exemplo, três documentos são retornados após a restauração (The Manchurian Candidate, Mars Attacks! e U.S. Marshals), quantidade idêntica à do cluster de origem.
Passo 4: Migrar snapshots incrementais e fazer o switchover
Depois de migrar o primeiro snapshot completo, sincronize os dados gravados no cluster de origem nesse intervalo por meio de snapshots incrementais. Antes do switchover definitivo, interrompa todos os services que possam modificar os índices no cluster de origem e execute esta etapa para garantir que o último snapshot incremental contenha todos os dados. O exemplo a seguir grava mais 2 documentos no cluster de origem.
Criar um snapshot incremental no AWS ES
-
Grave dados incrementais no índice
moviesno AWS ES.Neste exemplo, 2 documentos são gravados. Após a operação de gravação, o índice
moviescontém 5 documentos cujos valores de_idvariam de 1 a 5. ExecuteGET movies/_countpara conferir a contagem atual de documentos, que servirá para comparação com o cluster de destino. -
Crie o snapshot incremental.
Execute o comando a seguir para criar manualmente um snapshot. Para mais informações, consulte Create a full snapshot in AWS ES.
PUT _snapshot/eric-snapshot-repository/snapshot_movies_2
{
"indices": "movies"
}
Após a criação do snapshot, execute o comando abaixo para verificar seu status.
GET _snapshot/eric-snapshot-repository/snapshot_movies_2Visualize os novos arquivos de snapshot no console do AWS S3.
O bucket do S3 lista todos os arquivos do repositório de snapshot. Os novos arquivos correspondentes a
snapshot_movies_2sãosnap-CWhlF7ShQZaKQlJasPE70A.dat,index.latest,index-1emeta-CWhlF7ShQZaKQlJasPE70A.dat.
Transferir os dados do snapshot incremental para o Alibaba Cloud OSS
Transfira os dados do snapshot incremental do AWS S3 para o Alibaba Cloud OSS utilizando o ossimport. O bucket do S3 já contém os arquivos do primeiro snapshot. Recomendamos definir isSkipExistFile como true no arquivo de configuração local_job.cfg para transferir apenas os novos arquivos de snapshot.
isSkipExistFile é um parâmetro booleano. O valor padrão false indica que objetos existentes serão sobrescritos. Se o valor for true, os objetos já migrados serão ignorados com base nos valores de size e LastModifiedTime dos objetos. Esse parâmetro não tem efeito quando jobType é audit.
Após a conclusão da transferência, os novos arquivos de snapshot aparecerão no OSS.
Depois que os arquivos incrementais forem transferidos para o OSS, o Alibaba Cloud Elasticsearch continuará usando o conteúdo do repositório em cache. Como resultado, GET _snapshot/eric-snapshot-repository/_all ainda poderá retornar apenas o primeiro snapshot. No console do Kibana do cluster do Alibaba Cloud Elasticsearch, registre novamente o repositório do OSS com o mesmo nome: execute primeiro DELETE _snapshot/eric-snapshot-repository e recrie o repositório usando o comando PUT descrito no Passo 3. Confirme que o novo snapshot está visível e restaure o snapshot incremental.
Os novos arquivos são index-1, index.latest, meta-CWhIF7ShQZaKQUasPE70A.dat e snap-CWhIF7ShQZaKQUasPE70A.dat.
Restaurar o snapshot incremental e direcionar o tráfego do service
Os comandos para restaurar o snapshot incremental são os mesmos descritos em Step 3: Migrate the first full snapshot. No entanto, é necessário fechar o índice movies antes da restauração e reabrir o índice movies após a restauração.
-
Feche o índice
movies.POST /movies/_close -
Verifique o status do índice
moviese confirme se o estado mudou paraclose. Não é possível usarGET movies/_statspara consultar um índice fechado, pois a solicitação retornaráindex_closed_exception. Execute o comando a seguir em vez disso.GET _cat/indices/movies?v -
Restaure o snapshot incremental.
POST _snapshot/eric-snapshot-repository/snapshot_movies_2/_restore { "indices": "movies" } -
Abra o índice
movies.POST /movies/_open
Após a conclusão da restauração, execute GET movies/_count para verificar o número de documentos. Neste exemplo, o cluster de destino retorna 5, valor idêntico ao do cluster de origem do AWS ES. Agora é possível direcionar o tráfego do service para o cluster do Alibaba Cloud Elasticsearch.
FAQ
Por que a unicidade do repositório é necessária?
Se vários clusters do Elasticsearch, incluindo o cluster de origem e o de destino, utilizarem o mesmo repositório de snapshot simultaneamente, ocorrerão os seguintes problemas:
Conflitos de metadados: Vários clusters operando no mesmo repositório podem sobrescrever ou corromper arquivos de metadados, impedindo a identificação correta dos snapshots.
Sobrescrita de dados: Snapshots de clusters diferentes podem sobrescrever os arquivos de dados uns dos outros, causando perda ou corrupção de dados.
Falhas na restauração: O Elasticsearch não consegue determinar quais dados pertencem a qual cluster, fazendo com que as operações de restauração falhem ou restaurem dados incorretos.
Portanto, utilize um repositório de snapshot dedicado para cada cluster do Elasticsearch ou use base_path para separar caminhos dentro do mesmo bucket. Se vários clusters precisarem acessar o mesmo repositório, conceda permissões de gravação a apenas um cluster e registre o repositório com "readonly": true nos demais clusters, para que se conectem ao repositório em modo somente leitura.
Por que ocorre um erro quando o Alibaba Cloud Elasticsearch restaura dados de índice de um snapshot no OSS?
A causa pode ser um nome de diretório vazio terminado com barra (/) ou outros caracteres especiais no caminho do OSS onde os dados do snapshot estão armazenados. Por exemplo, um nível anômalo chamado "/" pode aparecer no console do OSS.
O Alibaba Cloud Elasticsearch não suporta esses caracteres nos caminhos dos arquivos de snapshot. Para resolver o problema, utilize ossbrowser para mover os dados do snapshot no OSS para uma pasta com um nome válido.