O Stream Load é um método síncrono baseado em HTTP para carregar arquivos CSV de uma máquina local para o StarRocks. Como os resultados são retornados imediatamente após a conclusão de cada job, o Stream Load é ideal para cenários em que é necessário confirmar o sucesso antes de prosseguir.
Quando usar o Stream Load: O Stream Load funciona melhor para arquivos de até 10 GB armazenados localmente ou em memória. Para arquivos maiores ou armazenamento conectado à rede, utilize o Broker Load.
Como funciona
Envie um job de importação por meio de uma requisição HTTP PUT para o nó frontend (FE). O nó FE redireciona a requisição para um nó backend (BE), que atua como coordenador: divide os dados conforme o schema da tabela, distribui para os nós BE relevantes e retorna o resultado.
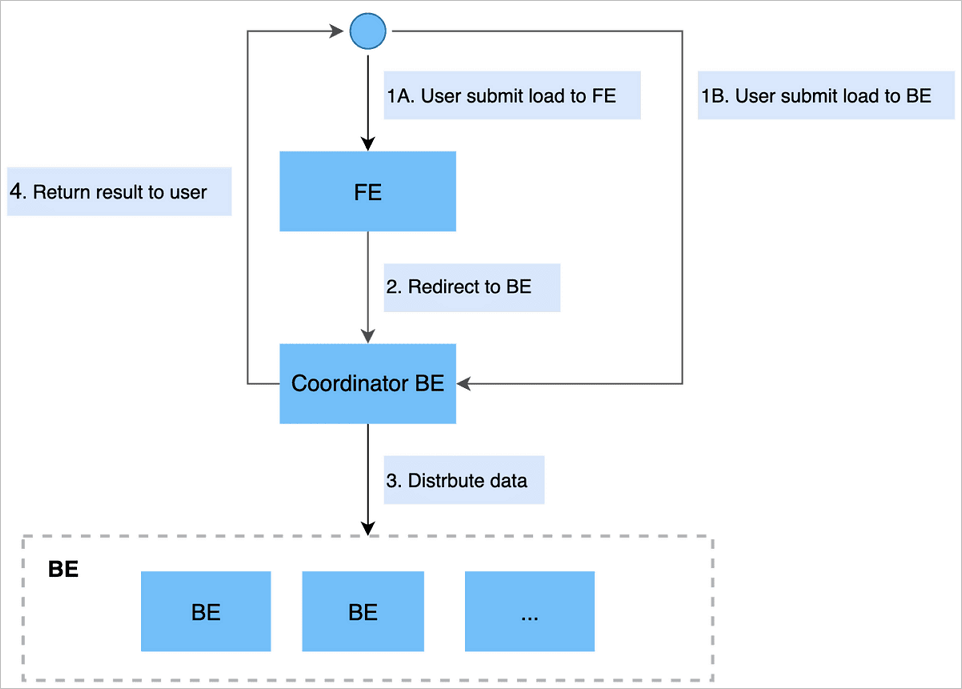
Envie a requisição diretamente para um nó BE para evitar o redirecionamento.
Pré-requisitos
Antes de começar, certifique-se de que:
A máquina que executa a importação tenha acesso de rede ao nó FE na porta 8030 e aos nós BE na porta 8040.
Enviar um job de importação
Todos os parâmetros do Stream Load são passados como cabeçalhos HTTP no formato -H "key:value". O exemplo abaixo utiliza curl.
Sintaxe
curl --location-trusted -u <user>:<password> \
  [-H "<header-key>:<header-value>" ...] \
  -T <data-file> -XPUT \
  http://<fe-host>:8030/api/<db>/<table>/_stream_load
Observações sobre codificação HTTP:
Para transferência sem chunked encoding, inclua o cabeçalho
Content-Lengthpara preservar a integridade dos dados.Defina o cabeçalho
Expectcomo100-continuepara evitar o envio de dados caso o servidor retorne um erro antecipado.
Parâmetros
|
Parâmetro |
Obrigatório |
Descrição |
|
|
Sim |
Credenciais para autenticação básica HTTP. O StarRocks verifica a identidade e as permissões de importação com base nesta assinatura. |
|
|
Não |
Rótulo exclusivo para o job de importação. O StarRocks rejeita rótulos duplicados para jobs concluídos nos últimos 30 minutos. Se omitido, um rótulo é gerado automaticamente. |
|
|
Não |
Delimitador de colunas no arquivo de origem. Padrão: |
|
|
Não |
Delimitador de linhas no arquivo de origem. Padrão: |
|
|
Não |
Mapeamento de colunas entre o arquivo de origem e a tabela do StarRocks. Necessário quando as colunas diferem em ordem, quantidade ou quando são necessárias colunas computadas. Consulte Exemplos de mapeamento de colunas. |
|
|
Não |
Condição de filtro para excluir linhas. Por exemplo, |
|
|
Não |
Fração máxima de linhas filtráveis devido a problemas de qualidade. Padrão: |
|
|
Não |
Partições de destino para a importação. Linhas fora das partições especificadas são filtradas. Exemplo: |
|
|
Não |
Tempo limite do job de importação em segundos. Padrão: |
|
|
Não |
Ativa a verificação rigorosa de tipos. Padrão: ativado. Para desativar: |
|
|
Não |
Fuso horário para funções sensíveis a fuso. Padrão: |
|
|
Não |
Limite de memória para o job de importação. Padrão: |
Exemplos de mapeamento de colunas
Exemplo 1 — Reordenar colunas: A tabela do StarRocks possui as colunas c1, c2, c3. O arquivo de origem tem três colunas na ordem c3, c2, c1:
-H "columns: c3, c2, c1"Exemplo 2 — Coluna extra no arquivo de origem: A tabela do StarRocks tem c1, c2, c3. O arquivo de origem possui quatro colunas, sendo que a quarta não corresponde a nenhuma coluna da tabela:
-H "columns: c1, c2, c3, temp"Atribua um nome de espaço reservado (como temp) à coluna sem correspondência.
Exemplo 3 — Colunas computadas: A tabela do StarRocks contém year, month, day. O arquivo de origem tem uma coluna no formato 2018-06-01 01:02:03:
-H "columns: col, year = year(col), month=month(col), day=day(col)"Exemplo
curl --location-trusted -u root \
  -T /mnt/disk1/data.csv \
  -H "label:load-20240101" \
  -H "column_separator:|" \
  http://fe-c-xxxx-internal.starrocks.aliyuncs.com:8030/api/test/orders/_stream_load
Resultado da importação
Após a conclusão do job, o StarRocks retorna um resultado em JSON:
{
    "TxnId": 11672,
    "Label": "f6b62abf-4e16-4564-9009-b77823f3c024",
    "Status": "Success",
    "Message": "OK",
    "NumberTotalRows": 199563535,
    "NumberLoadedRows": 199563535,
    "NumberFilteredRows": 0,
    "NumberUnselectedRows": 0,
    "LoadBytes": 50706674331,
    "LoadTimeMs": 801327,
    "BeginTxnTimeMs": 103,
    "StreamLoadPlanTimeMs": 0,
    "ReadDataTimeMs": 760189,
    "WriteDataTimeMs": 801023,
    "CommitAndPublishTimeMs": 199
}|
Campo |
Descrição |
|
|
ID da transação do job de importação. |
|
|
Rótulo utilizado no job. |
|
|
Resultado da importação. Valores válidos: |
|
|
Status do job existente que detém o rótulo conflitante. Retornado apenas quando |
|
|
Descrição detalhada do status. Contém o motivo da falha quando |
|
|
Total de linhas lidas do fluxo de dados. |
|
|
Linhas carregadas com sucesso. Retornado apenas quando |
|
|
Linhas filtradas devido a problemas de qualidade. |
|
|
Linhas excluídas pela condição |
|
|
Tamanho do arquivo de origem em bytes. |
|
|
Duração do job de importação em milissegundos. |
|
|
URL para baixar as linhas filtradas. Apenas as primeiras 1.000 linhas filtradas são retidas. |
Tratar erros de importação
Quando ErrorURL aparecer no resultado, recupere as linhas filtradas para diagnosticar problemas:
# View error details directly
curl "http://<host>:8040/api/_load_error_log?file=<error-log-file>"

# Or download for offline analysis
wget "http://<host>:8040/api/_load_error_log?file=<error-log-file>"
Analise a saída para identificar linhas malformadas, ajuste os parâmetros de importação e reenvie o job.
Cancelar um job de importação
O Stream Load é síncrono — interrompa o processo curl para cancelar um job em andamento:
ps -ef | grep stream_load
# Then kill the relevant process
Se um job atingir o tempo limite ou encontrar um erro irrecuperável, o StarRocks o cancelará automaticamente.
Melhores práticas
Escolher o tamanho adequado de arquivo
O Stream Load apresenta melhor desempenho com arquivos entre 1 GB e 10 GB. O máximo padrão é 10 GB (controlado por streaming_load_max_mb no nó BE).
Para importar um arquivo maior que 10 GB, aumente o limite no nó BE antes de enviar o job:
curl --location-trusted -u 'admin:<password>' \
  -XPOST \
  http://<be-host>:8040/api/update_config?streaming_load_max_mb=15360
Defina o valor como pelo menos o tamanho do seu arquivo em MB. Por exemplo, um arquivo de 15 GB requer 15360.
Ajustar o tempo limite
O tempo limite padrão é de 600 segundos. Para aumentá-lo, altere o parâmetro stream_load_default_timeout_second no console do EMR:
Abra a aba Instance Configuration da sua instância StarRocks.
Atualize
stream_load_default_timeout_secondpara o valor desejado.
Exemplo completo de ponta a ponta
Este exemplo carrega um arquivo de clientes com 150.000 linhas no banco de dados stream_load.
Baixe os dados de amostra: customer.tbl
O tamanho da instância não afeta o número de jobs de importação no modo Stream Load processados simultaneamente.
Passo 1. Se o arquivo exceder 10 GB, aumente primeiro o limite do nó BE:
curl --location-trusted -u 'admin:<password>' \
  -XPOST \
  http://be-c-xxxx-internal.starrocks.aliyuncs.com:8040/api/update_config?streaming_load_max_mb=15360
Passo 2. Na aba Instance Configuration, defina stream_load_default_timeout_second como 3600.
Passo 3. Crie a tabela de destino:
CREATE TABLE `customer` (
  `c_custkey`    bigint(20)      NULL COMMENT "",
  `c_name`       varchar(65533)  NULL COMMENT "",
  `c_address`    varchar(65533)  NULL COMMENT "",
  `c_nationkey`  bigint(20)      NULL COMMENT "",
  `c_phone`      varchar(65533)  NULL COMMENT "",
  `c_acctbal`    double          NULL COMMENT "",
  `c_mktsegment` varchar(65533)  NULL COMMENT "",
  `c_comment`    varchar(65533)  NULL COMMENT ""
) ENGINE=OLAP
DUPLICATE KEY(`c_custkey`)
COMMENT "OLAP"
DISTRIBUTED BY HASH(`c_custkey`) BUCKETS 24
PROPERTIES (
  "replication_num"          = "1",
  "in_memory"                = "false",
  "storage_format"           = "DEFAULT",
  "enable_persistent_index"  = "false",
  "compression"              = "LZ4"
);
Passo 4. Envie o job de importação:
curl --location-trusted -u 'admin:<password>' \
  -T /mnt/disk1/customer.tbl \
  -H "label:labelname" \
  -H "column_separator:|" \
  http://fe-c-xxxx-internal.starrocks.aliyuncs.com:8030/api/stream_load/customer/_stream_load
Uma execução bem-sucedida retorna:
{
    "TxnId": 575,
    "Label": "labelname",
    "Status": "Success",
    "Message": "OK",
    "NumberTotalRows": 150000,
    "NumberLoadedRows": 150000,
    "NumberFilteredRows": 0,
    "NumberUnselectedRows": 0,
    "LoadBytes": 24196144,
    "LoadTimeMs": 1081,
    "BeginTxnTimeMs": 104,
    "StreamLoadPlanTimeMs": 106,
    "ReadDataTimeMs": 85,
    "WriteDataTimeMs": 850,
    "CommitAndPublishTimeMs": 20
}
Caso ErrorURL apareça no resultado, execute curl "<ErrorURL>" para visualizar as linhas filtradas e ajustar a configuração do job.
Próximos passos
Para integração do Stream Load com Java, consulte o demo do stream_load.
Para integração com Spark Streaming, veja Spark Streaming para StarRocks.