Um Query Profile registra os detalhes de execução de uma consulta na sua instância do StarRocks. Use Query Profiles para diagnosticar o desempenho de consultas, identificar gargalos e selecione a técnica de otimização mais adequada para resolvê-los.
Visão geral do Query Profile
Visualização do Query Profile
O StarRocks Manager oferece suporte à análise visual de Query Profiles. Para mais informações, consulte Query Profile introduction.
Identificar gargalos de consulta
Na visualização do Query Profile no StarRocks Manager, os operadores com maior tempo de execução aparecem em cores mais escuras. Os três operadores com a maior duração de execução são destacados, facilitando a identificação dos gargalos da consulta.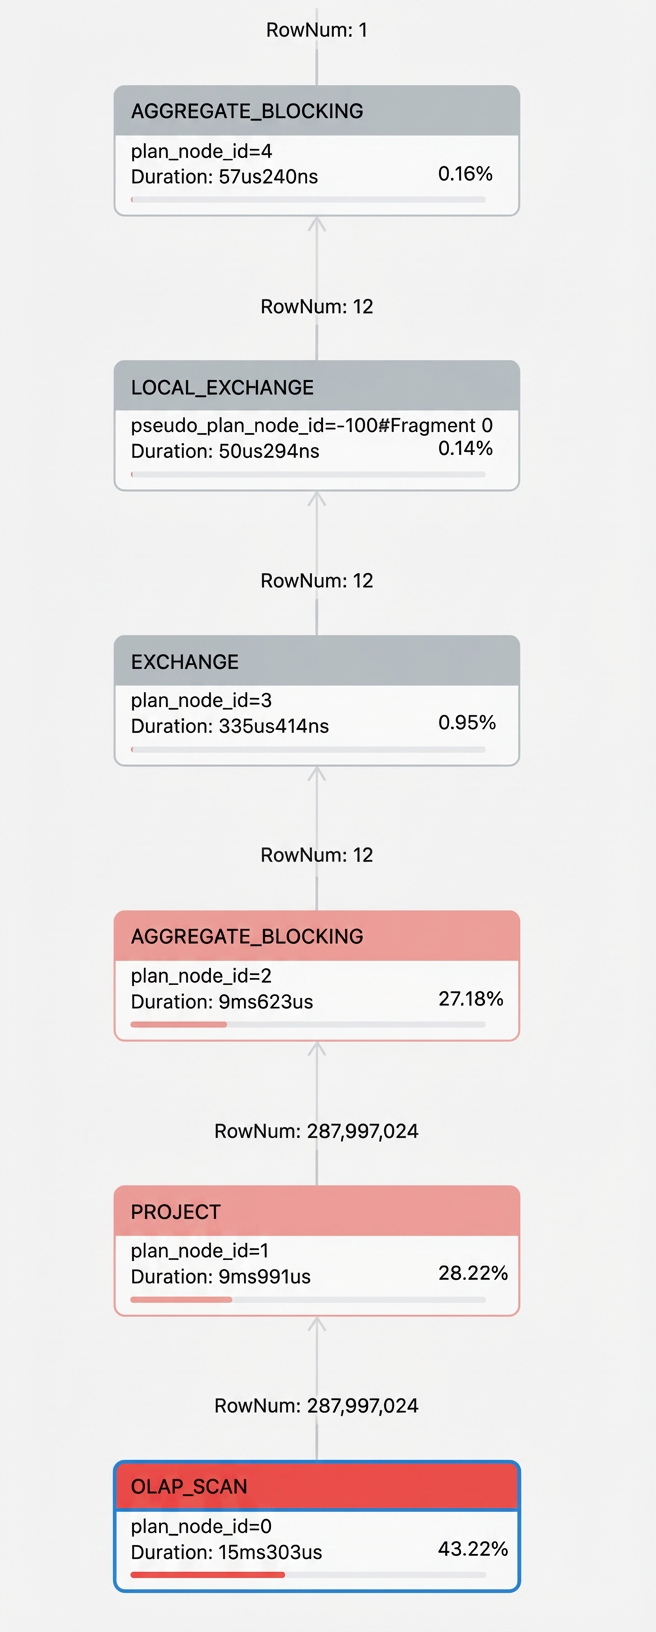
Casos de uso de otimização
As seções a seguir descrevem como diagnosticar e resolver problemas comuns de desempenho de consultas no StarRocks:
Otimizar consultas de campos grandes que causam erros de falta de memória (OOM)
Ao consultar uma tabela que contém campos grandes como TEXT ou VARCHAR, a leitura ou o processamento de grande volume de dados nesses campos pode causar um erro de falta de memória (OOM). Aplique as medidas a seguir para reduzir o consumo de memória:
Evite
SELECT *. Especifique explicitamente apenas as colunas necessárias para reduzir o volume de dados lidos e carregados na memória.Mantenha campos grandes fora de operações de agregação como
GROUP BYeDISTINCT, para evitar conjuntos de resultados intermediários excessivamente grandes.Ative o recurso de spill to disk para aliviar a pressão de memória, definindo a variável de sessão
enable_spill=true.Otimize o schema da tabela movendo campos de texto grandes para uma tabela separada e mantendo apenas índices e campos pequenos na tabela principal. Essa abordagem de divisão de tabelas não tem efeito em cenários de agregação.
Bitmap index
Um Bitmap index é um tipo especial de índice de banco de dados que utiliza um array de bits. Cada bit no array corresponde a uma única linha na tabela de dados. O valor do bit — 0 ou 1 — é determinado pelo valor da linha correspondente.
Use um Bitmap index para melhorar o desempenho de consultas em colunas com baixa cardinalidade e alto número de valores repetidos, como uma coluna
gender.Para verifique se uma consulta utiliza um Bitmap index, consulte o campo
BitmapIndexFilterRowsno Query Profile.
Criar um índice
Crie um Bitmap index ao criar uma tabela.
CREATE TABLE `student_info` (
  `s_stukey` bigint(20) NULL COMMENT "",
  `s_name` varchar(65533) NULL COMMENT "",
  `s_gender` varchar(65533) NULL COMMENT "",
  INDEX index1 (s_gender) USING BITMAP COMMENT 'index1'
) ENGINE=OLAP
DUPLICATE KEY(`s_stukey`)
COMMENT "OLAP"
DISTRIBUTED BY HASH(`s_stukey`);
INSERT INTO student_info
VALUES
    (001,'student#000000019','male'),
    (002,'student#000000020','male'),
    (003,'student#000000021','male'),
    (004,'student#000000022','female');
Crie um Bitmap index em uma tabela existente usando
CREATE INDEX.
CREATE INDEX index_name ON table_name (column_name) [USING BITMAP] [COMMENT ''];Verificar o progresso da criação do índice
Execute o seguinte comando para verifique o progresso de uma tarefa de criação de índice:
SHOW ALTER TABLE COLUMN [FROM db_name];Visualizar um índice
Execute o seguinte comando para visualize os índices de uma tabela:
SHOW {INDEX[ES] | KEY[S] } FROM [db_name.]table_name [FROM db_name];A saída retornada é a seguinte:
MySQL [db_test]> show index from student_info;
+------------------------+------------+----------+--------------+-------------+-----------+-------------+----------+--------+------+------------+---------+
| Table                  | Non_unique | Key_name | Seq_in_index | Column_name | Collation | Cardinality | Sub_part | Packed | Null | Index_type | Comment |
+------------------------+------------+----------+--------------+-------------+-----------+-------------+----------+--------+------+------------+---------+
| db_test.student_info   |            | index1   |              | s_gender    |           |             |          |        |      | BITMAP     | index1  |
+------------------------+------------+----------+--------------+-------------+-----------+-------------+----------+--------+------+------------+---------+
1 row in set (0.01 sec)
Remover um índice
Execute o seguinte comando para remover um índice:
DROP INDEX index_name ON [db_name.]table_name;Testar uma consulta de coluna única
-
Execute uma consulta que filtre a coluna
s_gender.select * from student_info where s_gender='male'; -
Visualize o Profile.
Clique em OLAP_SCAN e, em seguida, clique na aba Node Details à direita. Filtre as métricas por
Bitmappara confirme que o Bitmap index está ativo.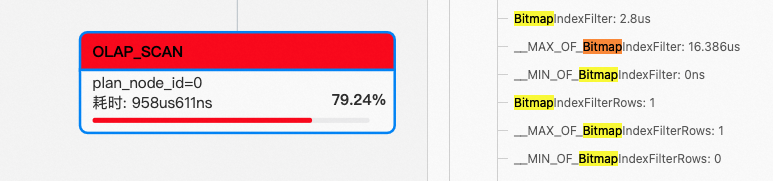
Bloom filter index
Um Bloom filter index determina rapidamente se um arquivo de dados contém o dado alvo. Quando não contém, o arquivo é ignorado, reduzindo o volume de dados lidos. Um Bloom filter é eficiente em termos de espaço e adequado para colunas de alta cardinalidade, como colunas de ID.
No modelo Primary Key e no modelo Duplicate, é possível criar um Bloom filter index em qualquer coluna. No modelo Aggregate e no modelo Update, a criação de Bloom filter index é permitida apenas em colunas de chave.
Bloom filter indexes não são compatíveis com colunas dos tipos de dados TINYINT, FLOAT, DOUBLE ou DECIMAL.
Um Bloom filter index melhora o desempenho apenas de consultas que contenham predicados
inou=, comoSELECT ... WHERE ... IN ()eSELECT ... WHERE column = ....Para verifique se uma consulta utiliza um Bloom filter index, consulte o campo
BloomFilterFilterRowsno Query Profile.
Criar um índice
Ao criar uma tabela, crie um Bloom filter index especificando bloom_filter_columns na cláusula PROPERTIES. O exemplo a seguir demonstra como fazer isso.
CREATE TABLE table1
(
  k1 BIGINT,
  k2 LARGEINT,
  v1 VARCHAR(2048) REPLACE,
  v2 SMALLINT DEFAULT "10"
)
ENGINE = olap
PRIMARY KEY(k1, k2)
DISTRIBUTED BY HASH (k1, k2) BUCKETS 10
PROPERTIES("bloom_filter_columns" = "k1,k2"); -- Separate multiple index columns with commas (,).
Visualizar um índice
Execute o seguinte comando para visualize os índices de uma tabela:
SHOW CREATE TABLE table1;Modificar um índice
Por exemplo:
Adicione um Bloom filter index para a coluna
v1.
ALTER TABLE table1 SET ("bloom_filter_columns" = "k1,k2,v1");Remova o Bloom filter index da coluna
k2.
ALTER TABLE table1 SET ("bloom_filter_columns" = "k1");Exclua todos os Bloom filter indexes de
table1.
ALTER TABLE table1 SET ("bloom_filter_columns" = "");Exemplo
-
Usando a tabela
customerdo TPC-H como exemplo, adicione um Bloom filter index em uma coluna de alta cardinalidade que não seja uma chave de ordenação, como a colunac_phone.ALTER TABLE tpc_h_sf100.customer SET ("bloom_filter_columns" = "c_custkey, c_phone"); -
Visualize o índice para confirme que o Bloom filter index foi adicionado.
SHOW CREATE TABLE tpc_h_sf100.customer;| customer | CREATE TABLE `customer` ( `c_custkey` bigint(20) NULL COMMENT "", `c_name` varchar(65533) NULL COMMENT "", `c_address` varchar(65533) NULL COMMENT "", `c_nationkey` bigint(20) NULL COMMENT "", `c_phone` varchar(65533) NULL COMMENT "", `c_acctbal` double NULL COMMENT "", `c_mktsegment` varchar(65533) NULL COMMENT "", `c_comment` varchar(65533) NULL COMMENT "", `Gender` varchar(65533) NULL DEFAULT "default_value" COMMENT "" ) ENGINE=OLAP DUPLICATE KEY(`c_custkey`) COMMENT "OLAP" DISTRIBUTED BY HASH(`c_custkey`) BUCKETS 24 PROPERTIES ( "replication_num" = "1", "bloom_filter_columns" = "c_custkey, c_phone", "in_memory" = "false", "storage_format" = "DEFAULT", "enable_persistent_index" = "false", "compression" = "LZ4" ); | -
Execute uma consulta que filtre a coluna
c_phone.select * from tpc_h_sf100.customer where c_phone = "10-334-921-5346"; -
Visualize o Profile.
Clique em OLAP_SCAN e, em seguida, clique na aba Node Details à direita. Localize a métrica
BloomFilterFilterRowspara confirme que o Bloom filter index está ativo.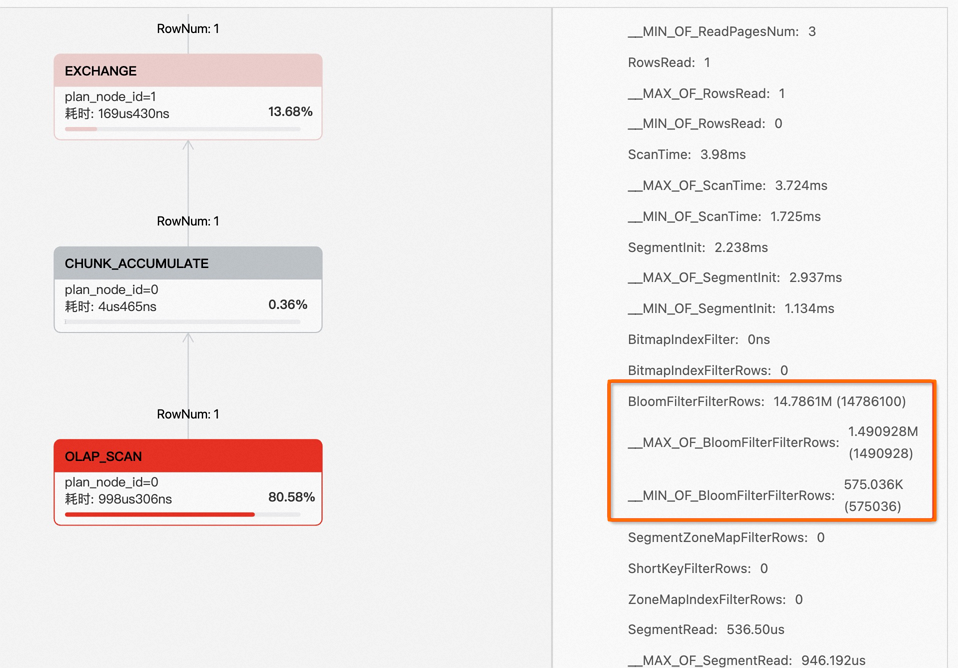
Otimizar para distorção de dados
Este exemplo usa a tabela lineitem do TPC-H e seleciona uma coluna com distribuição de valores desigual como chave de bucketing para demonstrar um problema de distorção de dados. Neste exemplo, a coluna l_tag tem o mesmo valor em todas as linhas, o que gera uma distorção de dados extrema.
-
Crie os dados de teste. Adicione uma nova coluna à tabela
lineitemdo TPC-H para usar como chave de distribuição.CREATE TABLE `lineitem_tag` ( `l_orderkey` bigint(20) NULL COMMENT "", `l_partkey` bigint(20) NULL COMMENT "", `l_suppkey` bigint(20) NULL COMMENT "", `l_linenumber` int(11) NULL COMMENT "", `l_quantity` double NULL COMMENT "", `l_extendedprice` double NULL COMMENT "", `l_discount` double NULL COMMENT "", `l_tax` double NULL COMMENT "", `l_returnflag` varchar(65533) NULL COMMENT "", `l_linestatus` varchar(65533) NULL COMMENT "", `l_shipdate` date NULL COMMENT "", `l_commitdate` date NULL COMMENT "", `l_receiptdate` date NULL COMMENT "", `l_shipinstruct` varchar(65533) NULL COMMENT "", `l_shipmode` varchar(65533) NULL COMMENT "", `l_comment` varchar(65533) NULL COMMENT "", `l_tag` varchar(65533) default 'false' COMMENT "" ) ENGINE=OLAP DUPLICATE KEY(`l_orderkey`) COMMENT "OLAP" DISTRIBUTED BY HASH(`l_tag`) BUCKETS 96 PROPERTIES ( "replication_num" = "1", "in_memory" = "false", "storage_format" = "DEFAULT", "enable_persistent_index" = "false" ); insert into lineitem_tag select *, 'false' as l_tag from tpc_h_sf100.lineitem; -
Execute uma consulta para realizar uma varredura completa da tabela.
select count(1) from lineitem_tag; -
Visualize o Profile.
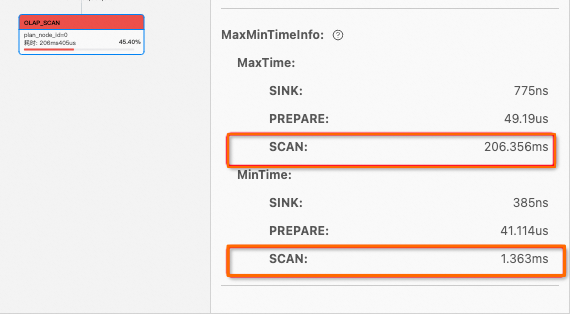
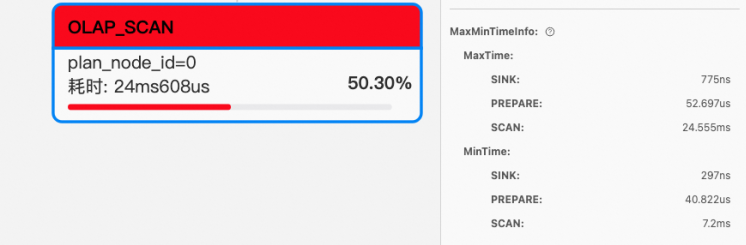
Clique em OLAP_SCAN e acesse a aba Node à direita. Compare o tempo de SCAN em MaxTime e MinTime. Se os tempos diferirem em várias ordens de magnitude, pode ter ocorrido distorção de dados.
-
Otimize o schema da tabela redefinindo a chave de distribuição. Crie uma nova tabela chamada
lineitem2e altere a chave de bucketing del_tagparal_orderkeypara resolver a distorção de dados. O comando a seguir cria a tabela; a alteração fundamental éDISTRIBUTED BY HASH(.CREATE TABLE `lineitem2` ( `l_orderkey` bigint(20) NULL COMMENT "", `l_partkey` bigint(20) NULL COMMENT "", `l_suppkey` bigint(20) NULL COMMENT "", `l_linenumber` int(11) NULL COMMENT "", `l_quantity` double NULL COMMENT "", `l_extendedprice` double NULL COMMENT "", `l_discount` double NULL COMMENT "", `l_tax` double NULL COMMENT "", `l_returnflag` varchar(65533) NULL COMMENT "", `l_linestatus` varchar(65533) NULL COMMENT "", `l_shipdate` date NULL COMMENT "", `l_commitdate` date NULL COMMENT "", `l_receiptdate` date NULL COMMENT "", `l_shipinstruct` varchar(65533) NULL COMMENT "", `l_shipmode` varchar(65533) NULL COMMENT "", `l_comment` varchar(65533) NULL COMMENT "", `l_tag` varchar(65533) NULL DEFAULT "default_value" COMMENT "" ) ENGINE=OLAP DUPLICATE KEY(`l_orderkey`) COMMENT "OLAP" DISTRIBUTED BY HASH(`l_orderkey`) BUCKETS 96 PROPERTIES ( "replication_num" = "1", "bloom_filter_columns" = "l_orderkey", "in_memory" = "false", "storage_format" = "DEFAULT", "enable_persistent_index" = "false", "compression" = "LZ4" ); Visualize o Profile novamente. Compare o tempo de SCAN em MaxTime e MinTime. É possível observar que o problema de distorção de dados foi mitigado.
Materialized view de tabela única
Uma materialized view de tabela única (também conhecida como Rollup) no StarRocks é um tipo especial de índice que não pode ser consultado diretamente. Se o seu data warehouse contiver um grande número de consultas complexas ou repetitivas, crie uma materialized view de tabela única para acelerá-las.
Testar uma consulta
-
Usando a tabela
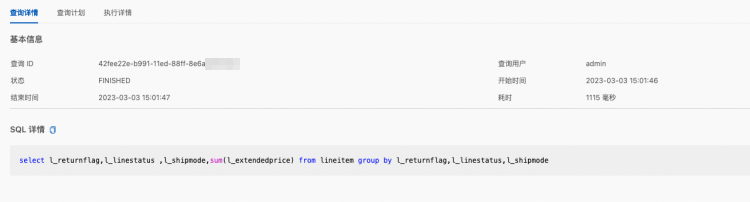
lineitemdo TPC-H como exemplo, execute uma consulta.select l_returnflag,l_linestatus,l_shipmode,sum(l_extendedprice) from lineitem group by l_returnflag,l_linestatus,l_shipmode; A consulta inicial leva 1115 ms para ser concluída porque nenhuma materialized view foi criada.
-
Visualize o Profile.
Clique em OLAP_SCAN e acesse a aba Node à direita. É possível verifique que o Rollup varreu a própria tabela
lineitem.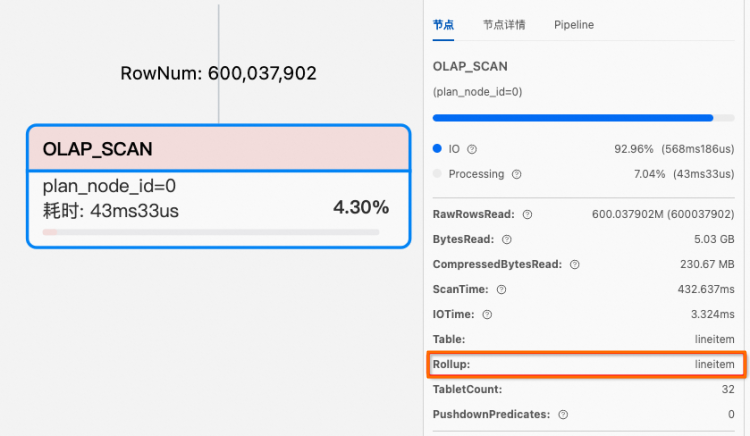
Criar uma materialized view
Execute o seguinte comando para criar uma materialized view de tabela única:
CREATE MATERIALIZED VIEW material_test AS select l_returnflag,l_linestatus ,l_shipmode,sum(l_extendedprice) from lineitem group by l_returnflag,l_linestatus,l_shipmode;Verificar acerto da materialized view
-
Use o comando
EXPLAINpara verifique se a consulta utiliza a materialized view de tabela única.explain select l_returnflag,l_linestatus ,l_shipmode,sum(l_extendedprice) from lineitem group by l_returnflag,l_linestatus,l_shipmode;No resultado retornado,
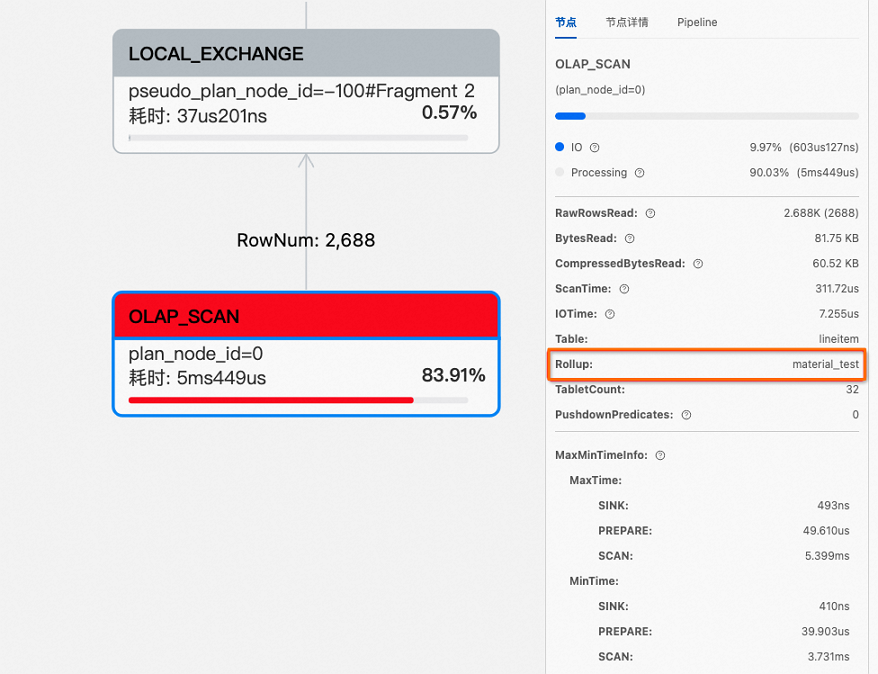
rollup: material_testindica que a consulta utilizou a materialized view chamadamaterial_test.0:OlapScanNode TABLE: lineitem PREAGGREGATION: OFF. Reason: null partitions=1/1 rollup: material_test tabletRatio=96/96 tabletList=15646,15648,15650,15652,15654,15656,15658,15660,15662,15664 ... cardinality=600037902 avgRowSize=14.285666 numNodes=0 -
Visualize o Profile.
Clique em OLAP_SCAN. Na aba Node à direita, é possível confirme que a consulta utilizou a materialized view e que o tempo de execução foi reduzido para 0,05 ms.
Verificar se o JoinRuntimeFilter está ativo
Quando a tabela à direita em uma operação JOIN constrói uma hash table, um Runtime Filter é criado. Esse filtro é enviado ao lado esquerdo da árvore de consulta e propagado para o operador de scan sempre que possível. As métricas relacionadas ao JoinRuntimeFilter estão disponíveis na aba Node Details do operador de scan.
-
Use
query72.sqldo TPC-DS como exemplo.select i_item_desc, w_warehouse_name, d1.d_week_seq, sum(case when p_promo_sk is null then 1 else 0 end) no_promo, sum(case when p_promo_sk is not null then 1 else 0 end) promo, count(*) total_cnt from inventory join catalog_sales on (cs_item_sk = inv_item_sk) join warehouse on (w_warehouse_sk=inv_warehouse_sk) join item on (i_item_sk = cs_item_sk) join customer_demographics on (cs_bill_cdemo_sk = cd_demo_sk) join household_demographics on (cs_bill_hdemo_sk = hd_demo_sk) join date_dim d1 on (cs_sold_date_sk = d1.d_date_sk) join date_dim d2 on (inv_date_sk = d2.d_date_sk) join date_dim d3 on (cs_ship_date_sk = d3.d_date_sk) left outer join promotion on (cs_promo_sk=p_promo_sk) left outer join catalog_returns on (cr_item_sk = cs_item_sk and cr_order_number = cs_order_number) where d1.d_week_seq = d2.d_week_seq and inv_quantity_on_hand < cs_quantity and d3.d_date > (cast(d1.d_date AS DATE) + interval '5' day) and hd_buy_potential = '>10000' and d1.d_year = 1999 and cd_marital_status = 'D' group by i_item_desc,w_warehouse_name,d1.d_week_seq order by total_cnt desc, i_item_desc, w_warehouse_name, d1.d_week_seq limit 100; -
Visualize o Profile.
Clique em OLAP_SCAN e, em seguida, clique na aba Node Details à direita. É possível verifique que o JoinRuntimeFilter foi acionado quando o operador de scan varreu a tabela
inventory.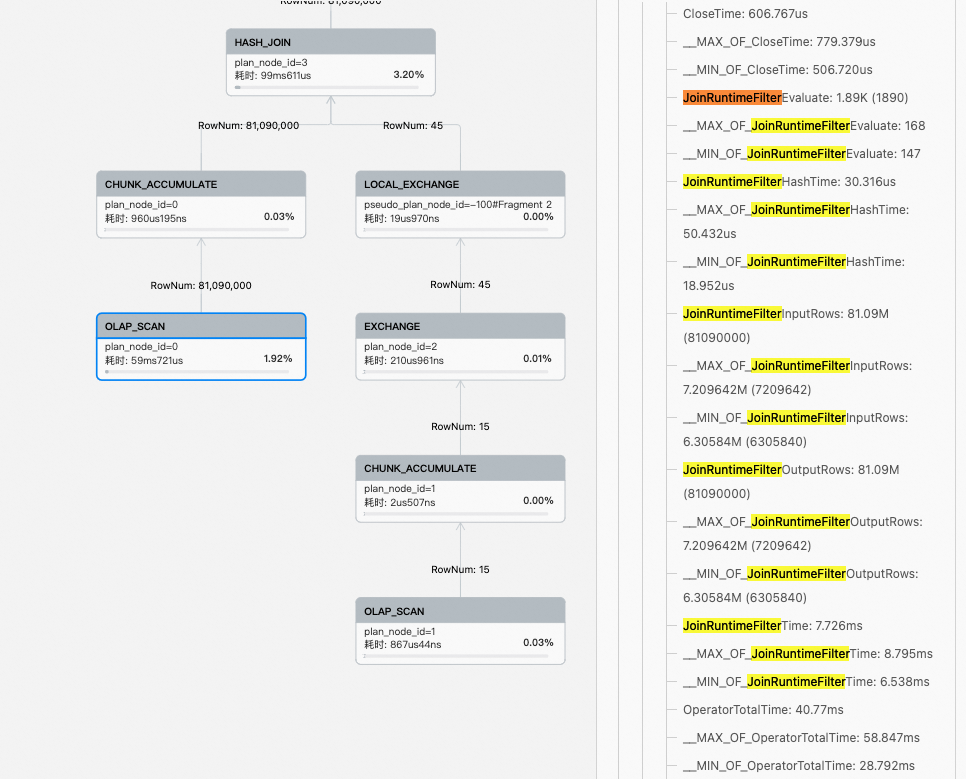
Colocate Join
Para usar o Colocate Join no StarRocks, atribua as tabelas a um Colocation Group (CG) no momento de criação. As tabelas do mesmo CG devem seguir o mesmo Colocation Group Schema (CGS), garantindo que os dados sejam distribuídos pelo mesmo conjunto de nós BE. Quando a coluna de join também é a chave de bucketing, os nós de computação realizam apenas um join local, reduzindo o tempo de transferência de dados entre nós. Ao contrário do Shuffle Join ou do Broadcast Join, o Colocate Join elimina a transferência de dados pela rede e melhora o desempenho das consultas.
Criar uma tabela colocada
O StarRocks suporta operações de Colocate Join apenas em tabelas dentro do mesmo banco de dados.
Execute o seguinte comando para criar uma tabela em um Colocation Group:
CREATE TABLE tbl (k1 int, v1 int sum)
DISTRIBUTED BY HASH(k1)
BUCKETS 8
PROPERTIES(
    "colocate_with" = "group1"
);
Exclusão automática de um Colocation Group
Quando a última tabela de um grupo é excluída permanentemente, o grupo também é excluído automaticamente. A exclusão permanente significa que a tabela foi removida da Lixeira. Após exclua uma tabela com o comando DROP TABLE, ela permanece na Lixeira por um dia por padrão antes de ser excluída permanentemente.
Visualizar informações do grupo
Por exemplo, execute o seguinte comando para visualize as informações do grupo.
SHOW PROC '/colocation_group';O comando retorna as seguintes informações.
+-------------+--------------+----------+------------+----------------+----------+----------+
| GroupId     | GroupName    | TableIds | BucketsNum | ReplicationNum | DistCols | IsStable |
+-------------+--------------+----------+------------+----------------+----------+----------+
| 11912.11916 | 11912_group1 | 11914    | 8          | 3              | int(11)  | true     |
+-------------+--------------+----------+------------+----------------+----------+----------+
A tabela a seguir descreve as colunas.
|
Column |
Description |
|
GroupId |
O identificador único de um grupo em todo o cluster. A primeira parte é o ID do banco de dados e a segunda parte é o ID do grupo. |
|
GroupName |
O nome completo do grupo. |
|
TableIds |
A lista de IDs de tabelas incluídas neste grupo. |
|
BucketsNum |
O número de buckets. |
|
ReplicationNum |
O número de réplicas. |
|
DistCols |
O tipo de dado das colunas de distribuição. |
|
IsStable |
Indica se o grupo está estável. |
Execute o seguinte comando para visualize a distribuição de dados de um grupo específico.
SHOW PROC '/colocation_group/GroupId';
SHOW PROC '/colocation_group/11912.11916';
O comando retorna as seguintes informações.
+-------------+---------------------+
| BucketIndex | BackendIds          |
+-------------+---------------------+
| 0           | 10002, 10004, 10003 |
| 1           | 10002, 10004, 10003 |
| 2           | 10002, 10004, 10003 |
| 3           | 10002, 10004, 10003 |
| 4           | 10002, 10004, 10003 |
| 5           | 10002, 10004, 10003 |
| 6           | 10002, 10004, 10003 |
| 7           | 10002, 10004, 10003 |
+-------------+---------------------+
8 rows in set (0.00 sec)
Modificar propriedades do grupo
Execute o seguinte comando para mover uma tabela para um Colocation Group diferente:
ALTER TABLE tbl SET ("colocate_with" = "group_name");Exemplo
-
Atribua as tabelas
orderselineitemdo conjunto de dados TPC-H ao mesmo Colocation Group.use tpc_h_sf100; ALTER TABLE orders SET ("colocate_with" = "cg_tpc_orders"); ALTER TABLE lineitem SET ("colocate_with" = "cg_tpc_orders"); -
Execute a seguinte consulta.
select count(1) from orders as o join lineitem as l on o.o_orderkey = l.l_orderkey; -
Verifique se o Colocate Join está ativo na aba Query Plan da consulta na interface do StarRocks Manager.
Quando
colocatefor true, o Colocate Join está ativo. No plano de execução, isso aparece comocolocate: true. O fragmento do plano de consulta correspondente é:
2:HASH JOIN
|  join op: INNER JOIN (COLOCATE)
|  colocate: true
|  equal join conjunct: 10: l_orderkey = 1: o_orderkey
|
|----1:OlapScanNode
|       TABLE: orders
|       PREAGGREGATION: ON
|       PREDICATES: 1: o_orderkey IS NOT NULL
|       partitions=1/1
|       rollup: orders
|       tabletRatio=96/96
|       tabletList=12403,12405,12407,12409,12411,12413,12415,12417,12419,12421 ...
|       cardinality=135000000
|       avgRowSize=1.0
|       numNodes=0
Verificar pruning de bucket e partição
Na aba Query Plan da sua consulta na interface do StarRocks Manager, consulte o parâmetro partition ou tabletRatio para verifique se o pruning de partição ou de bucket está ativo.
Como solucionar o crescimento contínuo de memória do FE que aciona um alerta de memória?
Quando a memória do FE continua crescendo e aciona um alerta de memória, investigue o problema na seguinte ordem:
Verifique a existência de inchaço de metadados — Execute
SHOW PROC '/statistic'e verifique o total deTabletNum. Um total deTabletNumacima de 1.000.000 indica inchaço de metadados.Localize as consultas com alto consumo de recursos — Se o
TabletNumestiver normal, consulte a tabela de log de auditoria_starrocks_audit_db_.starrocks_audit_tbl, ordene os registros por consumo de CPU ou memória e otimize as instruções SQL com alta carga.Resolva a carga desbalanceada — Configure o SLB e um pool de conexões no lado do cliente para ative o balanceamento de carga entre os nós FE. Isso evita que as requisições se concentrem em um único FE Leader, o que causa picos de memória e GC frequente.
Otimize o método de escrita — Substitua inserções
VALUESde grande volume por Stream Load para eliminar gargalos de parsing no FE desde a source.