O Spark Thrift Server é um service fornecido pelo Apache Spark que suporta conexões e execução de consultas SQL via Java Database Connectivity (JDBC) ou Open Database Connectivity (ODBC). Isso facilita a integração do seu ambiente Spark com ferramentas de business intelligence (BI), ferramentas de visualização de dados e outras ferramentas de análise de dados já existentes. Crie uma sessão do Spark Thrift Server e conecte-se a ela a partir de diferentes clientes.
Pré-requisitos
Crie um workspace antes de continuar. Para mais informações, consulte Manage workspaces.
Criar uma sessão do Spark Thrift Server
Após criar uma sessão do Spark Thrift Server, selecione-a ao criar um nó Spark SQL.
-
Acesse a página Sessions.
Faça login no EMR console.
No painel de navegação à esquerda, escolha EMR Serverless > Spark.
Na página Spark, clique em o nome do workspace de destino.
Na página EMR Serverless Spark, clique em Sessions no painel de navegação à esquerda.
Na página Sessions, clique em a aba Spark Thrift Server Session.
Clique em Create Spark Thrift Server Session.
-
Na página Create Spark Thrift Server Session, configure os parâmetros e clique em Create.
Parâmetro
Descrição
Name
O nome do novo Spark Thrift Server.
O nome deve ter entre 1 e 64 caracteres e pode conter letras, dígitos, hifens (-), sublinhados (_) e espaços.
Resource Queue
Selecione uma fila de desenvolvimento ou uma fila compartilhada entre os ambientes de desenvolvimento e produção para implantar a sessão.
Para mais informações sobre filas, consulte Manage resource queues.
Engine Version
A versão do engine para esta sessão. Para mais informações, consulte Engine versions.
Use Fusion Acceleration
O Fusion acelera workloads do Spark e reduz o custo total dos jobs. Para informações de faturamento, consulte Product Billing. Para mais informações sobre o engine Fusion, consulte Fusion engine.
Automatic Stop
Ativado por padrão. A sessão do Spark Thrift Server para automaticamente após 45 minutos de inatividade.
Normal Network Connection
Uma conexão de rede existente para acessar fontes de dados em uma VPC ou serviços externos. Para mais informações, consulte Network connectivity between EMR Serverless Spark and other VPCs.
Spark Thrift Server Port
A porta é 443 para acesso pelo endpoint público e 80 para acesso pelo endpoint interno da mesma região.
Authentication Method
Somente o método por token é suportado.
spark.driver.cores
O número de núcleos de CPU para o processo driver. Valor padrão: 1.
spark.driver.memory
A memória alocada ao processo driver. Valor padrão: 3,5 GB.
spark.executor.cores
O número de núcleos de CPU para cada executor. Valor padrão: 1.
spark.executor.memory
A memória alocada a cada executor. Valor padrão: 3,5 GB.
spark.executor.instances
O número de executores a alocar. Valor padrão: 2.
Dynamic Resource Allocation
Desativado por padrão. Quando ativado, configure os seguintes parâmetros:
-
Minimum Number of Executors: O valor padrão é 2.
-
Maximum Number of Executors: Se spark.executor.instances não estiver definido, o valor padrão é 10.
More Memory Configurations
-
spark.driver.memoryOverhead: A memória não heap disponível para o driver. Se este parâmetro não estiver definido, o Spark aloca automaticamente um valor com base no padrão, que é
max(384 MB, 10% * spark.driver.memory). -
spark.executor.memoryOverhead: A memória não heap disponível para cada executor. Se este parâmetro não estiver definido, o Spark aloca automaticamente um valor com base no padrão, que é
max(384 MB, 10% * spark.executor.memory). -
spark.memory.offHeap.size: A quantidade de memória off-heap disponível para o Spark. O valor padrão é 1 GB.
Este parâmetro só tem efeito quando
spark.memory.offHeap.enabledestá definido comotrue. Quando o engine Fusion está em uso, este recurso é ativado por padrão com 1 GB de memória off-heap.
Spark Configuration
Insira as informações de configuração do Spark. Por padrão, os parâmetros são separados por espaços. Por exemplo,
spark.sql.catalog.paimon.metastore dlf. -
-
Obtenha as informações de endpoint.
Na aba Spark Thrift Server Session, clique em o nome do Spark Thrift Server que você criou.
-
Na aba Overview, copie as informações de endpoint.
Escolha o tipo de endpoint de acordo com o seu ambiente de rede:
Public Endpoint: Use este endpoint para acessar o EMR Serverless Spark a partir de uma máquina local, rede externa ou ambiente entre clouds. Tarifas de tráfego podem ser aplicadas. Adote as medidas de segurança adequadas.
Internal Endpoint: Use este endpoint para acessar o EMR Serverless Spark a partir de uma instância ECS da Alibaba Cloud na mesma região. O acesso interno é gratuito e mais seguro, mas está restrito à rede interna da Alibaba Cloud na mesma região.
Criar um token
Na aba Spark Thrift Server Session, clique em o nome da sessão do Spark Thrift Server que você criou.
Clique em a aba Token Management.
Clique em Create Token.
-
Na caixa de diálogo Create Token, configure os parâmetros e clique em OK.
Parâmetro
Descrição
Name
O nome do novo token.
Expired At
O prazo de expiração do token. O valor mínimo é 1 dia. Ativado por padrão com um período de expiração de 365 dias.
-
Copie as informações do token.
ImportanteCopie as informações do token imediatamente após a criação, pois não será possível visualizá-las novamente. Caso o token expire ou seja perdido, crie ou redefina o token.
Conectar ao Spark Thrift Server
Ao conectar ao Spark Thrift Server, substitua as seguintes informações conforme necessário:
-
<endpoint>: O Endpoint(Public) ou Endpoint(Private) obtido na aba Overview.Se você utilizar o endpoint interno, o acesso ao Spark Thrift Server ficará restrito aos recursos dentro do mesmo VPC.
<port>: O número da porta. A porta é 443 para acesso via endpoint público e 80 para acesso via endpoint interno na mesma região.<username>: O nome do token criado na aba Token Management.<token>: As informações do token copiadas na aba Token Management.
Conectar ao Spark Thrift Server usando Python
-
Execute o seguinte comando para instalar os pacotes PyHive e Thrift.
pip install pyhive thrift -
Escreva um script Python para conectar ao Spark Thrift Server.
O script a seguir conecta ao Hive e lista todos os bancos de dados. Escolha um método de conexão de acordo com seu ambiente de rede.
Connect using a public endpoint
from pyhive import hive

if __name__ == '__main__':
    # Replace <endpoint>, <username>, and <token> with your actual information.
    cursor = hive.connect('<endpoint>', port=443, scheme='https', username='<username>', password='<token>').cursor()
    cursor.execute('show databases')
    print(cursor.fetchall())
    cursor.close()
Connect using an internal same-region endpoint
from pyhive import hive

if __name__ == '__main__':
    # Replace <endpoint>, <username>, and <token> with your actual information.
    cursor = hive.connect('<endpoint>', port=80, scheme='http', username='<username>', password='<token>').cursor()
    cursor.execute('show databases')
    print(cursor.fetchall())
    cursor.close()
Conectar ao Spark Thrift Server usando Java
-
Adicione as seguintes dependências Maven ao arquivo
pom.xml.<dependencies> <dependency> <groupId>org.apache.hadoop</groupId> <artifactId>hadoop-common</artifactId> <version>3.0.0</version> </dependency> <dependency> <groupId>org.apache.hive</groupId> <artifactId>hive-jdbc</artifactId> <version>2.1.0</version> </dependency> </dependencies>NotaA versão integrada do Hive no Serverless Spark é 2.x. Portanto, apenas o hive-jdbc 2.x é compatível.
-
Escreva o código Java para conectar ao Spark Thrift Server.
O código a seguir conecta ao Spark Thrift Server e consulta a lista de bancos de dados.
Connect using a public endpoint
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.ResultSet;
import java.sql.ResultSetMetaData;
import org.apache.hive.jdbc.HiveStatement;

public class Main {
    public static void main(String[] args) throws Exception {
        String url = "jdbc:hive2://<endpoint>:443/;transportMode=http;httpPath=cliservice/token/<token>";
        Class.forName("org.apache.hive.jdbc.HiveDriver");
        Connection conn = DriverManager.getConnection(url);
        HiveStatement stmt = (HiveStatement) conn.createStatement();

        String sql = "show databases";
        System.out.println("Running " + sql);
        ResultSet res = stmt.executeQuery(sql);

        ResultSetMetaData md = res.getMetaData();
        String[] columns = new String[md.getColumnCount()];
        for (int i = 0; i < columns.length; i++) {
            columns[i] = md.getColumnName(i + 1);
        }
        while (res.next()) {
            System.out.print("Row " + res.getRow() + "=[");
            for (int i = 0; i < columns.length; i++) {
                if (i != 0) {
                    System.out.print(", ");
                }
                System.out.print(columns[i] + "='" + res.getObject(i + 1) + "'");
            }
            System.out.println(")]");
        }

        conn.close();
    }
}
Connect using an internal same-region endpoint
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.ResultSet;
import java.sql.ResultSetMetaData;
import org.apache.hive.jdbc.HiveStatement;

public class Main {
    public static void main(String[] args) throws Exception {
        String url = "jdbc:hive2://<endpoint>:80/;transportMode=http;httpPath=cliservice/token/<token>";
        Class.forName("org.apache.hive.jdbc.HiveDriver");
        Connection conn = DriverManager.getConnection(url);
        HiveStatement stmt = (HiveStatement) conn.createStatement();

        String sql = "show databases";
        System.out.println("Running " + sql);
        ResultSet res = stmt.executeQuery(sql);

        ResultSetMetaData md = res.getMetaData();
        String[] columns = new String[md.getColumnCount()];
        for (int i = 0; i < columns.length; i++) {
            columns[i] = md.getColumnName(i + 1);
        }
        while (res.next()) {
            System.out.print("Row " + res.getRow() + "=[");
            for (int i = 0; i < columns.length; i++) {
                if (i != 0) {
                    System.out.print(", ");
                }
                System.out.print(columns[i] + "='" + res.getObject(i + 1) + "'");
            }
            System.out.println(")]");
        }

        conn.close();
    }
}
Conectar ao Spark Thrift Server usando Spark Beeline
-
Se você estiver usando um cluster autogerenciado, acesse o diretório
bindo Spark e utilize o Beeline para conectar ao Spark Thrift Server.Connect using a public endpoint
cd /opt/apps/SPARK3/spark-3.4.2-hadoop3.2-1.0.3/bin/

./beeline -u "jdbc:hive2://<endpoint>:443/;transportMode=http;httpPath=cliservice/token/<token>"
Connect using an internal same-region endpoint
cd /opt/apps/SPARK3/spark-3.4.2-hadoop3.2-1.0.3/bin/ ./beeline -u "jdbc:hive2://<endpoint>:80/;transportMode=http;httpPath=cliservice/token/<token>"NotaO caminho
/opt/apps/SPARK3/spark-3.4.2-hadoop3.2-1.0.3no código é um exemplo do caminho de instalação do Spark em um cluster EMR on ECS. Ajuste o caminho de acordo com o caminho real de instalação do Spark no seu cliente. Se você não souber o caminho de instalação do Spark, execute o comandoenv | grep SPARK_HOMEpara localizá-lo. -
Se você estiver usando um cluster EMR on ECS, utilize diretamente o cliente Spark Beeline para conectar ao Spark Thrift Server.
Connect using a public endpoint
spark-beeline -u "jdbc:hive2://<endpoint>:443/;transportMode=http;httpPath=cliservice/token/<token>"Connect using an internal same-region endpoint
spark-beeline -u "jdbc:hive2://<endpoint>:80/;transportMode=http;httpPath=cliservice/token/<token>"
Se o erro a seguir ocorrer ao usar o Hive Beeline para conectar ao Serverless Spark Thrift Server, a causa geralmente é uma incompatibilidade entre a versão do Hive Beeline e o Spark Thrift Server. Para resolver o problema, use uma versão 2.x do Beeline para Hive.
24/08/22 15:09:11 [main]: ERROR jdbc.HiveConnection: Error opening session
org.apache.thrift.transport.TTransportException: HTTP Response code: 404
Configure o Apache Superset para conectar ao Spark Thrift Server
O Apache Superset é uma plataforma de exploração e visualização de dados que suporta uma ampla variedade de tipos de gráficos. Para mais informações, consulte a documentação do Superset.
-
Instale as dependências.
Verifique se a versão 0.20.0 do pacote
thriftestá instalada. Caso contrário, execute o comando a seguir para instalá-la.pip install thrift==0.20.0 -
Inicie o Superset e acesse a interface do Superset.
Para mais informações sobre como iniciar o Superset, consulte a documentação do Superset.
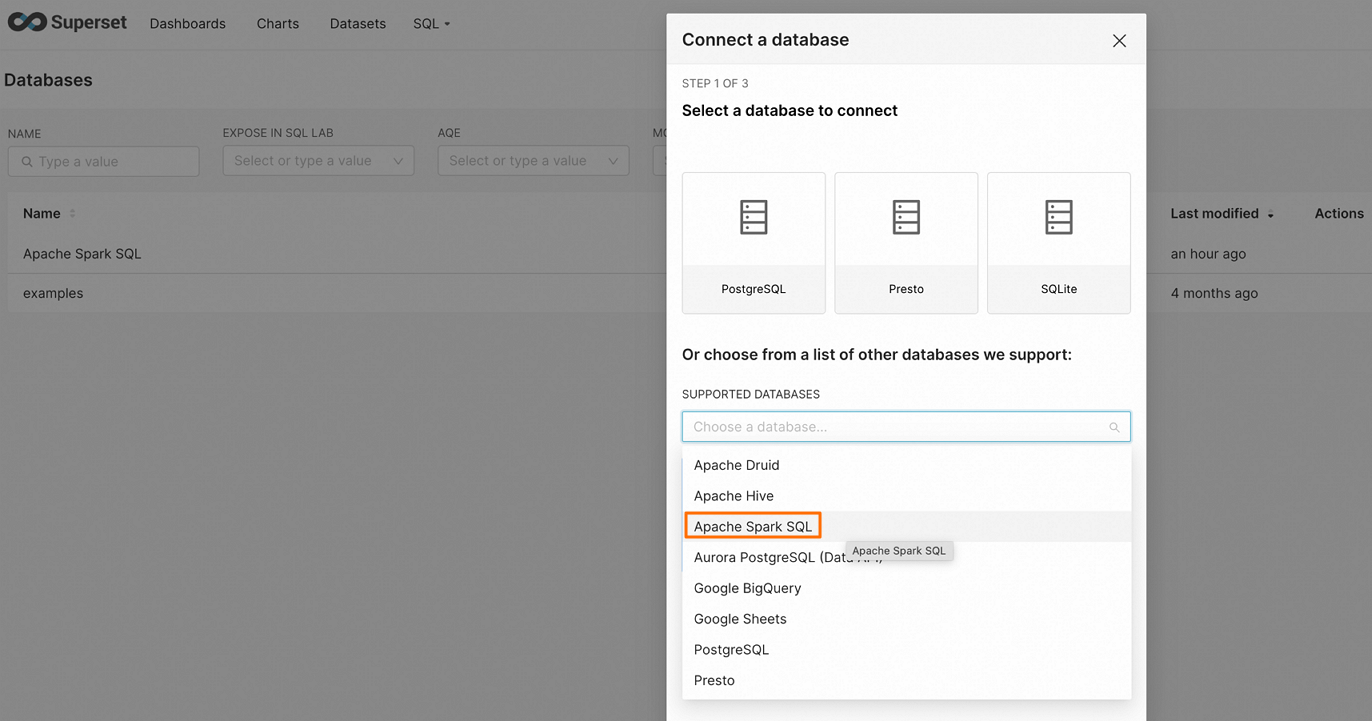
No canto superior direito da página, clique em DATABASE para acessar a página Connect a database.
-
Na página Connect a database, selecione Apache Spark SQL.
-
Insira a string de conexão e configure os parâmetros da fonte de dados.
Connect using a public endpoint
hive+https://<username>:<token>@<endpoint>:443/<db_name>Connect using an internal same-region endpoint
hive+http://<username>:<token>@<endpoint>:80/<db_name> Clique em FINISH para confirmar a conexão e a validação.
Configure o Hue para conectar ao Spark Thrift Server
O Hue é uma interface web de código aberto para interagir com o ecossistema Hadoop. Para mais informações, consulte a documentação do Hue.
-
Instale as dependências.
Verifique se a versão 0.20.0 do pacote
thriftestá instalada. Caso contrário, execute o comando a seguir para instalá-la.pip install thrift==0.20.0 -
Adicione a string de conexão do Spark SQL ao arquivo de configuração do Hue.
Localize o arquivo de configuração do Hue (normalmente em
/etc/hue/hue.conf) e adicione o seguinte conteúdo ao arquivo.Connect using a public endpoint
[[[sparksql]]]
     name = Spark Sql
     interface=sqlalchemy
     options='{"url": "hive+https://<username>:<token>@<endpoint>:443/"}'
Connect using an internal same-region endpoint
[[[sparksql]]] name = Spark Sql interface=sqlalchemy options='{"url": "hive+http://<username>:<token>@<endpoint>:80/"}' -
Reinicie o Hue.
Após modificar a configuração, execute o comando a seguir para reiniciar o service do Hue e aplicar as alterações.
sudo service hue restart -
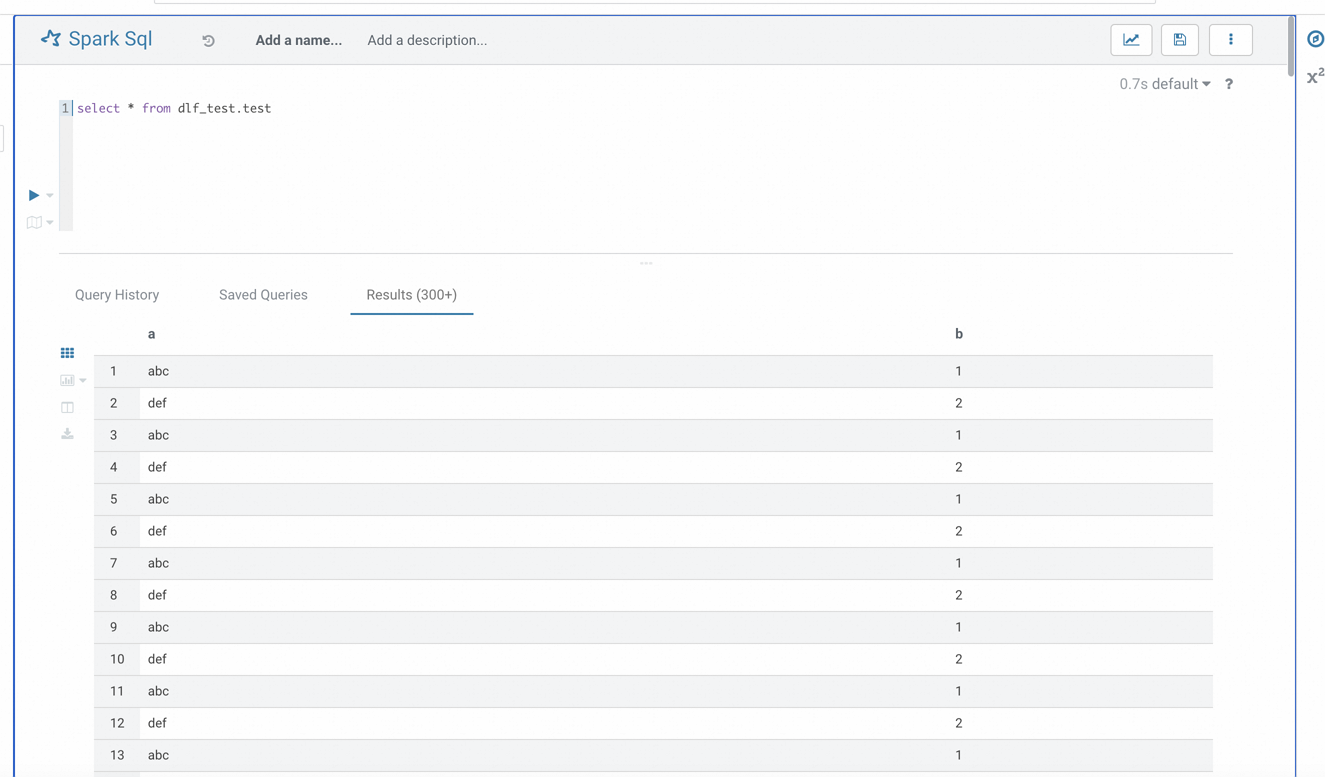
Verifique a conexão.
Após reiniciar com sucesso, acesse a interface do Hue e localize a opção Spark SQL. Se a configuração estiver correta, você poderá conectar ao Spark Thrift Server e executar consultas SQL.
Conectar ao Spark Thrift Server usando DataGrip
O DataGrip é uma ferramenta de gerenciamento de banco de dados para consultar, criar e gerenciar bancos de dados em ambientes locais, remotos ou cloud. Para mais informações, acesse o site do DataGrip.
-
Instale o DataGrip. Para mais informações, consulte Install DataGrip.
A versão do DataGrip utilizada neste exemplo é a 2025.1.2.
Abra o cliente DataGrip. A interface do DataGrip será exibida.
-
Crie um projeto.
-
Clique em
 e escolha .

Na caixa de diálogo New Project, insira um nome para o projeto, como
Spark, e clique em OK.
-
-
Clique no ícone
 na barra de menus do Database Explorer. Selecione Data Source > Other > Apache Spark.

-
Na caixa de diálogo Data Sources and Drivers, configure os seguintes parâmetros.

Tab
Parameter
Descrição
General
Name
Um nome personalizado para a conexão. Por exemplo, spark_thrift_server.
Authentication
Selecione um método de autenticação. Neste tópico, a opção No auth está selecionada.
Em ambientes de produção, selecione User & Password para garantir que apenas usuários autorizados possam enviar jobs SQL, aumentando a segurança do sistema.
Driver
Clique em Apache Spark e, em seguida, clique em Go to Driver para confirmar que a versão do driver é
ver. 1.2.2.NotaComo a versão atual do engine do Serverless Spark é 3.x, selecione a versão 1.2.2 do driver para garantir estabilidade e compatibilidade de recursos.

URL
A URL de conexão com o Spark Thrift Server. Escolha um método de conexão de acordo com seu ambiente de rede.
-
Conexão via endpoint público
jdbc:hive2://<endpoint>:443/;transportMode=http;httpPath=cliservice/token/<token> -
Conexão via endpoint interno na mesma região
jdbc:hive2://<endpoint>:80/;transportMode=http;httpPath=cliservice/token/<token>
Options
Run keep-alive query
Opcional. Ative esta opção para evitar a desconexão automática por tempo de inatividade.
-
-
Clique em Test Connection para verificar a conexão.

Clique em OK para concluir a configuração.
-
Agora você pode gerenciar o Spark Thrift Server usando o DataGrip.
Após conectar o DataGrip ao Spark Thrift Server, você poderá realizar o desenvolvimento de dados. Para mais informações, consulte a documentação de ajuda do DataGrip.
Por exemplo, na conexão criada, clique com o botão direito na tabela de destino, escolha e, no editor SQL que se abre, escreva e execute um script SQL para visualizar os dados da tabela.

Conectar ao Spark Thrift Server usando Redash
O Redash é uma ferramenta de BI de código aberto para consultas em banco de dados via web e visualização de dados. Para mais informações, consulte a documentação do Redash.
Instale o Redash. Para mais informações, consulte a documentação oficial do Redash.
-
Instale as dependências.
Verifique se a versão 0.20.0 do pacote
thriftestá instalada. Caso contrário, execute o comando a seguir para instalá-la.pip install thrift==0.20.0 Faça login no Redash.
No painel de navegação à esquerda, clique em Settings e, na aba Data Sources, clique em +New Data Source.
-
Na caixa de diálogo exibida, configure os parâmetros e clique em Create.

Parâmetro
Descrição
Type Selection
O tipo de fonte de dados. Na caixa de pesquisa, localize e selecione Hive (HTTP).
Configuration
Name
O nome da fonte de dados. É possível personalizar o nome.
Host
O endpoint do Spark Thrift Server.
Obtenha o Endpoint(Public) ou o Endpoint(Private) na aba Overview.
Port
-
Para acesso via endpoint público, a porta é 443.
-
Para acesso via endpoint interno na mesma região, a porta é 80.
HTTP Path
Defina como
/cliservice.Username
O nome de usuário. Insira qualquer nome, como
root.Password
Insira as informações do token que você criou.
HTTP Scheme
-
Para acesso via endpoint público, defina como
https. -
Para endpoint interno na mesma região, insira
http.
-
-
No topo da página, escolha . Escreva instruções SQL no editor.

Conectar ao Spark Thrift Server usando dbt
O dbt (data build tool) permite que analistas e engenheiros de dados escrevam lógica de transformação baseada em SQL e gerenciem implantações com boas práticas de engenharia de software, como versionamento e testes. Para mais informações, consulte a documentação do dbt.
-
Instale o dbt.
pip install dbt-sparkPara usar o conector Hive, instale também:
pip install dbt-spark[HIVE] -
Crie um projeto dbt.
dbt init my_spark_project cd my_spark_project -
Configure o perfil do dbt.
Defina as informações de conexão com o Spark Thrift Server no arquivo
~/.dbt/profiles.yml:Conexão via endpoint público
my_spark_project:
  target: dev
  outputs:
    dev:
      type: spark
      method: thrift
      host: <endpoint>
      port: 443
      user: <username>
      password: <token>
      schema: default
      connect_retries: 5
      connect_timeout: 60
      retry_all: true
      use_ssl: true
      server_side_parameters:
        "hive.exec.dynamic.partition": "true"
        "hive.exec.dynamic.partition.mode": "nonstrict"
Conexão via endpoint interno na mesma região
my_spark_project: target: dev outputs: dev: type: spark method: thrift host: <endpoint> port: 80 user: <username> password: <token> schema: default connect_retries: 5 connect_timeout: 60 retry_all: true use_ssl: false server_side_parameters: "hive.exec.dynamic.partition": "true" "hive.exec.dynamic.partition.mode": "nonstrict" -
Teste a conexão.
dbt debugSe a conexão for bem-sucedida, você verá uma saída semelhante à seguinte:
Connection test: [OK connection ok] -
Crie um modelo dbt.
Crie um arquivo SQL no diretório
models/, comomodels/example_model.sql:{{ config(materialized='table') }} select col1, col2, current_timestamp() as created_at from {{ ref('source_table') }} where col1 is not null -
Execute o projeto dbt.
# Run all models dbt run # Run a specific model dbt run --models example_model # Run tests dbt test # Generate documentation dbt docs generate dbt docs serve -
Configure as tabelas de origem e os testes.
Defina as tabelas de origem e os testes no arquivo
models/schema.yml:version: 2 sources: - name: raw_data description: "Raw data from source systems" tables: - name: source_table description: "Source table containing raw data" columns: - name: col1 description: "Primary identifier" tests: - not_null - unique - name: col2 description: "Data column" models: - name: example_model description: "Transformed data model" columns: - name: col1 description: "Primary identifier" tests: - not_null - unique - name: col2 description: "Processed data column" - name: created_at description: "Record creation timestamp"
Observações:
Verifique se a versão do dbt é compatível com o Spark Thrift Server. Use dbt-spark 1.3.0 ou superior.
Em ambientes de produção, configure informações sensíveis, como tokens, usando variáveis de ambiente em vez de gravá-las diretamente no arquivo de configuração.
Se ocorrer um timeout de conexão, ajuste os parâmetros
connect_timeouteconnect_retries.Para conjuntos de dados de grande volume, use um modelo de dados incremental para melhorar o desempenho:
{{ config(
    materialized='incremental',
    unique_key='id',
    incremental_strategy='merge'
) }} select * from source_table {% if is_incremental() %} where updated_at > (select max(updated_at) from {{ this }}) {% endif %}
Após concluir essas configurações, você poderá conectar ao Spark Thrift Server usando o dbt e aproveitar seus recursos para transformação e gerenciamento de dados.
Visualizar registros de execução
Após a conclusão de um job, você pode visualizar seu histórico de execuções.
Na página SQL Sessions, clique no nome da sessão desejada.
-
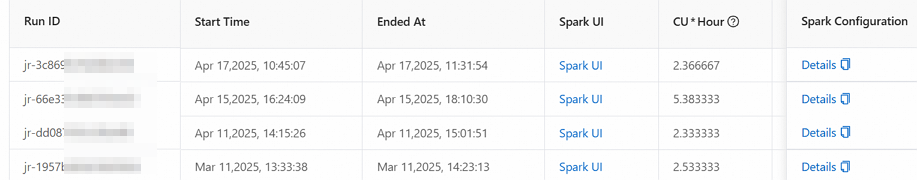
Clique na aba Execution Records.
Nesta aba, você pode visualizar detalhes de cada execução, como o ID da execução, o horário de início e um link para o Spark UI.