Uma sessão é uma sessão do Spark disponível em um workspace do EMR Serverless Spark. As sessões de notebook fornecem os recursos computacionais necessários para o desenvolvimento interativo de notebooks.
crie uma sessão de notebook
Depois de crie uma sessão de notebook, você pode selecione a sessão para o desenvolvimento de notebooks.
-
acesse a página Notebook Sessions.
Faça login no EMR console.
No painel de navegação à esquerda, escolha .
Na página Spark, clique em nome do workspace de destino.
Na página EMR Serverless Spark, escolha Sessions no painel de navegação à esquerda.
clique em aba Notebook Session.
Na página Notebook Session, clique em Create Notebook Session.
-
Na página Create Notebook Session, configure os seguintes parâmetros e clique em Create.
NotaRecomendamos defina a concorrência máxima da fila de recursos selecionada para, no mínimo, a quantidade de recursos exigida pela sessão de notebook. Esse valor é exibido no console.
Parâmetro
Descrição
Name
O nome da sessão de notebook.
O nome deve ter de 1 a 64 caracteres e pode conter letras, dígitos, hifens (-), sublinhados (_) e espaços.
Use GPU resources
Ao ative o Machine Learning, você pode especifique filas de implantação separadamente para o driver e os executores. As filas devem ser filas de GPU.
NotaLimites de uso de recursos do Spark:
-
Recursos do driver do Spark: a soma de todas as configurações de memória do driver deve ser menor ou igual ao tamanho de memória da instância de GPU.
-
Recursos do executor do Spark: a soma de todas as configurações de memória dos executores deve ser menor ou igual ao tamanho de memória da instância de GPU.
Engine Version
A versão do mecanismo para a sessão. Para mais informações, consulte Engine version overview.
Use Fusion Acceleration
O Fusion pode acelerar cargas de trabalho do Spark e reduzir o custo total dos jobs. Para obter informações de faturamento, consulte Product Billing. Para mais informações sobre o mecanismo Fusion, consulte Fusion engine.
Resource Queue
selecione uma fila de recursos para a sessão. Apenas filas designadas para desenvolvimento ou uso compartilhado estão disponíveis.
Para mais informações, consulte Manage resource queues.
Automatic Stop
ative por padrão. Você pode defina por quanto tempo a sessão pode ficar ociosa antes de parar automaticamente.
spark.driver.cores
O número de núcleos para o processo do driver. O valor padrão é 1.
spark.driver.memory
A quantidade de memória para o processo do driver. O valor padrão é 3,5 GB.
spark.executor.cores
O número de núcleos para cada processo de executor. O valor padrão é 1.
spark.executor.memory
A quantidade de memória para cada processo de executor. O valor padrão é 3,5 GB.
spark.executor.instances
O número de executores alocados pelo Spark. O valor padrão é 2.
Dynamic Resource Allocation
Desativado por padrão. Quando ativado, configure os seguintes parâmetros:
-
Minimum Number of Executors: O valor padrão é 2.
-
Maximum Number of Executors: Se você não defina spark.executor.instances, o valor padrão é 10.
More Memory Configurations
-
spark.driver.memoryOverhead: A memória não heap disponível para o driver. Se você não defina este parâmetro, o Spark aloca automaticamente um valor com base no padrão, que é
max(384 MB, 10% * spark.driver.memory). -
spark.executor.memoryOverhead: A memória não heap disponível para cada executor. Se você não defina este parâmetro, o Spark aloca automaticamente um valor com base no padrão, que é
max(384 MB, 10% * spark.executor.memory). -
spark.memory.offHeap.size: A quantidade de memória off-heap disponível para o Spark. O valor padrão é 1 GB.
Este parâmetro só entra em vigor quando
spark.memory.offHeap.enabledé defina comotrue. Ao usar o mecanismo Fusion, esse recurso é ativado por padrão com 1 GB de memória off-heap.
Environment
selecione um ambiente personalizado criado na página Environment. Quando a sessão de notebook é iniciada, o sistema pré-instala as bibliotecas do ambiente selecionado.
NotaVocê pode selecione apenas ambientes de execução que estejam no estado Ready.
Network Connection
Uma conexão de rede existente para acesse fontes de dados em uma VPC ou serviços externos. Para mais informações, consulte Network connectivity between EMR Serverless Spark and other VPCs.
Mount Integrated File Directory
Desativado por padrão. Para usar este recurso, adicione um diretório de arquivos na página Artifacts, na aba Integrated File Directory. Para mais informações, consulte Manage the integrated file directory.
Quando ativado, o sistema monta o diretório de arquivos integrado na sessão para que você possa acessar seus arquivos diretamente.
A operação de montagem consome recursos computacionais do driver. A quantidade consumida é o maior valor entre os dois seguintes:
-
Recursos fixos: 0,3 vCPUs + 1 GB de memória.
-
Recursos dinâmicos: 10% dos recursos do
spark.driver(ou seja, 10% dos núcleos e da memória dospark.driver).
Por exemplo, se o
spark.driverestiver configure com 4 núcleos e 8 GB de memória, os recursos dinâmicos serão 0,4 vCPUs + 0,8 GB de memória. Nesse caso, os recursos realmente consumidos sãomax(0,3 vCPUs + 1 GB, 0,4 vCPUs + 0,8 GB), o que resulta em 0,4 vCPUs + 1 GB de memória.Nota-
Escopo de montagem: Por padrão, o diretório de arquivos é montado apenas no driver. Para montá-lo também nos executores, ative Mount to Executor.
-
Vários diretórios: Você pode montar vários diretórios de arquivos integrados. No entanto, diretórios CPFS não podem ser usados junto com outros tipos. Por exemplo, você pode montar vários diretórios oss e NAS juntos, mas não pode montar CPFS com diretórios oss ou NAS.
-
Requisitos de rede: Ao montar um diretório de arquivos NAS ou CPFS, você deve configure uma conexão de rede. A VPC da conexão de rede deve ser a mesma VPC do destino de montagem do NAS ou CPFS.
Mount to Executor
Quando ativado, o sistema monta o diretório de arquivos integrado nos executores da sessão para que eles possam acessar os arquivos diretamente.
A montagem consome recursos dos executores. A quantidade consumida depende do uso dos arquivos.
Spark Configuration
Insira os parâmetros de configuração do Spark, separados por espaços. Exemplo:
spark.sql.catalog.paimon.metastore dlf. -
visualize registros de execute
Após a conclusão de um job, visualize seu histórico de execute.
Na página SQL Sessions, clique em nome da sessão desejada.
-
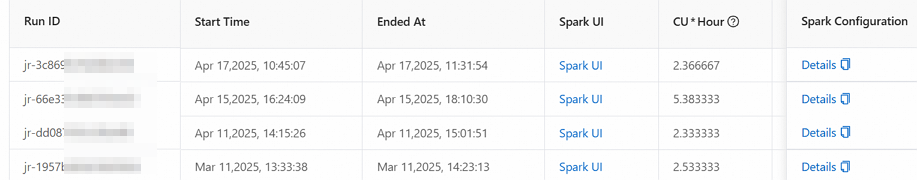
clique em aba Execution Records.
Nesta aba, você pode visualize os detalhes de cada execute, como o ID de execute, o horário de início e um link para a Spark UI.
Documentos relacionados
Para obter informações sobre operações de filas de recursos, consulte Manage resource queues.
Para obter informações sobre funções e permissões de sessão, consulte Manage users and roles.
Para um exemplo de ponta a ponta de desenvolvimento de notebook, consulte Get started with notebook development.