O EMR Serverless Spark conecta-se ao Hologres por meio do Hologres Spark Connector. Adicione as configurações necessárias para ler e gravar dados no Hologres em um ambiente Serverless Spark.
Limitações
O conector Spark exige a versão 1,3 ou posterior do Hologres. Verifique a versão da sua instância na página Instance Details no console do Hologres. Se a versão da sua instância for anterior à 1,3, atualize sua instância ou entre no grupo DingTalk do Hologres (ID: 32314975) para solicitar uma atualização.
Métodos de acesso
Você pode acessar o Hologres de duas maneiras. Escolha a opção mais adequada às suas necessidades:
|
Método de acesso |
Descrição |
Cenários |
Referências |
|
Método 1: Configuração no nível de tarefa ou sessão |
Configure as informações de conexão do Hologres (JDBC URL, nome de usuário, senha e outros parâmetros) separadamente em cada tarefa ou sessão. |
|
Este tópico |
|
Método 2: Configuração unificada via catálogos de dados (recomendado) |
Adicione um catálogo de dados do Hologres usando o recurso Data Catalogs do EMR Serverless Spark. Após adicionar o catálogo, todos os jobs e sessões no workspace poderão acessar os dados autorizados por padrão. Nota
Somente a versão de engine esr-4.9.0 e posteriores são suportadas. |
|
Para workspaces que exigem acesso frequente e de longo prazo aos dados do Hologres, o Método 2 (catálogos de dados) reduz configurações repetitivas e melhora a eficiência do desenvolvimento.
Procedimento
Etapa 1: Obter e fazer upload do JAR hologres-connector-spark****
As versões esr-4.8.0 e posteriores do EMR Serverless Spark já incluem o conector do Hologres integrado. Esta etapa só é necessária se você estiver usando uma versão anterior à esr-4.8.0.
Para ler e gravar no Hologres, o Spark precisa de um arquivo JAR de conector. Baixe-o no Repositório Central Maven. Este tópico utiliza a versão 1.5.6: hologres-connector-spark-3.x-1.5.6-jar-with-dependencies.jar.
Faça upload do arquivo JAR hologres-connector-spark baixado para o OSS. Para obter instruções, consulte Upload simples.
Etapa 2: Adicionar uma conexão de rede
-
Obtenha as informações de rede.
Acesse a página do Hologres e acesse os detalhes da instância do Hologres desejada para encontrar as informações de VPC e vSwitch.
-
Adicione uma conexão de rede.
O Serverless Spark requer uma conexão de rede com o cluster do Hologres. Para mais informações, consulte Conectividade de rede entre o EMR Serverless Spark e outras VPCs.
Etapa 3: Criar um banco de dados e uma tabela no Hologres
Conecte-se à instância do Hologres. Para obter detalhes, consulte Conectar-se a uma instância.
-
Na aba SQL Editor, insira as seguintes instruções SQL em uma nova consulta temporária e execute-as.
-- Create a database.
CREATE DATABASE testdb;
-- Create a table.
CREATE TABLE "public"."test" (
    "id" text  NULL,
    "name" text  NULL);
-- Insert data.
INSERT INTO public.test VALUES ('1001','jack'),('1002','tony'),('1003','mike');
-- Query data.
SELECT * FROM public.test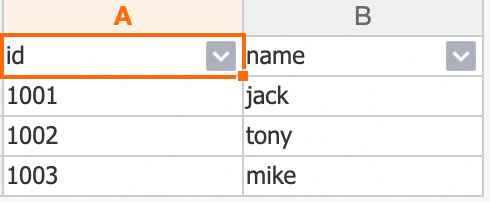
Etapa 4: Ler e gravar dados no Hologres
Exemplo 1: Sessão SQL
Leia e grave dados no Hologres usando uma sessão SQL.
-
Crie uma sessão SQL. Para obter detalhes, consulte Gerenciar sessões SQL.
Ao criar a sessão, selecione a conexão de rede criada na etapa anterior na lista de conexões de rede. Na seção Spark Configuration, adicione os seguintes parâmetros para carregar o hologres-connector-spark.
# Add the hologres-connector JAR file (only required for versions before esr-4.8.0).
spark.emr.serverless.user.defined.jars oss://<bucket>/hologres-connector-spark-3.x-<version>.jar

# Configure the Hologres catalog.
spark.sql.catalog.hologres_external_test_db com.alibaba.hologres.spark3.HoloTableCatalog
spark.sql.catalog.hologres_external_test_db.username ***
spark.sql.catalog.hologres_external_test_db.password ***
spark.sql.catalog.hologres_external_test_db.jdbcurl jdbc:postgresql://hgpostcn-cn-***-vpc-st.hologres.aliyuncs.com:80/testdb
A tabela a seguir descreve os parâmetros.
Parâmetro
Exemplo
Descrição
spark.emr.serverless.user.defined.jarsoss://<bucket>/hologres-connector-spark-3.x-<version>.jarCaminho para o arquivo JAR definido pelo usuário.
spark.sql.catalog.hologres_external_test_dbcom.alibaba.hologres.spark3.HoloTableCatalogConfigura uma fonte de dados do Hologres como um catálogo externo no Spark 3.x. Valor fixo.
spark.sql.catalog.hologres_external_test_db.usernameLTAI******AccessKey ID da sua conta Alibaba Cloud. Recomendamos usar o gerenciamento de segredos para lidar com informações sensíveis. Para obter detalhes, consulte Gerenciar informações sensíveis usando o gerenciamento de segredos.
spark.sql.catalog.hologres_external_test_db.passwordmXYV******AccessKey Secret da sua conta Alibaba Cloud. Recomendamos usar o gerenciamento de segredos para lidar com informações sensíveis. Para obter detalhes, consulte Gerenciar informações sensíveis usando o gerenciamento de segredos.
spark.sql.catalog.hologres_external_test_db.jdbcurljdbc:postgresql://hgpostcn-cn-***-vpc-st.hologres.aliyuncs.com:80/testdbJDBC connection URL da instância do Hologres.
É possível personalizar a parte
hologres_external_test_dbnos nomes dos parâmetros. -
Na página Data Development, crie um job SparkSQL e selecione a sessão SQL criada no canto superior direito.
Para mais informações, consulte Desenvolvimento SparkSQL.
-
Copie o código abaixo para a nova aba SparkSQL e clique em Run.
-- Switch to the testdb database.
USE hologres_external_test_db;
-- Write data.
INSERT INTO `public`.test VALUES ('1004','tom');
-- Query data.
SELECT * FROM `public`.test;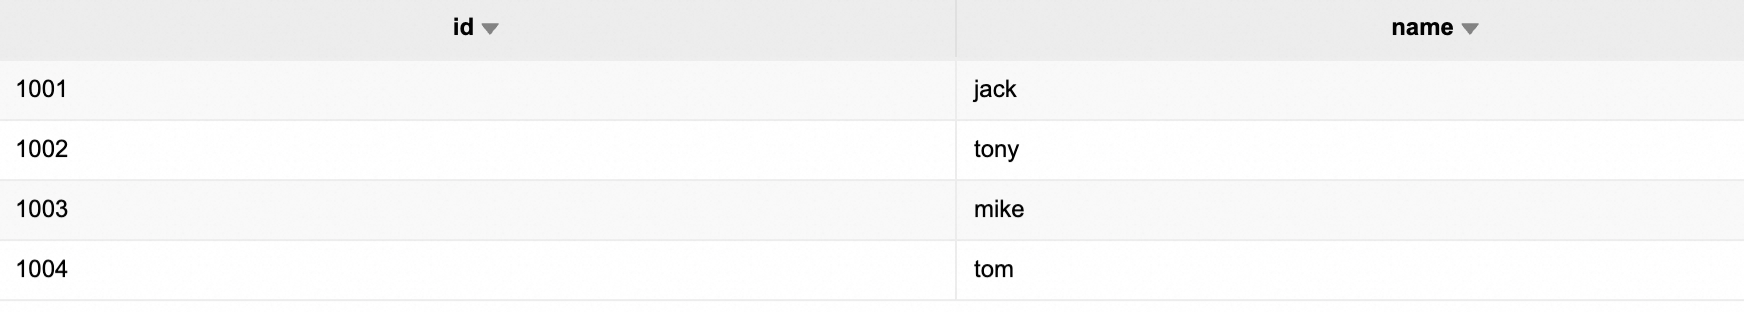
Exemplo 2: Job de streaming
Este exemplo em PySpark lê dados do Kafka e os grava no Hologres como um job de streaming.
Certifique-se de que a conexão de rede entre o Kafka e o Hologres esteja ativa. Recomendamos implantar o Kafka e o Hologres na mesma VPC e vSwitch.
-
Neste exemplo de código, substitua as informações do Kafka e a tabela do Hologres pelos seus valores reais.
from pyspark.sql import SparkSession from pyspark.sql.functions import col # Configure your Kafka information. servers = "alikafka-serverless-cn-xxxxx-vpc.alikafka.aliyuncs.com:9092" # Replace with your Kafka bootstrap servers. topic = "topic-name" # Replace with your Kafka topic. # Create a SparkSession. spark = SparkSession.builder \ .appName("test read kafka") \ .getOrCreate() # Read the Kafka stream. df = spark \ .readStream \ .format("kafka") \ .option("kafka.bootstrap.servers", servers) \ .option("subscribe", topic) \ .load() # Define a function to write to Hologres (called for each micro-batch). def write_to_hologres(batch_df, batch_id): print(f"Writing batch {batch_id} to Hologres...") batch_df.write \ .format("hologres") \ .mode("append") \ .insertInto("hologres_external_test_db.public.test") # Replace with your Hologres table. # Convert the key and value to strings and write the stream. query = df.selectExpr("CAST(key AS STRING)", "CAST(value AS STRING)") \ .writeStream \ .foreachBatch(write_to_hologres) \ .outputMode("append") \ .trigger(processingTime='30 seconds') \ .start() # Wait for the streaming query to terminate (this blocks cell execution in a notebook). query.awaitTermination() -
Faça upload do arquivo.
Na página Artifacts, clique em Upload File.
Na caixa de diálogo Upload File, clique na área de upload para selecionar o arquivo Python da etapa anterior ou arraste o arquivo para a área de upload.
-
Crie e execute o job de streaming.
Na página Development, clique no ícone
 (Create).
Na caixa de diálogo exibida, insira um Name, selecione PySpark na lista Application (Streaming) e clique em OK.
-
Na nova aba de desenvolvimento, configure os parâmetros a seguir e mantenha os demais com as configurações padrão. Em seguida, clique em Publish.
Parâmetro
Descrição
Main Python Resources
Selecione o arquivo Python enviado na etapa anterior.
Engine Version
Selecione uma versão compatível do Spark. Este exemplo usa
esr-4.6.0.Network Connection
Selecione a conexão de rede criada na Etapa 2.
Spark Configuration
# Add the hologres-connector JAR file (only required for versions before esr-4.8.0).
spark.emr.serverless.user.defined.jars              oss://<bucket>/test_script/hologres-connector-spark-3.x-1.5.6-jar-with-dependencies.jar
# Configure the Hologres catalog.
spark.sql.catalog.hologres_external_test_db com.alibaba.hologres.spark3.HoloTableCatalog
spark.sql.catalog.hologres_external_test_db.username ***
spark.sql.catalog.hologres_external_test_db.password ***
spark.sql.catalog.hologres_external_test_db.jdbcurl jdbc:postgresql://hgpostcn-cn-***-vpc-st.hologres.aliyuncs.com:80/testdb
Para obter uma descrição detalhada dos parâmetros, consulte Exemplo 1: Sessão SQL.
Após publicar o job, clique em Go to O&M. Na página que se abre, clique em Start.
-
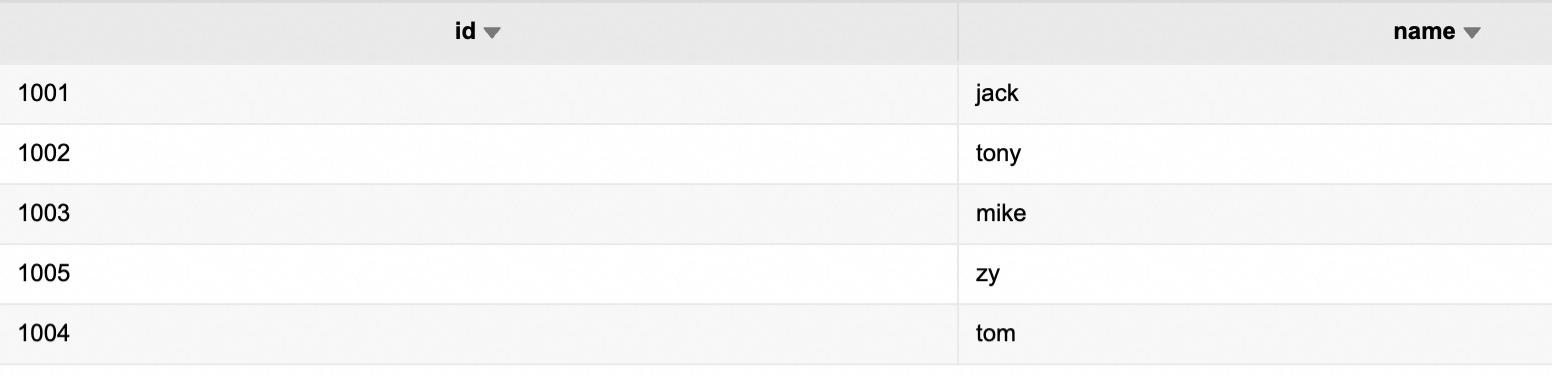
Verifique o resultado.
-
Envie mensagens para o Kafka.
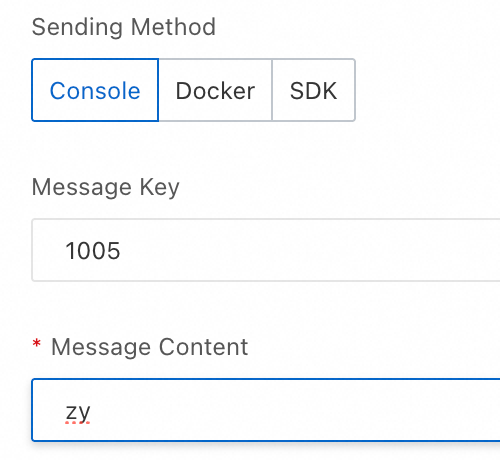
Consulte os dados usando Spark SQL.
-
Exemplo 3: Sessão Notebook
-
Crie uma sessão Notebook. Para obter detalhes, consulte Gerenciar sessões Notebook.
Ao criar a sessão, selecione a conexão de rede criada na etapa anterior na lista de conexões de rede. Na seção Spark Configuration, adicione o seguinte parâmetro para carregar o hologres-connector-spark.
# Add the hologres-connector JAR file (only required for versions before esr-4.8.0).
spark.emr.serverless.user.defined.jars oss://<bucket>/hologres-connector-spark-3.x-<version>.jar
Na página Data Development, crie um job Notebook e selecione a sessão Notebook criada no canto superior direito.
-
Copie o código abaixo para a nova aba Notebook e clique em
 .
import pandas as pd
from pyspark.sql import SparkSession
from pyspark.sql.types import StructType, StructField, StringType, IntegerType, LongType

# 1. Prepare a Pandas DataFrame.
pdf = pd.DataFrame({
    "id": ["1006"],
    "name": ["sl"]
})

# 2. Convert to a PySpark DataFrame.
# (Optional: Explicitly define the schema to ensure correct data types)
schema = StructType([
    StructField("id", StringType(), True),
    StructField("name", StringType(), True)
])

df = spark.createDataFrame(pdf, schema=schema)

# Write to Hologres.
df.write \
  .format("hologres") \
  .option("username", "LTAI******") \
  .option("password", "mXYV******") \
  .option("jdbcurl", "jdbc:postgresql://hgpostcn-cn-***-vpc-st.hologres.aliyuncs.com:80/testdb") \
  .option("table", "test") \
  .mode("append") \
  .save()

# Read data.
readDf = spark.read\
  .format("hologres") \
  .option("username", "LTAI******") \
  .option("password", "mXYV******") \
  .option("jdbcurl", "jdbc:postgresql://hgpostcn-cn-***-vpc-st.hologres.aliyuncs.com:80/testdb") \
  .option("table", "test") \
  .load()

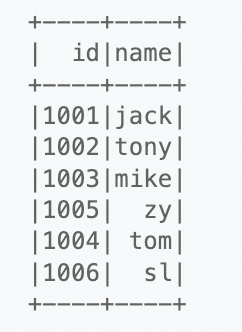
readDf.select("id", "name").show(10)
A tabela a seguir descreve os parâmetros.
Parâmetro
Exemplo
Descrição
usernameLTAI******AccessKey ID da sua conta Alibaba Cloud. Recomendamos usar o gerenciamento de segredos para lidar com informações sensíveis. Para obter detalhes, consulte Gerenciar informações sensíveis usando o gerenciamento de segredos.
passwordmXYV******AccessKey Secret da sua conta Alibaba Cloud. Recomendamos usar o gerenciamento de segredos para lidar com informações sensíveis. Para obter detalhes, consulte Gerenciar informações sensíveis usando o gerenciamento de segredos.
jdbcurljdbc:postgresql://hgpostcn-cn-***-vpc-st.hologres.aliyuncs.com:80/testdbJDBC connection URL da instância do Hologres.
Verifique o resultado.
Comandos comuns de catálogo do Hologres
Um catálogo do Hologres conecta um banco de dados do Hologres ao Spark SQL como um catálogo externo. Cada catálogo está vinculado a um único banco de dados do Hologres e não há suporte para acesso entre bancos de dados. A estrutura lógica dentro de um catálogo é consistente com o Hologres:
|
Conceito Spark |
Conceito Hologres |
Descrição |
|
catalog |
database |
Por exemplo, |
|
namespace |
schema |
Por exemplo, |
|
table |
table |
Especifique explicitamente |
Uso de um catálogo do Hologres
Um catálogo do Hologres no Spark mapeia exatamente para um banco de dados do Hologres e não pode ser alterado após a criação.
USE hologres_external_test_db;Listagem de todos os namespaces
Um namespace no Spark corresponde a um schema no Hologres. O schema padrão é public. Use o comando USE para alterar o schema padrão de uma sessão.
-- View all namespaces in the Hologres catalog, which correspond to all schemas in Hologres.
SHOW NAMESPACES;
Listagem de tabelas em um namespace
-
Liste todas as tabelas.
SHOW TABLES; -
Liste tabelas em um namespace específico.
USE test_schema;
SHOW TABLES;

-- Or use:
SHOW TABLES IN test_schema;
Documentos relacionados
Para mais informações sobre como usar o Spark para ler e gravar no Hologres, consulte Ler e gravar dados no Hologres usando o Spark.