Este tópico responde às perguntas frequentes (FAQs) sobre o EMR Serverless Spark.
As perguntas frequentes sobre o EMR Serverless Spark estão organizadas abaixo por área de compatibilidade.
Perguntas
Compatibilidade com DLF
O que fazer se ocorrer um erro java.net.UnknownHostException ao ler dados do DLF?
Esse erro ocorre em Development durante a execução de uma consulta SQL para leitura de dados de uma tabela do Data Lake Formation (DLF) 1.0, quando o EMR Serverless Spark não consegue resolver o host no caminho location da tabela. A solução depende de o cluster Hadoop Distributed File System (HDFS) usar alta disponibilidade (HA).
at org.apache.spark.sql.execution.SQLExecution$.withSQLConfPropagated(SQLExecution.scala:195)
at org.apache.spark.sql.execution.SQLExecution$.$anonfun$withNewExecutionId$1(SQLExecution.scala:103)
at org.apache.spark.sql.SparkSession.withActive(SparkSession.scala:827)
at org.apache.spark.sql.execution.SQLExecution$.withNewExecutionId(SQLExecution.scala:65)
at org.apache.spark.sql.Dataset.withAction(Dataset.scala:4206)
at org.apache.spark.sql.Dataset.collect(Dataset.scala:3459)
at org.apache.spark.sql.hive.thriftserver.SparkExecuteStatementOperation.org$apache$spark$sql$hive$thriftserver$SparkExecuteStatementOperation$$execute
(SparkExecuteStatementOperation.scala:235)
... 16 more
Caused by: java.net.UnknownHostException: master-1-1.c-8b5xxx.cn-hangzhou.emr.aliyuncs.com
... 66 more
HDFS sem HA
Verifique se o nome de domínio na location da tabela está acessível. Por padrão, master-1-1.<cluster-id>.<region>.emr.aliyuncs.com é diretamente acessível. Para outros nomes de domínio, adicione os mapeamentos necessários. Consulte Gerenciar nomes de domínio.
HDFS com HA
Configure os mapeamentos de nomes de domínio. Consulte Gerenciar nomes de domínio.
-
Crie um arquivo chamado
hdfs-site.xmlem/etc/spark/conf. Use como base o conteúdo do arquivohdfs-site.xmldo seu cluster EMR on ECS. Consulte Gerenciar configurações personalizadas para saber como fazer upload do arquivo. Veja abaixo um exemplo dehdfs-site.xml. Substitua os endereços do NameNode e os números de porta pelos valores do seu cluster.<?xml version="1.0"?> <configuration> <property> <name>dfs.nameservices</name> <value>hdfs-cluster</value> </property> <property> <name>dfs.ha.namenodes.hdfs-cluster</name> <value>nn1,nn2,nn3</value> </property> <property> <name>dfs.namenode.rpc-address.hdfs-cluster.nn1</name> <value>master-1-1.<cluster-id>.<region-id>.emr.aliyuncs.com:<port></value> </property> <property> <name>dfs.namenode.rpc-address.hdfs-cluster.nn2</name> <value>master-1-2.<cluster-id>.<region-id>.emr.aliyuncs.com:<port></value> </property> <property> <name>dfs.namenode.rpc-address.hdfs-cluster.nn3</name> <value>master-1-3.<cluster-id>.<region-id>.emr.aliyuncs.com:<port></value> </property> <property> <name>dfs.client.failover.proxy.provider.hdfs-cluster</name> <value>org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider</value> </property> </configuration>Após a criação do arquivo, o Java Runtime ou Fusion Runtime poderá resolver o cluster HA e acessar os dados.
Compatibilidade com OSS
Como acessar recursos do OSS entre contas?
Há dois métodos disponíveis. Escolha conforme a abrangência necessária para compartilhar o acesso:
|
Método |
Escopo |
Quando usar |
|
Nível de workspace |
Todos os jobs no workspace |
O workspace executa muitos jobs que precisam acessar o mesmo bucket e você deseja uma configuração única e persistente. |
|
Nível de tarefa e sessão |
Uma tarefa ou sessão específica |
O acesso é temporário ou específico da tarefa, ou você não tem permissão para modificar a configuração do workspace. |
Nível de workspace
Configure a política do bucket de destino do Object Storage Service (OSS) para conceder acesso de leitura e gravação à função de execução do workspace.
Faça login no console do OSS. No painel de navegação à esquerda, clique em Buckets e, em seguida, clique no bucket de destino.
No painel de navegação à esquerda, escolha Permission Control > Bucket Policy.
Na página Bucket Policy, clique na aba Add in GUI e, em seguida, clique em Authorize.
-
No painel Authorize, defina os parâmetros a seguir e clique em OK. Para todos os outros parâmetros, consulte Configure a bucket policy using the GUI.
Parâmetro
Valor
Applied To
Whole Bucket
Authorized User
Other Accounts. Defina Principal como
arn:sts::<uid>:assumed-role/<role-name>/*. Substitua<uid>pelo ID da conta Alibaba Cloud e<role-name>pelo nome da função de execução (diferencia maiúsculas de minúsculas). A função padrão é AliyunEMRSparkJobRunDefaultRole. Para encontrar a função de execução, acesse a página de lista de workspaces e clique em Details na coluna Actions.
Nível de tarefa e sessão
Ao criar uma tarefa ou sessão, adicione as seguintes propriedades na seção Spark Configurations. Substitua os placeholders pelos detalhes do seu bucket.
spark.hadoop.fs.oss.bucket.<bucketName>.endpoint <endpoint>
spark.hadoop.fs.oss.bucket.<bucketName>.credentials.provider com.aliyun.jindodata.oss.auth.SimpleCredentialsProvider
spark.hadoop.fs.oss.bucket.<bucketName>.accessKeyId <accessID>
spark.hadoop.fs.oss.bucket.<bucketName>.accessKeySecret <accessKey>|
Placeholder |
Descrição |
|
|
Nome do bucket do OSS |
|
|
Endpoint do OSS |
|
|
AccessKey ID da conta Alibaba Cloud usada para acessar os dados do OSS |
|
|
AccessKey secret da conta Alibaba Cloud usada para acessar os dados do OSS |
O que fazer se um arquivo do OSS não existir ou não puder ser acessado?
-
Problema
Ao executar um job no Alibaba Cloud EMR Serverless Spark, pode ocorrer um erro indicando que um arquivo do OSS referenciado pelo programa principal não existe ou não pode ser acessado.
-
Causa
Permissões insuficientes para a função de execução. A função de execução especificada durante a criação do workspace do Serverless Spark está configurada incorretamente ou a função de execução padrão foi alterada. Como resultado, o job não consegue acessar os recursos do OSS.
Caminho de arquivo do OSS incorreto. O caminho do arquivo do OSS referenciado pelo programa principal contém erros de digitação ou o arquivo não existe.
-
O nome do arquivo referenciado contém espaços
Se o nome do arquivo do OSS referenciado contiver espaços, a análise do caminho do arquivo poderá falhar.
-
Soluções
-
Verifique e configure corretamente a função de execução
Verifique a função de execução atual: Na página do Serverless Spark, clique em Details na coluna Actions do workspace. Verifique o valor de Execution Role e certifique-se de que seja
AliyunEMRSparkJobRunDefaultRole.Se você usa a função padrão, mas o problema persistir, investigue as outras possíveis causas.
-
Se você usa uma função personalizada:
Certifique-se de que a política de permissões inclua as permissões necessárias, como a permissão oss:GetObject para ler os recursos do OSS de destino. Para obter informações sobre como configurar as permissões, consulte AliyunEMRSparkJobRunDefaultRolePolicy.
-
Se a configuração de permissões for complexa ou se você não tiver certeza de que está correta, recrie o workspace e especifique a função padrão
AliyunEMRSparkJobRunDefaultRole role as the execution role.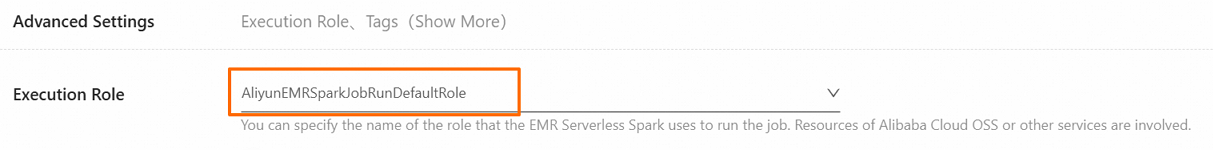 Nota
Recomendamos o uso da função padrão em vez de uma função personalizada para evitar problemas de configuração de permissões.
-
Verifique o caminho do arquivo do OSS
Confirme se o caminho do arquivo do OSS está correto, incluindo o prefixo
oss://, o nome do bucket, o caminho do diretório e o nome do arquivo.Use o console do OSS para verificar se o arquivo de destino existe.
-
Remova espaços do nome do arquivo
Verifique e renomeie o arquivo para garantir que seu nome não contenha espaços ou outros caracteres especiais.
Se o problema persistir após concluir as etapas de solução de problemas anteriores, entre em contato com o suporte técnico da Alibaba Cloud.
-
Compatibilidade com S3
Como acessar o S3?
Ao criar uma tarefa ou sessão, adicione as seguintes propriedades na seção Spark Configurations. Substitua os placeholders pelos detalhes do seu bucket.
spark.hadoop.fs.s3.impl com.aliyun.jindodata.s3.JindoS3FileSystem
spark.hadoop.fs.AbstractFileSystem.s3.impl com.aliyun.jindodata.s3.S3
spark.hadoop.fs.s3.bucket.<bucketName>.accessKeyId <accessID>
spark.hadoop.fs.s3.bucket.<bucketName>.accessKeySecret <accessKey>
spark.hadoop.fs.s3.bucket.<bucketName>.endpoint <endpoint>
spark.hadoop.fs.s3.credentials.provider com.aliyun.jindodata.s3.auth.SimpleCredentialsProvider|
Placeholder |
Descrição |
|
|
Nome do bucket do S3 |
|
|
Endpoint do S3 |
|
|
AccessKey ID da conta usada para acessar o S3 |
|
|
AccessKey secret da conta usada para acessar o S3 |
Compatibilidade com OBS
Como acessar o OBS?
Ao criar uma tarefa ou sessão, adicione as seguintes propriedades na seção Spark Configurations. Substitua os placeholders pelos detalhes do seu bucket.
spark.hadoop.fs.obs.impl com.aliyun.jindodata.obs.JindoObsFileSystem
spark.hadoop.fs.AbstractFileSystem.obs.impl com.aliyun.jindodata.obs.OBS
spark.hadoop.fs.obs.bucket.<bucketName>.accessKeyId <accessID>
spark.hadoop.fs.obs.bucket.<bucketName>.accessKeySecret <accessKey>
spark.hadoop.fs.obs.bucket.<bucketName>.endpoint <endpoint>
spark.hadoop.fs.obs.credentials.provider com.aliyun.jindodata.obs.auth.SimpleCredentialsProvider|
Placeholder |
Descrição |
|
|
Nome do bucket do OBS |
|
|
Endpoint do OBS |
|
|
AccessKey ID da conta usada para acessar o OBS |
|
|
AccessKey secret da conta usada para acessar o OBS |