Quando várias equipes compartilham um cluster Hadoop, a contenção de recursos causa desempenho imprevisível nos jobs e dificulta a alocação de custos. Os agendadores do YARN resolvem esse problema ao impor garantias de recursos por tenant, aplicar políticas de justiça multitenant e otimizar a utilização dos nós para evitar hotspots.
O Capacity Scheduler é recomendado para o YARN no E-MapReduce (EMR). Este documento explica o funcionamento do Capacity Scheduler e como configurá-lo. Para outros tipos de agendador, consulte a documentação do Apache Hadoop YARN.
Escolha um agendador
|
Agendador |
Padrão em |
Suporte multitenant |
Rótulos de nó / atributos / restrições de posicionamento |
Quando usar |
|
FIFO Scheduler |
— |
Não |
Não |
Cenários simples e single-tenant. Raramente usado em produção. |
|
Fair Scheduler |
CDH (Cloudera Distributed Hadoop) |
Sim |
Não |
Clusters CDH legados. Não recomendado para novas implantações. |
|
Capacity Scheduler |
Apache Hadoop, HDP, CDP |
Sim |
Sim |
Clusters de produção multitenant com requisitos de desempenho e isolamento de recursos. Recomendado para YARN no EMR. |
O Capacity Scheduler oferece o conjunto completo de capacidades de gerenciamento multitenant e agendamento de recursos, incluindo agendamento global, rótulos de nó, atributos de nó e restrições de posicionamento. O rest deste documento detalha o Capacity Scheduler.
Como funciona o Capacity Scheduler
Modos de agendamento
O MainScheduler do Capacity Scheduler suporta três modos de acionamento:
|
Modo |
Funcionamento |
Mais indicado para |
|
Acionado por heartbeat de nó |
O MainScheduler é acionado quando um nó envia um heartbeat. O agendamento ocorre localmente no nó e depende dos intervalos de heartbeat, o que pode reduzir a eficiência quando muitos nós têm recursos insuficientes. |
Clusters com baixos requisitos de desempenho e funcionalidades de agendamento. |
|
Agendamento assíncrono |
Uma thread assíncrona seleciona aleatoriamente um nó da lista para agendamento. Isso melhora o throughput sem exigir estado global. |
Clusters com altos requisitos de desempenho, mas poucos requisitos de funcionalidades. |
|
Agendamento global |
Uma thread global seleciona aplicações com base na justiça multitenant e na prioridade e, em seguida, escolhe os nós considerando tamanho de recursos, restrições de posicionamento e distribuição de recursos no cluster. Esse método gera decisões de agendamento otimizadas. |
Clusters com altos requisitos tanto de desempenho quanto de funcionalidades de agendamento. |
O agendamento global exige todas as configurações de agendamento assíncrono além de suas próprias definições. Consulte Agendamento global para obter detalhes.
Arquitetura (agendamento global)
A figura a seguir mostra a arquitetura do agendamento global com base no YARN 3.2 ou posterior.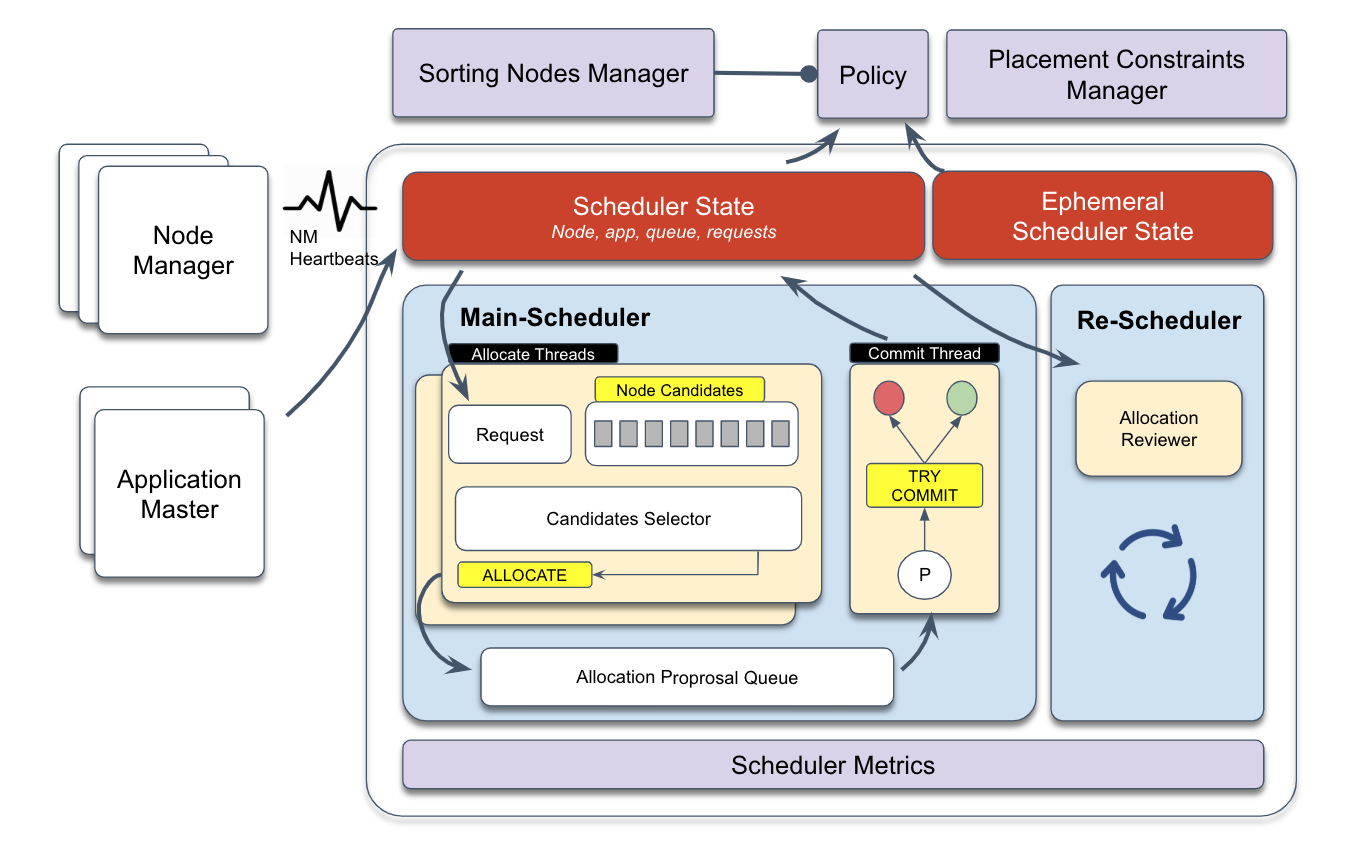
O MainScheduler executa como um framework assíncrono multithread:
As threads de alocação identificam a solicitação de recurso de maior prioridade, selecionam nós candidatos com base no tamanho dos recursos e nas restrições de posicionamento, geram propostas de alocação e as colocam em uma fila intermediária.
A thread de submissão consome as propostas de alocação, revalida as restrições de posicionamento e os requisitos da aplicação/nó e então confirma ou descarta cada proposta, atualizando o state do agendador.
O ReScheduler executa periodicamente como um framework de monitoramento dinâmico de recursos. Ele implementa políticas de preempção entre filas, dentro da fila e de recursos reservados.
O Node Sorting Manager e o Placement Constraint Manager são plug-ins de agendamento global para o MainScheduler. Eles cuidam do balanceamento de carga e do gerenciamento complexo de restrições de posicionamento.
Processo de alocação de contêineres
A figura a seguir ilustra o processo de agendamento global do Capacity Scheduler.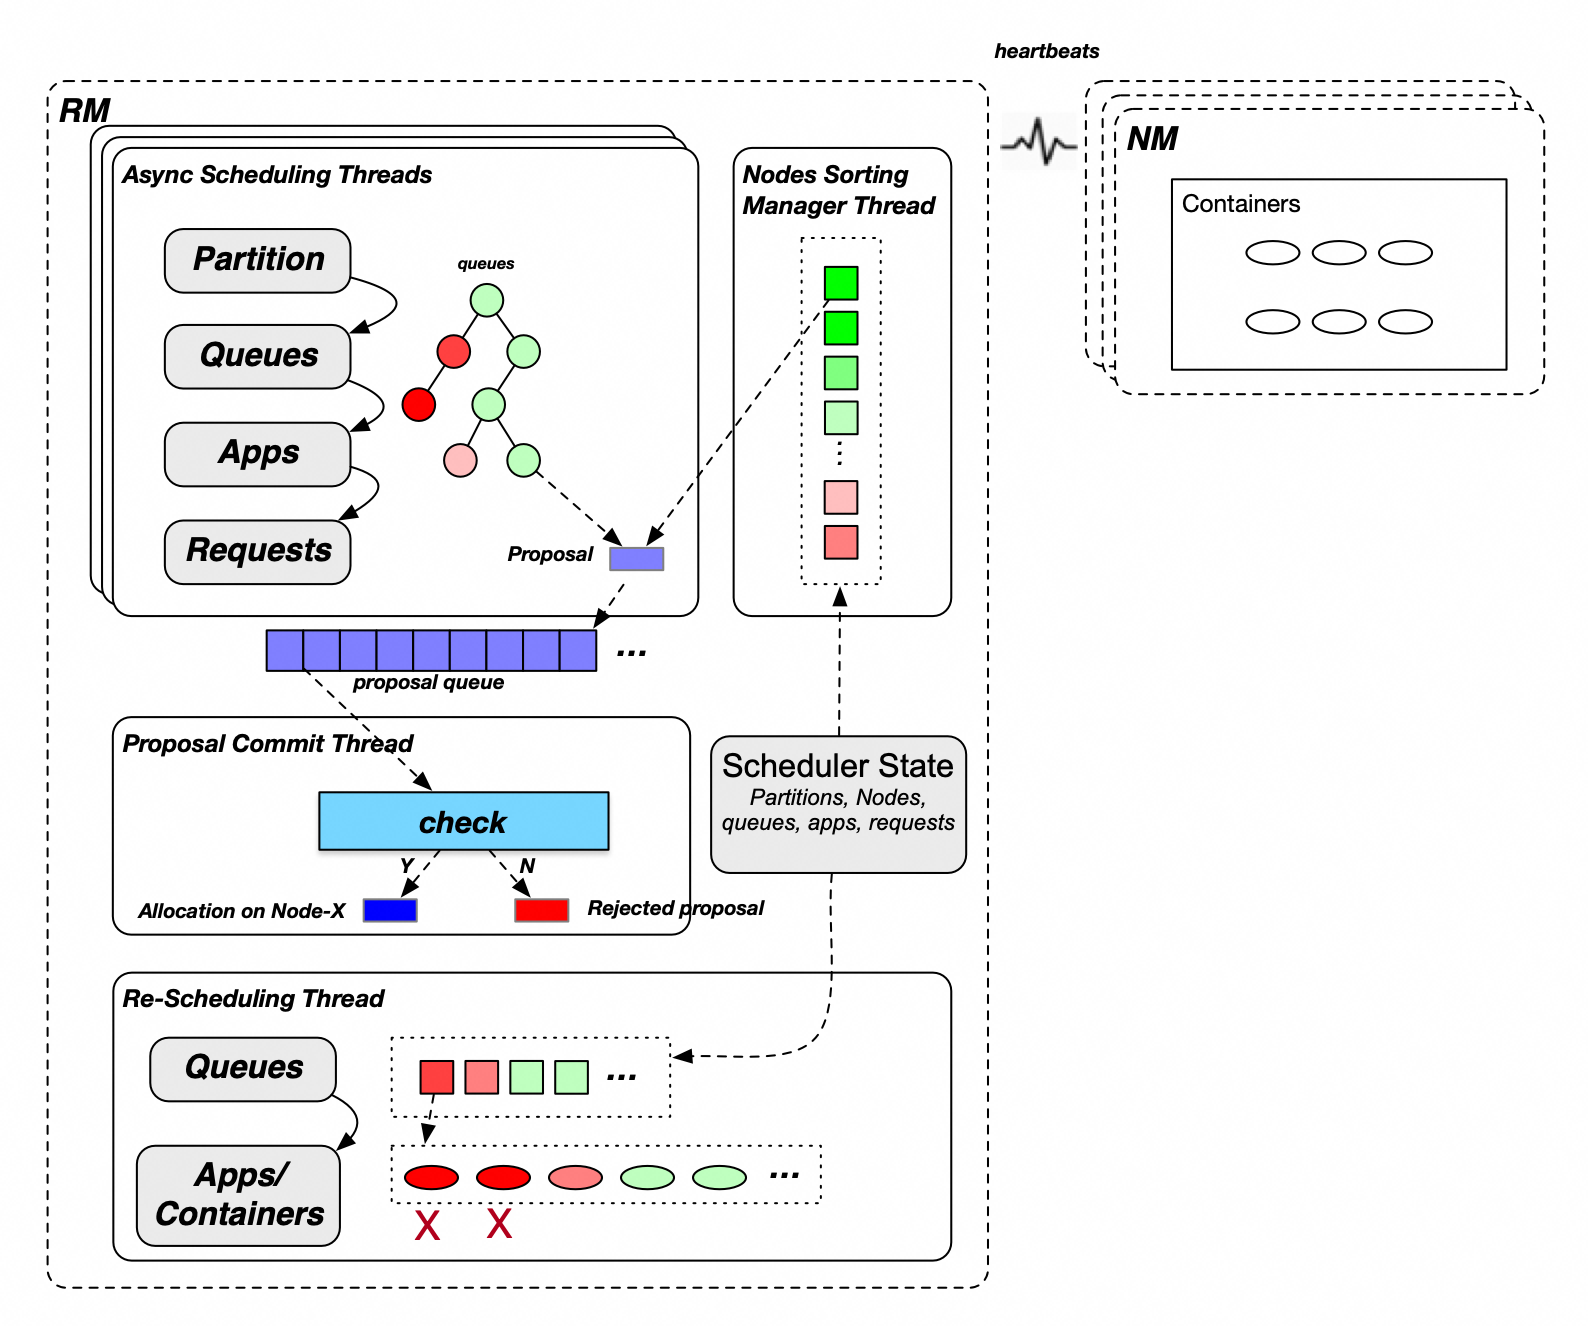
O MainScheduler aloca contêineres em seis etapas:
Selecione partições (rótulos de nó). Um cluster pode ter uma ou mais partições. O MainScheduler aloca contêineres nas partições sequencialmente.
Selecione filas folha. Percorrendo da fila raiz para baixo, as filas filhas em cada nível são visitadas em ordem crescente de sua porcentagem de recursos garantidos. Filas com menor utilização (mostradas em verde na figura acima) recebem recursos antes daquelas com maior utilização (mostradas em vermelho).
-
Selecione aplicações. Dentro de uma fila, o MainScheduler escolha as aplicações conforme a política de ordenação da fila:
Política Fair: ordem crescente de recursos de memória alocados
Política FIFO: ordem decrescente de prioridade e, em seguida, ordem crescente de ID da aplicação
Selecione solicitações. O MainScheduler escolha as solicitações dentro da aplicação selecionada com base na prioridade.
Selecione nós candidatos ordenados. O MainScheduler busca em todos os nós ordenados os candidatos que atendem aos requisitos de recursos e às restrições de posicionamento da solicitação.
Aloque um contêiner. Para cada nó candidato, o MainScheduler verifica os recursos alocados, em uso e não confirmados da fila e do nó. Se a verificação for aprovada, ele gera uma proposta de alocação e a coloca na fila de propostas.
Após a alocação, a thread de submissão valida cada proposta em relação aos requisitos da aplicação, do nó e das restrições de posicionamento. Propostas reprovadas são descartadas; as aprovadas entram em vigor e atualize a contabilidade de recursos da aplicação e do nó.
Preempção
O ReScheduler monitora os recursos do cluster e aciona a preempção quando o total de recursos disponíveis cai abaixo de um limiar e aplicações específicas estão com recursos insuficientes.
|
Tipo de preempção |
Condição de acionamento |
|
Preempção entre filas |
Os recursos garantidos de uma fila estão totalmente em uso, mas outra fila com direito a esses recursos não consegue obtê-los porque o cluster não tem capacidade ociosa. Recursos dentro da capacidade da fila são garantidos; recursos acima da capacidade, mas abaixo da capacidade máxima, são compartilhados. |
|
Preempção intrafila |
Uma aplicação de alta prioridade em uma fila precisa de recursos, mas a alocação total da fila está esgotada. O ReScheduler rebalanceia com base na política FIFO ou Fair. |
|
Preempção de recursos reservados |
Uma tarefa que reservou recursos atende a uma condição de liberação, como timeout. A tarefa e seus recursos reservados são liberados. |
Principais recursos
Gerenciamento de filas multinível: A cota de recursos de uma fila pai limita o uso total de todas as suas filas filhas. Nenhuma fila filha individual pode exceder a cota da pai. Isso proporciona isolamento multitenant controlável para estruturas organizacionais complexas.
Cota de recursos: Defina capacidade garantida e capacidade máxima por fila, limite o número de aplicações simultâneas, restrinja a parcela de recursos do ApplicationMaster (AM) e controle as proporções de recursos por usuário.
Compartilhamento elástico de recursos: Quando o cluster e a fila pai possuem recursos ociosos, as filas filhas podem pegar emprestado recursos garantidos não utilizados de filas irmãs. Capacidade elástica = capacidade máxima da fila − capacidade da fila.
Controle de acesso baseado em ACL: Atribua permissões de submissão e gerenciamento por fila a usuários ou grupos específicos. Um único usuário pode gerencie várias filas, ou vários usuários podem compartilhar acesso de submissão à mesma fila.
Agendamento de filas entre tenants: No mesmo nível de fila, o agendamento ocorre em ordem crescente de porcentagem de recursos garantidos, de modo que filas com menores alocações são atendidas primeiro. Quando prioridades estão configuradas, as filas se dividem em dois grupos — aquelas na capacidade ou abaixo dela e aquelas acima — e as filas na capacidade ou abaixo são atendidas primeiro dentro de cada grupo.
Agendamento de aplicações intratenant: Dentro de uma fila, as aplicações são agendadas conforme a política de ordenação da fila. Na política FIFO: prioridade decrescente e, depois, tempo de submissão crescente. Na política Fair: porcentagem crescente de recursos usados e, depois, tempo de submissão crescente.
Preempção: Mantém o uso de recursos de filas e aplicações equilibrado conforme os recursos do cluster mudam. Consulte Preempção para conhecer os três tipos de preempção.
Configure o Capacity Scheduler
Configurações globais
Configure os seguintes parâmetros em yarn-site.xml e capacity-scheduler.xml.
| Arquivo de configuração | Item de configuração | Valor recomendado | Descrição |
|---|---|---|---|
yarn-site.xml | yarn.resourcemanager.scheduler.class | Deixe em branco | Classe do agendador. Padrão: org.apache.hadoop.yarn.server.resourcemanager.scheduler.capacity.CapacityScheduler. |
capacity-scheduler.xml | yarn.scheduler.capacity.maximum-applications | Deixe em branco | Máximo de aplicações simultâneas no cluster. Padrão: 10000. |
yarn.scheduler.capacity.global-queue-max-application | Deixe em branco | Máximo de aplicações simultâneas por fila. Se não definido, o limite por fila é calculado como: Capacidade da fila / Recurso do cluster × maximum-applications. Configure isso apenas para filas com requisitos especiais, como uma fila de baixa capacidade que precisa execute muitas aplicações. | |
yarn.scheduler.capacity.maximum-am-resource-percent | 0.25 | Porcentagem máxima de recursos da fila que contêineres do ApplicationMaster (AM) podem usar, limitada a: este valor × capacidade máxima da fila. Padrão: 0,1. Aumente este valor se uma fila execute muitas aplicações pequenas com alta proporção de contêineres AM. | |
yarn.scheduler.capacity.resource-calculator | org.apache.hadoop.yarn.util.resource.DominantResourceCalculator | Calculadora de recursos para filas, nós e aplicações. O padrão (DefaultResourceCalculator) considera apenas memória. O DominantResourceCalculator considera todos os tipos de recursos configurados (memória, CPU e outros) e usa o recurso mais consumido como recurso principal. Nota Alterações neste item exigem reinicialização do ResourceManager (ou failover primário/secundário se alta disponibilidade (HA) estiver ativada). Uma operação de refresh não é suficiente. | |
yarn.scheduler.capacity.node-locality-delay | -1 | Número de ciclos de agendamento a ignorar antes de relaxar a localidade do nó. Padrão: 40. Defina como -1 para desativar o atraso de localidade e melhorar o desempenho do agendamento. Com redes e armazenamento modernos, o agendamento local raramente é o gargalo. |
Configurações de heartbeat de nó
|
Arquivo de configuração |
Item de configuração |
Valor recomendado |
Descrição |
|
|
|
|
Indica se deve alocar múltiplos contêineres por heartbeat. Padrão: |
|
|
Deixe em branco |
Máximo de contêineres atribuíveis por heartbeat. Padrão: 100. Efetivo apenas quando |
|
|
|
Deixe em branco |
Máximo de contêineres off-switch atribuíveis por heartbeat. Efetivo apenas quando |
Agendamento assíncrono
|
Arquivo de configuração |
Item de configuração |
Valor recomendado |
Descrição |
|
|
|
|
Indica se deve ative o agendamento assíncrono. Padrão: |
|
|
|
Máximo de threads para agendamento assíncrono. Padrão: 1. Múltiplas threads podem gerar propostas duplicadas; uma única thread é suficiente na maioria dos casos. |
|
|
|
Deixe em branco |
Máximo de propostas de alocação pendentes na fila. Padrão: 100. Aumente este valor para clusters grandes. |
Agendamento global
O agendamento global requer todas as configurações de agendamento assíncrono listadas na tabela anterior.
| Arquivo de configuração | Item de configuração | Valor recomendado | Descrição |
|---|---|---|---|
capacity-scheduler.xml | yarn.scheduler.capacity.multi-node-placement-enabled | true | Indica se deve ative o agendamento global. Padrão: false. Ative para clusters com altos requisitos tanto de desempenho quanto de funcionalidades de agendamento. |
yarn.scheduler.capacity.multi-node-sorting.policy | default | Nome da política ativa de agendamento global. | |
yarn.scheduler.capacity.multi-node-sorting.policy.names | default | Lista separada por vírgulas dos nomes das políticas de agendamento global. | |
yarn.scheduler.capacity.multi-node-sorting.policy.default.class | org.apache.hadoop.yarn.server.resourcemanager.scheduler.placement.ResourceUsageMultiNodeLookupPolicy | Classe de implementação da política padrão. Ordena os nós em ordem crescente de recursos alocados absolutos. | |
yarn.scheduler.capacity.multi-node-sorting.policy.default.sorting-interval.ms | 0 (clusters pequenos) / 1000 (clusters com mais de 1.000 nós) | Intervalo de atualização de cache para ordenação de nós. Padrão: 1000 ms. Defina como 0 para ordenação síncrona (sem cache). Para clusters grandes, defina como 1000 para ative o cache de nós e melhorar o desempenho. Nota Com o cache de nós ativado, os contêineres podem se concentrar nos nós melhor classificados. Teste o impacto antes de ative isso em produção. |
Configurações de partição de nó
Para configurações de partição de nó (rótulo de nó), consulte Node labels.
Configurações de fila
Configurações básicas de fila
As configurações básicas definem a hierarquia de filas, a capacidade garantida e a capacidade máxima. O exemplo a seguir mostra uma fila raiz com quatro filas filhas compartilhadas entre departamentos de uma organização.

Exemplo de estrutura de filas:
|
Fila |
Recursos garantidos |
Recursos máximos |
Filhas |
|
|
100% |
100% |
dev, test, support, default |
|
|
50% |
100% |
training, services |
|
|
40% de dev |
100% de dev |
— |
|
|
60% de dev |
100% de dev |
— |
|
|
30% |
50% |
— |
|
|
10% |
30% |
— |
|
|
10% |
100% |
— |
O exemplo de capacity-scheduler.xml a seguir configure essa estrutura. Copie e ajuste-o para corresponder ao layout de filas da sua organização.
<configuration>
  <!-- Root-level child queues -->
  <property>
    <name>yarn.scheduler.capacity.root.queues</name>
    <value>dev,test,support,default</value>
  </property>

  <!-- dev queue: 50% guaranteed, 100% max -->
  <property>
    <name>yarn.scheduler.capacity.root.dev.capacity</name>
    <value>50</value>
  </property>
  <property>
    <name>yarn.scheduler.capacity.root.dev.maximum-capacity</name>
    <value>100</value>
  </property>
  <property>
    <name>yarn.scheduler.capacity.root.dev.queues</name>
    <value>training,services</value>
  </property>

  <!-- dev.training: 40% of dev guaranteed, 100% of dev max -->
  <property>
    <name>yarn.scheduler.capacity.root.dev.training.capacity</name>
    <value>40</value>
  </property>
  <property>
    <name>yarn.scheduler.capacity.root.dev.training.maximum-capacity</name>
    <value>100</value>
  </property>

  <!-- dev.services: 60% of dev guaranteed, 100% of dev max -->
  <property>
    <name>yarn.scheduler.capacity.root.dev.services.capacity</name>
    <value>60</value>
  </property>
  <property>
    <name>yarn.scheduler.capacity.root.dev.services.maximum-capacity</name>
    <value>100</value>
  </property>

  <!-- test queue: 30% guaranteed, 50% max -->
  <property>
    <name>yarn.scheduler.capacity.root.test.capacity</name>
    <value>30</value>
  </property>
  <property>
    <name>yarn.scheduler.capacity.root.test.maximum-capacity</name>
    <value>50</value>
  </property>

  <!-- support queue: 10% guaranteed, 30% max -->
  <property>
    <name>yarn.scheduler.capacity.root.support.capacity</name>
    <value>10</value>
  </property>
  <property>
    <name>yarn.scheduler.capacity.root.support.maximum-capacity</name>
    <value>30</value>
  </property>

  <!-- default queue: 10% guaranteed, 100% max -->
  <property>
    <name>yarn.scheduler.capacity.root.default.capacity</name>
    <value>10</value>
  </property>
  <property>
    <name>yarn.scheduler.capacity.root.default.maximum-capacity</name>
    <value>100</value>
  </property>
</configuration>
Na página Application Queues do YARN ResourceManager, verifique se a configuração da fila entrou em vigor. A árvore de hierarquia de filas mostra as seguintes filas sob root: default, test, support, dev e, sob dev, as subfilas training e services. Expanda a fila dev.services para visualize detalhes do status de execução:
Queue State: RUNNING
Effective Capacity:
memory:7864, vCores:4(60,0%)Effective Max Capacity:
memory:26214, vCores:16(100,0%)Absolute Configured Capacity: 30,0%
Max Applications: 3000
Ordering Policy: FifoOrderingPolicy
Preemption: disabled
A tabela a seguir descreve os parâmetros do capacity-scheduler.xml para essa estrutura.
|
Arquivo de configuração |
Item de configuração |
Valor de exemplo |
Descrição |
|
|
|
|
Filhas da fila raiz. Separe múltiplas filas com vírgulas. |
|
|
|
Porcentagem de recursos garantidos para a fila |
|
|
|
|
Porcentagem máxima de recursos para a fila |
|
|
|
|
Filhas da fila |
|
|
|
|
Porcentagem de recursos garantidos para |
|
|
|
|
Porcentagem máxima de recursos para |
|
|
|
|
Porcentagem de recursos garantidos para |
|
|
|
|
Porcentagem máxima de recursos para |
|
|
|
|
Porcentagem de recursos garantidos para |
|
|
|
|
Porcentagem máxima de recursos para |
|
|
|
|
Porcentagem de recursos garantidos para |
|
|
|
|
Porcentagem máxima de recursos para |
|
|
|
|
Porcentagem de recursos garantidos para |
|
|
|
|
Porcentagem máxima de recursos para |
Configurações avançadas de fila
|
Arquivo de configuração |
Item de configuração |
Valor recomendado |
Descrição |
|
|
|
|
Política de ordenação de aplicações dentro de uma fila. |
|
|
Deixe em branco |
Indica se deve usar agendamento fair baseado em peso. Padrão: |
|
|
|
Deixe em branco |
Estado da fila. Padrão: |
|
|
|
Deixe em branco |
Limite de recursos AM por fila. Padrão: herda de |
|
|
|
Deixe em branco |
Fator de limite superior para um único usuário. Recursos máximos que um usuário pode usar: min(recursos máximos da fila, recursos garantidos da fila × userLimitFactor). Padrão: 1,0. |
|
|
|
Deixe em branco |
Porcentagem mínima de recursos garantidos que um único usuário pode usar. Calculado como: max(recursos garantidos / número de usuários, recursos garantidos × min(userLimitFactor) / 100). Padrão: 100. |
|
|
|
Deixe em branco |
Máximo de aplicações simultâneas nesta fila. Padrão: porcentagem de recursos garantidos × |
|
|
|
Deixe em branco |
ACL de submissão para esta fila. Herda da fila pai se não definido. |
|
|
|
Deixe em branco |
ACL de gerenciamento para esta fila. Herda da fila pai se não definido. |
Configurações de ACL
A ACL está desativada por padrão. Ative-a apenas quando sua organização exigir controle de acesso na submissão e no gerenciamento de filas.
|
Arquivo de configuração |
Item de configuração |
Valor recomendado |
Descrição |
|
|
|
Deixe em branco |
Indica se deve ative a ACL. Padrão: |
|
|
|
Deixe em branco |
ACL de submissão. Herda da fila pai se não definido. Por padrão, a fila raiz permite que todos os usuários envie aplicações. |
|
|
Deixe em branco |
ACL de gerenciamento. Herda da fila pai se não definido. Por padrão, a fila raiz permite que todos os usuários gerencie filas. |
A ACL de uma fila pai aplica-se a todas as suas filas filhas. Se a fila raiz permitir todos os usuários (padrão), as restrições de ACL das filas filhas não terão efeito. Para impor a ACL das filas filhas, primeiro restrinja a fila raiz definindo:
yarn.scheduler.capacity.root.acl_submit_applications=<space>yarn.scheduler.capacity.root.acl_administer_queue=<space>
Para conceder a um usuário ou grupo permissões de submissão e gerenciamento em uma fila, configure tanto acl_submit_applications quanto acl_administer_queue para essa fila.
Configurações de preempção
A preempção garante distribuição justa de recursos entre tenants e respeita as prioridades das aplicações. Ative-a para clusters com requisitos rigorosos de agendamento. A preempção requer YARN V2.8.0 ou posterior.
|
Arquivo de configuração |
Item de configuração |
Valor recomendado |
Descrição |
|
|
|
|
Ative a preempção. |
|
|
|
|
Ative a preempção intrafila. A preempção entre filas é ativada por padrão e não pode ser desativada. |
|
|
|
Política de ordem de preempção intrafila. Padrão: |
|
|
|
|
Indica se deve proteger esta fila contra preempção. Herda da pai se não definido. Definir como |
|
|
|
|
Indica se deve desativar a preempção intrafila para esta fila. Herda da pai se não definido. |
Gerencie configurações de fila com a API RESTful
A partir do YARN V3.2.0, use a api RESTful para aplicar atualizações incrementais de configuração e visualize todas as definições ativas no capacity-scheduler.xml. Versões anteriores suportam apenas atualizações completas via operação RefreshQueues, sem maneira de inspecionar as configurações ativas.
Para ative o gerenciamento de filas via api RESTful, adicione as seguintes definições ao yarn-site.xml:
|
Item de configuração |
Valor recomendado |
Descrição |
|
|
|
Tipo de armazenamento para configurações do agendador. |
|
|
|
Número máximo de versões de configuração armazenadas no sistema de arquivos. Versões antigas são excluídas automaticamente. |
|
|
|
Caminho onde o |
Visualize configurações ativas:
api RESTful:
http://<rm-address>/ws/v1/cluster/scheduler-confHDFS:
${yarn.scheduler.configuration.fs.path}/capacity-scheduler.xml.<timestamp>— o arquivo com o maior timestamp é a versão mais recente.
Atualize configurações incrementalmente:
O exemplo a seguir altera yarn.scheduler.capacity.maximum-am-resource-percent para 0.2 e exclua o parâmetro yarn.scheduler.capacity.xxx. Para exclua um parâmetro, omita o campo value.
curl -X PUT -H "Content-type: application/json" 'http://<rm-address>/ws/v1/cluster/scheduler-conf' -d '
{
  "global-updates": [
    {
      "entry": [{
        "key": "yarn.scheduler.capacity.maximum-am-resource-percent",
        "value": "0.2"
      },{
        "key": "yarn.scheduler.capacity.xxx"
      }]
    }
  ]
}'
Limites de recursos por contêiner
Os recursos máximos para um único contêiner são determinados pelas seguintes definições. Se uma solicitação de contêiner exceder o limite, o agendador registra um erro InvalidResourceRequestException: Invalid resource request....
|
Arquivo de configuração |
Item de configuração |
Descrição |
Padrão |
|
|
|
Memória máxima por contêiner no nível do cluster. Unidade: MiB. |
O valor de |
|
|
cpu máxima por contêiner no nível do cluster. Unidade: vCore. |
|
|
|
|
|
Memória máxima por contêiner no nível da fila. Substitui a definição do nível do cluster apenas para esta fila. |
Deixe em branco (herda a definição do nível do cluster) |
|
|
cpu máxima por contêiner no nível da fila. Substitui a definição do nível do cluster apenas para esta fila. |
Deixe em branco (herda a definição do nível do cluster) |