O E-MapReduce (EMR) 3.27.0 e versões posteriores permitem usar o Raft-RocksDB-Tablestore como backend de armazenamento para o Namespace Service do JindoFS. Três nós mestres formam uma instância Raft, e cada nó par armazena metadados em um RocksDB local.
Pré-requisitos
-
Crie uma instância do Tablestore. Recomenda-se uma instância de alto desempenho. Para mais informações, consulte Activate Tablestore and create an instance.
NotaAtive o recurso de transação.
Crie um cluster do E-MapReduce com três nós mestres. Para mais informações, consulte Create a cluster. Ao criar o cluster, ative High Availability e selecione 3 Master no Deployment Mode.
Informações básicas
O RocksDB usa o protocolo Raft para replicar dados entre três nós mestres. Você pode vincular um cluster a uma instância do Tablestore como backend de armazenamento adicional para sincronizar os metadados locais de forma assíncrona com essa instância.
A figura a seguir mostra a arquitetura de alta disponibilidade do Namespace Service com Raft, RocksDB e Tablestore.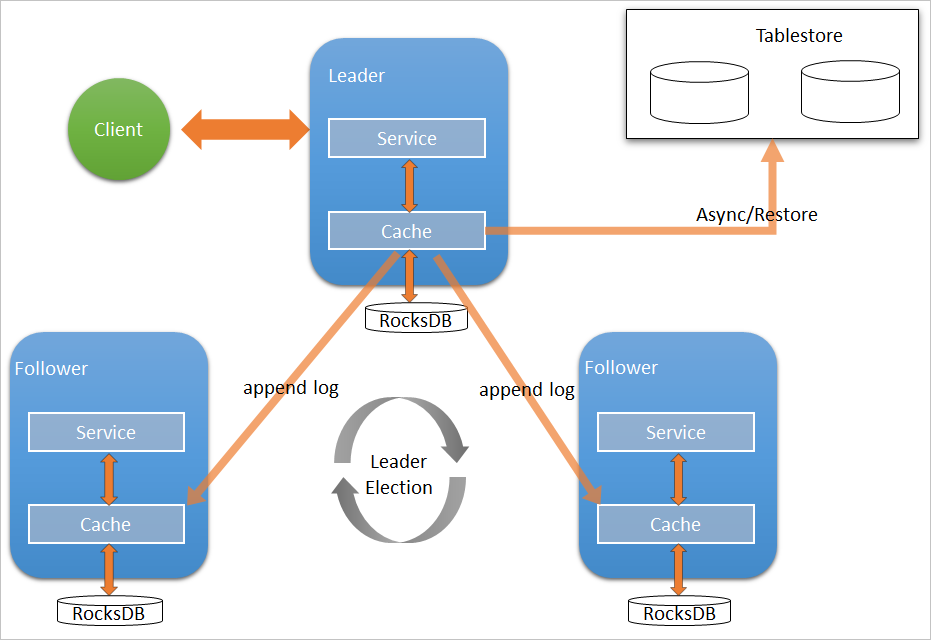
Configure o backend Raft local
-
Após criar o cluster EMR, pare todos os serviços do SmartData.
Faça login no console do Alibaba Cloud EMR.
Na barra de navegação superior, selecione uma região e um grupo de recursos conforme necessário.
Clique em na aba Clusters.
Na página Clusters, localize o cluster desejado e clique em Details na coluna Actions.
No painel de navegação à esquerda, escolha Services > SmartData.
No canto superior direito, escolha .
-
Adicione namespaces conforme necessário.
-
Acesse a aba bigboot do service SmartData.
No painel de navegação à esquerda, escolha Services > SmartData.
Clique em na aba Configure.
Na seção Service Configuration, clique em na aba bigboot.
-
Na aba bigboot do service SmartData, defina os seguintes parâmetros.
Parâmetro
Descrição
Exemplo
namespace.backend.type
Backend de armazenamento para o Namespace Service. Valores válidos:
-
rocksdb -
ots -
raft
O valor padrão é
rocksdb.raftnamespace.backend.raft.initial-conf
Endereços dos três nós mestres na instância Raft. Este valor é fixo.
emr-header-1:8103:0,emr-header-2:8103:0,emr-header-3:8103:0jfs.namespace.server.rpc-address
Endereços de acesso do cliente para os três nós mestres Raft. Este valor é fixo.
emr-header-1:8101,emr-header-2:8101,emr-header-3:8101 -
-
Opcional: Configure o Tablestore para armazenamento assíncrono remoto.
Na aba bigboot do service SmartData, defina os seguintes parâmetros.
Parâmetro
Descrição
Exemplo
namespace.ots.instance
Nome da instância do Tablestore.
emr-jfsnamespace.ots.accessKey
AccessKey ID da instância do Tablestore.
YourAccessKeyID
namespace.ots.accessSecret
AccessKey secret da instância do Tablestore.
YourAccessKeySecret
namespace.ots.endpoint
Endpoint da instância do Tablestore. Recomenda-se o uso de um endpoint VPC para clusters EMR.
http://emr-jfs.cn-hangzhou.vpc.tablestore.aliyuncs.comnamespace.backend.raft.async.ots.enabled
Indica se o upload assíncrono de dados para o Tablestore deve ser ativado. Valores válidos:
-
true -
false
Se você definir este parâmetro como
true, ative esse recurso antes da inicialização do service SmartData.NotaNão é possível ativar esse recurso após a inicialização do service, pois os dados no Tablestore ficariam desatualizados em relação aos dados no RocksDB local.
true -
-
Salve a configuração.
No canto superior direito, clique em Save.
Na caixa de diálogo Confirm, insira um motivo para a alteração e ative Auto-update Configuration.
Clique em OK.
No canto superior direito, escolha .
Restaurar metadados do Tablestore
Se você ativou o armazenamento assíncrono remoto com o Tablestore no cluster original, a instância do Tablestore contém uma cópia completa dos metadados do JindoFS. Após parar ou liberar o cluster original, restaure os metadados em um novo cluster para retomar o acesso aos arquivos.
-
Opcional: Execute os trabalhos preparatórios.
-
Opcional: Colete estatísticas de metadados (contagens de arquivos e pastas) do cluster original.
[hadoop@emr-header-1 ~]$ hadoop fs -count jfs://test/ 1596 1482809 25 jfs://test/ (Number of folders) (Number of files) -
Pare todos os jobs no cluster original e aguarde de 30 a 120 segundos para que os metadados sejam totalmente sincronizados com o Tablestore. Execute o comando a seguir para verifique o status. Se o nó LEADER exibir
_synced=1, os dados no Tablestore estarão totalmente sincronizados.jindo jfs -metaStatus -detailVisualize abaixo um exemplo de saída.
state: LEADERindica que o nó Raft atual é o líder. O índice de log foi atualizado para 624625 e todas as réplicas estão sincronizadas.[RaftPeerImpl] peer_id: xxx state: LEADER readonly: 0 term: 2 conf_index: 1 peers: xxx changing_conf: NO stage: STAGE_NONE election_timer: timeout(5000ms) STOPPED vote_timer: timeout(5000ms) STOPPED stepdown_timer: timeout(5000ms) SCHEDULING(in 2335ms) snapshot_timer: timeout(3600000ms) SCHEDULING(in 150305ms) storage: [1, 624625] disk_index: 624625 known_applied_index: 624625 last_log_id: (index=624625,term=2) first_index_pinned: 624625 state_machine: Idle last_committed_index: 624625 last_snapshot_index: 0 last_snapshot_term: 0 snapshot_status: IDLE replicator_25769803789@xxx next_index=624626 flying_append_entries_size=0 idle hc=2301 ac=624261 ic=0 replicator_32985348833259@xxx next_index=624626 flying_append_entries_size=0 idle hc=2301 ac=623564 ic=0 OtsUploader: _lastStopIndex=624624, _synced=1 Pare ou libere o cluster original para garantir que nenhum outro cluster esteja acessando a instância do Tablestore.
-
-
Crie um novo cluster.
Crie um novo cluster EMR na mesma região da instância do Tablestore e, em seguida, pare todos os serviços do SmartData. Para mais informações, consulte a Etapa 1 em Configure o backend Raft local.
-
Inicialize a configuração.
Na aba bigboot do service SmartData, defina os seguintes parâmetros.
Parâmetro
Descrição
Exemplo
namespace.backend.raft.async.ots.enabled
Indica se o upload assíncrono de dados para o Tablestore deve ser ativado. Valores válidos:
-
true -
false
falsenamespace.backend.raft.recovery.mode
Indica se a recuperação de metadados do Tablestore deve ser ativada. Valores válidos:
-
true -
false
true -
-
Salve a configuração.
No canto superior direito, clique em Save.
Na caixa de diálogo Confirm, insira um motivo para a alteração e ative Auto-update Configuration.
Clique em OK.
No canto superior direito, escolha .
-
Após o início do service SmartData no novo cluster, os metadados são restaurados automaticamente do Tablestore para o Raft-RocksDB local. Execute o comando a seguir para monitorar o progresso da recuperação.
jindo jfs -metaStatus -detailApós executar o comando, confirme se o
statena saída é LEADER e se ostatena seção[Recovery From OTS Status]é FINISH. Isso indica que a recuperação foi concluída. Visualize abaixo um exemplo de saída:[RaftPeerImpl] peer_id: xxx:8103:0 state: LEADER readonly: 0 term: 2 conf_index: 1 peers: xxx changing_conf: NO stage: STAGE_NONE election_timer: timeout(5000ms) STOPPED vote_timer: timeout(5000ms) STOPPED stepdown_timer: timeout(5000ms) SCHEDULING(in 3382ms) snapshot_timer: timeout(600000ms) SCHEDULING(in 474855ms) storage: [1, 153] disk_index: 153 known_applied_index: 153 last_log_id: (index=153,term=2) first_index_pinned: 1 state_machine: Idle last_committed_index: 153 last_snapshot_index: 1 last_snapshot_term: 2 snapshot_status: IDLE replicator_1116691496965@xxx: next_index=154 flying_append_entries_size=0 idle hc=262 ac=154 ic=0 replicator_3311419785217@xxx: next_index=154 flying_append_entries_size=0 idle hc=262 ac=154 ic=0 [Recovery From OTS Status] state: FINISH [Recovery From OTS Status] state: FINISH total rows: 1484409 table `jfs_block_test` 2 rows. table `jfs_namespace_cache_ns` 1 rows. table `jfs_namespace_test` 1484406 rows. -
Opcional: Verifique se o número de arquivos no novo cluster corresponde ao do cluster original.
Neste momento, o cluster está em modo de recuperação somente leitura.
# Compare the file count to verify that it is consistent with that of the original cluster. [hadoop@emr-header-1 ~]$ hadoop fs -count jfs://test/ 1596 1482809 25 jfs://test/ # Files can be read normally by using the cat or get command. [hadoop@emr-header-1 ~]$ hadoop fs -cat jfs://test/testfile this is a test file # View the directory contents. [hadoop@emr-header-1 ~]$ hadoop fs -ls jfs://test/ Found 3 items drwxrwxr-x - root root 0 2020-03-25 14:54 jfs://test/emr-header-1.cluster-50087 -rw-r----- 1 hadoop hadoop 5 2020-03-25 14:50 jfs://test/haha-12096RANDOM.txt -rw-r----- 1 hadoop hadoop 20 2020-03-25 15:07 jfs://test/testfile # Files cannot be modified because the cluster is in read-only mode. [hadoop@emr-header-1 ~]$ hadoop fs -rm jfs://test/testfile java.io.IOException: ErrorCode : 25021 , ErrorMsg: Namespace is under recovery mode, and is read-only. -
Atualize a configuração para alternar o cluster para o modo normal e ativar o upload assíncrono de dados para o Tablestore.
Na aba bigboot do service SmartData, defina os seguintes parâmetros.
Parâmetro
Descrição
Exemplo
namespace.backend.raft.async.ots.enabled
Indica se o upload assíncrono de dados para o Tablestore deve ser ativado. Valores válidos:
-
true -
false
truenamespace.backend.raft.recovery.mode
Indica se a recuperação de metadados do Tablestore deve ser ativada. Valores válidos:
-
true -
false
false -
-
Reinicie o cluster.
Clique em na aba Clusters.
Na página Clusters, localize o cluster desejado e escolha na coluna Actions.