Armazene dados do HBase no OSS-HDFS em clusters DataServing para separar computação e armazenamento. Os dados de Write-Ahead Logging (WAL) permanecem no HDFS.
Contexto
O OSS-HDFS é um serviço de armazenamento de data lake nativo da nuvem com gerenciamento unificado de metadados, compatibilidade total com a API HDFS e suporte abrangente a POSIX. Esse serviço é ideal para cenários de computação de big data e IA em arquiteturas de data lake. Para mais informações, consulte O que é o OSS-HDFS?.
A figura a seguir ilustra a arquitetura do HBase no OSS-HDFS.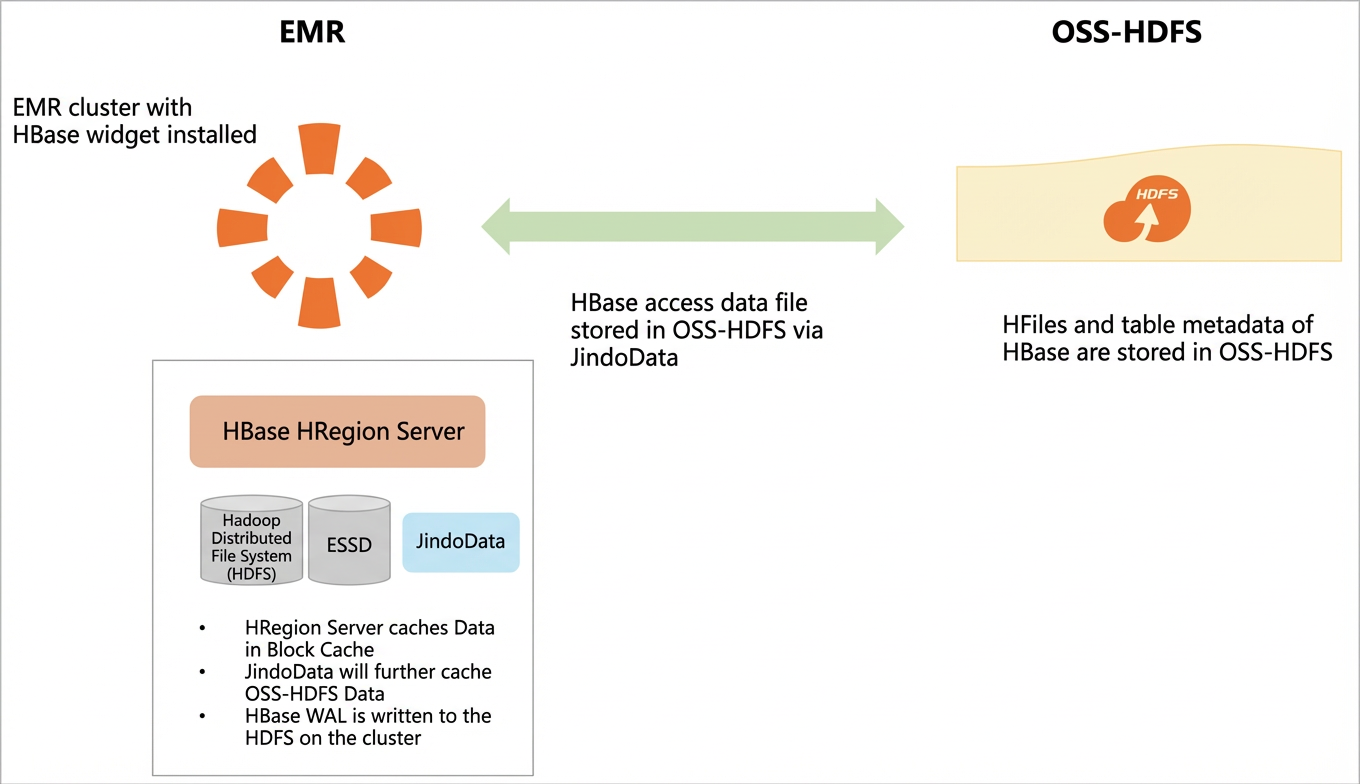
Limitações
Compatível apenas com clusters DataServing executando E-MapReduce 3.42 ou posterior, ou E-MapReduce 5.8.0 ou posterior.
Procedimento
Ative o OSS-HDFS e conceda as permissões de acesso necessárias. Para obter instruções detalhadas, consulte Ativar o OSS-HDFS e conceder permissões de acesso.
-
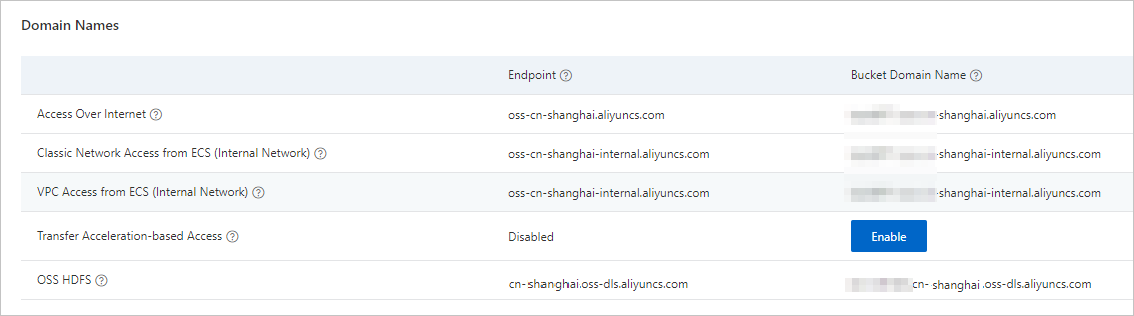
Obtenha o endpoint do serviço OSS-HDFS.
No console do OSS, acesse a página Overview e copie o endpoint do serviço OSS-HDFS. Use esse endpoint como caminho do parâmetro hbase.rootdir ao criar o cluster HBase do E-MapReduce.
-
Use o OSS-HDFS.
-
Crie um cluster DataServing. Para mais informações, consulte Criar um cluster.
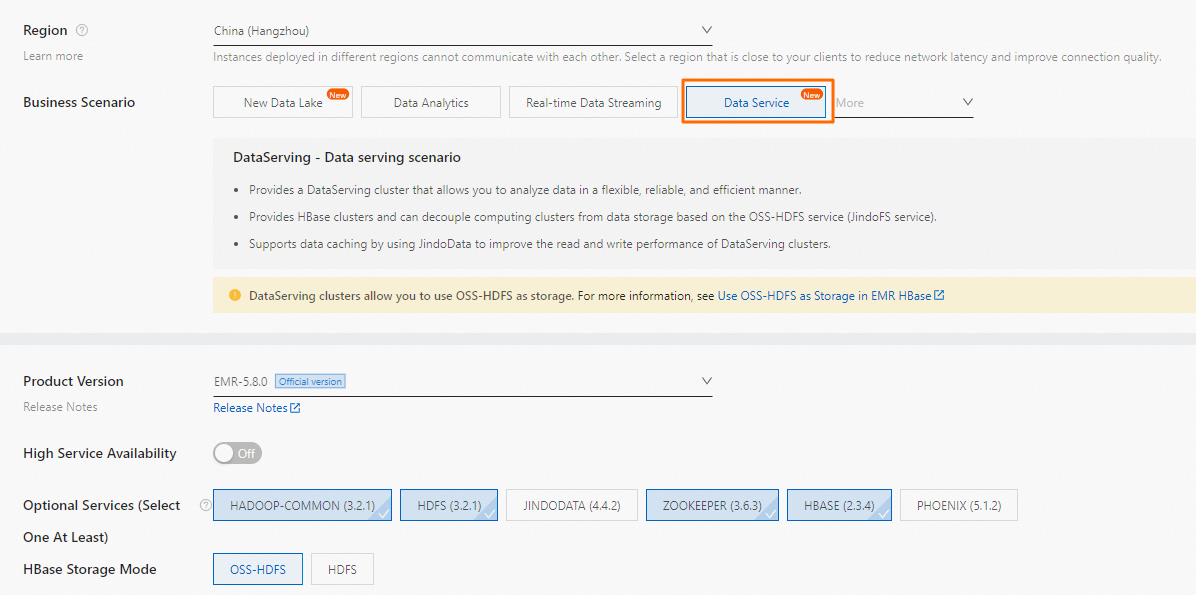 Ao criar o cluster DataServing, configure os seguintes parâmetros:
Optional Services: Selecione todos os serviços, exceto JindoData e Phoenix.
HBase Storage Mode: Selecione OSS-HDFS.
Root Directory: Especifique um bucket do OSS com o serviço HDFS ativado. Use o formato oss://${OSS-HDFS_ENDPOINT}/${DIR}. Por exemplo, oss://test_bucket.cn-hangzhou.oss-dls.aliyuncs.com/hbase.
NotaSubstitua os seguintes espaços reservados:
${OSS-HDFS_ENDPOINT}: O endpoint do OSS-HDFS obtido na Etapa 2.
${DIR}: O diretório raiz do HBase.
-
Crie uma tabela do HBase.
Faça login no cluster DataServing. Para mais informações, consulte Fazer login em um cluster.
-
Execute o comando a seguir para iniciar o HBase Shell:
hbase shell -
Execute o comando a seguir para criar uma tabela de teste chamada
barcom uma família de colunas chamadaf:create 'bar','f'Após criar a tabela, execute o comando
listpara visualizar suas tabelas.Exemplo de saída:
TABLE
bar
1 row(s)
Took 0.0138 seconds
-
Saia do HBase Shell e execute o comando a seguir para verificar se os dados da tabela estão armazenados no OSS-HDFS.
Sintaxe:
hadoop fs -ls oss://${OSS-HDFS_ENDPOINT}/${DIR}Exemplo:
hadoop fs -ls oss://test_bucket.cn-hangzhou.oss-dls.aliyuncs.com/hbase/data/defaultUma saída semelhante confirma a criação do diretório da tabela do HBase no OSS-HDFS:
Found 1 items
drwxrwxrwx   - hbase supergroup          0 2022-07-28 14:45 oss://test_bucket.cn-hangzhou.oss-dls.aliyuncs.com/hbase/data/default/bar
-
-
Opcional: Encerre e restaure um cluster.
Como o OSS-HDFS separa computação e armazenamento, encerre o cluster original e crie um novo que leia os mesmos dados do mesmo diretório do OSS-HDFS.
ImportanteO novo cluster e o cluster original devem usar a mesma versão do HBase. Uma incompatibilidade de versões pode causar problemas imprevisíveis de compatibilidade e tornar o novo cluster inutilizável.

Gravações simultâneas de vários clusters podem causar inconsistências de metadados ou dados, corromper seus dados e indisponibilizar os clusters.
Faça login no cluster DataServing. Para mais informações, consulte Fazer login em um cluster.
-
Inicie o HBase Shell.
hbase shell -
Execute o comando
flushpara gravar todos os dados em memória das suas tabelas no HFile.flush 'bar' -
Execute o comando
disablenas suas tabelas para impedir novas gravações de dados.disable 'bar' -
Crie um novo cluster. Certifique-se de que ele tenha a mesma versão do HBase do cluster original e configure-o para usar o mesmo diretório do OSS-HDFS como backend de armazenamento.
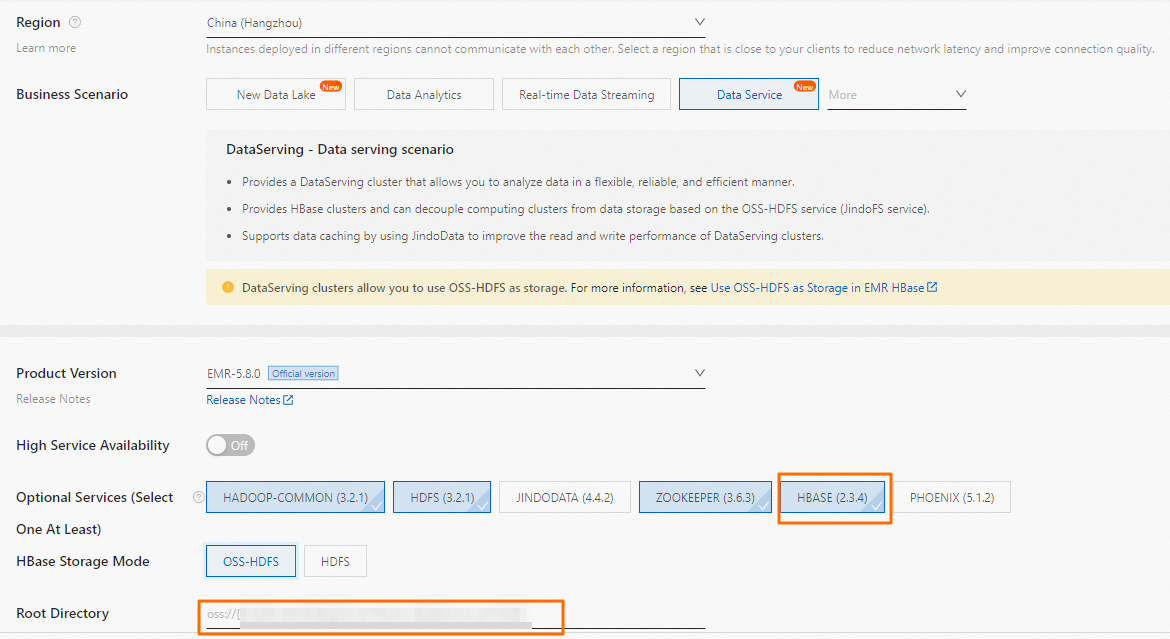
O novo cluster restaura automaticamente os dados do OSS-HDFS e fica pronto para uso.