O Presto (também conhecido como PrestoDB) é um mecanismo de consulta SQL distribuído desenvolvido para análises interativas em grande escala. A Alibaba Cloud não oferece um product Presto independente, e não é possível adquiri-lo separadamente. O Presto está disponível como componente da plataforma de big data open source E-MapReduce (EMR), onde você implanta e utiliza o service Presto em um cluster EMR. Este tópico aborda os principais recursos, a arquitetura, o modelo de dados e os benefícios do Presto no EMR.
Observações importantes
As versões 3.45.0 e 5.11.0 ou posteriores do E-MapReduce (EMR) suportam o Presto, que geralmente possui número de versão 0.2XX. Nas versões anteriores do EMR, o componente Presto com número de versão 3XX utilizava o kernel PrestoSQL ou Trino. Para mais informações, consulte Trino.
Principais recursos
Escrito em Java, o Presto foi projetado para alto desempenho e escalabilidade horizontal. Ele oferece:
Suporte completo ao ANSI SQL.
Conectividade com diversas fontes de dados, incluindo Hive, Hudi, Iceberg, Delta Lake, MySQL e PostgreSQL.
-
Compatibilidade com tipos avançados de dados:
Arrays e mapas
Dados JSON
Dados de Sistema de Informações Geográficas (GIS)
Dados de cores
-
Extensibilidade por meio de múltiplos mecanismos:
Conectores de dados plugáveis
Tipos de dados personalizados
Funções SQL personalizadas
Processamento em pipeline: retorna resultados de consulta aos clientes de forma incremental durante o processamento dos dados, o que reduz o tempo para obter o primeiro resultado.
-
Observabilidade integrada:
Uma interface web para visualizar a execução de consultas em tempo real.
Suporte ao protocolo JMX para coleta de métricas.
Arquitetura
A figura a seguir ilustra a arquitetura do sistema Presto.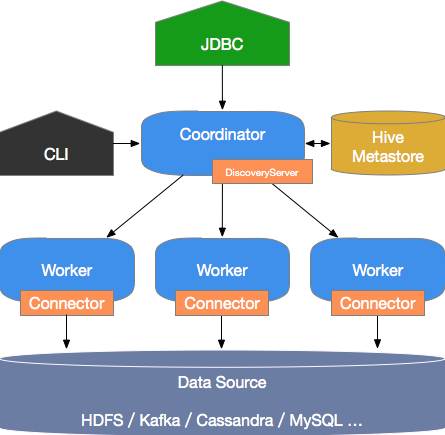
O Presto adota uma arquitetura coordenador/trabalhador. Um nó coordenador gerencia o planejamento de consultas e o status do cluster; vários nós trabalhadores executam as consultas de forma distribuída.
O coordenador é responsável por:
Receber e analisar consultas, gerar planos de execução e distribuir fragmentos do plano para os nós trabalhadores.
Monitorar a integridade dos nós trabalhadores. Cada trabalhador mantém uma conexão de heartbeat com o coordenador para reportar seu status.
Manter os metadados do metastore.
Os nós trabalhadores executam tarefas de consulta distribuídas. Eles utilizam conectores para ler e processar dados de sistemas de armazenamento externos e, em seguida, retornam os resultados ao coordenador.
Atualmente, o Presto não suporta arquitetura de alta disponibilidade (HA). Em um cluster EMR, o coordenador é executado no nó master-1-1. Os trabalhadores rodam em todos os nós Core e Task.
Casos de uso
O Presto é otimizado para cargas de trabalho analíticas em grandes conjuntos de dados. É ideal para:
Extração, transformação e carga (ETL)
Consultas ad hoc
Análise em larga escala de dados estruturados ou semiestruturados
Agregação multidimensional de dados e geração de relatórios
O Presto é um mecanismo de data warehouse. Seu suporte a transações é limitado, portanto, não é adequado para cargas de processamento transacional online (OLTP).
Benefícios do Presto no EMR
Em comparação com o Presto open source autogerenciado, o Presto no EMR oferece:
Configuração rápida: crie um cluster Presto com centenas de nós em minutos.
Dimensionamento elástico com configuração mínima.
Integração nativa com a pilha de software do EMR, incluindo Data Lake Formation (DLF), Object Storage Service (OSS) e OSS-HDFS.
Operações totalmente gerenciadas: o EMR cuida do provisionamento do cluster e da operação e manutenção para que você possa focar nas consultas.
Conceitos
Modelo de dados
O Presto organiza os dados em uma hierarquia de três camadas: catálogo, esquema e tabela.
Catálogo: contém um ou mais esquemas e mapeia para uma fonte de dados externa acessível por um conector. Uma única consulta pode abranger múltiplos catálogos.
Esquema: equivale a uma instância de banco de dados; contém uma ou mais tabelas.
Tabela: uma tabela relacional padrão dentro de um esquema.
Conector
Os conectores funcionam como camada de integração entre o Presto e fontes de dados externas. O Presto inclui conectores integrados para sistemas comuns e expõe uma SPI padrão que você pode implementar para conectar fontes de dados personalizadas.
Normalmente, cada catálogo está vinculado a um tipo específico de conector, definido no arquivo de propriedades do catálogo.
Mais informações
Para visualizar a documentação do Presto open source correspondente à sua versão, substitua XXX na URL https://prestodb.io/docs/XXX/ pelo número da versão do seu componente Presto e abra a URL em um navegador.
Por exemplo, se a sua versão do Presto for 0.279, consulte a documentação do Presto 0.279.