O Delta Lake é uma solução de data lake da Databricks que gerencia todo o ciclo de vida dos dados — desde a ingestão, organização e gerenciamento até consultas e exportação. Combinado com ferramentas upstream e downstream de terceiros, o Delta Lake ajuda você a construir um data lake rápido, fácil de usar e seguro.
Informações básicas
Uma solução típica de data lake armazena vários tipos de dados em um mecanismo de armazenamento de big data, como o Alibaba Cloud Object Storage Service (OSS) ou um Hadoop Distributed File System (HDFS) local, e se conecta a um mecanismo de análise, como Spark ou Presto, para processar os dados. No entanto, essa abordagem apresenta os seguintes problemas:
Importações com falha geram dados inconsistentes difíceis de limpar, e a recuperação de jobs falhos é complexa.
A ausência de um processo de extração, transformação e carga (ETL) resulta em supervisão inadequada da qualidade dos dados.
A falta de suporte a transações impede o isolamento entre operações de leitura e escrita, o que impossibilita a execução independente de leituras e gravações em streaming e em lote.
A solução Delta Lake funciona da seguinte forma:
Adiciona uma camada de gerenciamento de dados sobre a camada de armazenamento de big data, semelhante ao gerenciamento de metadados em um banco de dados. Os metadados são armazenados junto com os dados e ficam visíveis para os usuários, conforme mostrado em Data warehouse and data lake.
O Delta Lake introduz atomicidade, consistência, isolamento e durabilidade (ACID) com base no gerenciamento de metadados. Isso resolve problemas de dados inconsistentes causados por importações com falha e a falta de isolamento de leitura/escrita durante a ingestão de dados.
Os metadados armazenam as colunas das tabelas de origem, e o Delta Lake valida os dados durante a importação para garantir a qualidade.
O suporte a transações permite executar operações de leitura e escrita em lote e em streaming de forma isolada.
ACID é um acrônimo para as quatro propriedades essenciais que garantem transações confiáveis em bancos de dados: atomicidade, consistência, isolamento e durabilidade.
Figura 1. Data warehouse e data lake 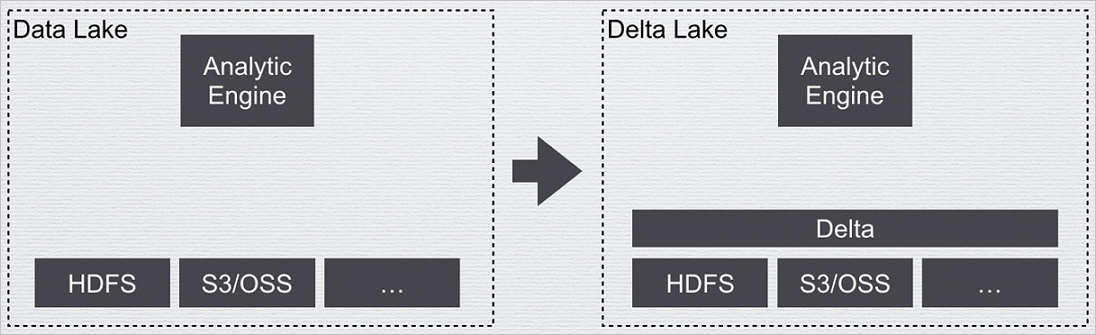
A tabela a seguir compara Data Warehouse, Data Lake e Delta Lake.
|
Critério de comparação |
Data Warehouse |
Data Lake |
Delta Lake |
|
Arquitetura |
Computação e armazenamento acoplados ou desacoplados |
Computação e armazenamento desacoplados |
Computação e armazenamento desacoplados |
|
Gerenciamento de armazenamento |
Rigoroso e proprietário |
Formato nativo |
Formato comum e leve |
|
Cenários |
Relatórios e análises |
Relatórios, análises e ciência de dados |
Relatórios, análises e ciência de dados |
|
Flexibilidade |
Baixa |
Alta |
Alta |
|
Qualidade e confiabilidade dos dados |
Muito alta |
Baixa |
Alta |
|
Suporte transacional |
Compatível |
Não compatível |
Compatível |
|
Desempenho |
Alto |
Baixo |
Alto |
|
Extensibilidade |
Depende da implementação |
Alta |
Alta |
|
Usuários |
Administradores |
Administradores e cientistas de dados |
Administradores e cientistas de dados |
|
Custo |
Alto |
Baixo |
Baixo |
Cenários
O Delta Lake é adequado para gerenciamento de data lake baseado em cloud e oferece suporte aos seguintes cenários:
Consulta em tempo real: os dados fluem de fontes upstream para o Delta Lake em tempo real e ficam imediatamente disponíveis para consulta. Por exemplo, em um cenário de Change Data Capture (CDC), use o Spark Streaming para consumir binlogs em tempo real. O recurso de merge do Delta Lake atualiza os dados upstream no data lake, permitindo consultas posteriores com Hive, Spark ou Presto. Como há suporte a ACID, a ingestão de dados e as consultas são isoladas, evitando leituras inconsistentes.
Exclusão ou atualização para conformidade com o Regulamento Geral sobre a Proteção de Dados (GDPR): soluções tradicionais de data lake não oferecem suporte a exclusões ou atualizações. Para modificar dados nessas soluções, é necessário limpar os dados brutos e reescrevê-los no armazenamento. O Delta Lake permite exclusão e atualização direta dos dados.
Sincronização de dados em tempo real com CDC: utilize o recurso de merge do Delta Lake para executar um job de streaming que integra dados upstream ao data lake em tempo real.
Controle de qualidade de dados: aplique a validação de schema do Delta Lake para filtrar dados anômalos durante a importação ou processá-los posteriormente.
Evolução de schema: os schemas de dados não são fixos. O Delta Lake permite modificar o schema dos dados por meio de uma API.
Machine learning em tempo real: em cenários de machine learning, grande parte do esforço concentra-se no processamento de dados — limpeza, transformação e extração de features. Normalmente, isso exige o tratamento separado de dados históricos e em tempo real. O Delta Lake simplifica esse processo ao unificar todo o pipeline de processamento de dados em um único fluxo confiável em tempo real. Operações como limpeza de dados, transformação e engenharia de features tornam-se ações de streaming, eliminando a necessidade de processar dados históricos e em tempo real separadamente.
Comparação com o Delta Lake open source
O EMR Delta Lake estende o Delta Lake open source com suporte adicional para SQL, Optimize e outros recursos. A tabela a seguir compara os recursos do EMR Delta Lake e do Delta Lake open source (versão 0.6.1).
|
Recurso |
EMR Delta |
Delta open source |
|
SQL |
|
|
|
API |
|
|
|
Conector Hive |
Compatível |
Compatível |
|
Conector Presto |
Compatível |
Compatível |
|
Parquet |
Compatível |
Compatível |
|
ORC |
Não compatível |
Não compatível |
|
Formato de texto |
Não compatível |
Não compatível |
|
Data Skipping |
Compatível |
Não compatível |
|
ZOrder |
Compatível |
Não compatível |
|
DeltaLog nativo |
Compatível |
Não compatível |