O Apache Flume é um sistema distribuído, confiável e de alta disponibilidade (HA) que coleta, agrega e transfere grandes volumes de dados de log de diversas fontes para um repositório central.
Cenários de uso
O Flume é usado principalmente para coleta de logs, mas também transfere outros tipos de dados por meio de uma source personalizada.
O Flume envia dados para plataformas de computação em tempo real, como Flink, Spark Streaming e Storm, e para plataformas de computação offline, como MapReduce (MR), Hive e Presto. Também é possível enviar dados diretamente para sistemas de armazenamento, como Hadoop Distributed File System (HDFS), OSS, Kafka e Elasticsearch, preparando-os para análises subsequentes e limpeza de tráfego.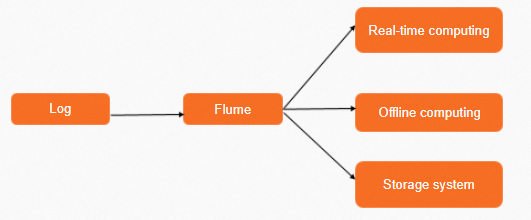
Arquitetura
Um Flume Agent é uma instância do Flume. Trata-se de um processo da Java Virtual Machine (JVM) que controla o fluxo de dados de Events dos produtores aos consumidores. O Flume Agent consiste em uma source, um Channel e um Sink. Uma source pode gravar em vários Channels, e múltiplos Sinks podem ler de um único Channel.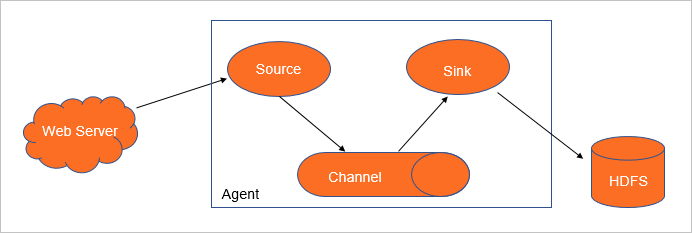
Termos
Nome | Descrição |
Event | O Event é a unidade básica de dados que flui por um Flume Agent. Ele consiste em um mapa Header opcional e um array de bytes com os dados. Veja o exemplo a seguir. |
source | A source atua como coletora de dados. Ela obtém informações de uma fonte externa e as envia em lotes para um ou mais Channels. As sources mais comuns incluem:
|
Channel | Funciona como fila de buffer entre a source e o Sink. Os Channels mais comuns incluem:
|
Sink | O Sink obtém um Event de um Channel e o confirma no armazenamento externo em uma transação. Após a confirmação bem-sucedida da transação, o Event é removido do Channel. Os Sinks mais comuns incluem:
|