O cGPU é uma tecnologia de compartilhamento de GPU baseada em kernel da Alibaba Cloud que permite a múltiplos contêineres isolados compartilhar uma única GPU física. Ao virtualizar recursos de GPU em vGPUs no nível do driver do kernel, o cGPU garante o isolamento de memória e poder de computação por contêiner sem comprometer o desempenho. Isso melhora a utilização do hardware e reduz os custos de infraestrutura de GPU.
Como funciona
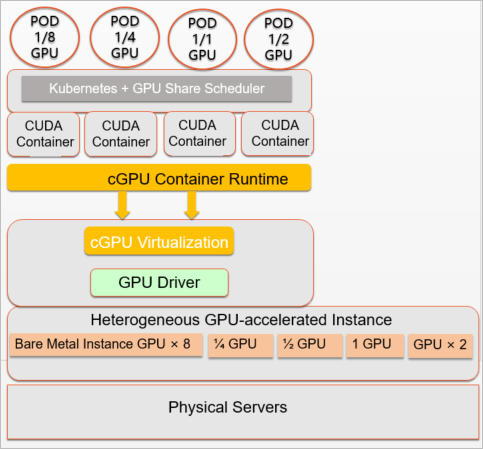
O driver do kernel da Alibaba Cloud cria dispositivos vGPU para cada contêiner em execução na GPU compartilhada. O driver aplica o isolamento nas camadas de memória e computação da GPU, impedindo que os contêineres interfiram nas cargas de trabalho uns dos outros. Assim, é possível executar vários jobs de treinamento ou inferência simultaneamente em uma única GPU.
Capacidades
Isolamento e controle de recursos
Isolamento de memória da GPU: Aloque memória da GPU com granularidade em nível de MB, imposta por contêiner.
Isolamento de poder de computação: Defina a utilização da GPU por contêiner e configure uma proporção mínima de poder de computação de apenas 2%.
Preempção: Tarefas de alta prioridade podem preemptar as de menor prioridade para garantir os objetivos de nível de service.
Compatibilidade
Compatível com Docker, containerd e Kubernetes, sem necessidade de modificar suas aplicações de IA.
Dispensa recompilação de código ou substituição de bibliotecas CUDA (Compute Unified Device Architecture).
Tipos de instância compatíveis
O cGPU é compatível com Bare Metal Instances do Elastic Compute Service (ECS) aceleradas por GPU, instâncias virtualizadas e instâncias aceleradas por vGPU.
Operações
Atualização a quente: Atualize o driver do kernel sem interromper as cargas de trabalho em execução.
Alocação multi-GPU: Atribua múltiplas vGPUs a um único contêiner.
Monitoramento e gerenciamento: Recursos avançados de O&M para rastrear e gerenciar o uso de recursos da GPU.
Casos de uso
Colocação de cargas de trabalho online/offline: Execute serviços online sensíveis à latência e jobs offline em lote na mesma GPU para maximizar a utilização.
Treinamento e inferência de IA: Isole múltiplos jobs de treinamento ou inferência baseados em CUDA em uma única GPU, com limites de recursos garantidos.
Renderização: Compartilhe recursos de GPU entre tarefas de renderização em ambientes multilocatários.