Para cargas de trabalho de text-to-image, o ComfyUI com DeepGPU acelera a inferência de modelos FLUX e SD. Por exemplo, ao configurar o ComfyUI com nós de aceleração DeepGPU em uma instância gpu, o desempenho de text-to-image para modelos FLUX aumenta em aproximadamente 30%. Este tópico descreve como instale e use o ComfyUI com DeepGPU.
Comparação de desempenho
O componente de aceleração de inferência DeepGPU, desenvolvido pela Alibaba Cloud, acelera significativamente a inferência de text-to-image para os modelos FLUX.1, SD e SDXL.
Em comparação com uma configuração sem os nós de aceleração ComfyUI+DeepGPU, a inclusão desses nós em uma instância gpu aumenta significativamente o desempenho. Recomenda-se usar a instância de placa única gn8is instance). Com essa configuração, o desempenho do modelo flux1-dev aumenta em aproximadamente 30% nas precisões bf16 e fp8. A tabela a seguir compara o desempenho de aceleração de text-to-image para modelos selecionados.
|
Precisão do peso do modelo |
Resolução da imagem (L x A) |
Tempo (sem DeepGPU) |
Tempo (com DeepGPU) |
Taxa de aceleração |
|
default(bf16) |
1024 x 1024 |
20,83s |
16,62s |
25,3% |
|
default(bf16) |
1280 x 720 |
19,02s |
15,07s |
26,2% |
|
default(bf16) |
680 x 1024 |
14,21s |
11,21s |
26,8% |
|
default(bf16) |
576 x 768 |
8,81s |
7,27s |
21,2% |
|
fp8_e4m3_fast |
1024 x 1024 |
15,16s |
11,15s |
36,0% |
|
fp8_e4m3_fast |
1280 x 720 |
13,66s |
9,97s |
37,0% |
|
fp8_e4m3_fast |
680 x 1024 |
9,93s |
7,51s |
32,2% |
|
fp8_e4m3_fast |
576 x 768 |
6,07s |
4,88s |
24,4% |
Pré-requisitos
-
crie uma instância gpu que atenda aos seguintes requisitos:
O sistema operacional deve ser o Ubuntu 20.04 ou o Ubuntu 22.04.
-
O driver NVIDIA e o CUDA devem estar instalados e atender aos requisitos de versão.
NotaAo crie uma instância gpu, recomendamos selecione a opção Install GPU Driver após escolher uma imagem e, em seguida, selecione as versões do CUDA, Driver e cuDNN.
A instância deve ter um endereço IP público fixo ou estar associada a um endereço IP elástico (EIP). Para mais informações, consulte ative public network access.
-
Configure as regras do grupo de segurança.
A porta 22 para conexões remotas é aberta por padrão. O servidor do ComfyUI requer uma porta (como a 7860) para sua interface web. Certifique-se de que as regras de entrada para as portas 22 e 7860 estejam configuradas no seu grupo de segurança. Caso contrário, add security group rules manualmente.
instale o componente de aceleração ComfyUI+DeepGPU
O ComfyUI é um projeto de código aberto. instale-o por conta própria e, em seguida, siga este tópico para instale o componente de aceleração DeepGPU. Para obter informações sobre os tipos de nós do DeepGPU e fluxos de trabalho integrados ao ComfyUI, consulte Node and workflow overview.
-
Configure o ComfyUI por conta própria.
NotaO ComfyUI é um projeto de código aberto e deve ser instalado por conta própria. Para obter informações sobre nós relacionados e exemplos de fluxos de trabalho no ComfyUI, consulte Node and workflow overview.
Se você carregar um modelo LoRA nativo no ComfyUI (usando LoraLoaderModelOnly) e acelerá-lo com o deepgpu-torch, modifique uma linha no source do ComfyUI.
-
Em ComfyUI/comfy/sd.py, adicione o parâmetro
weight_inplace_update=Trueà seguinte linha. O código modificado fica assim: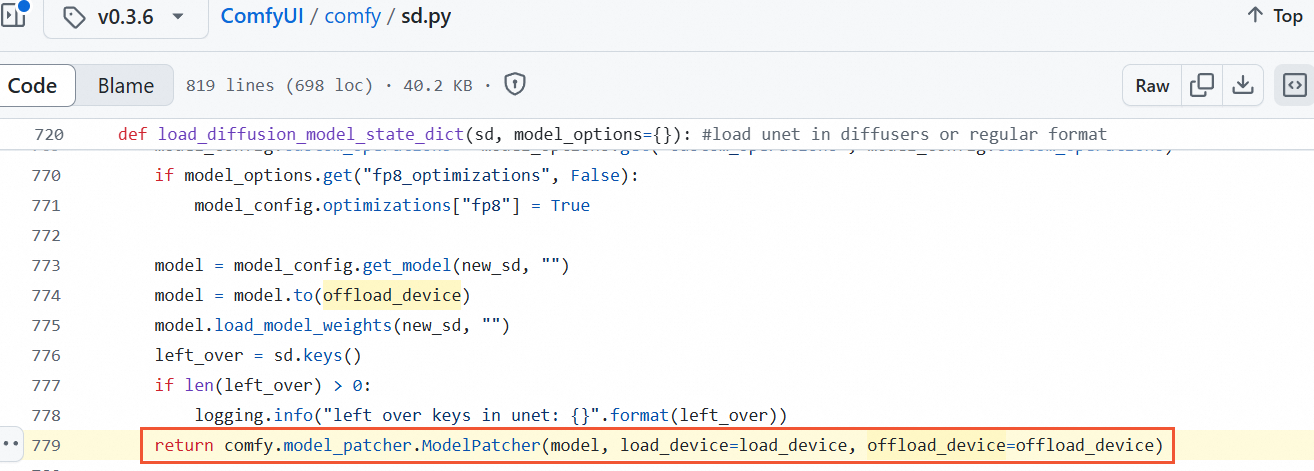
Código modificado:
return comfy.model_patcher.ModelPatcher(model, load_device=load_device, offload_device=offload_device, weight_inplace_update=True) -
Em ComfyUI/comfy/sd.py, adicione o parâmetro
weight_inplace_update=Trueà seguinte linha. O código modificado fica assim: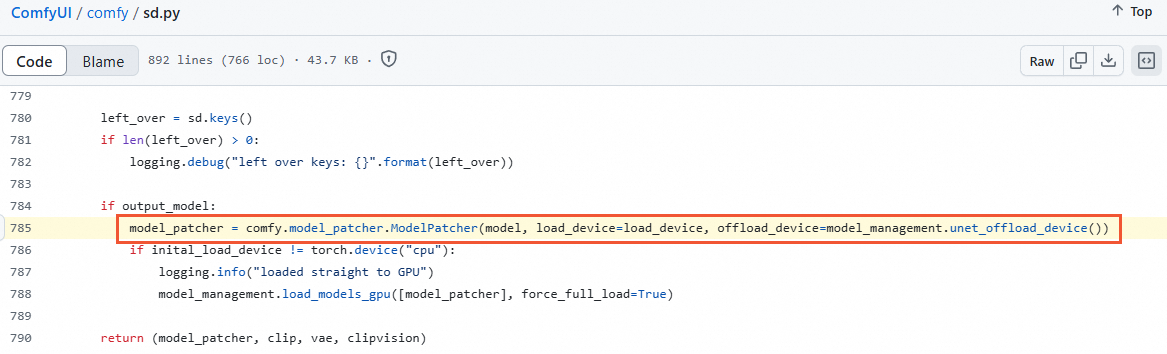
O código modificado fica assim:
model_patcher = comfy.model_patcher.ModelPatcher(model, load_device=load_device, offload_device=model_management.unet_offload_device(), weight_inplace_update=True)
-
-
instale o componente de aceleração DeepGPU.
-
verifique a versão do Python para garantir que atenda aos requisitos de dependência do deepgpu-torch.
O componente de aceleração deepgpu-torch requer um ambiente Python 3.10.
Ubuntu 22.04
execute
python3 -Vpara verifique a versão do Python. O Ubuntu 22.04 traz o Python 3.10.12 instalado por padrão, o que atende ao requisito.
Ubuntu 20.04
execute
python3 -Vpara verifique a versão do Python. O Ubuntu 20.04 traz o Python 3.8.10 instalado por padrão, o que não atende ao requisito.
instale o Miniconda para configurar um ambiente Python 3.10 isolado ou use outro método de sua preferência.
-
execute o comando a seguir para baixe o script de instalação do Miniconda.
wget https://repo.anaconda.com/miniconda/Miniconda3-py310_24.1.2-0-Linux-x86_64.sh -
execute os comandos a seguir para instale o Miniconda e ativar o ambiente.
bash ./Miniconda3-py310_24.1.2-0-Linux-x86_64.sh -b -p /workspace/miniconda source /workspace/miniconda/bin/activate -
execute
python3 -Vnovamente para verifique a versão do Python. Nota
Ao entrar novamente no sistema, execute
source /workspace/miniconda/bin/activatepara alternar para o ambiente virtual Python 3.10.
-
-
execute o comando a seguir para instale o torch.
O componente de aceleração deepgpu-torch requer o torch 2.5.x+cu124 (a versão padrão do CUDA para o torch 2.5.x). Este exemplo instala o torch 2.5.0. Substitua o número da versão para instalar uma versão diferente.
pip install torch==2.5.0execute
python3 -c "import torch; print(torch.__version__)"para confirme que o torch 2.5.0+cu124 está instalado.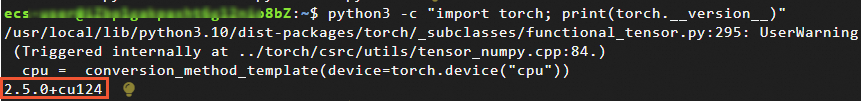
-
execute os comandos a seguir para instale o deepgpu-torch.
apt-get install which curl iputils-ping -y
pip install deepgpu-torch==0.0.15+torch2.5.0cu124 -f https://aiacc-inference-public-v2.oss-cn-hangzhou.aliyuncs.com/deepgpu/deepytorch/index.html
execute
pip list | grep deepgpu-torchpara visualize a versão instalada do deepgpu-torch.
-
execute os comandos a seguir para baixe e instale o plug-in do componente de aceleração DeepGPU para o ComfyUI.
baixe o plug-in e extraia-o no diretório
ComfyUI/custom_nodes/.cd ComfyUI/custom_nodes/ wget https://aiacc-inference-public-v2.oss-cn-hangzhou.aliyuncs.com/deepgpu/comfyui/flux/20250102/ComfyUI-deepgpu.tar.gz tar zxf ComfyUI-deepgpu.tar.gz cd ../.. pip install deepgpu-comfyui==1.0.8 -f https://aiacc-inference-public-v2.oss-cn-hangzhou.aliyuncs.com/deepgpu/comfyui/index.htmlexecute
pip list | grep deepgpu-comfyuipara verifique se o plug-in está instalado.
Use o ComfyUI+DeepGPU para acelerar a inferência de text-to-image
Este exemplo usa uma instância gn7ix com o Ubuntu 22.04 e o componente de aceleração DeepGPU instalado para demonstrar a aceleração de text-to-image para um modelo FLUX com o ComfyUI+DeepGPU.
-
instale o ambiente base (torch, dependências do ComfyUI e o componente de aceleração DeepGPU).
-
execute
python3 -Vpara verifique se a versão do Python é a 3.10.O Ubuntu 22.04 traz o Python 3.10.12 instalado por padrão, o que atende ao requisito de dependência do deepgpu-torch. Se você usar uma instância gpu com o Ubuntu 20.04, configure um ambiente Python 3.10 isolado. Para mais informações, consulte Ubuntu 20.04.
-
execute o comando a seguir para instale o torch.
# This example installs torch 2.5.0. Replace the version number to install a different version.
pip install torch==2.5.0 torchvision==0.20.0 torchaudio==2.5.0
execute
python3 -c "import torch; print(torch.__version__)"para visualize a versão instalada do torch.
-
execute o comando a seguir para instale as dependências do ComfyUI.
pip install PyYAML safetensors numpy Pillow einops psutil transformers scipy torchsde aiohttp comfyui-frontend-package==1.11.8 kornia spandrel av -
execute os comandos a seguir para instale o componente de aceleração DeepGPU.
apt-get install which curl iputils-ping -y
pip install deepgpu-torch==0.0.15+torch2.5.0cu124 -f https://aiacc-inference-public-v2.oss-cn-hangzhou.aliyuncs.com/deepgpu/deepytorch/index.html
pip install deepgpu-comfyui==1.0.8 -f https://aiacc-inference-public-v2.oss-cn-hangzhou.aliyuncs.com/deepgpu/comfyui/index.html
execute
pip list | grep deepgpu-torchoupip list | grep deepgpu-comfyuipara verifique as versões instaladas do componente de aceleração DeepGPU.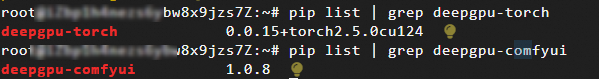
-
execute os comandos a seguir para baixe o source do ComfyUI.
Este exemplo baixe o source oficial do ComfyUI. Você pode usar seu próprio código personalizado do ComfyUI.
Ubuntu 22.04
git clone -b v0.3.26 https://github.com/comfyanonymous/ComfyUI
sed -i "s|comfy.model_patcher.ModelPatcher(model, load_device=load_device, offload_device=model_management.unet_offload_device())|comfy.model_patcher.ModelPatcher(model, load_device=load_device, offload_device=model_management.unet_offload_device(), weight_inplace_update=True)|g" ComfyUI/comfy/sd.py
Ubuntu 20.04
apt install git git clone -b v0.3.26 https://github.com/comfyanonymous/ComfyUI sed -i "s|comfy.model_patcher.ModelPatcher(model, load_device=load_device, offload_device=model_management.unet_offload_device())|comfy.model_patcher.ModelPatcher(model, load_device=load_device, offload_device=model_management.unet_offload_device(), weight_inplace_update=True)|g" ComfyUI/comfy/sd.py -
execute os comandos a seguir para baixe o plug-in do componente de aceleração DeepGPU.
cd ComfyUI/custom_nodes/ wget https://aiacc-inference-public-v2.oss-cn-hangzhou.aliyuncs.com/deepgpu/comfyui/flux/20250102/ComfyUI-deepgpu.tar.gz tar zxf ComfyUI-deepgpu.tar.gz ls cd ../.. -
execute os comandos a seguir para baixe o modelo FLUX.
Este exemplo baixe o modelo FLUX oficial. Você pode usar seus próprios modelos treinados.
cd ComfyUI wget -P models/unet https://aiacc-inference-public-v2.oss-cn-hangzhou.aliyuncs.com/deepgpu/comfyui/flux/models/flux1-dev.safetensors wget -P models/clip https://aiacc-inference-public-v2.oss-cn-hangzhou.aliyuncs.com/deepgpu/comfyui/flux/models/t5xxl_fp16.safetensors wget -P models/clip https://aiacc-inference-public-v2.oss-cn-hangzhou.aliyuncs.com/deepgpu/comfyui/flux/models/clip_l.safetensors wget -P models/vae https://aiacc-inference-public-v2.oss-cn-hangzhou.aliyuncs.com/deepgpu/comfyui/flux/models/ae.safetensorsNotaO download dos modelos pode levar algum tempo. Aguarde a conclusão do download.
-
execute o comando a seguir para iniciar o service do ComfyUI.
python3 main.py --listen 0.0.0.0 --port 7860 -
Em um navegador, acesse
http://IP:7860para acesse o service do ComfyUI.IPé o endereço IP público da sua instância gpu. -
Na interface do ComfyUI, escolha , selecione o arquivo JSON dos example workflows e clique em Queue Prompt.
ImportanteSe você testar primeiro um fluxo de trabalho com aceleração DeepGPU e depois testar um sem ela (ou vice-versa), reinicie o service do ComfyUI sempre que alternar.
-
Sem aceleração DeepGPU: Selecione o arquivo JSON base flux-dev (workflow_flux.JSON). A figura a seguir mostra a execução do fluxo de trabalho.
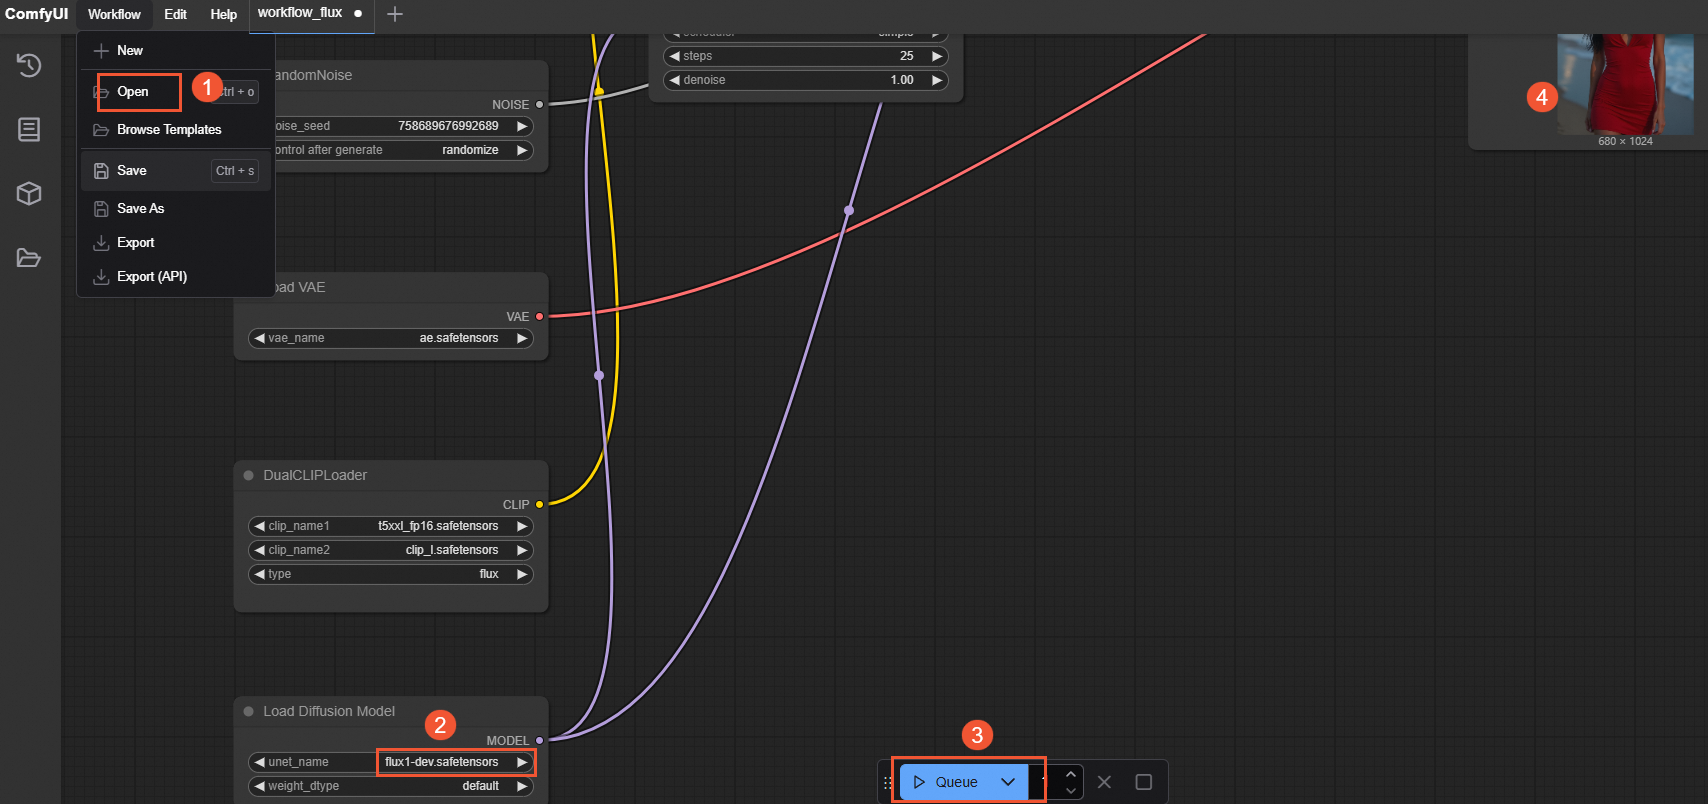
-
Com aceleração DeepGPU: Selecione o arquivo JSON acelerado flux-dev DeepyTorch (workflow_flux_deepytorch.JSON). A figura a seguir mostra a execução do fluxo de trabalho.
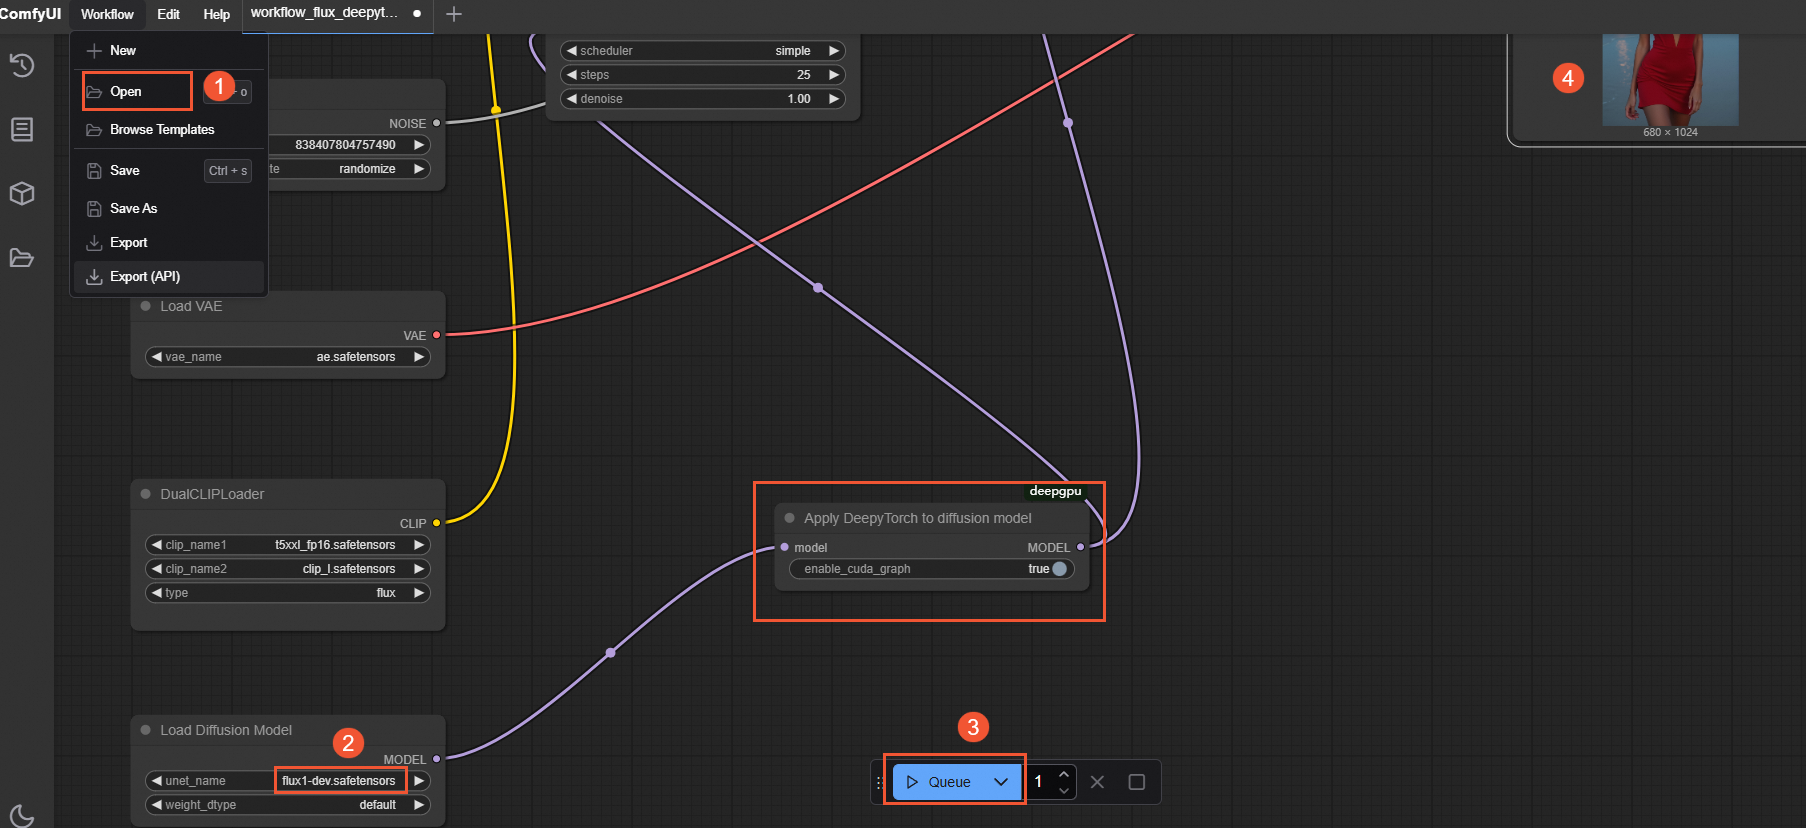
Após a execução, verifique o tempo de execução de text-to-image na página de conexão remota da GPU. Para isso, visualize o tempo após o campo
Prompt executed in(conforme mostrado abaixo). O desempenho é significativamente melhor com os nós de aceleração ComfyUI+DeepGPU. Para comparações detalhadas, consulte Performance comparison.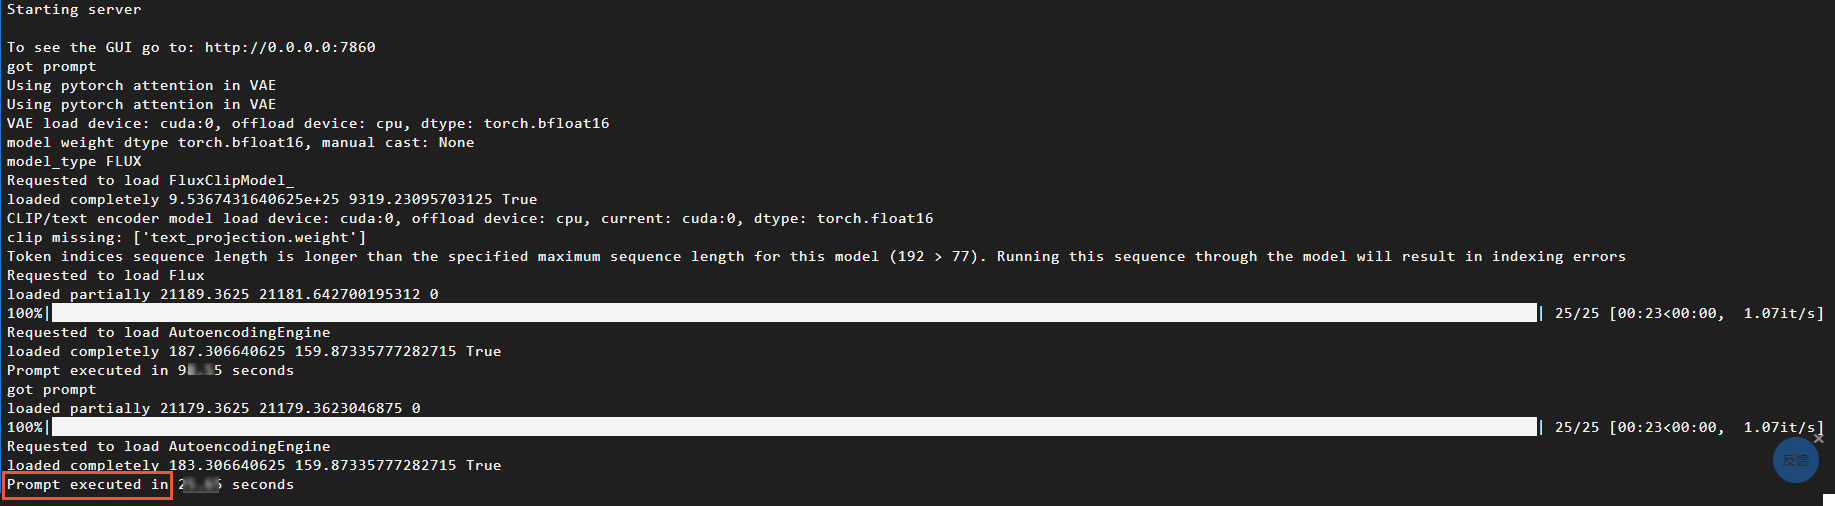
-
Visão geral de nós e fluxos de trabalho
Tipos de nós do DeepGPU
O plug-in do componente de aceleração DeepGPU inclui vários nós específicos. Na interface do ComfyUI, clique com o botão direito em uma área em branco e escolha para visualize os tipos de nós do DeepGPU disponíveis.
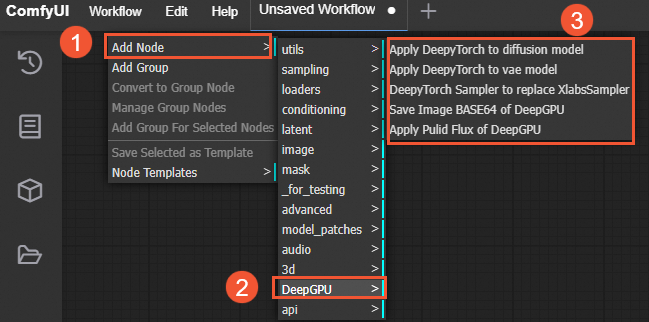
acesse o diretório ComfyUI/custom_nodes/ComfyUI-deepgpu e abra o arquivo __init__.py para ver os tipos de nós correspondentes.
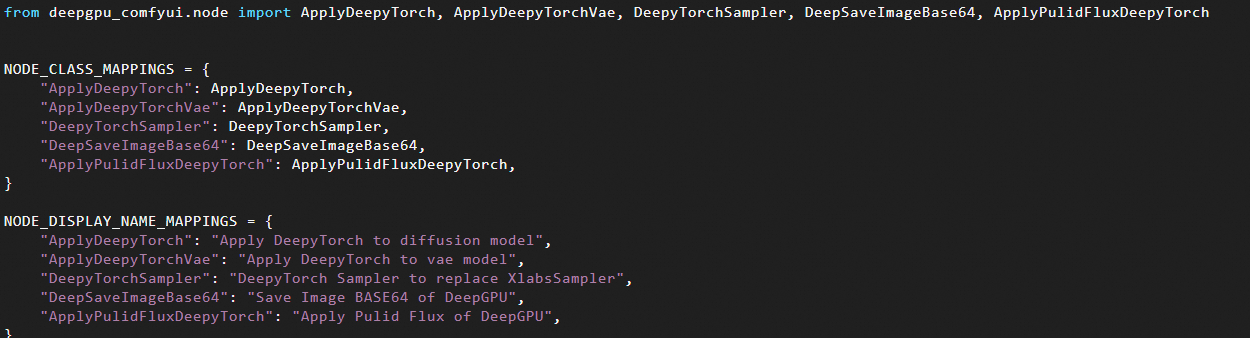
Os principais tipos de nós são:
Nó ApplyDeepyTorch: para modelos FLUX, este nó depende de outros nós. insira-o após um nó Load Diffusion Model, Load Flux LoRA ou Apply Flux IPAdapter. Para outros modelos, insira-o após um nó Load Checkpoint ou LoraLoaderModelOnly.
Nó DeepyTorchSampler: para modelos FLUX, este nó de amostragem supera e substitui o nó XLabsSampler (do x-flux-comfyui). Não é necessário usar o nó ApplyDeepyTorch ao usar este nó.
Nó ApplyPulidFluxDeepyTorch: para modelos FLUX, este nó supera e substitui o nó ApplyPulidFlux (do ComfyUI-PuLID-Flux-Enhanced). Não é necessário usar o nó ApplyDeepyTorch ao usar este nó.
Exemplos de fluxos de trabalho
Os exemplos a seguir mostram como usar vários nós em fluxos de trabalho de modelos FLUX e SD para acelerar a inferência.
FLUX.1 models
-
Para o modelo base
flux-devNa interface do ComfyUI, insira um nó
ApplyDeepyTorchapós o nóLoad Diffusion Model, conforme mostrado na figura a seguir: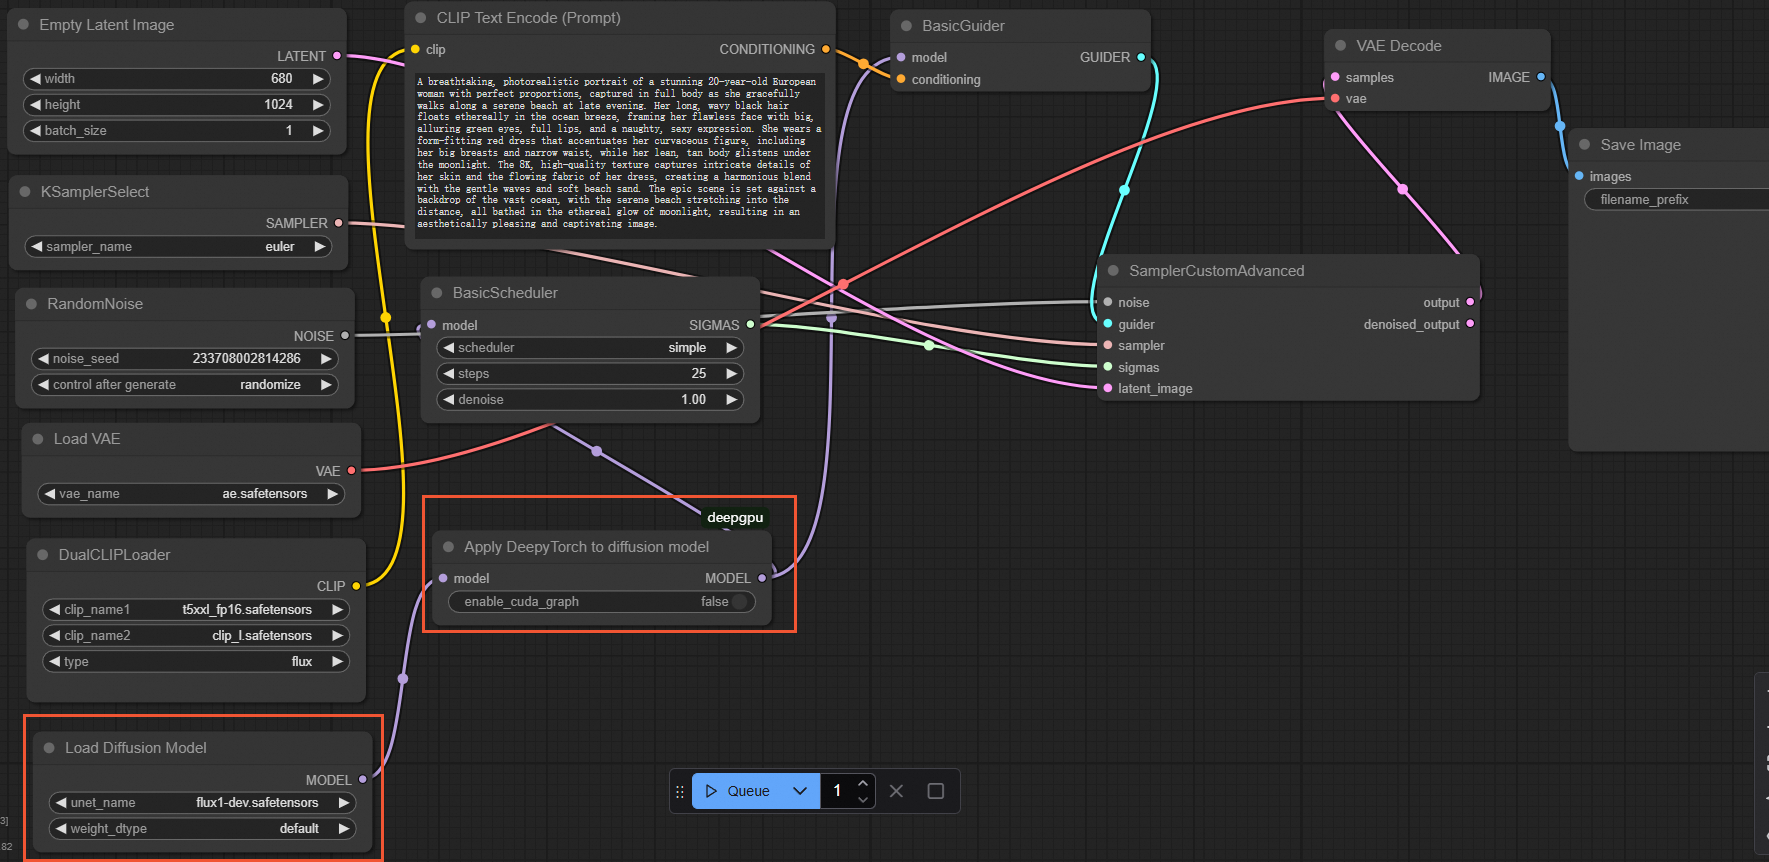
Arquivos de fluxo de trabalho de exemplo:
Versão base flux-dev: workflow_flux.JSON
Versão acelerada flux-dev DeepyTorch: workflow_flux_deepytorch.JSON
-
Para modelos LoRA nativos do ComfyUI
NotaO modelo de código aberto FLUX.1-dev com LoRA suporta tanto a implementação LoRA do XLabs quanto a implementação nativa do ComfyUI.
Na interface do ComfyUI, insira um nó
ApplyDeepyTorchapós o último nóLoraLoaderModelOnly, conforme mostrado na figura a seguir: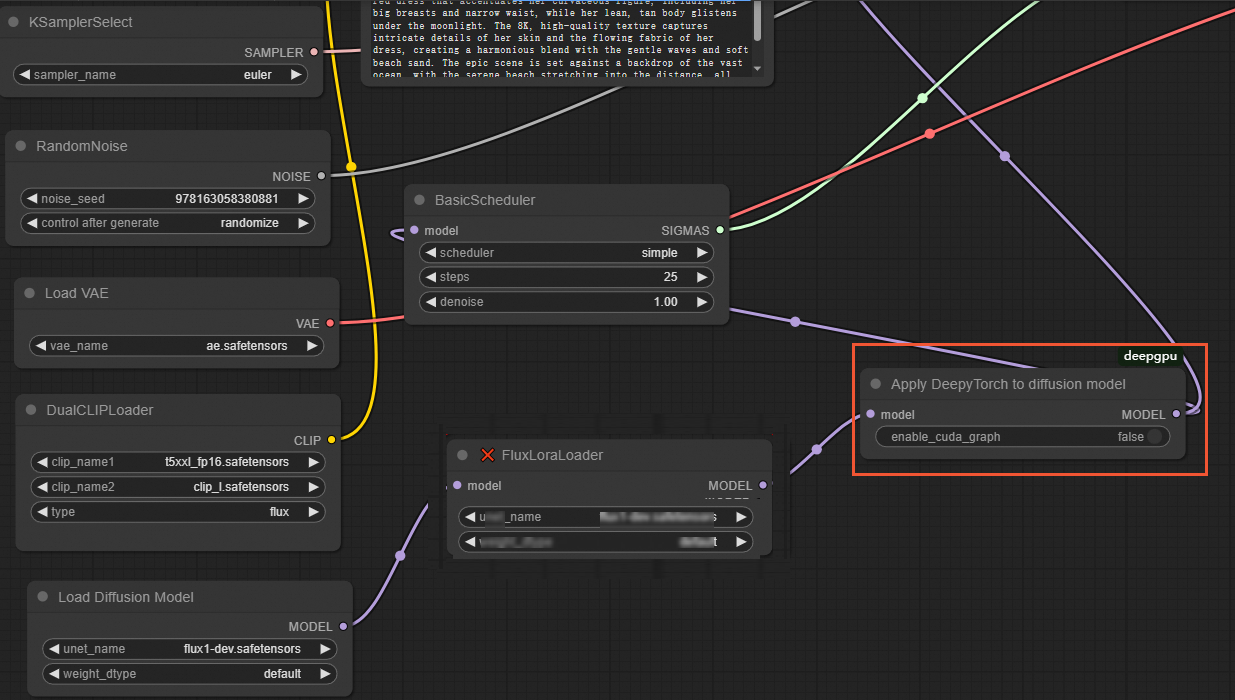
Arquivos de fluxo de trabalho de exemplo:
Versão original flux-dev+lora: workflow_flux_lora_wukong.json
Versão acelerada flux-dev+lora DeepyTorch: workflow_flux_lora_deepytorch_wukong.JSON
-
Para modelos FLUX com o plug-in Pulid
NotaO plug-in Pulid é do ComfyUI-PuLID-Flux-Enhanced.
Na interface do ComfyUI, substitua o nó
Apply Pulid Fluxpelo nóApply Pulid Flux of DeepGPU. Não é necessário usar o nóApplyDeepyTorch. O fluxo de trabalho é mostrado abaixo: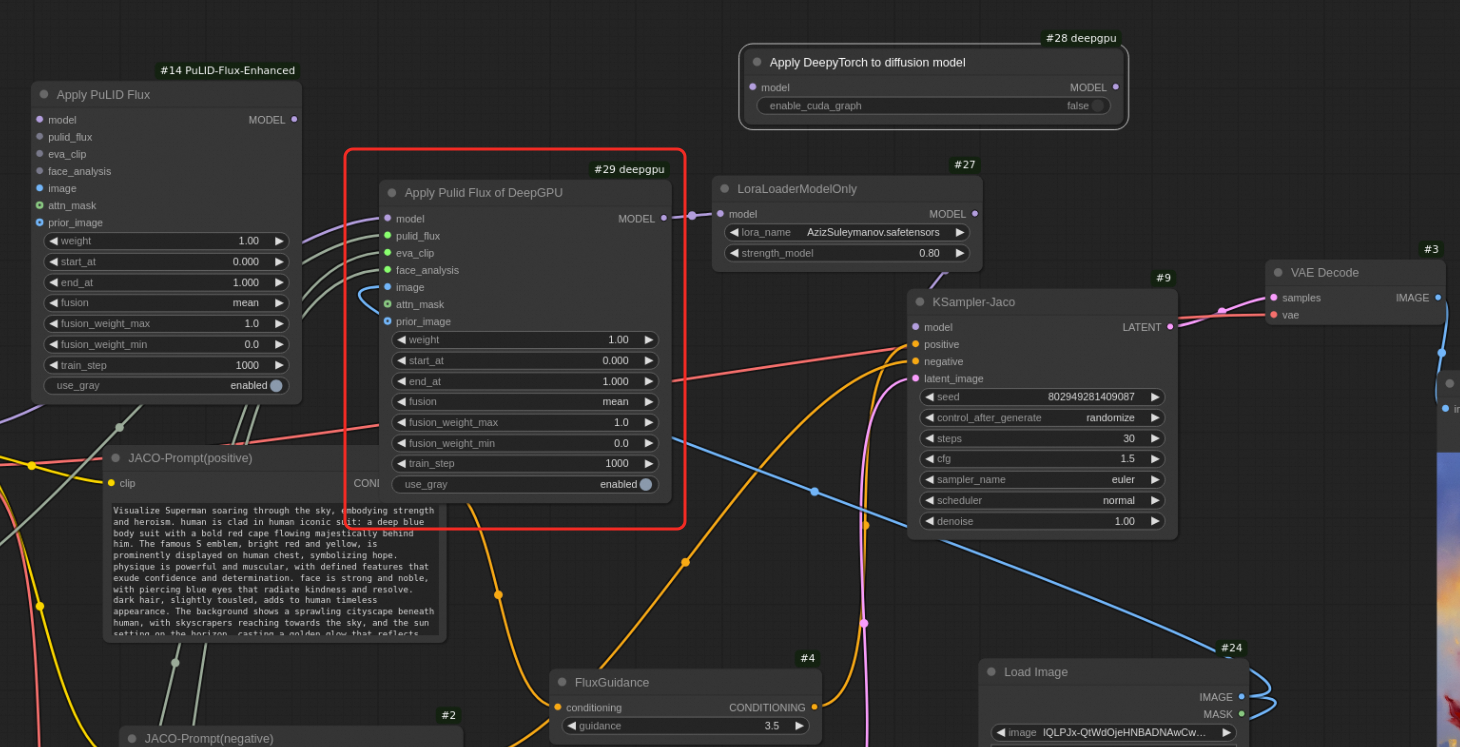
-
Para modelos LoRA FLUX personalizados
Antes de iniciar o service do ComfyUI, defina a seguinte variável de ambiente para execute o fluxo de trabalho na interface do ComfyUI.
export DEEPGPU_ENABLE_FLUX_LORA=trueNa interface do ComfyUI, insira um nó
ApplyDeepyTorchapós o último nóLoad Flux LoRA, conforme mostrado na figura a seguir: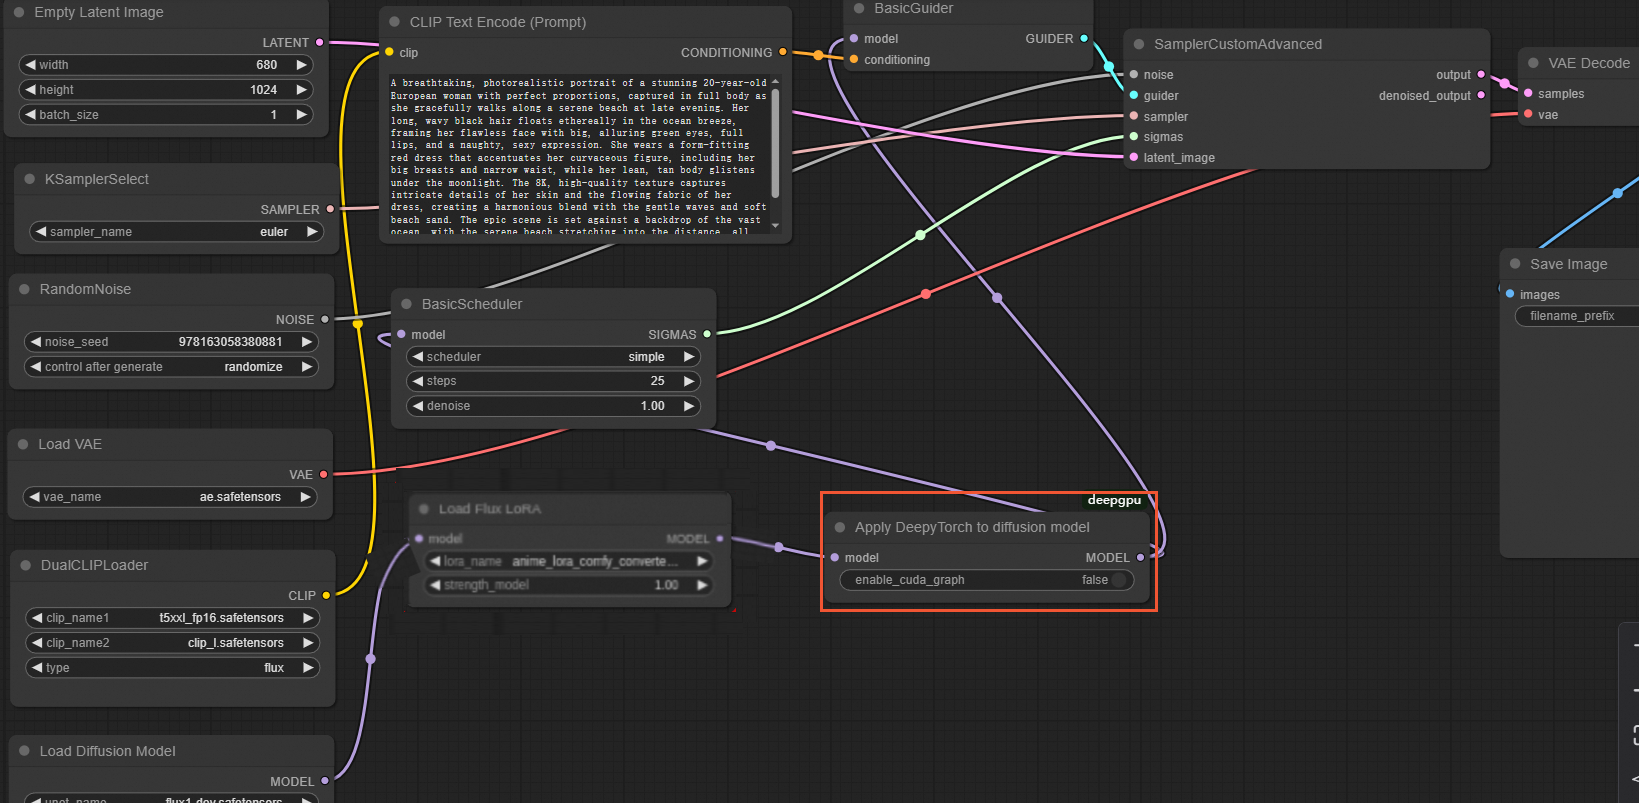
Arquivos de fluxo de trabalho de exemplo:
Versão original flux-dev+lora: workflow_flux_lora.JSON
Versão acelerada flux-dev+lora DeepyTorch: workflow_flux_lora_deepytorch.JSON
-
Para IP-Adapter FLUX personalizado
Antes de iniciar o service do ComfyUI, defina a seguinte variável de ambiente para execute o fluxo de trabalho na interface do ComfyUI.
export DEEPGPU_ENABLE_FLUX_LORA=trueNa interface do ComfyUI, insira um nó
ApplyDeepyTorchapós o nóApply Flux IPAdaptere substitua o nóXLabsSamplerpelo nóDeepyTorch Sampler, conforme mostrado abaixo:NotaA imagem de teste usada como entrada para este cenário é a imagem XLabs-AI.
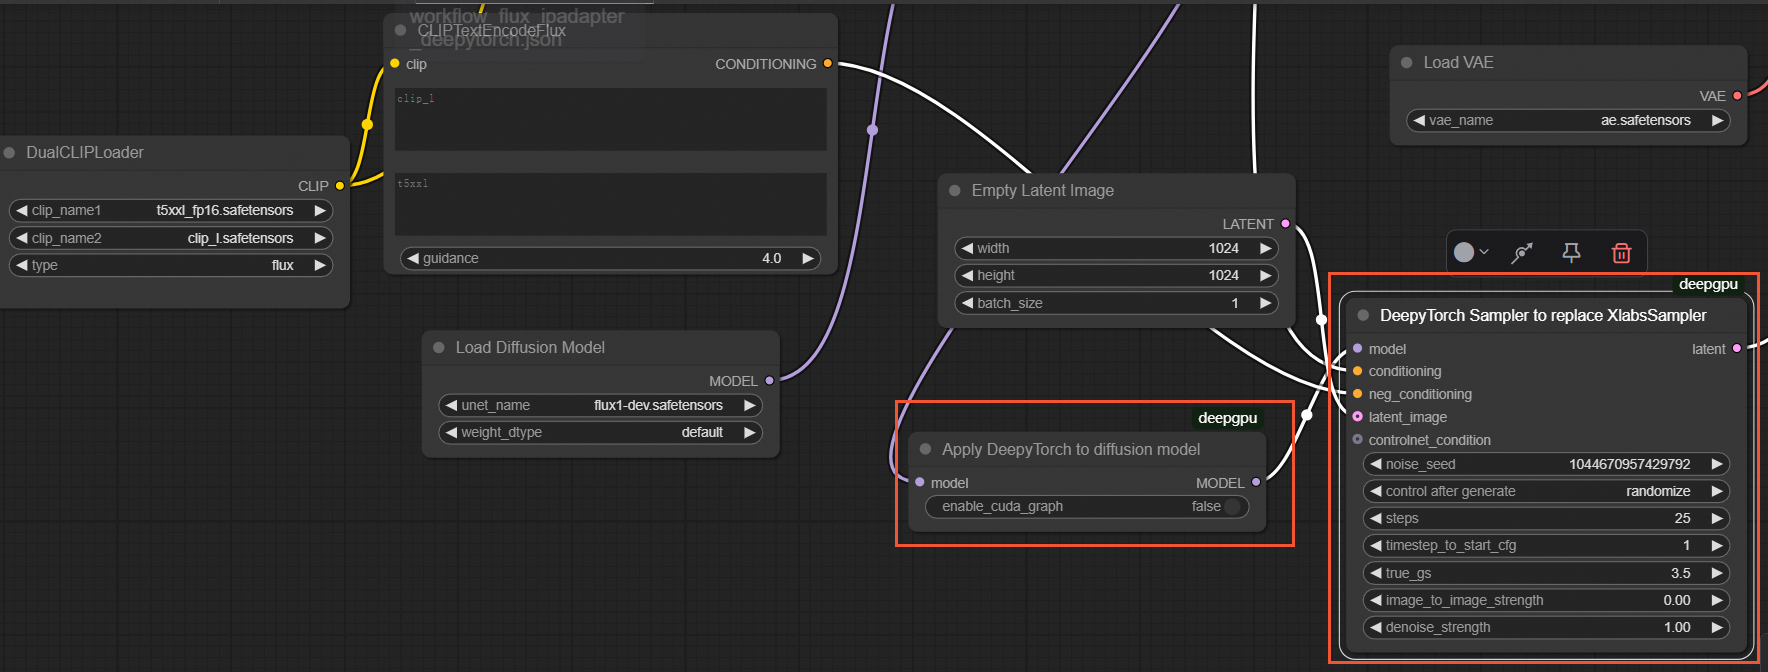
Arquivos de fluxo de trabalho de exemplo:
Versão original flux-dev+ip-adapter: workflow_flux_ipadapter.JSON
Versão acelerada flux-dev+ip-adapter DeepyTorch: workflow_flux_ipadapter_deepytorch.JSON
-
Para ControlNet FLUX personalizado
Na interface do ComfyUI, substitua o nó
XLabsSamplerpelo nóDeepyTorch Sampler, conforme mostrado abaixo:NotaA imagem de teste usada como entrada para este cenário é a imagem XLabs-AI.
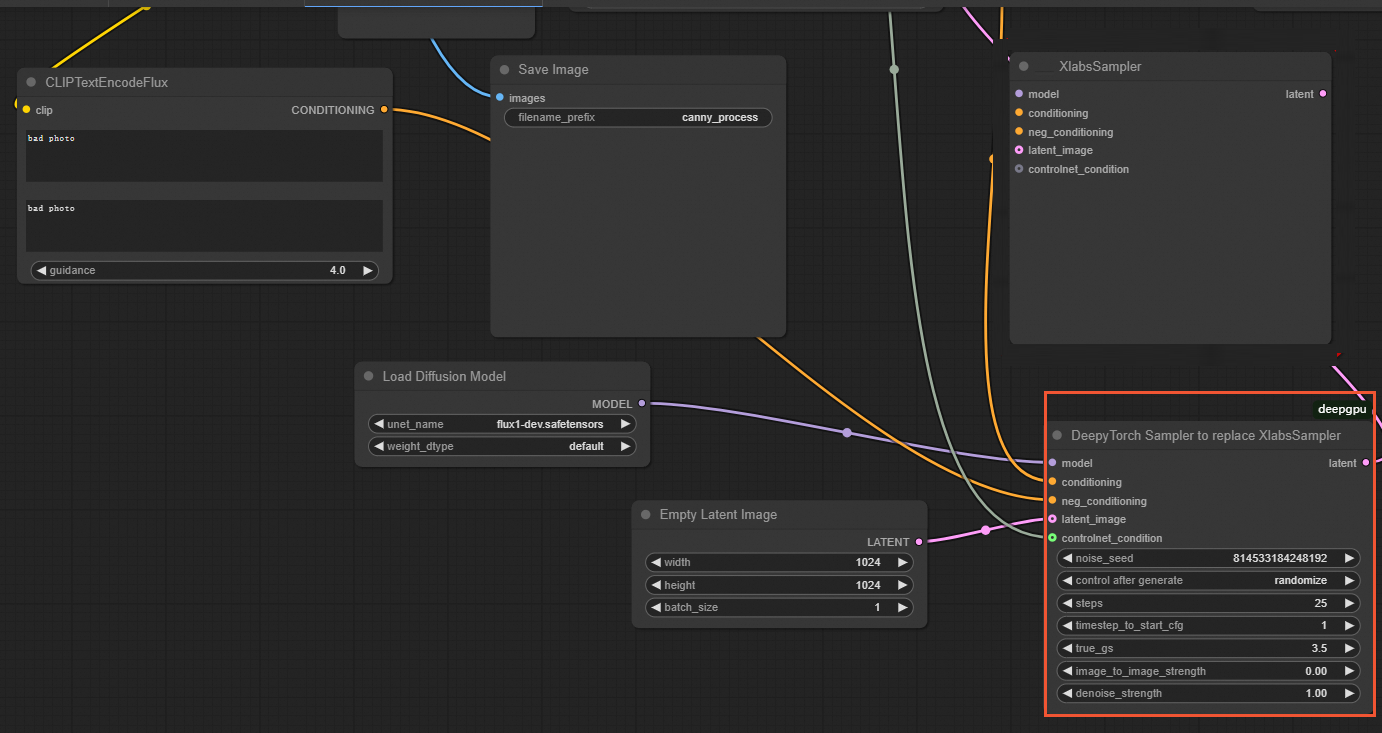
Arquivos de fluxo de trabalho de exemplo:
Versão original flux-dev+controlnet: workflow_flux_controlnet.JSON
Versão acelerada flux-dev+controlnet DeepyTorch: workflow_flux_controlnet_deepytorch.JSON
SD 1.5 models
-
Para modelos LoRA nativos do ComfyUI
NotaO modelo de código aberto FLUX.1-dev com LoRA suporta tanto a implementação LoRA do XLabs quanto a implementação nativa do ComfyUI.
Na interface do ComfyUI, insira um nó
ApplyDeepyTorchapós o último nóLoraLoaderModelOnly, conforme mostrado na figura a seguir:Arquivos de fluxo de trabalho de exemplo:
Versão original flux-dev+lora: workflow_flux_lora_wukong.json
Versão acelerada flux-dev+lora DeepyTorch: workflow_flux_lora_deepytorch_wukong.JSON
-
Para ControlNet SD personalizado
Na interface do ComfyUI, insira um nó
ApplyDeepyTorchapós o nóLoad Checkpoint, conforme mostrado na figura a seguir: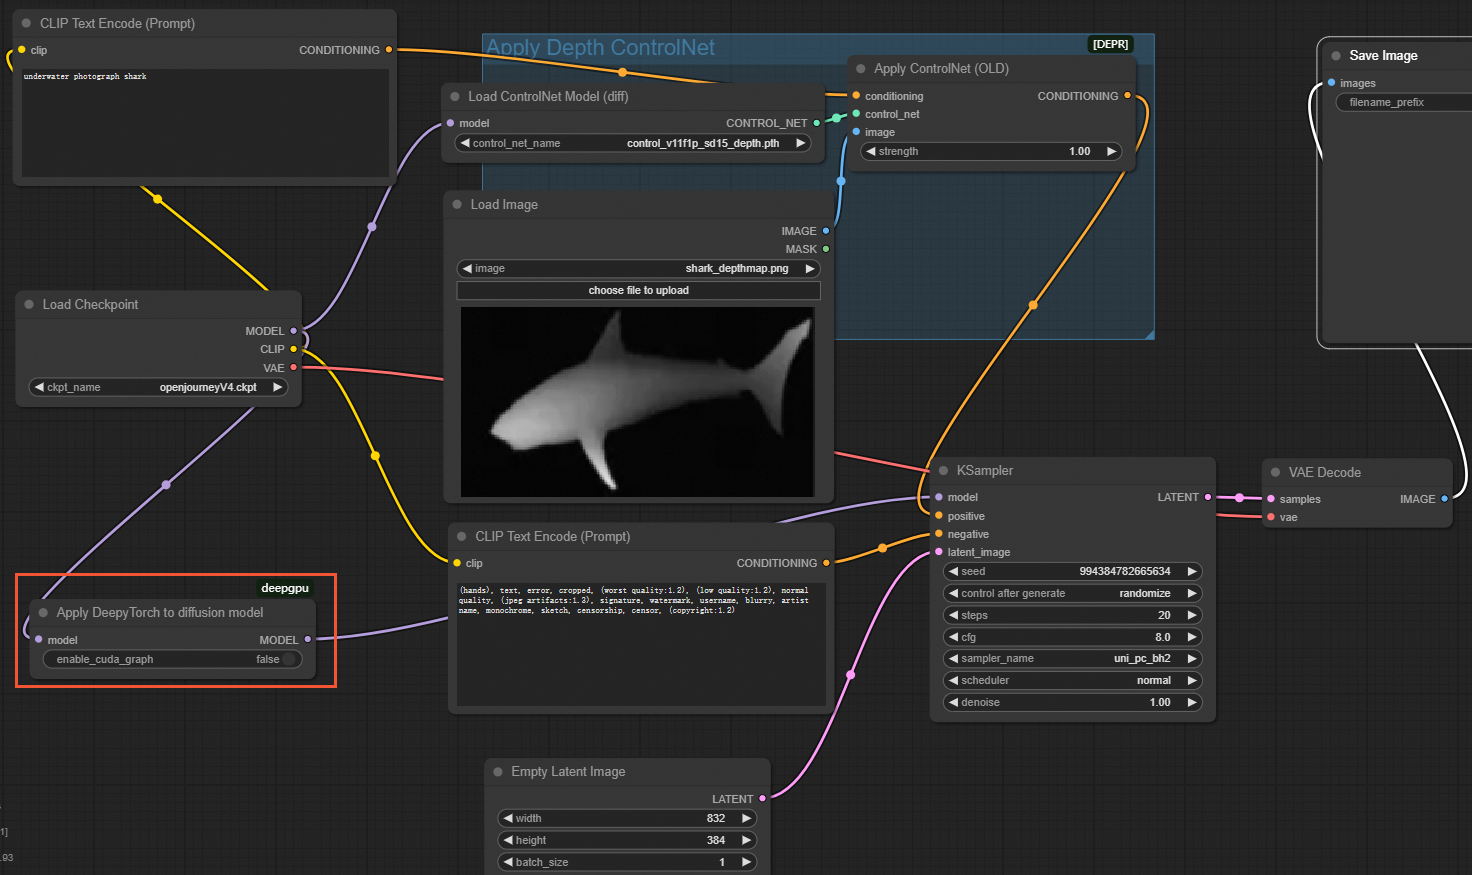
Arquivos de fluxo de trabalho de exemplo:
Versão original sd1.5+controlnet: workflow_sd1.5_controlnet.JSON
Versão acelerada sd1.5+controlnet DeepyTorch: workflow_sd1.5_controlnet_deepytorch.JSON
SDXL models
Para acelerar a inferência do modelo SDXL, insira um nó ApplyDeepyTorch após os nós Load Checkpoint BASE e REFINER, conforme mostrado abaixo:
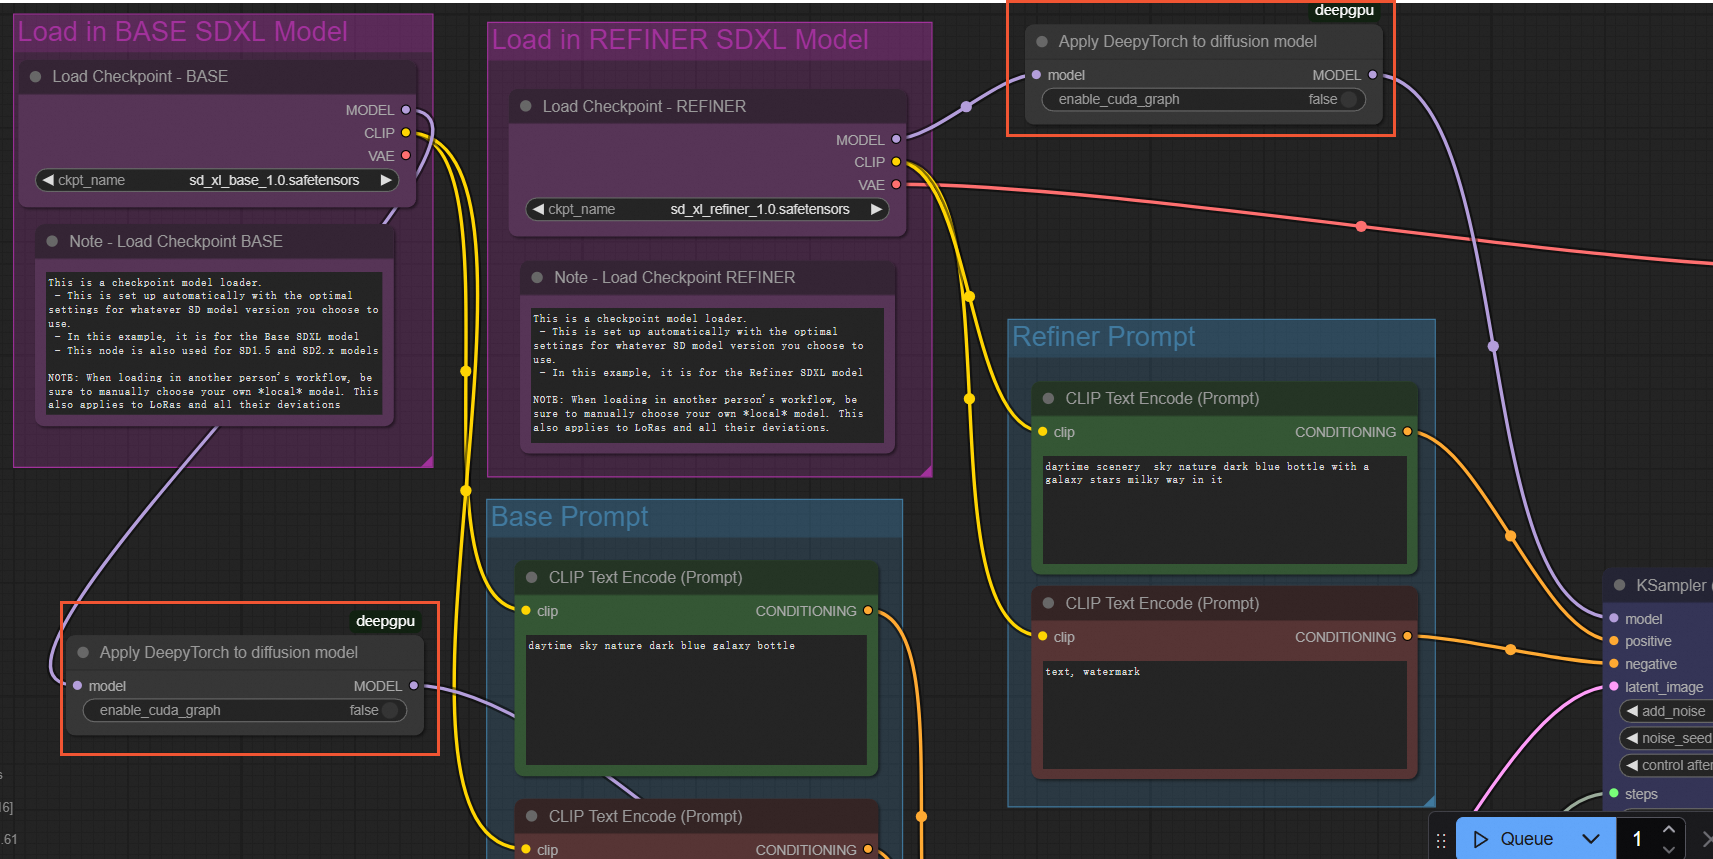
Arquivos de fluxo de trabalho de exemplo:
Versão original sdxl: workflow_sdxl_base_refiner.JSON
Versão acelerada sdxl DeepyTorch: workflow_sdxl_base_refiner_deepytorch.JSON