O Elastic GPU Service oferece instâncias aceleradas por GPU com alta densidade de computação, rede de baixa latência e faturamento flexível — além do DeepGPU, um conjunto de ferramentas gratuito que acelera cargas de trabalho de treinamento e inferência sem exigir alterações no código.
Elastic GPU Service
Implantação global em múltiplas regiões. Implante instâncias aceleradas por GPU em escala em diversas regiões globais. O provisionamento automático e o auto scaling lidam com picos repentinos de demanda sem intervenção manual.
Até 1.000 TFLOPS de computação de precisão mista. Quando combinadas com uma plataforma de CPU de alto desempenho, as instâncias aceleradas por GPU entregam até 1.000 trilhões de operações de ponto flutuante por segundo (TFLOPS) de desempenho de computação de precisão mista — capacidade suficiente para treinamento de modelos de linguagem grandes (LLM) em larga escala e inferência de alto throughput.
Rede de duas camadas para todos os tipos de carga de trabalho. Cada instância acelerada por GPU se conecta a uma Virtual Private Cloud (VPC) com até 32 Gbit/s de largura de banda interna e 4,5 milhões de pacotes por segundo (Mpps) para cargas de trabalho gerais. Para tarefas de treinamento distribuído, combine instâncias com o Super Computing Cluster (SCC) para adicionar até 50 Gbit/s de largura de banda de Remote Direct Memory Access (RDMA) entre nós — mantendo a sincronização de gradientes fora do gargalo.
Faturamento adaptado ao seu padrão de uso. Escolha entre assinatura, pagamento conforme o uso, instâncias preemptíveis, instâncias reservadas e unidades de capacidade de armazenamento (SCUs) para adequar-se ao seu modelo de custos. Combine métodos de faturamento para cobrir tanto cargas de trabalho estáveis quanto demandas pontuais.
DeepGPU
O DeepGPU é um conjunto de ferramentas gratuito que acelera cargas de trabalho de GPU no Elastic GPU Service. Ele inclui e cGPU.
FastGPU
O FastGPU é uma ferramenta de implantação de clusters que automatiza a configuração da infraestrutura, permitindo executar tarefas de treinamento e inferência de IA sem provisionar manualmente recursos de computação, armazenamento ou rede.
Clusters prontos em 5 minutos. O FastGPU implanta um cluster totalmente configurado em 5 minutos. Todos os recursos são provisionados na camada de infraestrutura e ficam diretamente acessíveis para depuração.
Ciclo de vida dos recursos vinculado ao ciclo de vida da tarefa. O FastGPU libera automaticamente as instâncias aceleradas por GPU quando uma tarefa de treinamento ou inferência termina. Instâncias preemptíveis são suportadas para reduzir custos.
Observabilidade completa. O FastGPU fornece visualização, gerenciamento de logs e rastreamento de tarefas para garantir que cada execução seja auditável.
cGPU
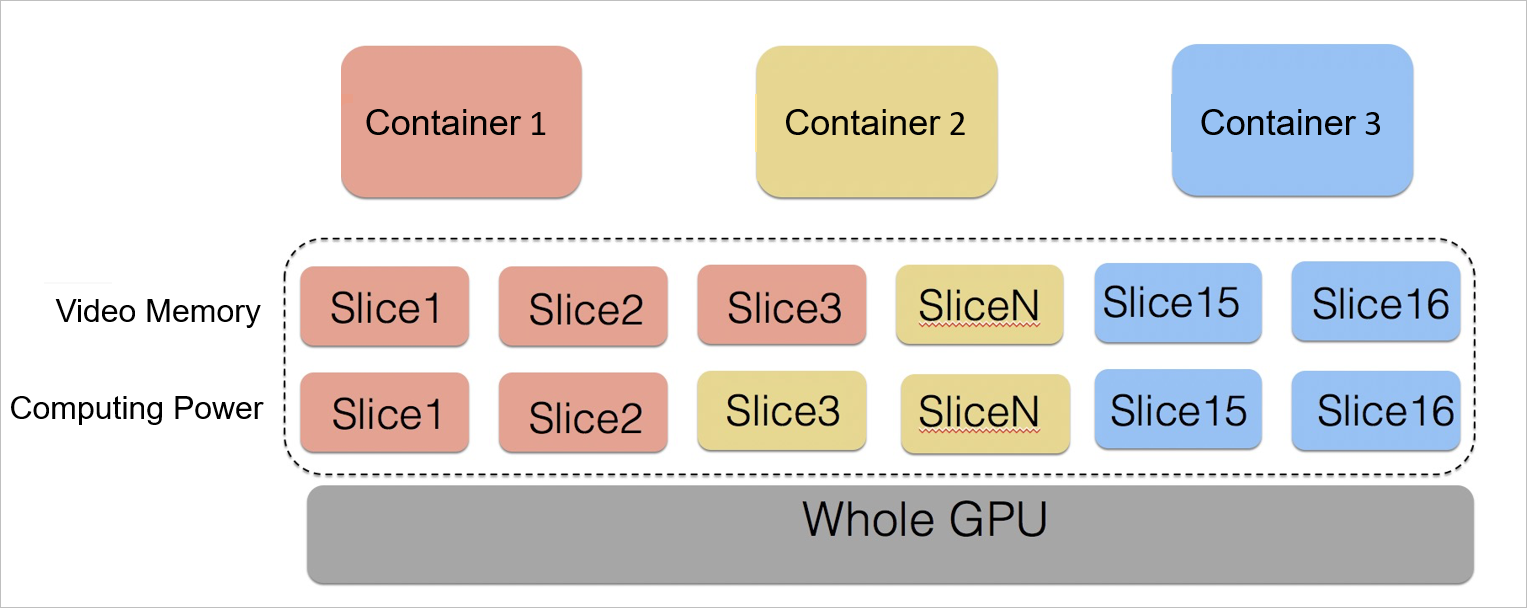
O cGPU permite que vários contêineres compartilhem uma única GPU física com isolamento rigoroso de recursos, melhorando a utilização da GPU, reduzindo custos e aumentando a segurança.
Compartilhe uma GPU entre contêineres sem expor dados comerciais. A maioria das cargas de trabalho de IA não necessita de uma GPU inteira. O cGPU aloca recursos de GPU entre contêineres enquanto isola os dados de cada um, garantindo que você pague apenas pela memória da GPU e pelo poder de computação que cada carga de trabalho realmente utiliza.
Alocação flexível por memória da GPU ou poder de computação. Aloque recursos com base em proporções de memória da GPU ou poder de computação para atender aos requisitos de cada contêiner.
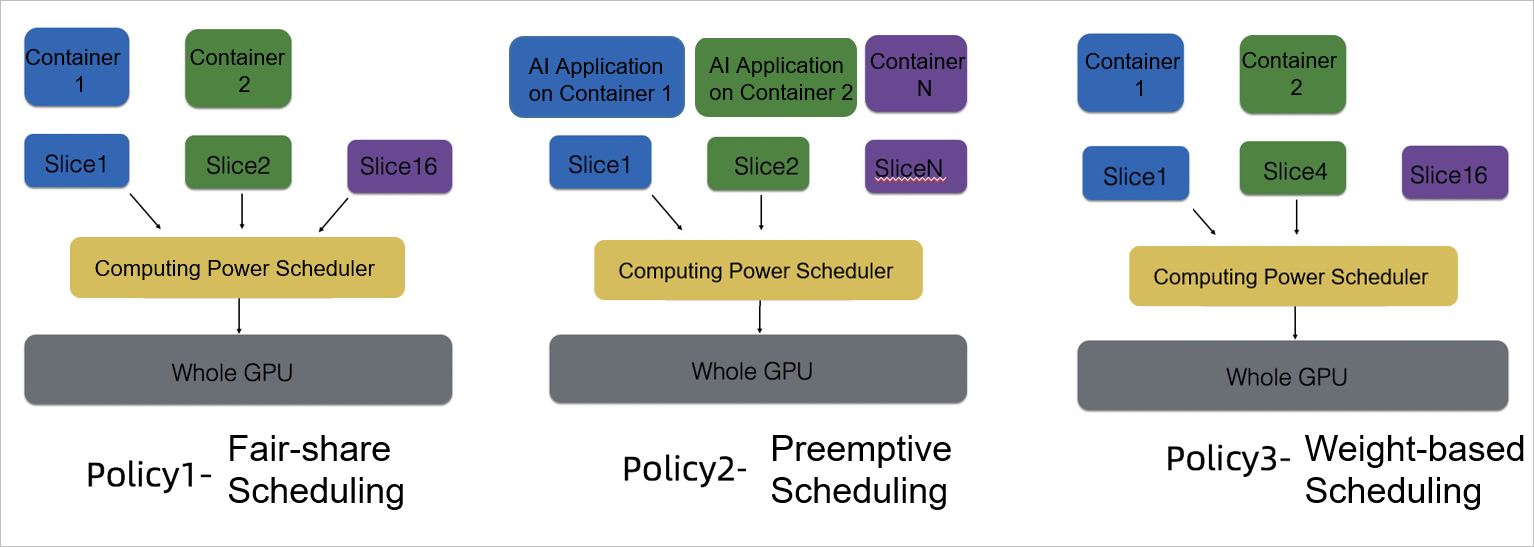
Three switchable scheduling policies for peak and off-peak hours. Alterne entre três políticas de alocação de poder de computação em tempo real para corresponder à intensidade da carga de trabalho, sem necessidade de reinicialização.