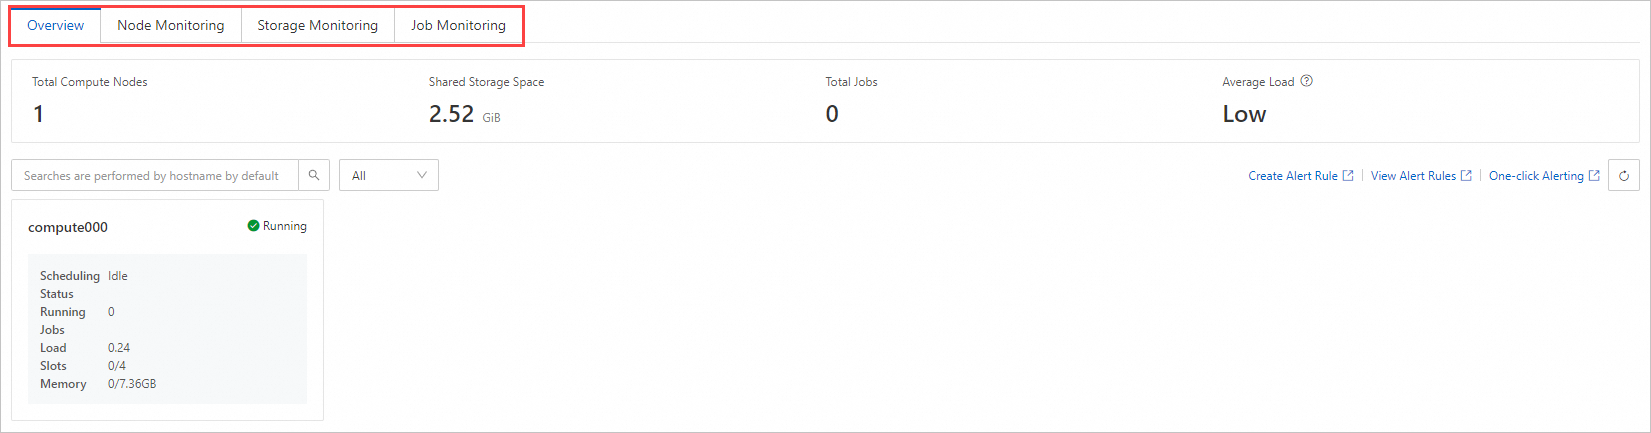
Aba | Descrição |
|
Overview
|
Esta aba apresenta estatísticas sobre Total Compute Nodes, Shared Storage Space, Total Jobs e Average Load. Também é possível verificar o Cluster Status e o uso de recursos de todos os nós de computação.
A tabela a seguir descreve o Scheduling Status dos nós de computação.
-
Idle: Todos os núcleos do nó estão disponíveis. O nó pode aceitar novos jobs e está pronto para operar com capacidade total.
-
Running: Alguns núcleos do nó estão em uso, mas outros ainda podem aceitar novos jobs.
-
Allocated: Todos os núcleos do nó estão ocupados. O nó não aceita novos jobs. Tarefas enviadas para este nó entram em fila até que núcleos fiquem disponíveis.
-
Offline: O nó não participa de computações e não aceita novos jobs.
|
|
Node Monitoring
|
Filtre por cluster ou fila para visualizar as seis estatísticas abaixo:
-
CPU Utilization
Percentual de tempo de CPU utilizado pelos programas nos nós de computação durante um período específico. Uma utilização alta (acima de 80%–90%) geralmente indica uso eficiente dos recursos, mas níveis elevados sustentados podem degradar o desempenho do cluster e aumentar os tempos de resposta. Já uma utilização baixa (0%–30%) pode sugerir subutilização de recursos, gargalos de desempenho ou problemas no agendamento de jobs.
-
Memory Utilization
Esta métrica reflete o uso de memória nos nós de computação do cluster. Para garantir a execução adequada dos jobs, monitore regularmente a utilização de memória e evite falhas por falta de memória. Se necessário, resolva esses problemas aumentando a capacidade de memória ou otimizando as estratégias de uso.
-
System Load
Representa a carga de trabalho dos nós de computação. Essa informação ajuda a avaliar a capacidade de processamento de jobs do cluster. Monitore a relação entre a carga e o número de nós. Uma carga excessivamente alta indica insuficiência de recursos. Reduza a carga do sistema adicionando nós (scale-out) ou otimizando o fluxo de trabalho.
-
Disk Usage
Indica o uso do espaço de armazenamento em disco. Esses dados ajudam a garantir a disponibilidade do disco e a evitar uso excessivo. Por exemplo, se o uso atingir 100%, operações de gravação não poderão ser realizadas. Gerencie a pressão de armazenamento limpando dados redundantes ou expandindo a capacidade. Essa análise oferece uma visão completa do uso de disco e indica se é necessária limpeza de espaço ou expansão de armazenamento.
-
Disk Read and Write
A taxa de leitura de disco indica a quantidade de dados lidos por segundo. A taxa de gravação indica a quantidade de dados gravados por segundo. Unidade: KB/s. Essas métricas permitem avaliar eficazmente o desempenho do cluster e assegurar que ele processe tarefas de computação com alta eficiência.
-
Network Traffic
Quantidade de dados transferidos entre nós de computação pela Virtual Private Cloud (VPC). Preste atenção especial aos períodos de pico de tráfego de rede para detectar exceções rapidamente. Por exemplo, largura de banda insuficiente reduz a eficiência da transmissão de dados.
|
|
Storage Monitoring
|
Visualize informações de monitoramento de armazenamento de diferentes sistemas de arquivos no cluster, incluindo as seis estatísticas a seguir:
-
Storage Space
Uso de armazenamento do sistema de arquivos Apsara File Storage NAS (NAS) anexado ao cluster. O sistema de arquivos NAS pode armazenar saídas de computação, arquivos temporários e dados de aplicativos. Para evitar exceções como espaço insuficiente, degradação de desempenho e perda de dados, recomenda-se adotar medidas como monitoramento e alertas, limpeza regular de dados e expansão de armazenamento.
-
Files
Número total de arquivos no sistema de arquivos NAS. Esta métrica reflete indiretamente a integridade do sistema e as necessidades de manutenção, ajudando a avaliar a eficiência da gestão de armazenamento. Note que um número excessivo de arquivos aumenta a complexidade de gerenciamento e afeta a eficiência de recuperação e o desempenho. Se a quantidade de arquivos ultrapassar o limiar predefinido, monitore-a atentamente. Recomenda-se organizar regularmente o conteúdo armazenado e remover arquivos desnecessários ou redundantes para melhorar a eficiência de gestão e o desempenho do sistema.
IOPS IOPS médio de leitura e gravação do sistema de arquivos dentro de um período especificado. Unidade: requisições/s. -
Latency
Latência média de leitura e gravação por milissegundo do sistema de arquivos dentro de um período específico. Unidade: milissegundos.
-
Throughput
Throughput médio de leitura e gravação (bytes por segundo) do sistema de arquivos dentro de um período específico. Unidade: KiB.
-
Metadata QPS
Número médio de vezes que o sistema de arquivos solicita metadados por segundo dentro de um período específico. Unidade: requisições/s.
Para mais informações sobre as métricas de armazenamento de um sistema de arquivos, consulte Performance monitoring e FAQ about the performance of NAS file systems.
|
|
Job Monitoring
|
Filtre por cluster, fila, projeto ou usuário para visualizar as seis estatísticas seguintes:
-
Jobs
Quantidade de jobs em execução no cluster. Trata-se de uma métrica importante para avaliar a carga do cluster. Para evitar competição de recursos causada por um número anormalmente alto de jobs, garanta que a métrica corresponda aos recursos disponíveis. Para melhorar a eficiência geral de utilização de recursos, recomenda-se otimizar o agendamento de jobs e eliminar tarefas desnecessárias.
-
Total Cores Required by Enqueued Jobs
Número total de núcleos de CPU necessários para concluir uma tarefa específica. Se o total de núcleos necessários for maior que o número de núcleos disponíveis, o tempo de espera dos jobs na fila pode ser longo. Para resolver tais problemas, aumente o número de núcleos de CPU do cluster ou ajuste a prioridade dos jobs para otimizar a alocação de recursos e melhorar a eficiência.
-
Job Wait Duration
Tempo médio de espera dos jobs enfileirados no cluster. Esta métrica reflete a situação de competição por recursos. Um tempo de espera longo afeta a eficiência geral, especialmente em situações anormais. Se o tempo de espera aumentar significativamente, execute jobs de alta prioridade primeiro para otimizar a utilização de recursos.
-
Total Cores Used by Running Jobs
Número de núcleos atualmente utilizados por jobs em execução. Esta métrica ajuda a monitorar o uso de recursos. Garanta que os núcleos sejam usados de forma eficaz para evitar utilização anormalmente alta ou baixa de recursos. Para resolver tais questões, recomenda-se ajustar as configurações de jobs e alocar recursos eficientemente para melhorar o desempenho geral.
-
Job CPU Utilization
Proporção entre os núcleos que um job utiliza e os núcleos que ele solicitou. Baixa utilização de CPU pelo job pode indicar um problema, como gargalo de I/O ou aplicativo ineficiente, resultando em desperdício de recursos. Recomenda-se analisar o job e sua carga de trabalho para identificar oportunidades de otimização.
-
Job Memory Usage
Proporção entre a memória que um job utiliza e a memória que ele solicitou. Monitore a utilização de memória do job para evitar uso excessivo, que pode levar a erros de falta de memória. Para manter a estabilidade do sistema, otimize as configurações de memória ou faça upgrade para um tipo de nó com mais memória.
|