Use o Data Transmission service (DTS) para configurar um pipeline de dados contínuo do ApsaraDB RDS for PostgreSQL para o AnalyticDB for PostgreSQL. O DTS gerencia tanto a carga inicial completa quanto a captura contínua de dados de alterações incrementais (CDC) por meio de replicação lógica, mantendo o banco de dados analítico sincronizado conforme os dados de source mudam.
Pré-requisitos
Antes de começar, certifique-se de ter:
Uma instância do AnalyticDB for PostgreSQL com armazenamento disponível maior do que o tamanho total dos dados na instância do RDS for PostgreSQL de origem. Consulte Create an instance.
Um banco de dados criado na instância do AnalyticDB for PostgreSQL de destino para receber os dados sincronizados. Consulte a seção CREATE DATABASE em SQL syntax.
Uma conta privilegiada na instância do RDS for PostgreSQL de origem que seja proprietária do banco de dados. Consulte Create an account e Create a database.
Uma conta do banco de dados na instância do AnalyticDB for PostgreSQL de destino com permissões de leitura e gravação. Uma conta inicial ou uma conta com a permissão RDS_SUPERUSER também funciona. Consulte Create a database account e Manage users and permissions.
Faturamento
|
Tipo de sincronização |
Taxa |
|
Sincronização de esquema e sincronização completa de dados |
Gratuita |
|
Sincronização incremental de dados |
Cobrada. Consulte Billing overview. |
Operações SQL suportadas para sincronização incremental
|
Tipo de operação |
Instruções SQL |
|
DML |
INSERT, UPDATE, DELETE |
|
DDL |
Operações ALTER TABLE, incluindo RENAME TABLE, ADD COLUMN, ADD COLUMN DEFAULT, ALTER COLUMN TYPE, DROP COLUMN, ADD CONSTRAINT, ADD CONSTRAINT CHECK e ALTER COLUMN DROP DEFAULT |
Requisitos para sincronização de DDL:
A sincronização de DDL está disponível apenas para tarefas criadas após 1º de outubro de 2020.
Para tarefas criadas antes de 12 de maio de 2023, configure triggers e funções no banco de dados de origem antes da configuração da tarefa. Consulte Use triggers and functions to implement incremental DDL migration for PostgreSQL databases.
A sincronização de DDL exige uma conta do banco de dados privilegiada na instância de origem e que você atualize a versão menor do motor para 20210228 ou posterior. Consulte Update the minor engine version.
Não é possível sincronizar dados do tipo BIT durante a sincronização incremental de dados.
As seguintes operações DDL não são sincronizadas:
Instruções DDL que incluem modificadores adicionais, como CASCADE ou RESTRICT
Instruções DDL de sessões que executam
SET session_replication_role = replicaInstruções DDL invocadas por meio de funções
Instruções DDL confirmadas na mesma transação que as instruções DML
Instruções DDL em objetos não incluídos no escopo de sincronização
Limitações
Requisitos de tabela e esquema
-
As tabelas devem ter uma restrição PRIMARY KEY ou UNIQUE com todos os campos únicos. Sem isso, o banco de dados de destino pode conter registros duplicados.
NotaSe você criar uma tabela de destino fora do DTS (sem selecionar Schema Synchronization para Synchronization Types), certifique-se de que a tabela de destino tenha as mesmas restrições PRIMARY KEY ou NOT NULL UNIQUE da tabela de origem.
Apenas tabelas podem ser selecionadas como objetos de sincronização, e não views, functions ou outros tipos de objetos.
Uma tarefa pode sincronizar dados de apenas um banco de dados. Para sincronizar vários bancos de dados, crie uma tarefa separada para cada um.
Tabelas com relações de herança entre esquemas não podem ser sincronizadas.
A tabela de destino não pode ser uma tabela append-optimized (AO).
O DTS não sincroniza os seguintes tipos de dados: VARBIT, GEOMETRY, UUID, TSQUERY, TSVECTOR e TXID_SNAPSHOT.
Mapeamento de colunas e diferenças de esquema
Se você usar o mapeamento de colunas para sincronização parcial de tabela, ou se os esquemas das tabelas de origem e destino forem diferentes, os dados nas colunas que existem na origem, mas não no destino, serão perdidos.
Se você renomear tabelas ou colunas no banco de dados de destino usando o recurso de mapeamento de nomes de objetos, a sincronização de mais de 5.000 tabelas em uma única tarefa causará um erro de solicitação. Para mais de 5.000 tabelas, configure várias tarefas ou sincronize bancos de dados inteiros.
Requisitos de log WAL
O banco de dados de origem deve atender a estes requisitos de write-ahead logging (WAL):
Por favor, defina
wal_levelcomological.Para sincronização apenas incremental: retenha os logs WAL por mais de 24 horas.
Para sincronização completa e incremental: retenha os logs WAL por pelo menos 7 dias. Após a conclusão da sincronização completa, você pode definir o período de retenção para mais de 24 horas.
O descumprimento desses requisitos pode impedir que o DTS obtenha os logs WAL, resultando em falha na tarefa ou, em casos excepcionais, inconsistência ou perda de dados.
Restrições de tempo de execução
Não execute instruções DDL durante a sincronização de esquema ou a sincronização completa de dados. Isso resultará em falha da tarefa.
-
Se você adicionar uma tabela a um esquema sincronizado ou renomear uma tabela usando RENAME, execute
ALTER TABLE schema.table REPLICA IDENTITY FULL;antes de gravar dados na tabela. Isso evita inconsistência de dados. Execute esta operação durante horários de menor tráfego para evitar deadlocks.NotaSubstitua
schemaetablepelo nome real do esquema e pelo nome da tabela. Não exclua as tabelas temporárias que o DTS cria no banco de dados de origem:
public.dts_pg_class,public.dts_pg_attribute,public.dts_pg_type,public.dts_pg_enum,public.dts_postgres_heartbeat,public.dts_ddl_command,public.dts_args_sessionepublic.aliyun_dts_instance. O DTS exclui automaticamente essas tabelas quando a instância é liberada.Transações de longa duração no banco de dados de origem podem causar acúmulo de logs WAL e esgotar o espaço em disco.
Se o banco de dados de origem passar por uma atualização de versão maior enquanto a tarefa estiver em execução, a tarefa falhará e não poderá ser recuperada. Reconfigure a tarefa.
Uma única alteração incremental de dados não deve exceder 256 MB. Se exceder, a tarefa falhará e não poderá ser recuperada. Reconfigure a tarefa.
Slots de replicação
O DTS cria um slot de replicação com o prefixo dts_sync_ no banco de dados de origem. Este slot retém logs incrementais dos últimos 15 minutos.
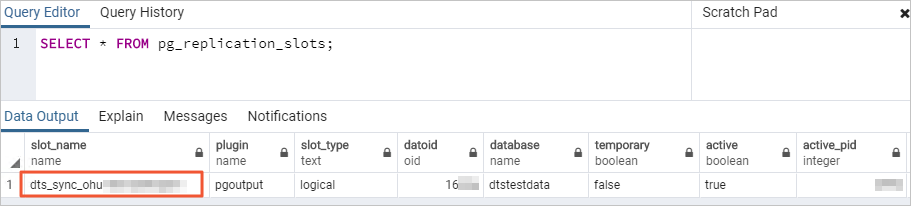
O slot de replicação é excluído automaticamente quando a instância do DTS é liberada. Se você alterar a senha do banco de dados de origem ou remover os endereços IP do DTS da lista de permissões, o slot não poderá ser excluído automaticamente; exclua manualmente para evitar acúmulo.
Se a tarefa for liberada ou falhar, o DTS excluirá automaticamente o slot de replicação. Após um switchover primário/secundário no banco de dados PostgreSQL de origem, faça login no banco de dados secundário para excluir o slot de replicação manualmente.
O DTS também adiciona uma tabela de heartbeat chamada dts_postgres_heartbeat ao banco de dados de origem para rastrear a latência de sincronização.
Restrições específicas da origem
ApsaraDB RDS for PostgreSQL:
Não modifique o endpoint ou a zona da instância do RDS for PostgreSQL de origem enquanto a tarefa estiver em execução. Isso resultará em falha da tarefa.
Para executar um switchover primário/secundário na instância de origem, ative primeiro o recurso Logical Replication Slot Failover. Consulte Logical Replication Slot Failover.
PostgreSQL autogerenciado:
Defina
max_wal_sendersemax_replication_slotscom valores maiores do que a soma dos slots de replicação existentes e o número de instâncias do DTS a serem criadas.Um switchover primário/secundário em um banco de dados PostgreSQL autogerenciado causará falha na tarefa.
Google Cloud SQL for PostgreSQL:
-
Defina o parâmetro Database Account para uma conta com a permissão
cloudsqlsuperuser. Ao selecionar objetos para sincronizar, selecione apenas os objetos que a conta está autorizada a gerenciar ou conceda a permissão OWNER nesses objetos para a conta.NotaUma conta com a permissão
cloudsqlsuperusernão gerencie dados de propriedade de outras contas com a mesma permissão.
Consistência de dados
Avalie o impacto no desempenho dos bancos de dados de origem e destino antes de iniciar a tarefa. Execute a tarefa durante horários de menor tráfego.
Durante a sincronização completa de dados, operações INSERT simultâneas criam fragmentação de tabela no banco de dados de destino, portanto, o tablespace de destino pode ser maior do que o de origem após a conclusão da sincronização completa.
A inconsistência de dados ocorre se dados de fontes diferentes do DTS forem gravados no banco de dados de destino durante a sincronização. Se você usar o Data Management (DMS) para executar operações DDL online enquanto outras fontes gravam no destino, pode ocorrer perda de dados.
Se você usar apenas o DTS para gravar dados no destino, use o DMS para executar operações DDL online nas tabelas de origem durante a sincronização. Consulte Change schemas without locking tables.
Recuperação de tarefas
Se uma tarefa do DTS falhar, o suporte técnico do DTS tentará a recuperação em até 8 horas. Durante a recuperação, a tarefa pode ser reiniciada e os parâmetros da tarefa (não os parâmetros do banco de dados) podem ser modificados. Para obter detalhes sobre quais parâmetros podem ser alterados, consulte a seção Modify instance parameters em Modify the parameters of a DTS instance.
Configurar uma tarefa de sincronização de dados
Etapa 1: Acesse Tarefas de Sincronização de Dados
Acesse o console do Data Management (DMS).
Na barra de navegação superior, clique em Data + AI.
-
No painel de navegação à esquerda, escolha DTS (DTS) > Data Synchronization.
NotaA navegação pode variar com base no modo e no layout do console do DMS. Consulte Simple mode e Customize the layout and style of the DMS console.
Você também pode acesse diretamente a Data Synchronization Tasks page of the new DTS console.
Etapa 2: Crie uma tarefa
-
No lado direito de Data Synchronization Tasks, selecione a região onde a instância de sincronização residirá.
NotaNo novo console do DTS, selecione a região na barra de navegação superior.
Clique em Create Task.
-
(Opcional) Clique em New Configuration Page no canto superior direito.
NotaIgnore esta etapa se Back to Previous Version for exibido.
Use a nova página de configuração, pois alguns parâmetros diferem entre as versões.
Etapa 3: Configurar bancos de dados de origem e destino
Configure os seguintes parâmetros:
Nome da tarefa
|
Parâmetro |
Descrição |
|
Task Name |
Um nome para a tarefa do DTS. O DTS gera um nome padrão; especifique um nome descritivo para identificar a tarefa facilmente. O nome não precisa ser exclusivo. |
Banco de dados de origem
|
Parâmetro |
Descrição |
|
Select a DMS database instance. |
Selecione um banco de dados registrado existente para preencher automaticamente as configurações ou deixe em branco e configure manualmente. Para registrar um banco de dados, consulte Register an Alibaba Cloud database instance ou Register a database hosted on a third-party cloud service or a self-managed database. Para registro no console do DTS, consulte Manage database connections. |
|
Database Type |
Selecione PostgreSQL. |
|
Access Method |
Selecione Alibaba Cloud Instance. |
|
Instance Region |
A região da instância do RDS for PostgreSQL de origem. |
|
Replicate Data Across Alibaba Cloud Accounts |
Selecione No para usar um banco de dados na conta atual. |
|
Instance ID |
O ID da instância do RDS for PostgreSQL de origem. |
|
Database Name |
O nome do banco de dados de origem que contém os dados a serem sincronizados. |
|
Database Account |
A conta privilegiada para a instância de origem. |
|
Database Password |
A senha da conta do banco de dados. |
|
Encryption |
Selecione Non-encrypted para uma conexão padrão ou SSL-encrypted para uma conexão criptografada. Para o SSL, faça upload do CA Certificate e, opcionalmente, do Client Certificate e Private Key of Client Certificate, e defina Private Key Password of Client Certificate. Consulte SSL encryption. |
Banco de dados de destino
|
Parâmetro |
Descrição |
|
Select a DMS database instance. |
Selecione um banco de dados registrado existente para preencher automaticamente as configurações ou configure manualmente. |
|
Database Type |
Selecione AnalyticDB for PostgreSQL. |
|
Access Method |
Selecione Alibaba Cloud Instance. |
|
Instance Region |
A região da instância do AnalyticDB for PostgreSQL de destino. |
|
Instance ID |
O ID da instância do AnalyticDB for PostgreSQL de destino. |
|
Database Name |
O nome do banco de dados de destino. |
|
Database Account |
A conta para a instância de destino, com permissões de leitura e gravação. |
|
Database Password |
A senha da conta do banco de dados. |
Etapa 4: Testar conectividade
Clique em Test Connectivity and Proceed.
O DTS adiciona automaticamente seus blocos CIDR de IP do servidor às listas de permissões de instâncias de banco de dados da Alibaba Cloud e às regras de grupo de segurança de bancos de dados hospedados no ECS. Para bancos de dados autogerenciados em data centers ou em plataformas de cloud de terceiros, adicione manualmente os blocos CIDR dos servidores do DTS à lista de permissões do banco de dados. Consulte CIDR blocks of DTS servers.
Adicionar blocos CIDR do DTS a listas de permissões ou grupos de segurança apresenta riscos de segurança. Antes de continuar, tome medidas preventivas, como impor credenciais fortes, limitar portas expostas, autenticar chamadas de API, auditar regras de lista de permissões regularmente e usar o Express Connect, VPN Gateway ou Smart Access Gateway para conectar o banco de dados ao DTS.
Etapa 5: Configurar objetos de sincronização
Escolher tipos de sincronização
Selecione os tipos de sincronização que correspondem ao seu caso de uso:
|
Tipo de sincronização |
Quando selecionar |
|
Schema Synchronization |
Selecione para que o DTS crie tabelas de destino automaticamente. Obrigatório ao selecionar também Full Data Synchronization. |
|
Full Data Synchronization |
Selecione para copiar todos os dados existentes da origem para o destino antes do início da sincronização incremental. Obrigatório para a configuração inicial. |
|
Incremental Data Synchronization |
Selecionado por padrão. Mantém o destino sincronizado com as alterações contínuas na origem usando replicação lógica. Obrigatório para sincronização contínua. |
Para a maioria das configurações, selecione todos os três: a sincronização de esquema cria as tabelas, a sincronização completa de dados copia os dados históricos e a sincronização incremental de dados mantém o destino atualizado.
Configurar objetos e tratamento de conflitos
|
Parâmetro |
Descrição |
|
DDL and DML Operations to Be Synchronized |
As operações SQL a serem sincronizadas. Para configurar por tabela, clique com o botão direito do mouse em um objeto em Selected Objects e selecione as operações. Consulte SQL operations that support incremental synchronization. |
|
Processing Mode of Conflicting Tables |
Precheck and Report Errors: falha na pré-verificação se as tabelas de destino compartilharem nomes com as tabelas de origem. Use o object name mapping para resolver conflitos. Ignore Errors and Proceed: ignora a verificação de conflito de nomes. Durante a sincronização completa, os registros de destino existentes com chaves primárias ou exclusivas correspondentes são retidos; durante a sincronização incremental, eles são sobrescritos. Se os esquemas forem diferentes, a inicialização pode falhar parcialmente. |
|
Capitalization of Object Names in Destination Instance |
Como o DTS lida com o uso de maiúsculas e minúsculas em nomes de banco de dados, tabelas e colunas no destino. O padrão é DTS default policy. Consulte Specify the capitalization of object names in the destination instance. |
|
Source Objects |
Selecione objetos nesta seção e clique em |
|
Selected Objects |
Clique com o botão direito do mouse em uma tabela para renomeá-la, definir filtros de dados ou configurar operações SQL por tabela. Para renomear vários objetos de uma vez, clique em Batch Edit e edite. Consulte Map object names e Set filter conditions. |
 para adicioná-los a Selected Objects. Granularidade selecionável: colunas, tabelas ou esquemas.
Renomear um objeto usando o mapeamento de nomes de objetos pode causar falha na sincronização de objetos dependentes.
Configurar opções avançadas
Clique em Next: Advanced Settings e configure os seguintes parâmetros:
|
Parâmetro |
Descrição |
|
Dedicated Cluster for Task Scheduling |
Por padrão, o DTS usa um cluster compartilhado. Adquira um cluster dedicado para maior estabilidade. Consulte What is a DTS dedicated cluster. |
|
Retry Time for Failed Connections |
Por quanto tempo o DTS tenta reconectar após falhas de conexão depois do início da tarefa. Intervalo: 10 a 1440 minutos. Padrão: 720 minutos. Defina como mais de 30 minutos. Se o DTS reconectar dentro deste período, a tarefa será retomada; caso contrário, a tarefa falhará. O valor mais curto entre as tarefas que compartilham a mesma origem ou destino entra em vigor. |
|
Retry Time for Other Issues |
Por quanto tempo o DTS tenta repetir operações DDL ou DML com falha. Intervalo: 1 a 1440 minutos. Padrão: 10 minutos. Defina como mais de 10 minutos e mantenha um valor menor que Retry Time for Failed Connections. |
|
Enable Throttling for Full Data Synchronization |
Limita a carga de leitura/gravação nos bancos de dados de origem e destino durante a sincronização completa. Configure Queries per second (QPS) to the source database, RPS of Full Data Migration e Data migration speed for full migration (MB/s). Disponível apenas quando Full Data Synchronization estiver selecionado. |
|
Enable Throttling for Incremental Data Synchronization |
Limita a carga durante a sincronização incremental. Configure RPS of Incremental Data Synchronization e Data synchronization speed for incremental synchronization (MB/s). |
|
Environment Tag |
Uma tag opcional para identificar a instância do DTS por ambiente. |
|
Configure ETL |
Defina como Yes para ativar o processamento de extração, transformação e carga (ETL) e insira instruções de transformação de dados. Defina como No para pular. Consulte What is ETL? e Configure ETL in a data migration or data synchronization task. |
|
Monitoring and Alerting |
Defina como Yes para receber alertas quando a tarefa falhar ou a latência de sincronização exceder um limiar. Configure o limiar de alerta e as configurações de notificação. Consulte Configure monitoring and alerting. |
Configurar verificação de dados
Clique em Next Step: Data Verification para configurar a verificação de dados. Consulte Configure a data verification task.
(Opcional) Configurar campos de banco de dados e tabelas
Clique em Next: Configure Database and Table Fields para definir a estrutura da tabela na instância do AnalyticDB for PostgreSQL de destino:
|
Parâmetro |
Descrição |
|
Type |
O tipo de tabela na instância de destino. |
|
Primary Key Column |
A coluna ou colunas de chave primária. Várias colunas formam uma chave primária composta. |
|
Distribution Key |
A chave de distribuição para a tabela. Deve ser uma das colunas de chave primária. Consulte Manage tables e Define table distribution. |
Esta etapa está disponível apenas quando a opção Schema Synchronization estiver selecionada. Defina Definition Status como All para que você visualize e modifique todas as tabelas.
Etapa 6: Salve configurações e executar uma pré-verificação
Clique em Next: Save Task Settings and Precheck.
Para visualizar os parâmetros da API desta configuração de tarefa, passe o mouse sobre o botão e clique em Preview OpenAPI parameters.
O DTS executa uma pré-verificação antes de iniciar a tarefa. A tarefa é iniciada apenas após a aprovação da pré-verificação.
Se a pré-verificação falhar, clique em View Details ao lado de cada item com falha, resolva os problemas e clique em Precheck Again.
Se um alerta for acionado: se não puder ser ignorado, resolva o problema e execute a pré-verificação novamente. Se puder ser ignorado, clique em Confirm Alert Details, depois em Ignore, depois em OK e, em seguida, em Precheck Again. Ignorar alertas pode causar inconsistência de dados.
Etapa 7: Adquirir e iniciar a instância
Aguarde até que Success Rate atinja 100% e clique em Next: Purchase Instance.
Na página de compra, configure o seguinte:
|
Parâmetro |
Descrição |
|
Billing Method |
Subscription: pague antecipadamente por um prazo fixo, mais econômico para uso de longo prazo. Pay-as-you-go: cobrado por hora, adequado para uso de curto prazo. Libere a instância quando não for mais necessária para interromper as cobranças. |
|
Resource Group Settings |
O grupo de recursos para a instância. Padrão: default resource group. Consulte What is Resource Management? |
|
Instance Class |
A camada de velocidade de sincronização. Consulte Instance classes of data synchronization instances. |
|
Subscription Duration |
Disponível apenas para o método de faturamento por assinatura. Opções: 1 a 9 meses, 1 ano, 2 anos, 3 anos ou 5 anos. |
Leia e selecione Data Transmission Service (Pay-as-you-go) Service Terms e clique em Buy and Start. Na caixa de diálogo, confirme a ação e clique em OK.
A tarefa aparece na lista de tarefas. Você pode monitorar o progresso dela lá.
Próximos passos
Logical Replication Slot Failover — ative este recurso na instância do RDS de origem se você planeja executar switchovers primário/secundário.
Map object names — renomeie objetos no destino sem alterar os objetos de origem.
Modify the parameters of a DTS instance — ajuste os parâmetros da tarefa após iniciá-la.
Configure a data verification task — verifique a consistência dos dados entre a origem e o destino.