Use o Data Transmission service (DTS) para transmitir alterações incrementais de uma instância do ApsaraDB RDS for MySQL para um projeto do DataHub em tempo real. Quando a sincronização estiver em execução, use o Alibaba Cloud Realtime Compute for Apache Flink ou o StreamCompute para analisar os dados.
Pré-requisitos
Antes de começar, verifique se você tem:
Um projeto do DataHub na região China (Hangzhou), China (Shanghai), China (Beijing) ou China (Shenzhen). Crie um, consulte Create a project.
Tabelas para sincronização com restrições PRIMARY KEY ou UNIQUE.
Faturamento
|
Tipo de sincronização |
Cobrança |
|
Sincronização de esquema e sincronização completa de dados |
Gratuito |
|
Sincronização incremental de dados |
Cobrado. Para mais informações, consulte Billing overview. |
Limitações
Sem dados históricos (apenas CDC): O DTS não oferece suporte à sincronização inicial completa de dados. O DTS sincroniza apenas as alterações que ocorrem após o início da tarefa.
Apenas tabelas: É possível selecionar apenas tabelas como objetos de sincronização.
Evite DDL durante a sincronização: Operações DDL em tabelas sincronizadas durante a execução da tarefa podem causar falhas na sincronização.
Operações SQL que podem ser sincronizadas
Tipo de operação | Instrução SQL |
DML | INSERT, atualize e exclua |
DDL | ADD COLUMN |
configure a sincronização de dados
Etapa 1: Comprar uma instância de sincronização de dados
Compre uma instância de sincronização de dados. Para mais informações, consulte Purchase a DTS instance.
Na página de compra, defina Source Instance como MySQL , Destination Instance como DataHub , e Synchronization Topology como One-way Synchronization .
Etapa 2: configure a tarefa
-
acesse o console do DTS.
Se for redirecionado para o console do Data Management (DMS), clique em
 ícone na
 para acessar a versão anterior do console do DTS.
No painel de navegação à esquerda, clique em Data Synchronization.
Na parte superior da página Synchronization Tasks, selecione a região onde a instância de destino está localizada.
Encontre a instância de sincronização de dados e clique em Configure Task na coluna Actions.
-
configure as instâncias de source e de destino.
Seção
Parâmetro
Descrição
N/D
Nome da tarefa de sincronização
O nome da tarefa gerado automaticamente pelo DTS. Especifique um nome descritivo para facilitar a identificação da tarefa. O nome não precisa ser único.
Detalhes da instância de source
Tipo de instância
selecione RDS Instance.
ImportantePara um banco de dados MySQL autogerenciado, prepare primeiro o ambiente necessário. Consulte Preparation overview.
Região da instância
A região de source selecionada na página de compra. Somente leitura.
ID da instância
O ID da instância do ApsaraDB RDS de source.
Conta do banco de dados
A conta do banco de dados de source.
ImportantePara o MySQL 5.5 ou MySQL 5.6, este parâmetro não é obrigatório.
Senha do banco de dados
A senha da conta.
ImportantePara o MySQL 5.5 ou MySQL 5.6, este parâmetro não é obrigatório.
Criptografia
selecione Non-encrypted ou SSL-encrypted. Se selecionar SSL-encrypted, ative a criptografia SSL na instância do RDS antes de configure esta tarefa. Consulte Configure the SSL encryption feature.
ImportanteEste parâmetro está disponível apenas na China continental e em China (Hong Kong).
Detalhes da instância de destino
Tipo de instância
DataHub. Somente leitura.
Região da instância
A região de destino selecionada na página de compra. Somente leitura.
Projeto
O nome do projeto do DataHub de destino.
-
Clique em Set Whitelist and Next no canto inferior direito. O DTS adiciona automaticamente os blocos CIDR do servidor à lista de permissões de endereços ip das instâncias de banco de dados da Alibaba Cloud (como o ApsaraDB RDS for MySQL) ou às regras do grupo de segurança de instâncias do elastic compute service (ECS) que hospedam o banco de dados. Se o banco de dados autogerenciado estiver hospedado em várias instâncias do ECS, adicione manualmente os blocos CIDR dos servidores do DTS às regras do grupo de segurança de cada instância do ECS. Para bancos de dados autogerenciados em um data center ou hospedados por um provedor de cloud de terceiros, adicione manualmente os blocos CIDR do servidor do DTS. Consulte Add the CIDR blocks of DTS servers.
AvisoAdicionar blocos CIDR do DTS a uma lista de permissões ou grupo de segurança pode introduzir riscos de segurança. Tome medidas preventivas, como reforçar a segurança de senhas, limitar portas expostas, auditar chamadas de API e revisar as regras da lista de permissões regularmente. Para maior segurança, conecte o banco de dados ao DTS usando o Express Connect, VPN Gateway ou Smart Access Gateway.
-
configure a política e os objetos de sincronização.
Parâmetro
Descrição
Sincronização inicial
selecione Initial Schema Synchronization. O DTS sincroniza os esquemas dos objetos selecionados para o projeto do DataHub de destino.
Objetos a serem sincronizados
Na seção Available, selecione as tabelas e clique em
 para movê-las para a seção Selected. Para renomear objetos sincronizados no destino, use o recurso de mapeamento de nome de objeto. Consulte Rename an object to be synchronized.
Ativar novas regras de nomenclatura para colunas adicionais
selecione Yes ou No. Antes de configure este parâmetro, verifique se os nomes das colunas adicionais entram em conflito com as colunas existentes no tópico de destino. Caso contrário, a tarefa de sincronização de dados poderá falhar ou os dados poderão ser perdidos. Consulte Naming rules for additional columns.
Renomear bancos de dados e tabelas
Use o recurso de mapeamento de nome de objeto para renomear objetos sincronizados no destino. Consulte Object name mapping.
Replicar tabelas temporárias quando o DMS executar operações DDL
Defina se o DTS sincroniza tabelas temporárias geradas por operações DDL online em DMS. Yes: o DTS sincroniza tabelas temporárias. Grandes operações DDL online podem aumentar a latência de sincronização. No: o DTS ignora tabelas temporárias e sincroniza apenas o DDL original da source. As tabelas de destino podem ser bloqueadas.
Tempo de nova tentativa para conexões com falha
Padrão: 720 minutos (12 horas). Se o DTS se reconectar dentro desse período, a sincronização será retomada. Caso contrário, a tarefa falhará. Há cobrança do DTS durante os períodos de nova tentativa. defina este valor com base nas suas necessidades de negócios e libere a instância caso as instâncias de source e de destino sejam liberadas.
(Opcional) Na seção Selected, passe o mouse sobre o nome de uma tabela e clique em Edit para configure uma chave de shard para o particionamento da tabela.
-
Clique em Precheck no canto inferior direito.
O DTS executa uma pré-verificação antes de iniciar a tarefa. A tarefa inicia apenas após a aprovação na pré-verificação. Se um item falhar na pré-verificação, clique em
 ícone ao lado do item com falha para visualize os detalhes. Corrija o problema e execute a pré-verificação novamente, ou ignore o item com falha e execute novamente se nenhuma correção for necessária.
Após a exibição da mensagem Precheck Passed, feche a caixa de diálogo Precheck. A tarefa inicia automaticamente.
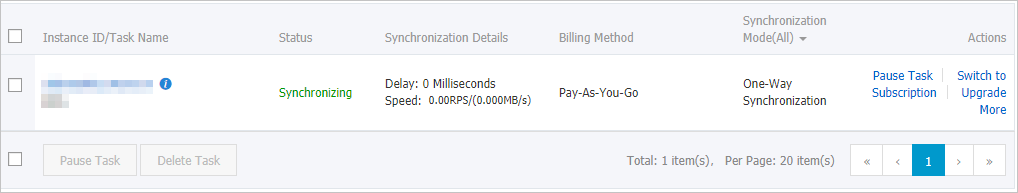
Aguarde a conclusão da sincronização inicial. O status da tarefa muda para Synchronizing. Verifique o status da tarefa na página Synchronization Tasks.
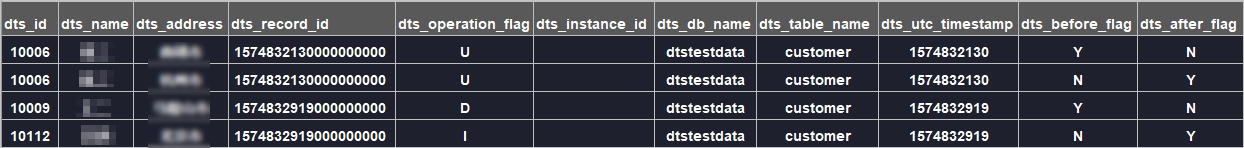
Esquema do tópico do DataHub
Quando o DTS sincroniza dados incrementais para um tópico do DataHub, ele adiciona colunas de metadados ao tópico.
Neste exemplo,id,nameeaddresssão campos de dados. Ao usar as regras de nomenclatura anteriores, o DTS adiciona o prefixodts_a todos os campos, incluindo os campos originais da source. Ao usar as novas regras de nomenclatura, o DTS não adiciona um prefixo aos campos originais da source.
|
Nome da coluna anterior |
Novo nome da coluna |
Tipo |
Descrição |
|
|
|
String |
ID exclusivo da entrada de log incremental. O valor incrementa automaticamente para cada nova entrada. Em cenários de recuperação de desastres, a reversão pode causar duplicação de ID. Para operações atualize, ambas as entradas de log (pré-atualização e pós-atualização) compartilham o mesmo |
|
|
|
String |
O tipo de operação. Valores válidos: |
|
|
|
String |
O ID do servidor do banco de dados. |
|
|
|
String |
O nome do banco de dados. |
|
|
|
String |
O nome da tabela. |
|
|
|
String |
O carimbo de data e hora da operação em UTC. Este também é o carimbo de data e hora do arquivo de log. |
|
|
|
String |
Indica se os valores da linha correspondem aos valores de pré-atualização. Valores válidos: |
|
|
|
String |
Indica se os valores da linha correspondem aos valores de pós-atualização. Valores válidos: |
Valores de sinalizador antes e depois
As colunas dts_before_flag e dts_after_flag indicam se uma linha no tópico representa o estado antes ou depois de uma alteração de dados.
|
Operação |
Entradas de log geradas |
dts_before_flag |
dts_after_flag |
Conteúdo da linha |
|
INSERT |
1 |
|
|
Os valores recém-inseridos. |
|
exclua |
1 |
|
|
Os valores excluídos. |
|
atualize (primeira entrada) |
2 (mesmo |
|
|
Valores de pré-atualização. |
|
atualize (segunda entrada) |
2 (mesmo |
|
|
Valores de pós-atualização. |
Operação INSERT
A entrada de log contém os valores recém-inseridos. dts_before_flag é N e dts_after_flag é Y.
Operação atualize
O DTS gera duas entradas de log com os mesmos valores de dts_record_id, dts_operation_flag e dts_utc_timestamp. A primeira entrada captura os valores de pré-atualização (dts_before_flag=Y, dts_after_flag=N). A segunda entrada captura os valores de pós-atualização (dts_before_flag=N, dts_after_flag=Y).

Operação exclua
A entrada de log contém os valores excluídos. dts_before_flag é Y e dts_after_flag é N.

Próximos passos
Com a tarefa de sincronização em execução, use o Alibaba Cloud Realtime Compute for Apache Flink para analisar os dados no projeto do DataHub. Para mais informações, consulte What is Alibaba Cloud Realtime Compute for Apache Flink?