O AnalyticDB for MySQL é um service de processamento analítico online (OLAP) em tempo real e alta concorrência desenvolvido pela Alibaba Cloud. Ele realiza análises e explorações multidimensionais de petabytes de dados com latência no nível de milissegundos. Use o Data Transmission Service (DTS) para sincronizar dados de um cluster PolarDB for MySQL para um cluster AnalyticDB for MySQL. Essa abordagem permite construir rapidamente sistemas internos de business intelligence (BI), plataformas de consulta interativa e aplicações de relatórios em tempo real.
Pré-requisitos
Um cluster de destino AnalyticDB for MySQL já foi criado. Para mais informações, consulte Create a cluster.
Verifique se o cluster de destino AnalyticDB for MySQL possui espaço de armazenamento suficiente.
O log binário está ativado no cluster de origem PolarDB for MySQL. Para mais informações, consulte Ativar log binário.
Limitações
Durante a inicialização completa dos dados, o DTS consome recursos de leitura e gravação dos bancos de dados de origem e destino, o que pode aumentar a carga do banco de dados. Quando os bancos apresentam baixo desempenho, especificações reduzidas ou cargas de trabalho pesadas (por exemplo, grande volume de instruções SQL lentas, tabelas sem chaves primárias ou deadlocks no banco de destino), a pressão sobre o banco pode aumentar ainda mais e tornar os services indisponíveis. Por isso, avalie o desempenho dos bancos de origem e destino antes de iniciar a sincronização de dados. Recomendamos executar a sincronização em horários de baixa demanda (por exemplo, quando a carga de CPU dos bancos de origem e destino estiver abaixo de 30%).
-
Não utilize ferramentas como gh-ost ou pt-online-schema-change para executar operações DDL online nos objetos a serem sincronizados no banco de origem durante a sincronização de dados. Caso contrário, a tarefa de sincronização falhará.
Devido a uma limitação de uso do AnalyticDB for MySQL, o cluster será bloqueado se o uso de disco de qualquer nó ultrapassar 80%. Antes de começar, estime o espaço de armazenamento necessário para os objetos a serem sincronizados e garanta que o cluster de destino tenha capacidade suficiente.
Índices de prefixo não podem ser sincronizados. Se o banco de dados de origem contiver índices de prefixo, a sincronização de dados poderá falhar.
A tarefa falhará caso o cluster de destino AnalyticDB for MySQL 3.0 esteja realizando backup enquanto a tarefa do DTS estiver em execução.
Faturamento
|
Tipo de sincronização |
Preço |
|
Sincronização de esquema e sincronização completa de dados |
Gratuito. |
|
Sincronização incremental de dados |
Pago. Para mais informações, consulte Billing overview. |
Operações SQL suportadas
Operações DDL: CREATE TABLE, DROP TABLE, RENAME TABLE, TRUNCATE TABLE, ADD COLUMN, DROP COLUMN e MODIFY COLUMN
Operações DML: INSERT, UPDATE e DELETE
Se o tipo de dados de um campo na tabela de origem for alterado durante a sincronização, a tarefa reportará um erro e será interrompida. É possível corrigir esse problema manualmente. Para mais informações, consulte Fix a synchronization failure caused by a data type change.
Permissões de conta de banco de dados
Banco de dados | Permissões necessárias |
PolarDB for MySQL | Permissões de leitura nos objetos a serem sincronizados. |
AnalyticDB for MySQL | Permissões de leitura e gravação. |
Para mais informações sobre como criar e autorizar uma conta de banco de dados, consulte Criar uma conta de banco de dados PolarDB for MySQL ou Criar uma conta de banco de dados para Cloud-native Data Warehouse AnalyticDB for MySQL.
Mapeamentos de tipos de dados
Para mais informações, consulte Data type mappings for initial schema synchronization.
Procedimento
-
Purchase a data synchronization task.
NotaAo adquirir a tarefa, defina Source Instance como Apsara PolarDB, Target Instance como AnalyticDB MySQL e Synchronization Topology como One-way synchronization.
-
Faça login no console do Data Transmission Service.
NotaCaso seja redirecionado automaticamente para o console do Data Management (DMS), clique em
 no canto inferior direito e depois clique em
 para retornar ao console clássico do DTS.
No painel de navegação à esquerda, clique em Data Synchronization.
-
Na barra de navegação superior da página Data Synchronization, selecione a região onde a instância de destino está localizada.
Localize a instância de sincronização de dados adquirida e clique em Configure Synchronization Channel.
-
Configure as instâncias de origem e destino para o canal de sincronização.
Seção
Parâmetro
Descrição
N/A
Nome da tarefa de sincronização
O DTS gera automaticamente um nome para a tarefa. Para facilitar a identificação, recomendamos usar um nome descritivo. O nome não precisa ser único.
Detalhes da instância de origem
Tipo de instância
Defina como PolarDB Instance. Este parâmetro não pode ser alterado.
Região da instância
Região da instância de origem selecionada durante a aquisição da tarefa. Este parâmetro não pode ser alterado.
ID da instância PolarDB
Selecione o ID do cluster de origem PolarDB for MySQL.
Conta do banco de dados
Insira a conta do banco de dados do cluster PolarDB for MySQL. Para informações sobre as permissões necessárias, consulte Database account permissions.
Senha do banco de dados
Insira a senha da conta do banco de dados.
Detalhes da instância de destino
Tipo de instância
Defina como ADS. Este parâmetro não pode ser alterado.
Região da instância
Região da instância de destino selecionada durante a aquisição da tarefa. Este parâmetro não pode ser alterado.
Versão
Selecione 3.0.
Banco de dados
Selecione o ID do cluster da instância de destino AnalyticDB for MySQL.
Conta do banco de dados
Insira a conta do banco de dados da instância AnalyticDB for MySQL. Para informações sobre as permissões necessárias, consulte Database account permissions.
Senha do banco de dados
Insira a senha da conta do banco de dados.
-
No canto inferior direito da página, clique em Set Whitelist and Next.
Se o banco de dados de origem ou destino for uma instância de banco de dados da Alibaba Cloud, como ApsaraDB RDS for MySQL ou ApsaraDB for MongoDB, o DTS adiciona automaticamente os blocos CIDR dos servidores DTS à lista de permissões de endereços IP da instância. Se o banco de origem ou destino for auto-gerenciado e hospedado em uma instância Elastic Compute Service (ECS), o DTS adiciona automaticamente os blocos CIDR dos servidores DTS às regras do grupo de segurança da instância ECS, e você deve garantir que a instância ECS possa acessar o banco de dados. Caso o banco auto-gerenciado esteja hospedado em várias instâncias ECS, adicione manualmente os blocos CIDR dos servidores DTS às regras do grupo de segurança de cada instância ECS. Se o banco de origem ou destino for auto-gerenciado, implantado em um data center ou fornecido por um provedor de cloud terceirizado, adicione manualmente os blocos CIDR dos servidores DTS à lista de permissões de endereços IP do banco para permitir o acesso do DTS. Para mais informações, consulte Whitelist DTS server IP addresses.
AvisoAdicionar os blocos CIDR de endereços IP públicos dos servidores DTS, seja automática ou manualmente, pode apresentar riscos de segurança. Ao utilizar este product, você reconhece e aceita esses riscos potenciais. Implemente proteções básicas de segurança, incluindo, mas não se limitando a: fortalecer a segurança de senhas, restringir portas abertas para blocos CIDR, usar autenticação para comunicação interna de API e revisar/restringir regularmente blocos CIDR desnecessários. Alternativamente, conecte-se ao banco de dados por meio de uma rede interna, como linha dedicada, VPN Gateway ou Smart Access Gateway.
-
Configure a política e os objetos de sincronização.
Parâmetro
Descrição
Inicialização da sincronização
Por padrão, tanto Initial schema synchronization quanto Initial full data synchronization vêm selecionados. Após a conclusão da pré-verificação, o DTS inicializa o esquema e os dados dos objetos sincronizados no cluster de destino. Esse processo cria uma linha de base para a subsequente sincronização incremental de dados.
Ação para tabelas existentes no destino
Precheck and report error: Verifica se existe uma tabela com o mesmo nome no banco de dados de destino. A verificação é aprovada caso não exista tal tabela. Se houver uma tabela com o mesmo nome, um erro será reportado durante a fase de pré-verificação e a tarefa de sincronização não iniciará.
NotaCaso não seja possível excluir ou renomear a tabela conflitante no banco de destino, mapeie a tabela para um novo nome no destino. Para mais informações, consulte Set object names in the destination instance.
Ignore Errors and Proceed: Ignora a verificação de tabelas com o mesmo nome no banco de dados de destino.
AvisoSelecionar Ignore Errors and Proceed pode causar inconsistências de dados e riscos operacionais. Por exemplo:
Se um registro no cluster de destino tiver a mesma chave primária de um registro de origem, o registro de destino será mantido e o registro de origem não será sincronizado.
Se os esquemas das tabelas forem diferentes, os dados podem não ser inicializados, apenas algumas colunas podem ser sincronizadas ou a tarefa pode falhar.
Mesclar múltiplas tabelas
Selecione Yes: O DTS adiciona a coluna
__dts_data_sourcea cada tabela para armazenar a fonte de dados e deixa de suportar a sincronização DDL.No: Opção padrão. A sincronização DDL é suportada.
NotaO recurso de mesclagem de tabelas é aplicado no nível da tarefa, não no nível da tabela. Se precisar mesclar algumas tabelas mas não outras, crie duas tarefas separadas de sincronização de dados.
Tipos de operação de sincronização
Selecione os tipos de operação a serem sincronizados. Para mais informações sobre as operações suportadas, consulte Supported SQL operations. Por padrão, todos os tipos de operação vêm selecionados.
Selecionar objetos de sincronização
Na caixa Available objects, clique em
 nos objetos que deseja sincronizar e, em seguida, clique em para movê-los para a caixa Selected objects.
É possível selecionar bancos de dados e tabelas como objetos de sincronização.
NotaAo selecionar um banco de dados inteiro, todas as operações de alteração de esquema para objetos dentro desse banco serão sincronizadas com o destino.
Ao selecionar uma tabela específica, apenas as operações
ADD COLUMNnessa tabela serão sincronizadas com o destino.Por padrão, os nomes dos objetos de sincronização permanecem inalterados. Caso precise alterar os nomes dos objetos no cluster de destino, utilize o recurso de mapeamento de nomes de objetos. Para mais informações, consulte Set object names in the destination instance.
Rename object mappings
Altere os nomes dos objetos sincronizados na instância de destino. Para mais informações, consulte Map databases, tables, and columns.
Replicate temporary tables during online DDL process in DMS
Se você usar Data Management (DMS) para realizar alterações DDL online no banco de dados de origem, poderá escolher se deseja sincronizar as tabelas temporárias geradas pelas alterações DDL.
-
Yes: Sincroniza as tabelas temporárias geradas pelas alterações DDL online.
NotaCaso uma grande quantidade de dados de tabelas temporárias seja gerada pelas alterações DDL online, a tarefa de sincronização de dados poderá sofrer atrasos.
-
No: Não sincroniza as tabelas temporárias geradas pelas alterações DDL online. Apenas as operações DDL originais do banco de dados de origem são sincronizadas.
NotaEsta opção faz com que as tabelas no banco de dados de destino sejam bloqueadas.
Connection retry timeout
Se o DTS não conseguir se conectar à instância de origem ou destino, ele tentará novamente por 720 minutos (12 horas) por padrão. Também é possível especificar uma duração personalizada de nova tentativa. Caso o DTS reconecte à instância de origem ou destino dentro do período especificado, a tarefa de sincronização será retomada automaticamente. Caso contrário, a tarefa falhará.
NotaO tempo de execução da tarefa durante as novas tentativas de conexão é cobrado. Personalize a duração da nova tentativa conforme suas necessidades comerciais ou libere a instância DTS assim que as instâncias de origem e destino forem liberadas.
Após concluir as configurações anteriores, clique em Next no canto inferior direito da página.
-
Defina os tipos das tabelas a serem sincronizadas no banco de dados de destino.
A tabela de configuração também inclui as colunas ADB Table Group, ADB Table Name, Number of Partitions e Definition Status. Ao passar o mouse sobre o nome de um banco de dados ou tabela, o DTS exibe o nome da tabela de origem.
NotaSe selecionar Initial Schema Synchronization, defina as tabelas a serem sincronizadas no AnalyticDB for MySQL, incluindo Type, key column primária e partition column. Para mais informações, consulte CREATE TABLE.
-
Após concluir as configurações anteriores, clique em Precheck and Start no canto inferior direito da página.
NotaAntes do início oficial da tarefa de sincronização, uma pré-verificação é executada. A tarefa só pode ser iniciada após a aprovação na pré-verificação.
-
Se a pré-verificação falhar, clique em
 ao lado de um item de verificação específico para visualizar os detalhes da falha.
Siga a instrução para corrigir o problema e execute a pré-verificação novamente.
Caso não precise corrigir os itens de verificação de aviso, selecione Ignore, Ignore Warning Items and Rerun Precheck para ignorar esses itens e executar a pré-verificação novamente.
Após a exibição de Precheck Passed na caixa de diálogo Precheck, feche a caixa. A tarefa de sincronização inicia automaticamente.
-
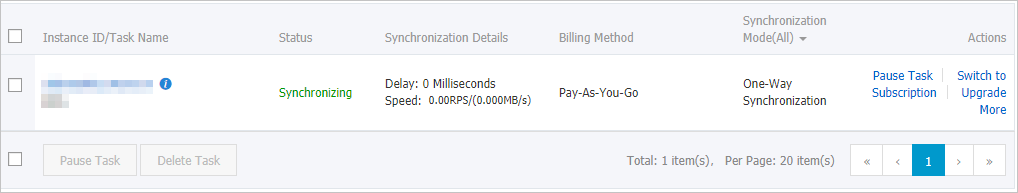
Aguarde até que o canal de sincronização seja inicializado e a tarefa entre no estado Synchronizing.
A página
Data Synchronization
exibe o status dos jobs de sincronização de dados.