Use o Data Transmission Service (DTS) para sincronizar dados incrementais em tempo real de um cluster PolarDB for MySQL para o DataHub. Em seguida, utilize produtos de big data, como o Realtime Compute for Apache Flink, para analisar os dados em tempo real.
Pré-requisitos
Crie um cluster PolarDB for MySQL de origem. Para mais informações, consulte Custom purchase e Purchase a subscription cluster.
Ative o DataHub e crie um projeto para receber os dados sincronizados. Para mais informações, consulte Get started with DataHub synchronization e Create and delete projects.
Ative o log binário do cluster PolarDB for MySQL. Para mais informações, consulte Enable binary logging.
Precauções
O DTS não sincroniza chaves estrangeiras do banco de dados de origem para o banco de dados de destino. Portanto, operações em cascata e de exclusão no banco de dados de origem não são sincronizadas com o banco de dados de destino.
Tipo | Descrição |
Limites do banco de dados de origem |
|
Outros limites |
|
Outras observações | O DTS executa periodicamente o comando CREATE DATABASE IF NOT EXISTS |
Faturamento
|
Tipo de sincronização |
Preço |
|
Sincronização de esquema e sincronização completa de dados |
Gratuito. |
|
Sincronização incremental de dados |
Pago. Para mais informações, consulte Billing overview. |
Topologias de sincronização suportadas
Sincronização unidirecional um-para-um.
Sincronização unidirecional um-para-muitos.
Sincronização unidirecional muitos-para-um.
Sincronização unidirecional em cascata.
Para mais informações sobre essas topologias de sincronização, consulte Synchronization topologies.
Operações SQL suportadas
Tipo de operação | Instrução SQL |
DML | INSERT, UPDATE, DELETE |
DDL | ADD COLUMN |
Permissões da conta do banco de dados
A conta do banco de dados para o cluster PolarDB for MySQL de origem requer pelo menos permissão de leitura nos objetos a serem sincronizados.
Procedimento
-
Acesse a página da lista de tarefas de sincronização da região de destino. Use um dos dois métodos a seguir:
Pelo console do DTS
Faça login no console do Data Transmission Service (DTS).
No painel de navegação à esquerda, clique em Data Synchronization.
No canto superior esquerdo da página, selecione a região onde a instância de sincronização está localizada.
Pelo console do DMS
NotaAs operações reais podem variar dependendo do modo e do layout do console do DMS. Para mais informações, consulte Simple mode e Customize the layout and style of the DMS interface.
Faça login no Data Management (DMS).
Na barra de menu superior, escolha .
À direita de Data Synchronization Tasks, selecione a região onde a instância de sincronização está localizada.
Clique em Create Task para abrir a página de configuração da tarefa.
-
Configure os bancos de dados de origem e de destino.
Categoria
Parâmetro
Descrição
N/A
Task Name
O DTS gera automaticamente um nome para a tarefa. Recomendamos especificar um nome descritivo para facilitar a identificação. O nome não precisa ser exclusivo.
Source Database
Select DMS Database Instance
Selecione uma instância existente conforme necessário.
-
Ao utilizar uma instância existente, as informações do banco de dados são preenchidas automaticamente. Não é necessário inseri-las novamente.
-
Se não for utilizar uma instância existente, insira as seguintes informações do banco de dados.
Database Type
Selecione PolarDB for MySQL.
Connection Type
Selecione Alibaba Cloud Instance.
Instance Region
Selecione a região onde o cluster PolarDB for MySQL de origem está localizado.
Cross-account
Neste cenário, os dados são sincronizados dentro da mesma conta Alibaba Cloud. Selecione No.
PolarDB Cluster ID
Selecione o ID do cluster PolarDB for MySQL de origem.
Database Account
Insira a conta do banco de dados para o cluster PolarDB for MySQL de origem. Para informações sobre as permissões necessárias, consulte Permissions required for a database account.
Database Password
Insira a senha correspondente à conta do banco de dados.
Encryption
Selecione uma opção de acordo com suas necessidades. Para mais informações, consulte Configure SSL encryption.
Destination Database
Select DMS Database Instance
Selecione uma instância existente conforme necessário.
-
Ao utilizar uma instância existente, as informações do banco de dados são preenchidas automaticamente. Não é necessário inseri-las novamente.
-
Se não for utilizar uma instância existente, insira as seguintes informações do banco de dados.
Database Type
Selecione DataHub.
Connection Type
Selecione Alibaba Cloud Instance.
Instance Region
Selecione a região onde a instância DataHub de destino está localizada.
Project
Selecione o projeto DataHub de destino.
-
-
Após concluir a configuração, clique em Test Connectivity and Proceed na parte inferior da página.
NotaCertifique-se de que os blocos CIDR de endereços IP dos servidores do DTS foram adicionados às configurações de segurança dos bancos de dados de origem e de destino para permitir o acesso desses servidores. Isso pode ser feito automática ou manualmente. Para mais informações, consulte Add the IP address CIDR blocks of DTS servers to a whitelist.
-
Configure os objetos da tarefa.
-
Na página Configure Objects, configure os objetos a serem sincronizados.
Parâmetro
Descrição
Synchronization Types
Incremental Data Synchronization está selecionado. Por padrão, você também deve selecionar Schema Synchronization e Full Data Synchronization. Após a conclusão da pré-verificação, o DTS realiza uma sincronização completa dos dados dos objetos selecionados da instância de origem para o cluster de destino. Isso serve como base para a subsequente sincronização incremental de dados.
Naming Rules of Additional Columns
Quando o DTS sincroniza dados com o DataHub, ele adiciona colunas extras ao tópico de destino. Se o nome de uma coluna extra entrar em conflito com o nome de uma coluna existente no tópico de destino, a tarefa de sincronização de dados falhará. Para evitar essa falha, defina a opção Enable new additional column rule como Yes ou No de acordo com suas necessidades comerciais.
AvisoAntes de selecionar uma regra de coluna adicional, avalie se os nomes das colunas adicionais entrarão em conflito com os nomes das colunas existentes no tópico de destino. Caso contrário, a tarefa pode falhar ou pode haver perda de dados. Para mais informações sobre as regras e definições de colunas adicionais, consulte Additional column names and definitions.
Processing Mode of Conflicting Tables
-
Precheck and Report Errors: Verifica se existe uma tabela com o mesmo nome no banco de dados de destino. Se não existir, a pré-verificação é aprovada. Se existir uma tabela com o mesmo nome, a pré-verificação falha e a tarefa de sincronização de dados não inicia.
NotaSe não for possível excluir ou renomear a tabela com o mesmo nome no banco de dados de destino, você poderá mapeá-la para um nome de tabela diferente. Para mais informações, consulte Map table and column names.
-
Ignore Errors and Proceed: Ignora a verificação de nomes de tabelas duplicados no banco de dados de destino.
AvisoSelecionar Ignore Errors and Proceed pode causar inconsistência de dados e colocar seus negócios em risco. Por exemplo:
-
Se os esquemas das tabelas forem iguais e um registro no banco de dados de destino tiver o mesmo valor de chave primária ou chave única que um registro no banco de dados de origem:
-
Durante a sincronização completa, o DTS mantém o registro no cluster de destino. O registro correspondente do banco de dados de origem não é sincronizado.
-
Durante a sincronização incremental, o registro do banco de dados de origem sobrescreve o registro no banco de dados de destino.
-
-
Se os esquemas das tabelas forem diferentes, a sincronização inicial de dados pode falhar. Isso pode resultar na sincronização apenas parcial dos dados das colunas ou em uma falha completa da sincronização. Prossiga com cautela.
-
Case Sensitivity Policy for Destination Object Names
Você pode configurar a política de diferenciação de maiúsculas e minúsculas para nomes de objetos de banco de dados, tabelas e colunas sincronizados com a instância de destino. Por padrão, a DTS default policy está selecionada. Você também pode optar por usar as políticas padrão dos bancos de dados de origem e de destino. Para mais informações, consulte Case sensitivity policy for destination object names.
Source Objects
Na caixa Source Objects, clique nos objetos a serem sincronizados e, em seguida, clique no ícone
 para movê-los para a caixa Selected Objects.Nota
É possível selecionar objetos para sincronização nos níveis de banco de dados e de tabela.
Selected Objects
-
Para renomear um único objeto de sincronização na instância de destino, clique com o botão direito do mouse no objeto na caixa Selected Objects. Para mais informações sobre como renomear objetos, consulte Map a single database, table, or column.
-
Para alterar em lote os nomes de vários objetos de sincronização na instância de destino, clique em Batch Edit no canto superior direito da caixa Selected Objects. Para mais informações, consulte Map databases, tables, and columns in a batch.
NotaPara selecionar operações SQL a serem sincronizadas no nível de banco de dados ou tabela, clique com o botão direito do mouse em um objeto na caixa Selected Objects e selecione as operações SQL desejadas na caixa de diálogo exibida. Para obter uma lista de operações suportadas, consulte Supported SQL operations.
Para filtrar dados usando uma cláusula WHERE, clique com o botão direito do mouse em uma tabela na caixa Selected Objects e defina as condições de filtro na caixa de diálogo exibida. Para mais informações, consulte Set filter conditions.
Se você selecionar objetos no nível de tabela, poderá clicar com o botão direito do mouse em uma tabela na caixa Selected Objects, desmarcar a caixa de seleção Sync All Columns e, em seguida, definir uma Shard Key, que é uma chave usada para particionamento.
-
-
Clique em Next: Advanced Settings para configurar parâmetros avançados.
Parâmetro
Descrição
Dedicated Cluster for Task Scheduling
Por padrão, o DTS agenda tarefas em um cluster compartilhado, e não é necessário selecionar um cluster. Para obter um desempenho mais estável, você pode adquirir um cluster dedicado para executar tarefas de sincronização do DTS. Para mais informações, consulte What is a DTS dedicated cluster?.
Retry Time for Failed Connections
Após o início de uma tarefa de sincronização, se a conexão com o banco de dados de origem ou de destino falhar, o DTS relatará um erro e iniciará imediatamente uma nova tentativa de conexão. A duração padrão de nova tentativa é de 720 minutos. Você também pode especificar uma duração personalizada de 10 a 1.440 minutos. Recomendamos definir a duração para 30 minutos ou mais. Se o DTS conseguir se reconectar ao banco de dados dentro da duração especificada, a tarefa de sincronização será retomada automaticamente. Caso contrário, a tarefa falhará.
Nota-
Se você tiver várias instâncias do DTS (por exemplo, Instância A e Instância B) que compartilham a mesma origem ou destino, e definir o tempo de nova tentativa de rede como 30 minutos para a Instância A e 60 minutos para a Instância B, a duração menor de 30 minutos será usada para ambas.
-
Como o DTS cobra pelo tempo de execução da tarefa durante o período de nova tentativa de conexão, recomendamos personalizar a duração da nova tentativa com base nas necessidades do seu negócio ou liberar a instância do DTS o mais rápido possível após a liberação das instâncias de banco de dados de origem e de destino.
Retry Time for Other Issues
Após o início da tarefa de sincronização, se ocorrerem outros problemas não relacionados à conectividade com o banco de dados de origem ou de destino (como exceções de execução DDL ou DML), o DTS relatará um erro e iniciará imediatamente operações contínuas de nova tentativa. A duração padrão de nova tentativa é de 10 minutos. Você também pode personalizar a duração da nova tentativa dentro do intervalo de 1 a 1.440 minutos. Recomendamos definir esse valor para 10 minutos ou mais. Se as operações relevantes forem bem-sucedidas dentro da duração de nova tentativa definida, a tarefa de sincronização será retomada automaticamente. Caso contrário, a tarefa falhará.
ImportanteO valor de Retry Time for Other Issues deve ser menor que o valor de Retry Time for Failed Connections.
Enable Throttling for Full Data Synchronization
Durante a fase de sincronização completa, o DTS consome recursos de leitura e gravação dos bancos de dados de origem e de destino, o que pode aumentar a carga do banco de dados. Para reduzir a carga nos bancos de dados de origem e de destino, você pode definir um limite de taxa para a tarefa de sincronização completa configurando os parâmetros Queries per second (QPS) to the source database, RPS of Full Data Migration e Data migration speed for full migration (MB/s).
Nota-
Este item de configuração está disponível apenas quando Synchronization Types estiver definido como Full Data Synchronization.
-
Você também pode adjust the full synchronization rate depois que a instância de sincronização estiver em execução.
Enable Throttling for Incremental Data Synchronization
Você também pode definir um limite de taxa para a tarefa de sincronização incremental. Para aliviar a pressão no banco de dados de destino, defina RPS of Incremental Data Synchronization e Data synchronization speed for incremental synchronization (MB/s).
Environment Tag
Você pode selecionar uma tag de ambiente para identificar a instância. Esta configuração é opcional.
Whether to delete SQL operations on heartbeat tables of forward and reverse tasks
Escolha se deseja gravar informações SQL de heartbeat no banco de dados de origem enquanto a instância do DTS estiver em execução.
-
Yes: As informações SQL de heartbeat não são gravadas no banco de dados de origem. Isso pode fazer com que a instância do DTS relate um atraso.
-
No: Grava informações SQL de heartbeat no banco de dados de origem. Isso pode interferir em recursos como backup físico e clonagem do banco de dados de origem.
Configure ETL
Escolha se deseja ativar o recurso de extração, transformação e carregamento (ETL). Para mais informações, consulte What is ETL? Valores válidos:
-
Yes: Ativa o recurso ETL. Insira instruções de processamento de dados no editor de código. Para mais informações, consulte Configure ETL in a data migration or data synchronization task.
-
No: Desativa o recurso ETL.
Monitoring and Alerting
Especifique se deseja configurar alertas. Se a sincronização falhar ou a latência exceder o limiar especificado, uma notificação será enviada a um contato de alerta.
-
No: Nenhum alerta é configurado.
-
Yes: Configure alertas definindo um limiar de alerta e especificando um notificação de alerta. Para mais informações, consulte Configure monitoring and alerting during task configuration.
-
-
-
Salve a tarefa e execute uma pré-verificação.
Para visualizar os parâmetros da API para configurar esta instância, passe o mouse sobre o botão Next: Save Task Settings and Precheck e clique em Preview OpenAPI parameters no balão exibido.
Se tiver terminado de visualizar os parâmetros da API, clique em Next: Save Task Settings and Precheck na parte inferior da página.
NotaAntes do início do trabalho de sincronização, o DTS executa uma pré-verificação. O trabalho só pode começar após a aprovação de todos os itens de pré-verificação.
Se a pré-verificação falhar, clique em View Details para o item com falha. Corrija o problema conforme instruído e execute a pré-verificação novamente.
-
Se a pré-verificação retornar um aviso:
Se um item de verificação falhar e não puder ser ignorado, clique em View Details ao lado do item. Siga as instruções para corrigir o problema e execute a pré-verificação novamente.
Para itens de verificação que podem ser ignorados, clique em Confirm Alert Details, Ignore, OK e Precheck Again em sequência para ignorar o aviso e executar a pré-verificação novamente. Se você optar por ignorar o item de aviso, isso poderá causar problemas como inconsistência de dados e representar riscos aos seus negócios.
-
Adquira a instância.
Quando a Success Rate for de 100%, clique em Next: Purchase Instance.
-
Na página Purchase, selecione o método de faturamento e a especificação de link para a instância de sincronização de dados. A tabela a seguir descreve esses parâmetros em detalhes.
Categoria
Parâmetro
Descrição
New Instance Class
Método de faturamento
-
Assinatura: O pagamento é feito no momento da criação da instância. É adequado para necessidades de longo prazo e mais econômico que o pagamento conforme o uso. Quanto maior a duração da assinatura, maior o desconto.
-
Pagamento conforme o uso: A cobrança é feita por hora. Adequado para necessidades de curto prazo. Você pode liberar a instância imediatamente após o uso para economizar custos.
Configuração do grupo de recursos
O grupo de recursos ao qual a instância pertence. O padrão é o grupo de recursos padrão. Para mais informações, consulte What is Resource Management?.
Especificação de link
O DTS fornece especificações de sincronização com diferentes níveis de desempenho. A especificação do link de sincronização afeta a taxa de sincronização. Você pode escolher uma especificação com base no seu cenário de negócios. Para mais informações, consulte Data synchronization link specifications.
Duração da assinatura
No modo de assinatura, selecione a duração e a quantidade para a instância de assinatura. Você pode escolher uma assinatura mensal de 1 a 9 meses ou uma assinatura anual de 1, 2, 3 ou 5 anos.
NotaEsta opção está disponível apenas quando o método de faturamento é Subscription.
-
Após concluir a configuração, leia e selecione Data Transmission Service (Pay-as-you-go) Service Terms.
-
Clique em Buy and Start. Na caixa de diálogo OK, clique em OK.
Você pode visualizar o progresso da tarefa na página Data Synchronization.
Esquema do tópico DataHub
Quando o DTS sincroniza dados incrementais com um tópico DataHub, ele adiciona colunas de metadados ao tópico.
Neste exemplo,id,nameeaddresssão campos de dados. Quando as regras de nomenclatura anteriores são usadas, o DTS adiciona o prefixodts_a todos os campos, incluindo os campos originais da origem. Quando as novas regras de nomenclatura são usadas, o DTS não adiciona um prefixo aos campos originais da origem.
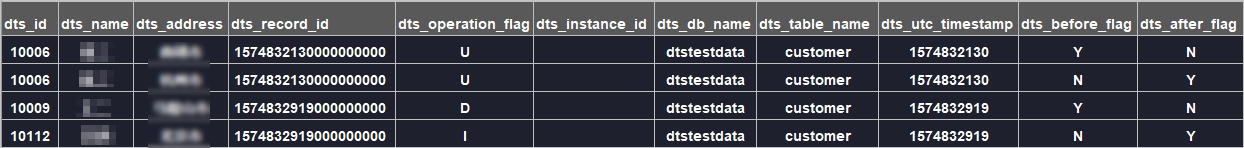
|
Nome da coluna anterior |
Novo nome da coluna |
Tipo |
Descrição |
|
|
|
String |
ID exclusivo da entrada de log incremental. Incrementa automaticamente para cada nova entrada. Em cenários de recuperação de desastres, o rollback pode causar duplicação de ID. Para operações UPDATE, ambas as entradas de log (pré-atualização e pós-atualização) compartilham o mesmo |
|
|
|
String |
O tipo de operação. Valores válidos: |
|
|
|
String |
O ID do servidor do banco de dados. |
|
|
|
String |
O nome do banco de dados. |
|
|
|
String |
O nome da tabela. |
|
|
|
String |
O timestamp da operação em UTC. Este também é o timestamp do arquivo de log. |
|
|
|
String |
Indica se os valores da linha são valores pré-atualização. Valores válidos: |
|
|
|
String |
Indica se os valores da linha são valores pós-atualização. Valores válidos: |
Valores de flag antes e depois
As colunas dts_before_flag e dts_after_flag indicam se uma linha no tópico representa o estado antes ou depois de uma alteração de dados.
|
Operação |
Entradas de log geradas |
dts_before_flag |
dts_after_flag |
Conteúdo da linha |
|
INSERT |
1 |
|
|
Os valores recém-inseridos. |
|
DELETE |
1 |
|
|
Os valores excluídos. |
|
UPDATE (primeira entrada) |
2 (mesmo |
|
|
Valores pré-atualização. |
|
UPDATE (segunda entrada) |
2 (mesmo |
|
|
Valores pós-atualização. |
Operação INSERT
A entrada de log contém os valores recém-inseridos. dts_before_flag é N e dts_after_flag é Y.
Operação UPDATE
O DTS gera duas entradas de log com os mesmos valores de dts_record_id, dts_operation_flag e dts_utc_timestamp. A primeira entrada captura os valores pré-atualização (dts_before_flag=Y, dts_after_flag=N). A segunda entrada captura os valores pós-atualização (dts_before_flag=N, dts_after_flag=Y).

Operação DELETE
A entrada de log contém os valores excluídos. dts_before_flag é Y e dts_after_flag é N.

Próximos passos
Depois que a tarefa de sincronização estiver em execução, use o Alibaba Cloud Realtime Compute for Apache Flink para analisar os dados no projeto DataHub. Para mais informações, consulte What is Alibaba Cloud Realtime Compute for Apache Flink?