Use o Data Transmission Service (DTS) para manter dois clusters do PolarDB for PostgreSQL (Compatible with Oracle) sincronizados em ambas as direções.
A sincronização bidirecional opera como um par de tarefas: uma tarefa direta (do cluster A para o cluster B) e uma tarefa reversa (do cluster B para o cluster A). O DTS evita loops de dados ao criar um schema dts em cada cluster de destino para rastrear a origem de cada gravação.
A sincronização bidirecional não garante ausência total de conflitos. Quando o mesmo registro é atualizado simultaneamente em ambos os clusters, o DTS aplica a política de resolução de conflitos configurada. Para minimizar conflitos, restrinja as gravações de registros com a mesma chave primária ou chave única a apenas um cluster por vez.
Faturamento
|
Tipo de sincronização |
Preço |
|
Sincronização de schema e sincronização completa de dados |
Gratuito |
|
Sincronização incremental de dados |
Pago. Consulte Billing overview. |
Pré-requisitos
Antes de começar, certifique-se de que:
Ambos os clusters do PolarDB for PostgreSQL (Compatible with Oracle) foram criados. Consulte Create a PolarDB for PostgreSQL (Compatible with Oracle) cluster.
O parâmetro
wal_levelestá definido comologicalem ambos os clusters. Isso adiciona as informações necessárias para replicação lógica ao write-ahead log (WAL). Consulte Set cluster parameters.O cluster de destino possui mais espaço de armazenamento do que o cluster de origem utiliza atualmente.
Limitações
Limites do banco de dados de origem
Largura de banda: O servidor que hospeda o cluster de origem deve ter largura de banda de saída suficiente. Largura de banda insuficiente reduz a velocidade de sincronização.
Tabelas sem chave primária ou chave única: Ative o recurso Exactly-Once write ao configurar a tarefa. Caso contrário, registros duplicados podem aparecer no destino. Consulte Synchronize tables without a primary key or UNIQUE constraint.
Seleção de objetos grandes com mapeamento de nomes: Se for necessário mapear nomes de tabelas ou colunas e a tarefa incluir mais de 1.000 tabelas, divida-as em várias tarefas ou sincronize todo o banco de dados. Enviar uma única tarefa que mapeie mais de 1.000 tabelas pode resultar em erro de solicitação.
-
Retenção de logs WAL: Se os logs WAL forem removidos antes que o DTS os leia, a tarefa falhará. Em casos extremos, pode ocorrer perda ou inconsistência de dados. Problemas causados por retenção insuficiente de WAL não são cobertos pelo SLA (Service-Level Agreement).
Apenas sincronização incremental: retenha logs WAL por mais de 24 horas.
Sincronização completa + incremental: retenha logs WAL por pelo menos 7 dias. Após a conclusão da sincronização completa, reduza o período de retenção para mais de 24 horas.
Transações de longa duração: O WAL gerado antes do commit de uma transação longa acumula-se durante a sincronização incremental. Isso pode esgotar o espaço em disco no cluster de origem.
Operações DDL durante a sincronização: Não execute operações DDL que alterem a estrutura do banco de dados ou da tabela durante a sincronização de schema ou a sincronização completa de dados. A tarefa falhará.
Gravações apenas durante a sincronização completa: Não grave novos dados no cluster de origem se apenas a sincronização completa de dados estiver selecionada. Para manter a consistência em tempo real, selecione também a sincronização de schema e a sincronização incremental de dados.
-
Failover de slot de replicação lógica: Para evitar que a replicação lógica seja interrompida durante um failover primário/secundário, o cluster de origem deve suportar e ter o Logical Replication Slot Failover ativado.
Se o cluster não suportar Failover de Slot de Replicação Lógica (por exemplo, se Database Engine for Oracle syntax compatible 2.0 ), um failover de alta disponibilidade (HA) pode fazer com que a instância de sincronização falhe e se torne irrecuperável.
Limite de tamanho de alteração única: Se uma única alteração incremental de dados exceder 256 MB, a instância de sincronização poderá falhar e não poderá ser recuperada. Será necessário reconfigurar a instância de sincronização.
Limites da sincronização bidirecional
Schema de prevenção de loops: O DTS cria um schema chamado
dtsem cada cluster de destino para evitar loops de dados. Não modifique esse schema enquanto a tarefa estiver em execução.Campos do tipo SERIAL: Se uma tabela tiver um campo do tipo SERIAL, o cluster de origem criará automaticamente uma sequence para esse campo. Se você selecionar Schema Synchronization em Synchronization Types, selecione também Sequence ou sincronize todo o schema. Caso contrário, a instância de sincronização poderá falhar.
Escopo de dados da tarefa: Em um par de sincronização bidirecional, apenas uma tarefa pode sincronizar dados completos e incrementais. A outra tarefa suporta apenas sincronização incremental.
Direção do fluxo de dados: Os dados da origem de uma tarefa são sincronizados apenas com o destino dessa mesma tarefa. Eles não são tratados como dados de origem para a outra tarefa.
Um banco de dados por tarefa: Cada tarefa de sincronização sincroniza um único banco de dados. Configure tarefas separadas para bancos de dados adicionais.
Objetos não suportados: O DTS não suporta tabelas da extensão TimescaleDB, tabelas com herança entre schemas ou tabelas com índices únicos baseados em expressões.
Schemas criados por plugins: Schemas criados pela instalação de plugins não podem ser sincronizados.
-
`REPLICA IDENTITY FULL` requirement: Execute
ALTER TABLE schema.table REPLICA IDENTITY FULL;nas tabelas do cluster de origem antes de gravar dados nelas nos seguintes cenários:Quando a instância de sincronização é executada pela primeira vez.
Quando você seleciona Schema como granularidade para seleção de objetos e uma nova tabela é criada ou uma tabela existente é reconstruída usando o comando
RENAME.Quando você usa o recurso para modificar objetos de sincronização.
Substitua
schemaetablepelos nomes reais do schema e da tabela. Execute este comando fora dos horários de pico. Não bloqueie as tabelas durante a execução — o bloqueio pode causar deadlocks. Se você ignorar os itens de pré-verificação relacionados, o DTS executará este comando automaticamente durante a inicialização da instância. Tabelas temporárias: O DTS cria as seguintes tabelas temporárias no cluster de origem para capturar instruções DDL, estrutura de tabela e informações de heartbeat. Não as exclua durante a sincronização — a tarefa falhará. O DTS as exclui automaticamente quando a instância é liberada:
public.dts_pg_class,public.dts_pg_attribute,public.dts_pg_type,public.dts_pg_enum,public.dts_postgres_heartbeat,public.dts_ddl_command,public.dts_args_sessionepublic.aliyun_dts_instance.Tabela de heartbeat: O DTS adiciona uma tabela de heartbeat chamada
dts_postgres_heartbeatao cluster de origem para manter precisão nas medições de latência incremental.-
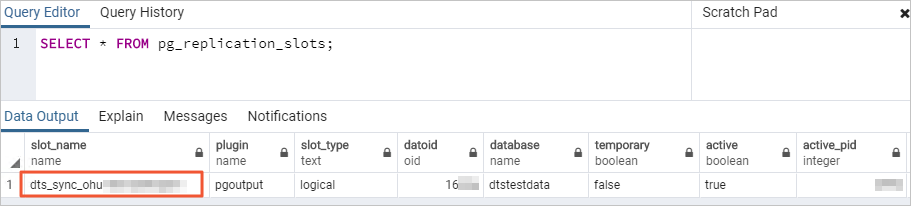
Slot de replicação: O DTS cria um slot de replicação com o prefixo
dts_sync_no cluster de origem. Esse slot fornece ao DTS acesso aos logs incrementais dos últimos 15 minutos. Quando a tarefa de sincronização falha ou a instância é liberada, o DTS tenta limpar o slot automaticamente.Se você alterar a senha da conta do banco de dados de origem ou remover o endereço IP do DTS da lista de permissões do cluster de origem durante a sincronização, o slot não poderá ser limpo automaticamente. Limpe-o manualmente para evitar que o WAL acumulado preencha o disco e torne o cluster de origem indisponível. Se ocorrer um failover, faça login no cluster secundário para limpar o slot manualmente.
Horário de sincronização: Sincronize os dados fora dos horários de pico, quando a carga de cpu em ambos os clusters estiver abaixo de 30%. A sincronização completa de dados executa operações INSERT concorrentes, o que aumenta a carga em ambos os clusters e causa fragmentação de tabela no destino. O espaço da tabela de destino pode ficar maior que o da origem após a conclusão da sincronização completa.
Verificações de restrição durante a sincronização: Durante a sincronização de schema, o DTS sincroniza chaves estrangeiras da origem para o destino. Durante a sincronização completa e incremental, o DTS desativa temporariamente as verificações de restrição e as operações em cascata de chave estrangeira no nível da sessão. Se ocorrerem operações de atualização ou exclusão em cascata na origem enquanto a tarefa estiver em execução, poderá haver inconsistência de dados.
Precisão FLOAT e DOUBLE: O DTS lê valores FLOAT e DOUBLE usando
ROUND(COLUMN, PRECISION). Se a precisão não for definida explicitamente, o DTS usará 38 para FLOAT e 308 para DOUBLE como padrão. Confirme se esses padrões atendem aos seus requisitos.Recuperação de tarefa e proteção contra gravação: O DTS tenta recuperar automaticamente tarefas com falha por até 7 dias. Antes de transferir sua carga de trabalho para o cluster de destino, encerre ou libere a tarefa, ou use
REVOKEpara revogar as permissões de gravação da conta de banco de dados do DTS no destino. Isso evita que os dados de origem sobrescrevam os dados de destino caso a tarefa seja recuperada.Chaves estrangeiras, triggers e event triggers: O DTS define
session_replication_rolecomoreplicano nível da sessão se a conta de destino for uma conta privilegiada ou tiver permissões de superusuário. Se a conta não tiver essas permissões, definasession_replication_rolecomoreplicamanualmente no destino. Durante esse período, operações de atualização ou exclusão em cascata na origem podem causar inconsistência de dados. Após a liberação da tarefa, alteresession_replication_rolede volta paraorigin.Recuperação pelo suporte do DTS: Se uma tarefa falhar, a equipe de suporte do DTS tentará restaurá-la em até 8 horas e poderá reiniciar a tarefa ou ajustar parâmetros da tarefa (não parâmetros do banco de dados). Os parâmetros que podem ser ajustados estão listados em Modify instance parameters.
Tabelas particionadas: Inclua tanto a tabela pai quanto todas as partições filhas como objetos de sincronização. A tabela pai de uma tabela particionada não armazena dados diretamente — todos os dados estão nas partições filhas. A ausência da tabela pai ou de uma partição filha pode causar inconsistência de dados.
Detecção de conflitos suportada
O DTS detecta os seguintes tipos de conflito durante a sincronização bidirecional. Devido a diferenças de horário e latência, a prevenção de conflitos não é garantida. Para manter a consistência, atualize registros com a mesma chave primária ou chave única em apenas um cluster por vez.
|
Tipo de conflito |
Condição de acionamento |
Comportamento do DTS |
|
Conflito de inserção |
Registros com a mesma chave primária são inseridos em ambos os clusters simultaneamente |
Aplica a política de resolução de conflitos configurada |
|
Atualização: registro ausente |
O registro a ser atualizado não existe no destino |
Converte o UPDATE em INSERT e aplica a política de resolução de conflitos se houver conflito de chave |
|
Atualização: conflito de chave |
O valor atualizado causa conflito de chave primária ou chave única no destino |
Aplica a política de resolução de conflitos configurada |
|
Exclusão: registro ausente |
O registro a ser excluído não existe no destino |
Ignora o DELETE independentemente da política de resolução de conflitos |
Políticas de resolução de conflitos:
|
Política |
Comportamento |
|
TaskFailed |
A tarefa para e entra em estado de falha. É necessária intervenção manual para retomar. |
|
Ignore |
O DTS ignora a instrução conflitante. O registro existente no destino é mantido. |
|
Overwrite |
O DTS sobrescreve o registro conflitante no destino com os dados da origem. |
Se a tarefa for pausada ou reiniciada e houver atraso, as políticas de resolução de conflitos não entrarão em vigor. Nesse caso, o DTS sobrescreverá os dados de destino por padrão.
Objetos suportados
SCHEMA, TABLE (inclui PRIMARY KEY, UNIQUE KEY, FOREIGN KEY, tipos de dados internos e DEFAULT CONSTRAINT)
VIEW e PROCEDURE (PostgreSQL 11 e posterior): o suporte varia conforme o tipo de banco de dados de destino. Verifique no console o que está disponível.
Operações SQL suportadas
|
Tipo de operação |
Instruções suportadas |
|
DML (Data Manipulation Language) |
INSERT, UPDATE, DELETE |
|
DDL (Data Definition Language) |
CREATE TABLE, DROP TABLE; ALTER TABLE (RENAME TABLE, ADD COLUMN, ADD COLUMN DEFAULT, ALTER COLUMN TYPE, DROP COLUMN, ADD CONSTRAINT, ADD CONSTRAINT CHECK, ALTER COLUMN DROP DEFAULT); CREATE INDEX ON TABLE |
Restrições de sincronização DDL: As instruções DDL não são sincronizadas nos seguintes casos:
A instrução DDL inclui cláusulas adicionais como CASCADE ou RESTRICT.
Uma transação contém instruções DML e DDL simultaneamente.
Apenas parte das instruções DDL de uma transação está incluída na tarefa de sincronização.
A instrução DDL é executada a partir de uma sessão criada por
SET session_replication_role = replica.A instrução DDL é executada chamando uma FUNCTION ou método similar.
A instrução DDL não especifica um schema (nesse caso, o schema
publicé implícito viaSHOW search_path).A instrução DDL contém
IF NOT EXISTS.
Apenas tarefas diretas suportam sincronização DDL. Tarefas reversas filtram automaticamente todas as operações DDL.
Permissões da conta do banco de dados
|
Banco de dados |
Permissões necessárias |
Como criar e autorizar |
|
Cluster de origem PolarDB for PostgreSQL (Compatible with Oracle) |
Uma conta privilegiada proprietária do banco de dados |
|
|
Cluster de destino PolarDB for PostgreSQL (Compatible with Oracle) |
Uma conta privilegiada proprietária do banco de dados |
Igual ao anterior |
Configurar sincronização bidirecional
A sincronização bidirecional é configurada em duas etapas: primeiro a tarefa direta (origem para destino), depois a tarefa reversa (destino para origem). A tarefa reversa fica disponível após a tarefa direta atingir o status Running.
Etapa 1: Abrir a lista de tarefas de sincronização
Acesse a lista de tarefas de sincronização de uma das duas maneiras abaixo.
Console do DTS
Faça login no console do DTS.
No painel de navegação à esquerda, clique em Data Synchronization.
No canto superior esquerdo, selecione a região onde a instância de sincronização está localizada.
Console do DMS
As etapas podem variar dependendo do modo e layout do console do DMS. Consulte Simple mode console e Customize the layout and style of the DMS console .
Faça login no console do DMS.
Na barra de menu superior, escolha Data + AI > DTS (DTS) > Data Synchronization.
À direita de Data Synchronization Tasks, selecione a região da instância de sincronização.
Etapa 2: Criar a tarefa direta
Clique em Create Task.
-
Configure os bancos de dados de origem e de destino.
Categoria Parâmetro Descrição — Task Name O DTS gera um nome automaticamente. Especifique um nome descritivo para facilitar a identificação. O nome não precisa ser único. Source Database Select Existing Connection Selecione uma registered database instance na lista para preencher automaticamente os campos abaixo. No console do DMS, este parâmetro é Select a DMS database instance. Se você não registrou a instância, preencha os campos manualmente. Database Type Selecione PolarDB (Compatible with Oracle). Access Method Selecione Alibaba Cloud Instance. Instance Region Selecione a região onde o cluster de origem reside. Replicate Data Across Alibaba Cloud Accounts Selecione No para sincronização na mesma conta. Instance ID Selecione o ID do cluster de origem. Database Name Insira o nome do banco de dados de origem. Database Account Insira a conta do banco de dados. Consulte Database account permissions. Database Password Insira a senha da conta. Destination Database Select Existing Connection Igual à origem: selecione uma instância registrada ou preencha manualmente. No console do DMS, isso é Select a DMS database instance. Database Type Selecione PolarDB (Compatible with Oracle). Connection Type Selecione Alibaba Cloud Instance. Instance Region Selecione a região onde o cluster de destino reside. Instance ID Selecione o ID do cluster de destino. Database Name Insira o nome do banco de dados de destino. Database Account Insira a conta do banco de dados. Consulte Database account permissions. Database Password Insira a senha da conta. -
Clique em Test Connectivity and Proceed.
Adicione os blocos CIDR do servidor DTS às configurações de segurança de ambos os clusters para permitir o acesso do DTS. Consulte Add the IP address whitelist of DTS servers . Se a origem ou o destino usar um método de acesso autogerenciado (não Alibaba Cloud Instance ), clique também em Test Connectivity na caixa de diálogo CIDR Blocks of DTS Servers .
-
Na página Configure Objects, defina os seguintes parâmetros.
Parâmetro Descrição Synchronization Types Selecione Schema Synchronization, Full Data Synchronization e Incremental Data Synchronization. O DTS sincroniza os dados históricos primeiro e depois muda para a sincronização incremental. Processing mode of conflicting tables Precheck and Report Errors: verifica se há tabelas com o mesmo nome no destino. A tarefa não inicia se alguma for encontrada. Para prosseguir, renomeie a tabela conflitante no destino ou use o mapeamento de nomes de objetos. Consulte Database Table Column Name Mapping. Ignore Errors and Proceed: ignora a verificação. Durante a sincronização completa, o DTS mantém o registro de destino e ignora o registro de origem quando há conflito de chaves. Durante a sincronização incremental, o DTS sobrescreve o registro de destino. Se os schemas das tabelas forem diferentes, a inicialização poderá falhar. Use com cautela. Synchronization Topology Selecione Two-way Synchronization. Exclude DDL Operations Selecione Yes para ignorar a sincronização DDL na tarefa direta. Selecione No para incluí-la. Tarefas reversas sempre filtram DDL independentemente desta configuração. Conflict Resolution Policy Selecione como o DTS lida com conflitos. Consulte Supported conflict detection para detalhes sobre cada política. Capitalization of Object Names in Destination Instance Configure a política de maiúsculas/minúsculas para nomes de bancos de dados, tabelas e colunas. O padrão é DTS default policy. Consulte Case policy for destination object names. Source Objects Clique nos objetos na caixa Source Objects e, em seguida, clique no ícone de seta para movê-los para Selected Objects. Selecione no nível de schema ou tabela. Selecionar tabelas não inclui views, triggers ou stored procedures. Se as tabelas contiverem tipos de dados SERIAL e Schema Synchronization estiver selecionado, selecione também Sequence ou escolha a sincronização de todo o schema. Selected Objects Para renomear um único objeto no destino, clique com o botão direito nele e siga Map a single object name. Para renomear vários objetos em lote, clique em Batch Edit e siga Map multiple object names in bulk. Para selecionar operações SQL específicas ou definir um filtro WHERE para uma tabela, clique com o botão direito na tabela. Consulte Set a filter condition. O mapeamento de nomes de objetos pode impedir que objetos dependentes sejam sincronizados corretamente. -
Clique em Next: Advanced Settings e configure o seguinte.
Parâmetro Descrição Dedicated Cluster for Task Scheduling O DTS usa um cluster compartilhado por padrão. Para maior estabilidade, adquira um cluster dedicado. Consulte What is a DTS dedicated cluster?. Retry Time for Failed Connections Duração durante a qual o DTS tenta novamente após uma falha de conexão. Padrão: 720 minutos. Intervalo: 10–1.440 minutos. Recomendado: 30 minutos ou mais. Se a conexão for recuperada dentro da janela de nova tentativa, a tarefa será retomada automaticamente. NotaQuando várias instâncias do DTS compartilham uma origem ou destino, o DTS usa a menor duração de nova tentativa configurada entre todas as instâncias. O DTS cobra pelo tempo de execução durante as novas tentativas.
Retry Time for Other Issues Duração durante a qual o DTS tenta novamente após erros que não são de conexão (como falhas na execução de DDL ou DML). Padrão: 10 minutos. Intervalo: 1–1.440 minutos. Recomendado: 10 minutos ou mais. Este valor deve ser menor que Retry Time for Failed Connections. Enable Throttling for Full Data Migration Limite a taxa de sincronização completa para reduzir a carga no destino. Defina QPS to the source database, RPS of Full Data Migration e Data migration speed (MB/s). Disponível apenas quando Full Data Synchronization estiver selecionado. Você também pode adjust the rate after the task starts. Enable Throttling for Incremental Data Synchronization Limite a taxa de sincronização incremental. Defina RPS of Incremental Data Synchronization e Data synchronization speed (MB/s). Environment Tag Adicione uma tag à instância para identificar seu ambiente. Opcional. Configure ETL Ative o recurso de extração, transformação e carregamento (ETL) para transformar dados em trânsito. Consulte What is ETL? e Configure ETL. Monitoring and Alerting Configure alertas para falhas de tarefa ou latência que exceda um limiar. Consulte Configure monitoring and alerting. Clique em Next: Data Validation para configurar opcionalmente uma tarefa de validação de dados. Consulte Configure data validation.
-
Salve a tarefa e execute a pré-verificação.
Para visualizar os parâmetros da API para esta configuração, passe o mouse sobre Next: Data Verification e clique em Preview OpenAPI parameters.
Clique em Next: Data Verification.
O DTS executa uma pré-verificação antes de iniciar a tarefa. A tarefa só inicia se a pré-verificação for aprovada. Se falhar, clique em View Details ao lado do item com falha, corrija o problema e execute a pré-verificação novamente. Para avisos não ignoráveis, corrija o problema antes de prosseguir. Para avisos ignoráveis, clique em Confirm Alert Details > Ignore > OK e, em seguida, clique em Precheck Again .
-
Adquira a instância de sincronização. A tarefa direta aparece na página de sincronização de dados.
Quando a Success Rate atingir 100%, clique em Next: Purchase Instance.
-
Selecione o método de faturamento e as especificações da instância.
Parâmetro
Descrição
Billing Method
Subscription: pagamento antecipado por uma duração fixa. Opções mensais: 1–9 meses. Opções anuais: 1, 2, 3 ou 5 anos. Custo-benefício para tarefas de longa duração. Pay-as-you-go: faturamento horário pelo uso real. Adequado para tarefas de curto prazo ou de teste.
Resource Group Settings
O grupo de recursos para a instância. O padrão é default resource group. Consulte What is Resource Management?.
Instance Class
Determina o desempenho da sincronização. Consulte Data synchronization link specifications.
Marque a caixa de seleção Data Transmission Service (Pay-as-you-go) Service Terms.
Clique em Purchase and Start e, em seguida, clique em OK na caixa de diálogo de confirmação.
Se tanto Full Data Synchronization quanto Incremental Data Synchronization estiverem selecionados, a tarefa será listada como uma única tarefa de Incremental Data Synchronization na página da lista de tarefas.
Etapa 3: Configurar a tarefa reversa
Após a tarefa direta estar em execução, configure a tarefa reversa para concluir a configuração bidirecional.
Aguarde até que o Status da tarefa direta seja Running.
Na coluna Actions da tarefa reversa, clique em Configure Task.
-
Configure a tarefa reversa usando as mesmas etapas da tarefa direta (etapas 2–7 acima). A tarefa reversa inverte a origem e o destino — as principais diferenças são mostradas abaixo.
ImportanteConfirme se as informações da instância (nome do banco de dados, conta e senha) estão corretas para cada direção. A origem e o destino são invertidos na tarefa reversa.
Parâmetro
Tarefa direta
Tarefa reversa
Source database
Cluster A (origem original)
Cluster B (destino original)
Destination database
Cluster B (destino original)
Cluster A (origem original)
DDL synchronization
Configurável via Exclude DDL Operations
Sempre filtrado automaticamente
Processing mode of conflicting tables
Verifica conflitos com todas as tabelas de destino
Não verifica tabelas sincronizadas pela tarefa direta
Synchronization objects
Sua seleção
Deve estar dentro dos Selected Objects da tarefa direta
Instance Region
Configurável
Fixo — não pode ser modificado
Object name mapping
Suportado
Evite — pode causar inconsistência de dados
Quando a Success Rate atingir 100%, clique em Back.
Aguarde até que o Status de ambas as tarefas seja Running. A sincronização bidirecional de dados agora está ativa.