O Data Transmission Service (DTS) migra dados de um banco de dados PostgreSQL auto-gerenciado para uma instância do AnalyticDB for PostgreSQL com tempo de inatividade mínimo. Combine a migração de esquema, a migração de dados completa e a migração de dados incrementais para manter o banco de dados source online durante todo o processo.
Pré-requisitos
Antes de começar, certifique-se de ter:
Uma instância de destino do AnalyticDB for PostgreSQL. Consulte crie uma instância
Espaço livre em disco na instância de destino que exceda o espaço em disco ocupado pelo banco de dados source
Ter revisado as versões suportadas dos bancos de dados source e destino. Consulte Visão geral dos cenários de migração de dados
Tipos de migração
O DTS oferece suporte a três tipos de migração. Utilize-os em conjunto para realizar uma migração ao vivo sem tempo de inatividade.
|
Tipo de migração |
O que faz |
|
Schema migration |
Copia os esquemas dos objetos selecionados para o destino. O DTS também migra chaves estrangeiras do source. |
|
Full data migration |
Copia todos os dados existentes para o destino. |
|
Incremental data migration |
Replica continuamente as alterações do source após a conclusão da migração completa, permitindo que suas aplicações continuem em execução sem interrupções. |
A migração de esquema e a migração de dados completa são gratuitas. A migração de dados incrementais é cobrada. Para a migração de esquema e a migração de dados completa, o tráfego de Internet é cobrado quando o Access Method de destino está definido como Public IP Address . Para obter detalhes sobre faturamento, consulte Visão geral do faturamento .
Limitações
Revise estas limitações e configure sua tarefa de migração.
Requisitos do banco de dados source
O servidor source deve ter largura de banda de saída suficiente. Uma largura de banda baixa reduz a velocidade da migração.
As tabelas devem ter restrições PRIMARY KEY ou UNIQUE, e todos os campos devem ser exclusivos. Tabelas sem essas restrições podem gerar registros duplicados no destino.
O nome do banco de dados source não pode conter hifens (
-). Por exemplo,dts-testdatanão é um nome válido.Se você selecione tabelas como objetos de migração e precisar renomear tabelas ou colunas no destino, uma única tarefa de migração suporta no máximo 1.000 tabelas. Para migrações maiores, divida-as em várias tarefas ou migre no nível do banco de dados.
A migração incremental exige que o parâmetro
wal_levelesteja definido comologicalno banco de dados source.-
Retenção de write-ahead log (WAL):
Apenas migração de dados incrementais: retenha os logs do WAL por mais de 24 horas.
Migração de dados completa + migração de dados incrementais: retenha os logs do WAL por pelo menos 7 dias.
Após a conclusão da migração completa, você pode reduzir o período de retenção para mais de 24 horas. Uma retenção insuficiente pode fazer com que o DTS não consiga ler os logs do WAL, resultando em falha na tarefa ou perda de dados.
-
Durante a migração, evite as seguintes operações no banco de dados source:
Um switchover entre primário e secundário — isso causa falha na tarefa de migração.
Operações DDL durante a migração de dados completa — isso causa falha na tarefa de migração.
Gravação de dados no source durante uma migração apenas completa — isso causa inconsistência de dados. Para evitar esse risco, inclua a migração de dados incrementais em sua tarefa.
Transações de longa duração com write-ahead logs abertos podem se acumular e exaurir o espaço em disco no source enquanto a migração incremental está em execução.
Requisitos do banco de dados de destino
Durante a migração de dados completa e a migração de dados incrementais, o DTS desativa temporariamente as verificações de restrições e as operações em cascata em chaves estrangeiras no nível da sessão. Se você execute operações de atualização ou exclusão em cascata no banco de dados source durante a migração, pode ocorrer inconsistência de dados.
A tabela de destino não pode ser uma tabela otimizada para anexação (AO).
O DTS não migra os seguintes tipos de objeto: DATATYPE, SEQUENCE, INDEX, PROCEDURE, FUNCTION, VIEW, OPERATOR, DEFAULT_CONSTRAINT, UK, PK, RULE, DOMAIN, AGGREGATE, EXTENSION, FK e TRIGGER.
Se você usar o mapeamento de colunas para a migração parcial de tabelas, os dados nas colunas source que não tiverem uma coluna de destino correspondente serão perdidos.
Para tabelas com chave primária: as colunas de chave primária no destino devem corresponder às do source.
Para tabelas sem chave primária: a coluna de chave primária e a chave de distribuição no destino devem ser iguais.
Uma chave exclusiva no destino deve conter todas as colunas de sua chave de distribuição (incluindo colunas de chave primária).
O DTS não oferece suporte à migração de tabelas de extensão do TimescaleDB ou tabelas com relacionamentos de herança entre esquemas.
O DTS não oferece suporte à migração de tabelas particionadas, a menos que você inclua tanto a tabela pai quanto todas as tabelas filhas como objetos de migração. A tabela pai não armazena dados — todos os dados estão nas tabelas filhas.
Comportamento da migração incremental
REPLICA IDENTITY e replicação de UPDATE/DELETE
O PostgreSQL usa o REPLICA IDENTITY para controlar a quantidade de dados de colunas gravados nos registros do WAL para eventos de UPDATE e DELETE. A configuração padrão (DEFAULT) inclui apenas colunas de chave primária nesses registros. Quando o DTS replica operações de UPDATE ou DELETE, ele precisa dos valores anteriores de todas as colunas para identificar e aplicar as alterações corretamente no destino. Sem a identidade FULL, o DTS não consegue replicar de forma confiável os eventos de UPDATE ou DELETE, o que pode levar à inconsistência de dados.
Se a sua tarefa de migração incluir a migração de dados incrementais, execute o seguinte comando em cada tabela a ser migrada antes de gravar dados nela. Isso define o REPLICA IDENTITY como FULL, que registra todos os valores das colunas para eventos de UPDATE e DELETE:
sudo make
sudo make install
Substitua schema e table pelo nome real do esquema e da tabela. Execute este comando fora dos horários de pico e evite o bloqueio da tabela durante a execução.
Execute este comando nas seguintes situações:
Quando a instância do DTS for iniciada pela primeira vez.
Quando a granularidade do objeto de migração for Schema e você crie uma nova tabela ou reconstruir uma tabela usando o comando RENAME no esquema que está sendo migrado.
Se você ignorar o item de pré-verificação relacionado, o DTS executará automaticamente este comando durante a inicialização da instância.
Tabelas temporárias e slots de replicação
O DTS cria as seguintes tabelas temporárias no banco de dados source. Não as exclua durante a migração — a tarefa pode falhar se elas forem removidas. O DTS as exclui automaticamente após a liberação da instância.
public.dts_pg_class, public.dts_pg_attribute, public.dts_pg_type, public.dts_pg_enum, public.dts_postgres_heartbeat, public.dts_ddl_command, public.dts_args_session, public.aliyun_dts_instance
A tabela dts_postgres_heartbeat é uma tabela de heartbeat que o DTS usa para garantir a precisão da latência da migração incremental.
O DTS também cria um slot de replicação com o prefixo dts_sync_ e limpa seus dados históricos a cada 90 minutos para reduzir o uso de armazenamento. Se a tarefa de migração for liberada ou falhar, o DTS limpará automaticamente o slot de replicação. Se um switchover entre primário e secundário for executado em uma instância do ApsaraDB RDS for PostgreSQL, faça logon no banco de dados secundário e limpe o slot de replicação manualmente.
Outras observações sobre a migração incremental
Para usar uma tarefa de migração de dados criada antes de 12 de maio de 2023 para migrar operações DDL, você deve crie um gatilho e uma função no banco de dados source para capturar informações de DDL antes de configure a tarefa de migração de dados. Para mais informações, consulte Usar gatilhos e funções para implementar a migração incremental de DDL para bancos de dados PostgreSQL.
A migração de dados incrementais não oferece suporte a colunas do tipo de dados BIT.
Quando o DTS grava instruções UPDATE na instância de destino do AnalyticDB for PostgreSQL, ele as converte automaticamente para REPLACE INTO. Se o UPDATE tiver como alvo colunas de chave primária, o DTS o converte para DELETE + INSERT.
O DTS oferece suporte à replicação de DDL apenas para tarefas criadas após 1º de outubro de 2020. Para tarefas criadas antes de 12 de maio de 2023, crie um gatilho e uma função no banco de dados source para capturar o DDL antes de configure a tarefa. Consulte Usar gatilhos e funções para implementar a migração incremental de DDL para bancos de dados PostgreSQL.
-
A conta do banco de dados usada para a migração incremental deve ter permissões de superusuário para replicar DDL. Operações DDL suportadas:
CREATE TABLE, DROP TABLE
ALTER TABLE: RENAME TABLE, ADD COLUMN, ADD COLUMN DEFAULT, ALTER COLUMN TYPE, DROP COLUMN, ADD CONSTRAINT, ADD CONSTRAINT CHECK, ALTER COLUMN DROP DEFAULT
TRUNCATE TABLE (requer PostgreSQL V11 ou posterior no source)
CREATE INDEX ON TABLE
O DTS não replica: DDL com CASCADE ou RESTRICT, DDL de sessões executando
SET session_replication_role = replica, DDL executado por meio de chamadas de função, CREATE SEQUENCE ou lotes que misturam DML e DDL.
Outras observações
Uma tarefa de migração abrange um banco de dados. crie uma tarefa separada para cada banco de dados adicional.
Antes de migrar os dados, avalie o impacto no desempenho dos bancos de dados source e destino. Recomendamos que você migre os dados fora dos horários de pico. Durante a migração de dados completa, o DTS usa os recursos de leitura e gravação de ambos os bancos de dados, o que pode aumentar a carga nos servidores de banco de dados.
A migração de dados completa usa operações INSERT simultâneas, o que causa fragmentação nas tabelas de destino. Após a migração, o tablespace de destino será maior que o de source.
O DTS usa
ROUND(COLUMN, PRECISION)para ler colunas FLOAT e DOUBLE. Precisão padrão: 38 dígitos para FLOAT, 308 dígitos para DOUBLE. Verifique se isso atende aos seus requisitos de precisão antes de migrar.O DTS tenta retomar tarefas com falha por até 7 days. Antes de alternar as cargas de trabalho para o destino, pare ou libere quaisquer tarefas com falha, ou execute REVOKE para remover as permissões de gravação do DTS no destino. Se uma tarefa com falha for retomada após a alternância, ela sobrescreverá os dados no destino.
O DTS não valida metadados de sequência. Verifique a validade da sequência manualmente.
-
Após alternar para o destino, as novas sequências não começam a partir do valor máximo no source. Antes de alternar, consulte os valores das sequências source e defina-os como os valores iniciais no destino:
sudo make
sudo make install
A saída contém instruções setval para todas as sequências no source. Execute apenas as instruções que se aplicam aos seus objetos de migração no destino.
Se uma instância do DTS falhar, o helpdesk tentará recuperá-la em até 8 horas. A recuperação pode incluir a reinicialização da instância ou o ajuste de parâmetros da instância do DTS (não parâmetros do banco de dados). Para parâmetros ajustáveis, consulte modifique parâmetros da instância.
Permissões necessárias
| Banco de dados | Migração de esquema | Migração completa | Migração incremental |
|---|---|---|---|
| PostgreSQL auto-gerenciado | USAGE em pg_catalog |
SELECT em objetos de migração | Superusuário |
| AnalyticDB for PostgreSQL | Proprietário do esquema (ou a conta inicial) | ||
Para crie contas e conceda permissões:
PostgreSQL auto-gerenciado: consulte a documentação do PostgreSQL para CREATE USER e GRANT.
AnalyticDB for PostgreSQL: consulte Crie e gerencie um usuário e gerencie permissões de usuário.
Prepare o banco de dados source
Conclua as etapas para a sua versão do PostgreSQL antes de configure a tarefa de migração.
Este guia usa um banco de dados PostgreSQL auto-gerenciado em um servidor Linux como exemplo. Se o seu source for uma instância do Amazon RDS for PostgreSQL ou Amazon Aurora PostgreSQL, consulte as etapas de preparação nos tópicos de migração correspondentes antes de continuar.
PostgreSQL 10.1 ou posterior
Faça logon no servidor que executa o banco de dados PostgreSQL auto-gerenciado.
-
Abra o
postgresql.confe atualize os seguintes parâmetros: Exemplo de configuração:Defina
wal_levelcomological.Defina
max_wal_sendersemax_replication_slotscom valores maiores que a soma de: o número de slots de replicação atualmente em uso no source, mais o número de instâncias do DTS que usam este banco de dados source.
sudo make
sudo make install
Reinicie o banco de dados para aplicar as alterações.
-
Adicione os blocos CIDR do servidor DTS ao
pg_hba.conf. Adicione apenas os blocos CIDR para servidores DTS na mesma região do banco de dados de destino. Para obter a lista de blocos CIDR, consulte Adicionar endereços IP do servidor DTS a uma lista de permissões. edite opg_hba.confe executeSELECT pg_reload_conf();ou reinicie o banco de dados para aplicar as alterações. Ignore esta etapa se o endereço IP nopg_hba.confjá estiver definido como0.0.0.0/0.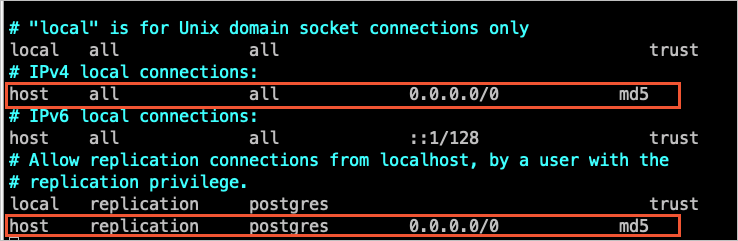
crie o banco de dados e o esquema correspondentes na instância de destino do AnalyticDB for PostgreSQL.
PostgreSQL 9.4.8 a 10.0
As versões do PostgreSQL abaixo de 10.1 exigem o plug-in ali_decoding para oferecer suporte à replicação lógica. Siga estas etapas para compilá-lo e instale-o.
baixe o código-fonte do PostgreSQL que corresponde à versão do seu banco de dados no site oficial do PostgreSQL.
-
Compile e instale o PostgreSQL executando os seguintes comandos em sequência:
ImportanteA versão do sistema operacional deve ser compatível com a versão do GNU Compiler Collection (GCC). - Se
sudo ./configurefalhar com um erro de readline, executesudo ./configure --without-readline. - Se você instale o PostgreSQL usando outro método, compile o plug-inali_decodingem um ambiente de teste com a mesma versão do sistema operacional e versão do GCC.
sudo make
sudo make install
baixe o plug-in ali_decoding.
-
Copie o diretório
ali_decodingpara o diretóriocontribda instalação compilada do PostgreSQL.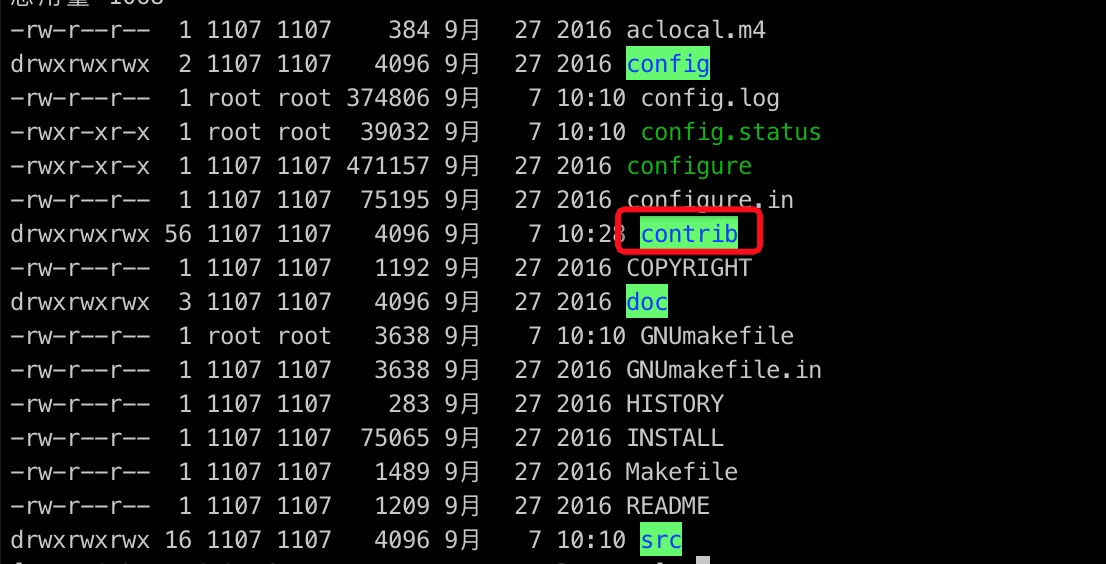
-
Substitua o conteúdo do
Makefileno diretórioali_decodingpelo seguinte:sudo make sudo make install -
A partir do diretório
ali_decoding, execute os seguintes comandos em sequência para compilar e instalar o plug-in:sudo make sudo make install -
Copie os arquivos compilados para os diretórios necessários.

crie o banco de dados e o esquema correspondentes na instância de destino do AnalyticDB for PostgreSQL.
crie uma tarefa de migração
Após selecione as instâncias de source e destino, leia a seção Limitações na parte superior da página de configuração antes de continuar.
Etapa 1: acesse a página Data Migration
Use o console do DTS ou o console do DMS.
Console do DTS
Faça logon no console do DTS.console do DTS
No painel de navegação à esquerda, clique em Data Migration.
No canto superior esquerdo, selecione a região onde a instância de migração reside.
Console do DMS
Nota
As etapas exatas podem variar com base no modo e no layout do console do DMS. Consulte Modo simples e Personalizar o layout e o estilo do console do DMS.
Faça logon no console do DMS.console do DMS
Na barra de navegação superior, acesse Data + AI > DTS (DTS) > Data Migration.
Na lista suspensa ao lado de Data Migration Tasks, selecione a região onde a instância de migração reside.
Etapa 2: configure bancos de dados source e destino
Clique em Create Task e configure os seguintes parâmetros.
Banco de dados source
|
Parâmetro |
Descrição |
|
Task name |
O DTS gera um nome automaticamente. especifique um nome descritivo para ajudar a identificar a tarefa. O nome não precisa ser exclusivo. |
|
Select existing connection |
Selecione uma instância de banco de dados registrada para preencher automaticamente os parâmetros de conexão. Se nenhuma instância registrada estiver disponível, configure os parâmetros manualmente. |
|
Database type |
Selecione PostgreSQL. |
|
Access method |
Selecione o método de implantação para o banco de dados source. Este guia usa Self-managed Database on ECS como exemplo. Para outros métodos de acesso, consulte Preparations. |
|
Instance region |
Selecione a região onde o banco de dados source reside. |
|
ECS instance ID |
insira o ID da instância ECS que hospeda o banco de dados source. |
|
Port number |
A porta service do banco de dados source. Padrão: 5432. |
|
Database name |
O nome do banco de dados que contém os objetos a serem migrados. |
|
Database account |
A conta para o banco de dados source. Consulte Permissões necessárias. |
|
Database password |
A senha da conta do banco de dados. |
|
Encryption |
Selecione Non-encrypted ou SSL-encrypted. Para criptografia SSL, faça upload do CA certificate. Opcionalmente, faça upload do Client certificate e Private key of client certificate, e insira a Private key password of client certificate. |
Banco de dados de destino
|
Parâmetro |
Descrição |
|
Select existing connection |
Selecione uma instância de banco de dados registrada para preencher automaticamente os parâmetros de conexão. |
|
Database type |
Selecione AnalyticDB for PostgreSQL. |
|
Access method |
Selecione Alibaba Cloud Instance. |
|
Instance region |
Selecione a região onde a instância de destino reside. |
|
Instance ID |
Selecione a instância de destino do AnalyticDB for PostgreSQL. |
|
Database name |
O nome do banco de dados na instância de destino. |
|
Database account |
A conta para o banco de dados de destino. Consulte Permissões necessárias. |
|
Database password |
A senha da conta do banco de dados. |
Etapa 3: Testar conectividade
Clique em Test Connectivity and Proceed.
O DTS precisa de acesso a ambos os bancos de dados. Certifique-se de que os blocos CIDR do servidor DTS foram adicionados às configurações de segurança dos bancos de dados source e de destino. Consulte Adicionar endereços IP do servidor DTS a uma lista de permissões .
Se o source ou o destino for um banco de dados auto-gerenciado não acessado como Alibaba Cloud Instance , clique em Test Connectivity na caixa de diálogo CIDR Blocks of DTS Servers .
Etapa 4: configure objetos de migração
Tipos e objetos de migração
|
Parâmetro |
Descrição |
|
Migration types |
Selecione Schema Migration e Full Data Migration para uma migração única. Para manter seu source online durante a migração, selecione também Incremental Data Migration. Se você ignorar o Schema Migration, crie o banco de dados e as tabelas de destino manualmente e ative o mapeamento de nomes de objetos em Selected Objects. |
|
Processing mode of conflicting tables |
Precheck and Report Errors: a pré-verificação falha se alguma tabela de destino compartilhar um nome com uma tabela source. Use o mapeamento de nomes de objetos para resolver conflitos. Ignore Errors and Proceed: ignora a verificação de conflito de nomes, mas arrisca a inconsistência de dados — durante a migração completa, os registros conflitantes são mantidos no destino; durante a migração incremental, eles são sobrescritos. |
|
DDL and DML operations to be synchronized |
Selecione as operações SQL a serem replicadas durante a migração incremental. Consulte Comportamento da migração incremental para operações suportadas. Para configure no nível do banco de dados ou da tabela, clique em com o botão direito no objeto em Selected Objects e selecione as operações. |
|
Storage engine type |
Padrão: Beam. Disponível apenas quando a versão secundária do AnalyticDB for PostgreSQL de destino é v7.0.6.6 ou posterior e o Schema Migration está selecionado. |
|
Capitalization of object names in destination instance |
Controla a caixa (maiúsculas/minúsculas) dos nomes de bancos de dados, tabelas e colunas no destino. Padrão: DTS default policy. Consulte especifique a capitalização de nomes de objetos na instância de destino. |
|
Source objects |
Selecione os objetos a serem migrados e clique em |
|
Selected objects |
Para renomear um único objeto, clique em com o botão direito nele. Para renomear vários objetos de uma vez, clique em Batch Edit. Consulte Mapear nomes de objetos. Para filtrar linhas, clique em com o botão direito em uma tabela e defina uma condição WHERE. Consulte defina condições de filtro. |
 para adicioná-los aos Selected Objects. Você pode selecione colunas, tabelas ou esquemas. A seleção de tabelas ou colunas exclui exibições, gatilhos e procedimentos armazenados.
Etapa 5: configure opções avançadas
Clique em Next: Advanced Settings e configure os seguintes parâmetros.
|
Parâmetro |
Descrição |
|
Dedicated cluster for task scheduling |
Por padrão, o DTS agenda tarefas para o cluster compartilhado. Adquira um cluster dedicado para obter melhor estabilidade da tarefa. Consulte O que é um cluster dedicado do DTS. |
|
Retry time for failed connections |
Por quanto tempo o DTS tenta novamente após uma falha de conexão. Valores válidos: 10 a 1.440 minutos. Padrão: 720. defina para pelo menos 30 minutos. Se a conexão for restaurada dentro desse período, o DTS retomará a tarefa. O tempo de tentativa especificado posteriormente tem precedência quando várias tarefas compartilham o mesmo banco de dados. |
|
Retry time for other issues |
Por quanto tempo o DTS tenta novamente após falhas de DDL ou DML. Valores válidos: 1 a 1.440 minutos. Padrão: 10. defina para pelo menos 10 minutos. Deve ser menor que Retry time for failed connections. |
|
Enable throttling for full data migration |
Limita a taxa de leitura/gravação durante a migração completa para reduzir a carga no source e no destino. Configure Queries per second (QPS) to the source database, RPS of Full Data Migration e Data migration speed for full migration (MB/s). Disponível apenas quando Full Data Migration está selecionado. |
|
Enable throttling for incremental data migration |
Limita a taxa de replicação durante a migração incremental. Configure RPS of Incremental Data Migration e Data migration speed for incremental migration (MB/s). Disponível apenas quando Incremental Data Migration está selecionado. |
|
Environment tag |
Opcionalmente, aplique uma tag na instância para identificar seu ambiente. |
|
Configure ETL |
Selecione Yesalert notification settings para transformar dados durante a migração usando instruções de extração, transformação e carga (ETL). Consulte configure ETL em uma tarefa de migração de dados ou sincronização de dados. |
|
Monitoring and alerting |
Selecione Yes para receber notificações quando a tarefa falhar ou a latência da migração exceder o limiar. Configure os limiares de alerta e os contatos. Consulte configure monitoramento e alertas. |
Etapa 6: configure uma tarefa de verificação de dados (opcional)
Clique em Next Step: Data Verification. Para obter instruções de configuração, consulte configure uma tarefa de verificação de dados.
Etapa 7: configure chave primária e colunas de distribuição
Clique em Next: Configure Database and Table Fields para defina a chave primária e as colunas de distribuição para as tabelas migradas na instância de destino do AnalyticDB for PostgreSQL.
Esta página aparece apenas quando o Schema Migration está selecionado. Para mais informações sobre colunas de chave primária e colunas de distribuição, consulte Data Table Management e Table Distribution Definition .
Etapa 8: Execute a pré-verificação
Clique em Next: Save Task Settings and Precheck.
visualize os parâmetros da API para esta configuração, passe o mouse sobre Next: Save Task Settings and Precheck e clique em Preview OpenAPI parameters .
O DTS executa uma pré-verificação antes de iniciar a migração. Você só pode iniciar a tarefa após ela passar na pré-verificação.
Se a pré-verificação falhar, clique em View Details ao lado de cada item com falha, corrija o problema e clique em Precheck Again.
Se um alerta aparecer para um item:
Se o alerta não puder ser ignorado, clique em View Details, corrija o problema e execute a pré-verificação novamente.
Se o alerta puder ser ignorado, clique em Confirm Alert Details > Ignore > OK e, em seguida, clique em Precheck Again.
Ignorar um alerta de pré-verificação pode resultar em inconsistência de dados.
Etapa 9: Adquirir e iniciar a instância
Aguarde até que a Success Rate atinja 100% e clique em Next: Purchase Instance.
-
Na página Purchase Instance, configure:
Parâmetro
Descrição
Resource group
O grupo de recursos para a instância de migração. Padrão: default resource group.
Instance class
Selecione uma classe de instância com base na velocidade de migração necessária. Consulte Classes de instância de instâncias de migração de dados.
Leia e aceite os Data Transmission Service (Pay-as-you-go) Service Terms.
Clique em Buy and Start e, em seguida, clique em OK na caixa de diálogo e confirme.
Acompanhe o progresso na página Data Migration.
As tarefas de migração de esquema + migração de dados completa param automaticamente quando concluídas. O status mostra Completed .
As tarefas de migração de dados incrementais são executadas continuamente. O status mostra Running . Pare a tarefa manualmente quando estiver pronto para alternar as cargas de trabalho para o destino.
Próximos passos
Após a conclusão da migração e antes de alternar suas cargas de trabalho para o banco de dados de destino:
Corrija os valores iniciais das sequências. Consulte os valores máximos das sequências no source e defina-os como os valores iniciais no destino. Consulte o comando de consulta de sequência na seção Limitações.
Pare ou libere tarefas com falha. O DTS tenta novamente tarefas com falha por até 7 dias. Pare ou libere quaisquer tarefas com falha, ou revogue as permissões de gravação do DTS no destino para evitar que os dados source sobrescrevam o destino após a alternância.
Alterne as cargas de trabalho. Pare as gravações no source e, em seguida, aponte suas aplicações para o destino.