O Data Transmission service (DTS) permite sincronizar dados de uma instância do ApsaraDB RDS for PostgreSQL para outra em tempo real. Use este fluxo de trabalho quando precisar de instâncias standby para recuperação de desastres, réplicas de leitura para separação de leitura e escrita, migração de banco de dados entre contas ou uma instância de análise separada que permaneça sincronizada com a produção.
O DTS oferece suporte a três fases de sincronização — sincronização de schema, sincronização completa de dados e sincronização incremental de dados — e a quatro topologias unidirecionais: um para um, um para muitos, em cascata e muitos para um.
Pré-requisitos
Antes de começar, verifique se:
As instâncias source e de destino do ApsaraDB RDS for PostgreSQL estão criadas. Consulte crie uma instância do ApsaraDB RDS for PostgreSQL.
A versão da instância de destino é igual ou superior à versão da instância source. Uma versão de destino mais antiga pode causar erros de compatibilidade.
Há espaço de armazenamento livre suficiente na instância de destino. O espaço deve exceder o tamanho total dos dados na instância source.
O parâmetro
wal_levelna instância source está definido comological.-
A retenção de logs WAL está configurada da seguinte forma:
Apenas sincronização incremental de dados: retenha os logs WAL por mais de 24 horas.
Sincronização completa de dados + sincronização incremental de dados: retenha os logs WAL por pelo menos sete dias. Após a conclusão da sincronização completa de dados, reduza o período de retenção para mais de 24 horas.
Se os logs WAL não forem retidos por tempo suficiente, o DTS poderá falhar ao lê-los. Isso causará a falha da tarefa e, possivelmente, levará à inconsistência ou perda de dados. Certifique-se de defina o período de retenção dos logs WAL com base nos requisitos anteriores. Caso contrário, a confiabilidade ou o desempenho do service no Acordo de Nível de service (SLA) do DTS podem não ser garantidos.
Para as combinações suportadas de versões source e de destino, consulte Visão geral dos cenários de sincronização de dados.
Faturamento
|
Tipo de sincronização |
Taxa |
|
Sincronização de schema e sincronização completa de dados |
Gratuita |
|
Sincronização incremental de dados |
Cobrada. Consulte Visão geral de faturamento. |
Limitações
Analise estas limitações antes de começar.
Requisitos do banco de dados source
-
As tabelas devem ter uma restrição PRIMARY KEY ou UNIQUE, e todos os campos devem ser únicos. Sem essas restrições, o banco de dados de destino poderá conter registros duplicados.
Se você crie a tarefa de sincronização sem selecionar Schema Synchronization , a tabela de destino deverá ter as mesmas restrições PRIMARY KEY ou NOT NULL UNIQUE da tabela source. Caso contrário, registros duplicados poderão aparecer.
Se você selecionar tabelas como objetos de sincronização e quiser renomear tabelas ou colunas no destino, uma única tarefa suportará no máximo 5.000 tabelas. Para mais de 5.000 tabelas, divida a carga de trabalho em várias tarefas ou sincronize no nível do banco de dados em vez do nível da tabela.
O DTS não sincroniza tabelas temporárias, gatilhos internos nem certos procedimentos e funções internas escritos em C. O DTS sincroniza parâmetros personalizados dos tipos COMPOSITE, ENUM e RANGE. As tabelas devem ter restrições PRIMARY KEY, FOREIGN KEY, UNIQUE ou CHECK.
-
O DTS cria um slot de replicação com o prefixo
dts_sync_no banco de dados source, o que concede ao DTS acesso aos logs incrementais dos últimos 15 minutos. O acúmulo de slots de replicação pode exaurir o espaço em disco. defina um alerta de uso de disco na instância source quando a replicação lógica estiver ativa. Comportamento de limpeza do slot de replicação: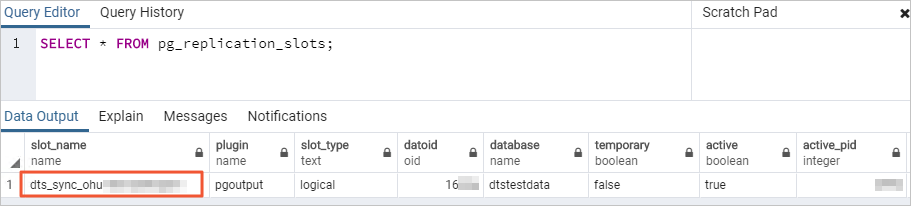
Após a liberação da instância do DTS, o slot é excluído automaticamente. No entanto, se você tiver alterado a senha do banco de dados source ou removido os endereços ip do DTS da lista de permissões de ip, exclua o slot manualmente.
Se ocorrer um failover de primário/secundário na instância source, faça logon no banco de dados secundário e exclua o slot manualmente.
O DTS cria as seguintes tabelas temporárias no banco de dados source para capturar instruções DDL, schemas de tabelas incrementais e informações de heartbeat. Não as exclua enquanto a sincronização estiver em execução, pois elas são excluídas automaticamente quando a instância do DTS é liberada:
public.dts_pg_class,public.dts_pg_attribute,public.dts_pg_type,public.dts_pg_enum,public.dts_postgres_heartbeat,public.dts_ddl_command,public.dts_args_sessionO DTS adiciona uma tabela de heartbeat chamada
dts_postgres_heartbeatao banco de dados source para rastrear a latência de sincronização com precisão.Para execute um failover de primário/secundário na instância source do ApsaraDB RDS for PostgreSQL sem interromper a sincronização, ative primeiro o recurso Logical Replication Slot Failover. Consulte Logical Replication Slot Failover.
Se uma única alteração incremental de dados exceder 256 MB, a instância de sincronização em execução falhará e não poderá ser recuperada. Nesse caso, reconfigure a tarefa.
Durante a sincronização de schema e a sincronização completa de dados, não execute instruções DDL que alterem os schemas do banco de dados ou das tabelas. Caso contrário, a tarefa falhará.
Se o banco de dados source tiver transações de longa duração durante a sincronização incremental de dados, os logs WAL gerados antes da confirmação dessas transações poderão se acumular e exaurir o espaço em disco.
Se uma atualização de versão principal for realizada no banco de dados source enquanto uma instância de sincronização estiver em execução, a instância falhará e não poderá ser recuperada. Nesse caso, reconfigure a tarefa.
Outros requisitos
Uma única tarefa sincroniza dados de apenas um banco de dados. Para sincronizar vários bancos de dados, crie uma tarefa separada para cada um.
O DTS não sincroniza tabelas que possuam relações de herança entre schemas.
-
Se você selecionar um schema como objeto de sincronização, execute a seguinte instrução antes de gravar dados em qualquer tabela nova ou renomeada nesse schema:
ALTER TABLE schema.table REPLICA IDENTITY FULL;Substitua
schemaetablepelos nomes reais. execute esta instrução fora dos horários de pico e evite bloquear a tabela. O bloqueio durante a execução desta instrução pode causar um deadlock. O DTS não valida metadados como sequences. Verifique a validade das sequences manualmente.
Antes de alternar as cargas de trabalho para o banco de dados de destino, atualize o valor inicial das sequences no destino. Após a alternância, as novas sequences gravadas não continuarão a partir do valor máximo na instância source.
Quando a conta de destino for privilegiada ou de superusuário e as tabelas sincronizadas contiverem chaves estrangeiras, gatilhos ou gatilhos de eventos, o DTS definirá temporariamente
session_replication_rolecomoreplicano nível da sessão. Se a conta de destino não tiver as permissões necessárias, defina esse parâmetro comoreplicamanualmente. Operações UPDATE ou DELETE em cascata na instância source durante esse período podem causar inconsistência de dados. Após a liberação da tarefa, defina o parâmetro de volta paraorigin.A gravação de dados de outras sources no banco de dados de destino durante a sincronização causa inconsistência de dados. Por exemplo, a execução de instruções DDL online a partir do DMS enquanto outras sources gravam no banco de dados de destino pode causar perda de dados.
Se uma tarefa falhar, o suporte técnico do DTS tentará restaurá-la em até 8 horas. Durante a restauração, a tarefa poderá ser reiniciada e os parâmetros da tarefa (não os parâmetros do banco de dados) poderão ser modificados.
Requisitos para tipos específicos de bancos de dados source
Instância source do ApsaraDB RDS for PostgreSQL
não modifique o endpoint ou a zona da instância source enquanto a sincronização estiver em execução. Isso causará a falha da tarefa.
Instância source de PostgreSQL autogerenciado
Os valores de max_wal_senders e max_replication_slots devem ser maiores que a soma do número de slots de replicação atualmente em uso e o número de instâncias do DTS que você planeja crie para este banco de dados.
Instância source do Cloud SQL for PostgreSQL (Google Cloud)
defina Database Account como uma conta com a permissão cloudsqlsuperuser. Ao selecionar objetos para sincronizar, escolha apenas os objetos que a conta está autorizada a gerencie ou conceda a permissão OWNER nesses objetos para a conta.
Uma conta com a permissão cloudsqlsuperuser não pode gerencie dados pertencentes a outras contas com a mesma permissão.
Objetos suportados
|
Tipo de objeto |
Detalhes |
|
SCHEMA e TABLE |
Inclui PRIMARY KEY, UNIQUE KEY, FOREIGN KEY, tipos de dados integrados e restrições DEFAULT |
|
VIEW, PROCEDURE, FUNCTION, RULE, SEQUENCE, EXTENSION, TRIGGER, AGGREGATE, INDEX, OPERATOR, DOMAIN |
PROCEDURE requer PostgreSQL V11 ou posterior |
Operações SQL que podem ser sincronizadas
|
Tipo |
Instruções |
|
DML |
INSERT, UPDATE, DELETE |
|
DDL |
Consulte abaixo |
A sincronização de DDL está disponível apenas para tarefas criadas após 1º de outubro de 2020.
Para tarefas criadas antes de 12 de maio de 2023, crie gatilhos e funções no banco de dados source para capturar informações de DDL antes de configure a tarefa. Consulte Usar gatilhos e funções para implementar a migração incremental de DDL para bancos de dados PostgreSQL.
A sincronização de DDL requer uma conta de banco de dados privilegiada na instância source com uma versão secundária do motor 20210228 ou posterior. Para atualize a versão secundária, consulte Atualizar a versão secundária do motor.
Instruções DDL suportadas:
CREATE TABLE e DROP TABLE
ALTER TABLE: RENAME TABLE, ADD COLUMN, ADD COLUMN DEFAULT, ALTER COLUMN TYPE, DROP COLUMN, ADD CONSTRAINT, ADD CONSTRAINT CHECK, ALTER COLUMN DROP DEFAULT
TRUNCATE TABLE (apenas para instância source de PostgreSQL autogerenciado versão 11 ou posterior)
CREATE INDEX ON TABLE
Limitações de DDL:
Para usar uma tarefa de sincronização de dados criada antes de 12 de maio de 2023 para sincronizar operações DDL, crie gatilhos e funções no banco de dados source para capturar informações de DDL antes de configure a tarefa. Para mais informações, consulte Usar gatilhos e funções para implementar a migração incremental de DDL para bancos de dados PostgreSQL.
O DTS não sincroniza dados do tipo BIT durante a sincronização incremental de dados.
O DTS não sincroniza cláusulas DDL adicionais, como CASCADE ou RESTRICT.
O DTS não sincroniza instruções DDL de sessões que executam
SET session_replication_role = replica.O DTS não sincroniza instruções DDL executadas pela invocação de funções.
Se uma transação contiver instruções DML e DDL, o DTS não sincronizará as instruções DDL.
O DTS não sincroniza instruções DDL para objetos fora do escopo de sincronização.
crie uma tarefa de sincronização
Etapa 1: Abrir a página de sincronização de dados
Use o console do DTS ou o console do DMS.
Console do DTS
Faça logon no console do DTS.console do DTS
No painel de navegação à esquerda, clique em Data Synchronization.
No canto superior esquerdo, selecione a região onde reside a instância de sincronização.
Console do DMS
Nota
As etapas podem variar dependendo do modo e do layout do console do DMS. Consulte
e
Personalizar o layout e o estilo do console do DMS
.
Faça logon no console do DMS.console do DMS
Na barra de navegação superior, passe o ponteiro do mouse sobre Data + AI e escolha DTS (DTS) > Data Synchronization.
Na lista suspensa à direita de Data Synchronization Tasks, selecione a região onde reside a instância de sincronização.
Etapa 2: crie a tarefa
clique em Create Task.
-
Se a página mostrar um botão New Configuration Page no canto superior direito, clique em ele.
Pule esta etapa se Back to Previous Version for exibido. As páginas de configuração nova e anterior podem diferir ligeiramente. Use a nova versão.
Etapa 3: configure os bancos de dados source e de destino
Após configure ambos os bancos de dados, leia os Limits exibidos na página. Pular esta etapa pode causar a falha da tarefa ou resultar em inconsistência de dados.
|
Seção |
Parâmetro |
Descrição |
|
N/D |
Task Name |
O DTS gera automaticamente um nome para a tarefa. Recomendamos especifique um nome descritivo para facilitar a identificação. O nome não precisa ser único. |
|
Source Database |
Database Type |
O tipo do banco de dados source. selecione PostgreSQL. |
|
Connection Type |
O método de acesso do banco de dados source. selecione Alibaba Cloud Instance. |
|
|
Instance Region |
A região onde reside a instância source do ApsaraDB RDS for PostgreSQL. |
|
|
Replicate Data Across Alibaba Cloud Accounts |
Este exemplo usa uma instância de banco de dados que pertence à conta atual do Alibaba Cloud. selecione No. |
|
|
Instance ID |
O ID da instância source do ApsaraDB RDS for PostgreSQL. |
|
|
Database Name |
O nome do banco de dados do qual os objetos são sincronizados na instância source do ApsaraDB RDS for PostgreSQL. |
|
|
Database Account |
A conta do banco de dados da instância source do ApsaraDB RDS for PostgreSQL. especifique uma conta privilegiada que seja proprietária do banco de dados. Para mais informações sobre como crie uma conta para uma instância do ApsaraDB RDS for PostgreSQL e conceder permissões a ela, consulte Create an account e Create a database. Nota
Se a instância source for do ApsaraDB RDS for PostgreSQL V9.4 e você quiser sincronizar apenas operações DML, apenas a permissão REPLICATION será necessária para a conta do banco de dados. |
|
|
Database Password |
insira a senha correspondente à conta do banco de dados. |
|
|
Encryption |
Especifica se a conexão com o banco de dados source deve ser criptografada. configure este parâmetro com base nos seus requisitos de negócios. Neste exemplo, Non-encrypted está selecionado. Para estabelecer uma conexão criptografada por SSL com o banco de dados source, execute as seguintes etapas: selecione SSL-encrypted, faça o upload de CA Certificate, Client Certificate e Private Key of Client Certificate conforme necessário e, em seguida, especifique Private Key Password of Client Certificate. Nota
|
|
|
Destination Database |
Database Type |
O tipo do banco de dados de destino. selecione PostgreSQL. |
|
Connection Type |
O método de acesso do banco de dados de destino. selecione Alibaba Cloud Instance. |
|
|
Instance Region |
A região onde reside a instância de destino do ApsaraDB RDS for PostgreSQL. |
|
|
Instance ID |
O ID da instância de destino do ApsaraDB RDS for PostgreSQL. |
|
|
Database Name |
O nome do banco de dados para o qual os objetos são sincronizados na instância de destino do ApsaraDB RDS for PostgreSQL. |
|
|
Database Account |
A conta do banco de dados da instância de destino do ApsaraDB RDS for PostgreSQL. A conta deve ter permissões de proprietário nos schemas. Para obter informações sobre como crie uma conta para uma instância do ApsaraDB RDS for PostgreSQL e conceder permissões a ela, consulte Create an account. |
|
|
Database Password |
insira a senha correspondente à conta do banco de dados. |
|
|
Encryption |
Especifica se a conexão com o banco de dados source deve ser criptografada. configure este parâmetro com base nos seus requisitos de negócios. Neste exemplo, Non-encrypted está selecionado. Para estabelecer uma conexão criptografada por SSL com o banco de dados source, execute as seguintes etapas: selecione SSL-encrypted, faça o upload de CA Certificate, Client Certificate e Private Key of Client Certificate conforme necessário e, em seguida, especifique Private Key Password of Client Certificate. Nota
|
Etapa 4: Testar a conectividade
clique em Test Connectivity and Proceed na parte inferior da página.
Adicione os blocos CIDR dos servidores do DTS às configurações de segurança de ambos os bancos de dados. Consulte Adicionar os blocos CIDR dos servidores do DTS . Se algum dos bancos de dados for autogerenciado e não estiver definido para o acesso Alibaba Cloud Instance , clique em Test Connectivity na caixa de diálogo CIDR Blocks of DTS Servers .
Etapa 5: configure os objetos a serem sincronizados
Na etapa Configure Objects, defina os seguintes parâmetros:
|
Parâmetro |
Descrição |
|
Synchronization Types |
Incremental Data Synchronization é selecionado por padrão. selecione também Schema Synchronization e Full Data Synchronization para sincronizar dados históricos como linha de base para a sincronização incremental. A seleção de Schema Synchronization faz com que o DTS sincronize os schemas das tabelas, incluindo chaves estrangeiras. |
|
Synchronization Topology |
selecione One-way Synchronization. |
|
Processing Mode of Conflicting Tables |
Precheck and Report Errors (padrão): a pré-verificação falha se a instância source e a de destino tiverem tabelas com o mesmo nome. Use o mapeamento de nomes de objetos para renomear tabelas conflitantes no destino, se necessário. Ignore Errors and Proceed: ignora a verificação de conflito de nomes. Durante a sincronização completa, os registros de destino existentes com valores de chave primária ou única correspondentes são mantidos. Durante a sincronização incremental, eles são sobrescritos. Se os schemas forem diferentes, a inicialização poderá falhar parcialmente. Use com cautela. |
|
Capitalization of Object Names in Destination Instance |
Controla como os nomes de bancos de dados, tabelas e colunas são capitalizados no destino. O padrão é DTS default policy. Consulte Especificar a capitalização dos nomes dos objetos. |
|
Source Objects |
selecione colunas, tabelas ou schemas e clique no ícone de seta para movê-los para Selected Objects. |
|
Selected Objects |
Clique com o botão direito em um objeto para renomeá-lo (consulte Mapear o nome de um único objeto), filtrar por operação SQL ou adicionar condições WHERE (consulte Set filter conditions). Para renomear vários objetos de uma vez, clique em Batch Edit para edite. Observe que a renomeação de um objeto pode interromper a sincronização de objetos dependentes. |
Etapa 6: configure as opções avançadas
clique em Next: Advanced Settings e configure o seguinte:
|
Parâmetro |
Descrição |
|
Dedicated Cluster for Task Scheduling |
Por padrão, o DTS usa um cluster compartilhado. Para maior estabilidade da tarefa, adquira um cluster dedicado. Consulte O que é um cluster dedicado do DTS. |
|
Retry Time for Failed Connections |
Tempo durante o qual o DTS tenta reconectar após uma falha de conexão. Intervalo válido: 10 a 1440 minutos. Padrão: 720 minutos. defina como pelo menos 30 minutos. Se o DTS reconectar dentro dessa janela, a tarefa será retomada; caso contrário, a tarefa falhará. Se várias tarefas compartilharem a mesma instância source ou de destino, o menor tempo de nova tentativa será aplicado. As cobranças da instância do DTS continuam durante as novas tentativas. |
|
Retry Time for Other Issues |
Tempo durante o qual o DTS tenta novamente após falhas de DDL ou DML. Intervalo válido: 1 a 1440 minutos. Padrão: 10 minutos. defina como pelo menos 10 minutos. Este valor deve ser menor que Retry Time for Failed Connections. |
|
Enable Throttling for Full Data Migration |
Limite o QPS para o banco de dados source, o RPS da migração completa de dados ou a velocidade de migração (MB/s) para reduzir a carga durante a sincronização completa. Visível apenas quando Full Data Synchronization está selecionado. |
|
Enable Throttling for Incremental Data Synchronization |
Limite o RPS ou a velocidade de sincronização (MB/s) para a sincronização incremental, a fim de reduzir a carga no destino. |
|
Environment Tag |
Uma tag opcional para identificar a instância do DTS. |
|
Configure ETL |
ative o recurso de extração, transformação e carga (ETL) para transformar dados em trânsito. selecione Yesconfigurações de notificação de alerta para insira instruções de processamento de dados. Consulte configure ETL em uma tarefa de migração de dados ou sincronização de dados. |
|
Monitoring and Alerting |
configure alertas para falhas de tarefa ou latência que exceda um limiar. selecione Yes para configure o limiar de alerta e os contatos de notificação. Consulte configure monitoramento e alertas ao crie uma tarefa do DTS. |
Etapa 7: configure a verificação de dados (opcional)
clique em Next Step: Data Verification para configure a verificação. Consulte configure uma tarefa de verificação de dados.
Etapa 8: Executar a pré-verificação
clique em Next: Save Task Settings and Precheck e salve.
Para visualize os parâmetros da API para esta configuração de tarefa, passe o ponteiro do mouse sobre o botão e clique em Preview OpenAPI parameters antes de prosseguir.
O DTS executa uma pré-verificação antes que a tarefa possa começar. Se a pré-verificação falhar:
clique em View Details ao lado de cada item com falha, resolva o problema e, em seguida, clique em Precheck Again.
Se um item mostrar um alerta que pode ser ignorado, clique em Confirm Alert Details > Ignore > OK, confirme e em seguida clique em Precheck Again. Ignorar alertas pode levar à inconsistência de dados.
Etapa 9: Adquirir e iniciar a instância
Aguarde até que Success Rate atinja 100% e clique em Next: Purchase Instance.
-
Na página de compra, configure o seguinte:
Seção
Parâmetro
Descrição
New Instance Class
Método de faturamento
-
Assinatura: você paga por uma assinatura ao crie uma instância de sincronização de dados. O método de faturamento por assinatura é mais econômico que o método de pagamento conforme o uso para uso a longo prazo.
-
Pagamento conforme o uso: uma instância de pagamento conforme o uso é faturada por hora. O método de pagamento conforme o uso é adequado para uso a curto prazo. Se você não precisar mais de uma instância de sincronização de dados de pagamento conforme o uso, poderá liberar a instância para reduzir custos.
Configurações do grupo de recursos
O grupo de recursos ao qual a instância de sincronização de dados pertence. Valor padrão: default resource group. Para mais informações, consulte O que é o Resource Management?
Classe da instância
O DTS fornece classes de instância que variam em velocidade de sincronização. selecione uma classe de instância com base nos seus requisitos de negócios. Para mais informações, consulte Classes de instância de instâncias de sincronização de dados.
Duração da assinatura
Se você selecionar o método de faturamento por assinatura, especifique a duração da assinatura e o número de instâncias de sincronização de dados que deseja crie. A duração da assinatura pode ser de um a nove meses, um ano, dois anos, três anos ou cinco anos.
NotaEste parâmetro está disponível apenas se você selecionar o método de faturamento Subscription.
-
Leia e aceite os Data Transmission Service (Pay-as-you-go) Service Terms.
clique em Buy and Start e, em seguida, clique em OK na caixa de diálogo.
visualize o progresso da tarefa na lista de tarefas.
O que fazer após o início da tarefa
Após o início da tarefa, monitore a latência de sincronização na lista de tarefas. Antes de alternar as cargas de trabalho para o destino:
atualize o valor inicial das sequences no banco de dados de destino. Após a alternância, os novos valores de sequence não continuarão a partir do valor máximo na instância source.
Se você usar apenas o DTS para gravar dados de tabelas no banco de dados de destino, poderá usar o DMS para execute operações DDL online nas tabelas source sem bloqueá-las durante a sincronização. Consulte Alterar schemas sem bloquear tabelas.
Para topologias de sincronização suportadas, consulte Synchronization topologies.