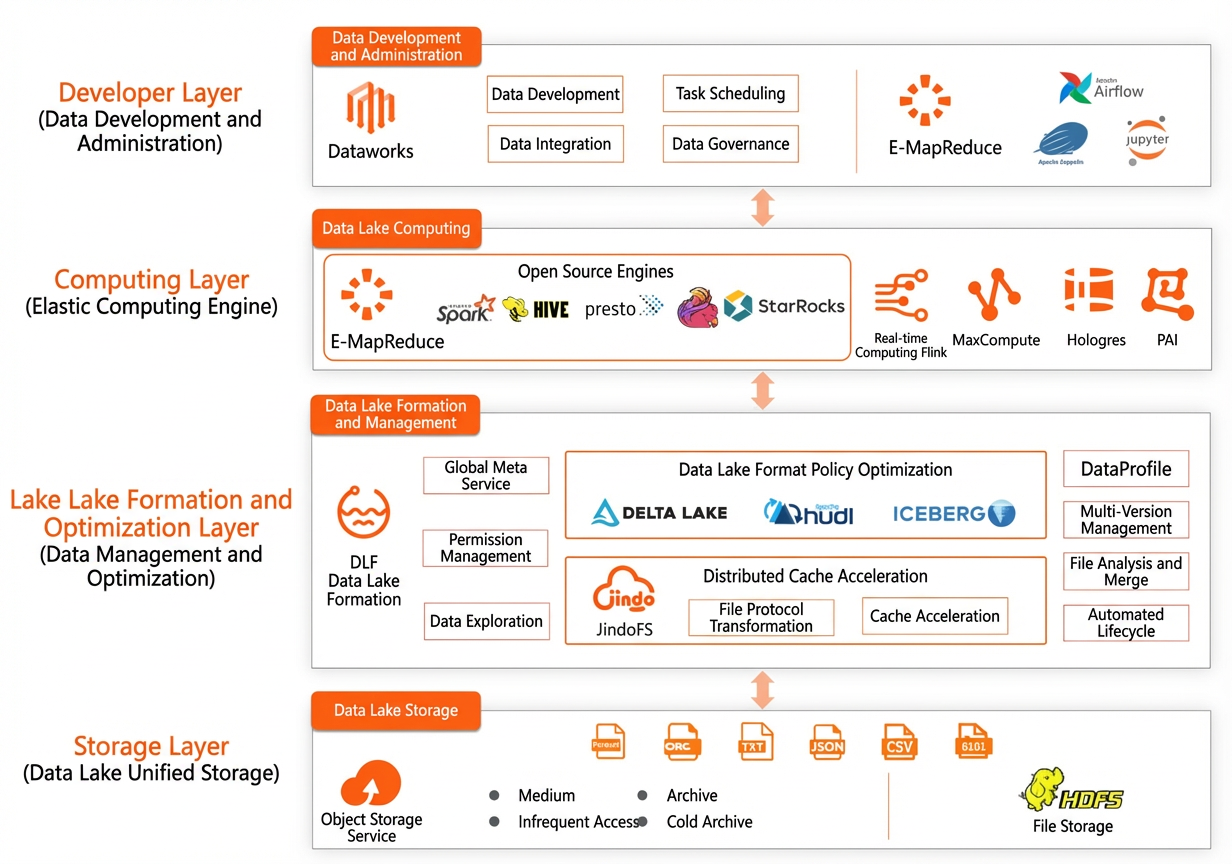
A solução de data lake EMR+DLF integra o E-MapReduce (EMR) e o Data Lake Formation (DLF) para oferecer gerenciamento centralizado de metadados e permissões em data lakes. Ela também oferece suporte à gestão do ciclo de vida dos dados, otimização automática de formatos de lake e análise de armazenamento. Você pode ingerir dados de diversas fontes no data lake e realizar uma exploração de dados unificada.
Informações básicas
Em comparação com a solução tradicional de data lake do EMR, a solução EMR+DLF oferece as seguintes vantagens:
-
O DLF fornece um service de metadados unificado, totalmente gerenciado e livre de O&M para data lakes em diferentes engines.
Gerenciamento visual de metadados com suporte a múltiplas versões e rollback.
Migração simplificada de metadados por meio de interface visual.
Busca de texto completo em metadados.
Análise de perfil de metadados, incluindo tamanho de arquivos, contagem de linhas, frequência de acesso, quantidade de arquivos pequenos, popularidade de arquivos e contagem de arquivos válidos.
Compatibilidade com engines de computação adicionais além das open source do EMR, como MaxCompute, Flink e Hologres.
-
O DLF permite o gerenciamento granular de permissões de dados.
Controle de permissões refinado e visual para recursos como catálogos de dados, bancos de dados, colunas e funções.
Integração com diversas engines de computação do EMR, incluindo Spark, Hive, Presto e Impala.
-
Recursos abrangentes de gerenciamento de data lake.
Gestão multidimensional do ciclo de vida dos dados. O sistema arquiva automaticamente os dados com base na popularidade dos arquivos e no horário de atualização, reduzindo custos de armazenamento.
Políticas automáticas de otimização de armazenamento para o formato Delta Lake, visando a redução de custos.
Arquitetura
Informações adicionais
Para consultar as regiões onde o DLF está disponível, consulte Data Lake Formation: Supported regions and endpoints.
Para obter detalhes sobre o faturamento do DLF, consulte Billing modes.
Procedimento
Etapa 1: Criar um cluster EMR DataLake
Ao criar um cluster EMR DataLake, selecione DLF Unified Metadata no campo Metadata.
Faça login no console do EMR. No painel de navegação à esquerda, clique em EMR on ECS.
-
Na página EMR on ECS, clique em Create Cluster. Na página E-MapReduce on ECS, configure os parâmetros abaixo.
Business Scenario: Selecione Data Lake.
Optional Services (Select One At Least): O Hive é obrigatório. Escolha outros serviços conforme suas necessidades de negócio.
Metadata: Selecione DLF Unified Metadata.
DLF Catalog: Utilize o catálogo padrão do DLF ou crie um novo. Caso ainda não tenha ativado o DLF, o sistema solicitará a ativação prévia.
Siga as instruções subsequentes na tela. Para mais detalhes, consulte Create a cluster.
Etapa 2: Inicializar metadados
Escolha um dos métodos abaixo para inicializar os metadados, de acordo com o seu cenário.
Caso os metadados de um cluster EMR estejam em um banco de dados MySQL integrado ou em um banco ApsaraDB RDS autogerenciado, migre-os para o DLF. Consulte Best practices for EMR metadata migration to DLF para mais informações.
-
Se um cluster EMR recém-criado não possuir metadados históricos, utilize o DLF para criá-los visualmente ou empregue Hive/Spark SQL para gerar bancos de dados e tabelas.
Acesse o console do DLF. Na barra de navegação superior, selecione a região onde o Object Storage Service (OSS) está ativado, como China (Hangzhou).
No painel de navegação à esquerda, escolha .
Clique na aba Database e, em seguida, em Create Database.
Na página Create Database, defina os parâmetros desejados e clique em OK.
Quando os dados de um novo cluster EMR residirem no OSS sem metadados associados, aproveite o recurso metadata discovery do DLF para extraí-los do OSS. Veja mais em Quick start: Taobao user behavior analysis.
Etapa 3: Inicializar dados
Adote uma das abordagens a seguir para inicializar os dados, conforme o cenário:
Para migrar dados de um cluster EMR existente, utilize o Jindo DistCp e transfira-os para o OSS.
Para importar dados de sistemas como RDS, MySQL e Kafka, use o Realtime Compute for Apache Flink e ingira-os no DLF. Consulte Manage DLF-Legacy catalogs para detalhes.
Etapa 4: Consultar dados em uma tabela específica do DLF usando Spark ou Presto
Conecte-se ao nó master -1-1 do cluster EMR via SSH. Para mais informações, consulte Log on to a cluster.
-
Consulte dados de uma tabela específica com Spark SQL.
-
Execute o comando abaixo para iniciar o Spark SQL:
spark-sql -
Execute a instrução a seguir para consultar os dados da tabela:
SELECT * FROM <database>.<table>;
-
-
Utilize o Presto para consultar dados em uma tabela específica.
-
Inicie a CLI do Presto com o comando:
presto --server master-1-1:8889 -
Execute a consulta abaixo para obter os dados da tabela:
SELECT * FROM <catalog>.<database>.<table>;Parâmetros da instrução acima
Parâmetro
Descrição
<catalog>
Nome da fonte de dados alvo da conexão.
Use o comando show catalogs; para listar todos os catálogos. Alternativamente, visualize-os na aba Configure do service Presto no console do EMR.
<database>
Nome do banco de dados a ser consultado.
<table>
Nome da tabela alvo da consulta.
Por exemplo, para consultar dados da tabela test no banco default do Hive, execute a instrução SELECT * FROM hive.default.test;.
-
(Opcional) Etapa 5: Ativar o gerenciamento de permissões de dados
Caso seu negócio exija alta segurança e controle adequado de permissões no data lake, siga os passos abaixo para ativar o gerenciamento de permissões:
Ative o gerenciamento de permissões do DLF no seu cluster EMR. Consulte DLF-Auth para mais detalhes.
Habilite o gerenciamento de permissões para seus catálogos de dados no DLF. Veja mais em Configure permissions.
Após a configuração, as permissões passam a valer para todos os dados do cluster EMR. Os usuários precisam receber as autorizações necessárias para acessar esses dados.
Para saber como conceder permissões aos usuários, consulte Data authorization. Mais informações estão disponíveis em Unified access control with DLF and EMR.
(Opcional) Etapa 6: Implementar o gerenciamento de ciclo de vida
O recurso de gerenciamento de ciclo de vida permite definir regras para bancos de dados e tabelas do data lake. É possível alterar periodicamente a classe de armazenamento dos dados no OSS com base no tempo de criação da partição/tabela, na última modificação ou no valor da partição, o que ajuda a reduzir custos. Para mais informações, consulte Lifecycle management.