Todos os produtos
Search
Central de documentação

DataWorks:FAQ sobre sincronização em lote

Última atualização: Aug 26, 2026

Respostas para perguntas frequentes sobre tarefas de sincronização em lote, incluindo problemas de conectividade, configurações de recursos, dados incorretos e erros específicos de plugins.

Visão geral

Utilize as palavras-chave na tabela a seguir para localizar problemas e soluções.

Categoria

Palavra-chave

Tópico relacionado

Problemas comuns de O&M em tarefas de sincronização em lote

Network communication issues

Why does a data source pass the connectivity test but an offline sync task fails with a data source connection error?

Switch resource groups

How do I switch the resource group for an offline sync task?

Dirty data

Run timeout

How do I troubleshoot long-running offline sync tasks?

Slow sync caused by a missing index in the WHERE condition of a data sync task

Whether default values of source tables are retained

Are default values and NOT NULL constraints retained in the destination table created by Data Integration?

Split key

Can a composite primary key be used as a split key for offline sync tasks?

Data loss

Data inconsistency between the destination table and source table after data sync

Causas e soluções para erros não relacionados a plugins

Dirty data

How do I handle dirty data errors caused by encoding format or garbled characters?

SSRF attacks

How do I handle the error "Task have SSRF attacks"?

Network communication issues

Offline sync task intermittently succeeds or fails

Table/column name keywords

How do I handle sync task failures caused by reserved keywords in table or column names?

Adding columns to a table

How do I handle column additions in the source table for offline sync tasks?

Date writing

How do I preserve milliseconds or specify a custom date-time format when writing date-time data to text?

Causas e soluções para erros específicos de plugins

MongoDB

OSS

Is there a file count limit when reading OSS files?

DataHub

How do I handle write failures caused by exceeding the data limit when writing to DataHub?

Lindorm

Does writing data using the Lindorm bulk method always replace historical data?

Elasticsearch

How do I query all fields in an Elasticsearch index?

OTS Writer configuration

How do I configure OTS Writer to write data to a destination table with auto-increment primary key columns?

Time series model configuration

How do I understand the _tag and is_timeseries_tag fields in time series model configuration?

Cenários e soluções para sincronização em lote

Custom table names

How do I customize table names for offline sync tasks?

MaxCompute

Task configuration issues

How do I handle the issue of not being able to view all tables when configuring an offline sync node?

LogHub

Kafka

OSS

MySQL

Modify TTL

Can the TTL of a synced data table only be modified by using the ALTER statement?

Function aggregation

Does API-based sync support using source-side functions (such as MaxCompute functions) for aggregation?

Elasticsearch

Field mapping

How do I handle field mapping issues when data preview is unavailable for unstructured data sources?

Mensagens de erro e soluções

Resource configuration issues

OSS

Error when reading OSS data: AccessDenied The bucket you access does not belong to you

Redis

Error when writing to Redis in hash mode: Code:[RedisWriter-04] source column number is invalid

PostgreSQL

Error when reading PostgreSQL data: FATAL: terminating connection due to conflict with recovery

MySQL

Instance run conflicts

Offline task error: Duplicate entry 'xxx' for key 'uk_uk_op'

Network communication issues

Offline sync task with MySQL data source error: Communications link failure

Field mapping

Offline task error: plugin xx does not specify column

MaxCompute

RestAPI

RestAPI Writer error: The JSON string found by path is not an array type

RDS

Error when the offline sync source is Amazon RDS: Host is blocked

MongoDB

Elasticsearch

Hive

Error when syncing data to local Hive offline: Could not get block locations

Run timeout

Offline sync task with MongoDB source error: MongoExecutionTimeoutException: operation exceeded time limit

Conectividade de rede

Por que o teste de conectividade da fonte de dados é bem-sucedido, mas a tarefa de sincronização em lote falha com um erro de conexão à fonte de dados?

  • Se o teste de conectividade foi bem-sucedido anteriormente, execute-o novamente para confirmar se o grupo de recursos e o banco de dados estão conectados no momento (e se nenhuma alteração foi feita no lado do banco de dados).

  • Verifique se o grupo de recursos que passou no teste de conectividade é o mesmo utilizado para executar a tarefa.

    Verifique o grupo de recursos usado pela tarefa:

    • Se a tarefa for executada no grupo de recursos padrão, os logs conterão as seguintes informações: running in Pipeline[basecommon_ group_xxxxxxxxx]

    • Se a tarefa for executada em um grupo de recursos exclusivo para Data Integration, os logs conterão as seguintes informações: running in Pipeline[basecommon_S_res_group_xxx]

    • Se a tarefa for executada em um grupo de recursos serverless, os logs conterão as seguintes informações: running in Pipeline[basecommon_Serverless_res_group_xxx]

  • Caso a tarefa falhe ocasionalmente durante o agendamento nas primeiras horas da manhã, mas seja bem-sucedida após uma nova execução, verifique a carga do banco de dados no momento em que o erro ocorreu.

A tarefa de sincronização em lote apresenta sucesso e falha intermitentes

Se uma tarefa de sincronização em lote falhar intermitentemente, a causa pode ser uma configuração incompleta da lista de permissões. Verifique se a lista de permissões do banco de dados está totalmente configurada.

Ao utilizar um grupo de recursos exclusivo para Data Integration:

  • Se você adicionou anteriormente os endereços IP da interface de rede elástica (ENI) do grupo de recursos exclusivo para Data Integration à lista de permissões da fonte de dados e o grupo de recursos teve seu dimensionamento expandido desde então, atualize a lista de permissões da fonte de dados para incluir os endereços IP da ENI do grupo de recursos expandido.

  • Para evitar a necessidade de atualizar a lista de permissões sempre que o grupo de recursos tiver seu dimensionamento expandido, recomendamos adicionar o bloco CIDR do vSwitch associado ao grupo de recursos exclusivo para Data Integration como a lista de permissões do banco de dados. Para mais informações, consulte Add an allowlist.

Ao utilizar um grupo de recursos serverless: consulte Network connectivity of a serverless resource group para verificar a configuração da lista de permissões do grupo de recursos e garantir que a rede esteja configurada corretamente.

Se a lista de permissões estiver configurada corretamente, verifique se a carga do banco de dados está excessivamente alta, o que pode causar interrupções nas conexões.

Configurações de recursos

A tarefa de sincronização em lote falha com o erro: [TASK_MAX_SLOT_EXCEED]:Unable to find a gateway that meets resource requirements. 20 slots are requested, but the maximum is 16 slots.

  • Possível causa:

    A concorrência está definida com um valor muito alto, resultando em recursos insuficientes.

  • Solução:

    Reduza a concorrência da tarefa de sincronização em lote.

    • Se você configurar a tarefa de sincronização em lote no modo assistente, reduza o valor de Expected Maximum Concurrency em Channel Control. Para mais informações, consulte Configure channel control in wizard mode.

    • Se você configurar a tarefa de sincronização em lote no modo script, reduza o valor do parâmetro concurrent em Channel Control. Para mais informações, consulte Configure channel control in script mode.

A tarefa de sincronização em lote falha com o erro: OutOfMemoryError: Java heap space

Para resolver este erro:

  1. Se a configuração do plugin suportar parâmetros como batchsize ou maxfilesize, reduza os valores correspondentes.

    Você pode verificar se cada plugin suporta os parâmetros mencionados acima. Acesse o tópico Supported data sources and readers/writers e clique no plugin correspondente para visualizar os detalhes dos parâmetros.

  2. Reduza a concorrência.

    • Se você configurar a tarefa de sincronização em lote no modo assistente, reduza o valor de Expected Maximum Concurrency em Channel Control. Para mais informações, consulte Configure channel control in wizard mode.

    • Se você configurar a tarefa de sincronização em lote no modo script, reduza o valor do parâmetro concurrent em Channel Control. Para mais informações, consulte Configure channel control in script mode.

  3. Se estiver sincronizando arquivos, como arquivos do OSS, reduza o número de arquivos a serem lidos.

  4. Na seção Running Resources da configuração da tarefa, aumente adequadamente o valor de Resource Usage (CU). Defina o valor de CU com cuidado para evitar afetar outras tarefas em execução.

Conflitos de execução de instâncias

A tarefa de sincronização em lote falha com o erro: Duplicate entry 'xxx' for key 'uk_uk_op'

  • Mensagem de erro: Error updating database. Cause: com.mysql.jdbc.exceptions.jdbc4.MySQLIntegrityConstraintViolationException: Duplicate entry 'cfc68cd0048101467588e97e83ffd7a8-0' for key 'uk_uk_op'.

  • Possível causa: O Data Integration não permite que diferentes instâncias do mesmo nó (ou seja, tarefas de sincronização com a mesma configuração JSON) sejam executadas simultaneamente. Por exemplo, se uma tarefa de sincronização for executada em um cronograma de 5 minutos e atrasos upstream fizerem com que tanto a instância das 00:00 quanto a das 00:05 sejam acionadas às 00:05, uma das instâncias não poderá ser iniciada. Isso também pode ocorrer quando você faz backfill de dados ou reexecuta uma instância enquanto a instância da tarefa ainda está em execução.

  • Solução: Intercale os horários de execução das instâncias. Para tarefas agendadas em intervalos de hora ou minuto, recomendamos definir a autodependência para que a instância atual inicie somente após a conclusão da instância do ciclo anterior. Para configuração no Data Studio legado, consulte Self-dependency. Para configuração no novo Data Studio, consulte Configure self-dependency.

Timeout de execução

Tarefa de sincronização em lote com MongoDB como source falha com erro: MongoDBReader$Task - operation exceeded time limitcom.mongodb.MongoExecutionTimeoutException: operation exceeded time limit.

  • Detalhes do erro: Durante uma tarefa de sincronização de dados, a tarefa falha com o seguinte erro: MongoDBReader$Task - operation exceeded time limitcom.mongodb.MongoExecutionTimeoutException: operation exceeded time limit.

  • Causa possível: O volume de dados na extração completa é muito grande.

  • Solução:

    • Aumente a concorrência.

    • Reduza o BatchSize.

    • Adicione a configuração cursorTimeoutInMs na seção de parâmetros do Reader e defina um valor alto, como 3600000 ms.

Tarefa de sincronização em lote com MySQL como source de dados falha com erro de timeout de conexão: Communications link failure

  • Erro de leitura

    • Sintoma:

      Ao ler dados, ocorre o seguinte erro: Communications link failure The last packet successfully received from the server was 7,200,100 milliseconds ago. The last packet sent successfully to the server was 7,200,100 milliseconds ago. - com.mysql.jdbc.exceptions.jdbc4.CommunicationsException: Communications link failure

    • Causa possível:

      O banco de dados executa consultas SQL lentamente, causando timeout de leitura no MySQL.

    • Solução:

      • Verifique se há uma condição de filtro where configurada e garanta que as colunas de filtro estejam indexadas.

      • Confira se a tabela de origem contém dados em excesso. Nesse caso, divida a tarefa em várias tarefas menores.

      • Analise os logs para identificar a instrução SQL que causou o bloqueio e consulte o administrador do banco de dados para resolver o problema.

  • Erro de escrita

    • Sintoma:

      Ao gravar dados, ocorre o seguinte erro: Caused by: java.util.concurrent.ExecutionException: ERR-CODE: [TDDL-4614][ERR_EXECUTE_ON_MYSQL] Error occurs when execute on GROUP 'xxx' ATOM 'dockerxxxxx_xxxx_trace_shard_xxxx': Communications link failure The last packet successfully received from the server was 12,672 milliseconds ago. The last packet sent successfully to the server was 12,013 milliseconds ago. More...

    • Causa possível:

      Uma consulta lenta causa SocketTimeout. O SocketTimeout padrão para conexões TDDL é de 12 segundos. Se uma instrução SQL levar mais de 12 segundos para executar no MySQL, o erro 4614 será reportado. Esse erro pode ocorrer ocasionalmente quando o volume de dados é grande ou o servidor está sobrecarregado.

    • Solução:

      • Aguarde a estabilização do banco de dados e execute novamente a tarefa de sincronização.

      • Entre em contato com o administrador do banco de dados para ajustar o valor de timeout.

Como solucionar problemas de uma tarefa de sincronização em lote com execução demorada?

Causa possível 1: Execução excessivamente longa

  • Instruções pre-SQL ou post-SQL (como preSql e postSql) demoram muito para executar no banco de dados, tornando a tarefa lenta.

  • A chave de divisão não está configurada adequadamente, resultando em execução lenta.

    A sincronização em lote utiliza a chave de divisão (splitPk) para fragmentar os dados e inicia tarefas concorrentes de sincronização, aumentando a eficiência. Consulte a documentação de cada plugin específico para verificar se é necessário configurar uma chave de divisão.

Solução 1:

  • Caso existam instruções pre-SQL ou post-SQL configuradas, utilize colunas indexadas para filtragem de dados.

  • Se a chave de divisão for suportada, configure-a corretamente. O exemplo abaixo ilustra a configuração da chave de divisão no plugin MySQL Reader:

    • Recomenda-se usar a chave primária da tabela como splitPk, pois chaves primárias geralmente têm distribuição uniforme, evitando hotspots de dados nos shards resultantes.

    • Atualmente, o splitPk suporta apenas fragmentação de dados baseada em inteiros, não aceitando strings, ponto flutuante, datas ou outros tipos. Ao especificar um tipo não suportado, a sincronização usará canal único.

    • Se o splitPk estiver vazio ou não for especificado, a sincronização de dados utilizará um único canal para sincronizar os dados da tabela.

Causa possível 2: Aguardando recursos de execução do Data Integration

Solução 2: Se os logs mostrarem status WAIT prolongado, o grupo de recursos exclusivo do Data Integration usado pela tarefa atual não possui concorrência disponível suficiente para executá-la. Para detalhes sobre a causa e a solução, consulte Troubleshoot resource group concurrency issues.

Nota

Como uma tarefa de sincronização em lote é despachada de um grupo de recursos de agendamento para um grupo de recursos de execução do Data Integration, cada tarefa consome um recurso de agendamento. Se uma tarefa de sincronização em lote rodar por um período estendido sem liberar recursos, ela poderá bloquear não apenas outras tarefas de sincronização em lote, mas também outros tipos de tarefas agendadas.

O que fazer quando uma tarefa de sincronização fica lenta devido a varredura completa de tabela causada por cláusula WHERE sem índice?

  • Exemplo de cenário

    O SQL executado é o seguinte:

    SELECT bid,inviter,uid,createTime FROM `relatives` WHERE createTime>='2016-10-2300:00:00' AND reateTime<'2016-10-24 00:00:00';

    A execução iniciou em 2016-10-25 11:01:24.875 e os resultados começaram a retornar em 2016-10-25 11:11:05.489. O programa de sincronização aguardou o banco de dados retornar os resultados da consulta SQL, e o MaxCompute precisou esperar muito tempo antes de prosseguir com a execução.

  • Análise da causa raiz

    A coluna createTime na cláusula WHERE não possui índice, provocando varredura completa da tabela.

  • Solução

    Recomenda-se que a cláusula where utilize colunas indexadas para melhorar o desempenho. Também é possível adicionar índices conforme necessário.

Alternar grupo de recursos

Como alterar o grupo de recursos de execução de uma tarefa de sincronização em lote?

Data Studio legado:

É possível modificar o grupo de recursos usado para depuração na página de detalhes da tarefa de sincronização em lote no DataStudio. Também é possível alterar o grupo de recursos de execução de tarefas do Data Integration usado durante o agendamento no Operation Center. Para mais informações, consulte Switch the Data Integration resource group.

Novo Data Studio:

É possível modificar o grupo de recursos usado para depurar tarefas do Data Integration no DataStudio. Também é possível alterar o grupo de recursos de execução de tarefas do Data Integration usado durante o agendamento no Operation Center. Para mais informações, consulte Switch the Data Integration resource group.

Dados incorretos

Como identificar e localizar dados incorretos?

Dados incorretos: Registro que falha ao ser gravado no destino devido a uma exceção.

Impacto dos dados incorretos: Esses registros não são gravados no destino. É possível controlar se dados incorretos são permitidos e definir o número máximo de registros desse tipo. Por padrão, o Data Integration permite dados incorretos. Você pode especificar o limiar de dados incorretos ao configurar uma tarefa de sincronização. Para mais informações, consulte Configure channel control in wizard mode.

  • Se a tarefa permitir dados incorretos: A execução continua mesmo quando surgem dados incorretos, mas esses registros são descartados e não gravados no destino.

  • Controle da quantidade permitida de dados incorretos:

    • Se o limite permitido for definido como 0, a tarefa falhará e será encerrada assim que qualquer dado incorreto for gerado.

    • Se o limite permitido for definido como x, a tarefa falhará e será encerrada quando a contagem de dados incorretos ultrapassar x. Caso a contagem seja inferior a x, a tarefa continuará executando, porém os dados incorretos serão descartados e não gravados no destino.

Análise de cenários com dados incorretos:

  • Cenário 1:

    • Mensagem de erro: {"message":"Dirty data encountered when writing to the ODPS destination table: An error occurred in the data of field [3]. Please check the data and make corrections, or you can increase the threshold to ignore this record.","record":[{"byteSize":0,"index":0,"type":"DATE"},{"byteSize":0,"index":1,"type":"DATE"},{"byteSize":1,"index":2,"rawData":0,"type":"LONG"},{"byteSize":0,"index":3,"type":"STRING"},{"byteSize":1,"index":4,"rawData":0,"type":"LONG"},{"byteSize":0,"index":5,"type":"STRING"},{"byteSize":0,"index":6,"type":"STRING"}]}.

    • Como proceder: O log indica a coluna com dado incorreto. A terceira coluna apresenta anomalia.

      • O writer reporta o dado incorreto. Verifique a instrução DDL da tabela de destino. O tamanho da coluna especificado para a tabela ODPS é menor que o tamanho real dos dados na coluna correspondente do MySQL.

      • Princípio de sincronização de dados: Os dados do source devem ser graváveis no destino (os tipos de source e destino precisam ser compatíveis e as definições de tamanho das colunas devem corresponder). Especificamente, o tipo de dado do source deve ser compatível com o tipo do destino. Por exemplo, dados VARCHAR do source não podem ser gravados em uma coluna INT no destino. O tamanho da coluna de destino deve ser suficiente para acomodar o tamanho real dos dados mapeados do source. Dados de tipos como LONG, VARCHAR e DOUBLE podem ser armazenados em tipos mais amplos, como string ou text, no destino.

      • Se a mensagem de erro de dado incorreto não for clara, copie todo o registro de dado incorreto do log, examine os dados e compare-os com os tipos de dados do destino para identificar quais colunas estão fora de conformidade.

      Por exemplo:

      {"byteSize":28,"index":25,"rawData":"ohOM71vdGKqXOqtmtriUs5QqJsf4","type":"STRING"}

      byteSize: contagem de bytes; index: 25, a 26ª coluna; rawData: valor real; type: tipo de dado.

  • Cenário 2:

    • Mensagem de erro: O DataX reporta dados incorretos ao ler valores nulos do MySQL.

    • Como proceder: Verifique se o tipo de dado da coluna de origem com valores nulos corresponde ao tipo da coluna mapeada no destino. Incompatibilidade de tipos gera erro. Por exemplo, gravar um valor nulo do tipo string em uma coluna de destino do tipo int resulta em erro.

  • Cenário 3:

    • Mensagem de erro: Os tipos de campo de origem e destino são incompatíveis. Por exemplo, um campo de origem do Simple Log Service (SLS) é lido como STRING, mas a coluna de destino mapeada está definida como INT ou outro tipo não textual.

    • Como proceder: O Data Integration valida os tipos de campo antes de gravar os dados. Se o tipo do campo de origem for incompatível com o tipo do campo de destino, o registro será identificado como dado incorreto e interceptado, nunca sendo gravado no destino. Garanta que os tipos de campo de origem e destino sejam iguais ou compatíveis. Por exemplo, altere o campo de destino para VARCHAR para receber o valor ou converta o tipo de dado antes da sincronização.

      Nota

      Um trigger do MySQL na tabela de destino não resolve esse tipo de dado incorreto. O Data Integration intercepta registros com tipos de campo incompatíveis antes que eles cheguem ao banco de dados de destino, portanto nenhuma operação INSERT ou UPDATE ocorre na tabela de destino e o trigger nunca é acionado. Garanta a compatibilidade dos tipos de campo ao configurar a tarefa de sincronização no DataWorks.

Como visualizar dados incorretos?

Você pode view the task logs e clicar em Detail log url nos logs para obter o runtime log detalhado e informações sobre dados incorretos.

DI Submit at       : 2023-01-04 00:21:05
DI Start at        : 2023-01-04 00:21:07
DI Finish at       : 2023-01-04 07:00:05

2023-01-04 07:00:06 : Use "cdp job -log xxx" for more detail.
2023-01-04 07:00:06 :Detail log url: https://di-cn-chengdu.data.aliyun.com/web/di/insxxx
Exit with SUCCESS.
2023-01-04 07:00:06 [INFO] Sandbox context cleanup temp file success.
2023-01-04 07:00:06 [INFO] Data synchronization ended with return code: [0].
2023-01-04 07:00:06 INFO ============================================================

Se a quantidade de dados incorretos exceder o limite durante uma tarefa de sincronização em lote, os dados já sincronizados são mantidos?

A tarefa acumula a contagem de registros de dados incorretos durante a execução. Assim que essa contagem ultrapassa o limiar configurado, a tarefa é encerrada imediatamente.

  • Retenção de dados: Os dados gravados com sucesso no destino antes do término da tarefa são preservados. Nenhum rollback é realizado.

  • Política de tolerância zero: Quando o limiar de dados incorretos é definido como 0, o sistema adota tolerância zero. Isso significa que a tarefa falha e para imediatamente ao detectar o primeiro registro de dado incorreto.

Como lidar com erros de dados incorretos causados por configurações de codificação ou caracteres corrompidos?

  • Mensagem de erro:

    Se os dados contiverem caracteres emoji, erros de dados incorretos podem ocorrer durante a sincronização: [13350975-0-0-writer] ERROR StdoutPluginCollector - Dirty data {"exception":"Incorrect string value: '\\xF0\\x9F\\x98\\x82\\xE8\\xA2...' for column 'introduction' at row 1","record":[{"byteSize":8,"index":0,"rawData":9642,"type":"LONG"}],"type":"writer"} .

  • Causa possível:

    • A codificação do banco de dados não está definida como utf8mb4, o que causa erros ao sincronizar caracteres emoji.

    • Os dados de origem já contêm caracteres corrompidos.

    • Há inconsistência entre a codificação do banco de dados e a do cliente.

    • A codificação do navegador é diferente, causando falhas na pré-visualização ou exibição de caracteres corrompidos.

  • Solução:

    Escolha a solução adequada com base na causa dos caracteres corrompidos:

    • Se os dados originais contiverem caracteres corrompidos, corrija-os antes de executar a tarefa de sincronização.

    • Se houver inconsistência entre os formatos de codificação do banco de dados e do cliente, modifique o formato de codificação primeiro.

    • Se a codificação do navegador for diferente da codificação do banco de dados ou do cliente, unifique os formatos de codificação antes de pré-visualizar os dados.

    Você pode tentar o seguinte:

    1. Para fontes de dados adicionadas no formato JDBC, modifique para utf8mb4 da seguinte forma: jdbc:mysql://xxx.x.x.x:3306/database?com.mysql.jdbc.faultInjection.serverCharsetIndex=45.

    2. Para fontes de dados adicionadas por ID de instância, anexe o seguinte ao nome do banco de dados: database?com.mysql.jdbc.faultInjection.serverCharsetIndex=45.

    3. Modifique o formato de codificação do banco de dados para utf8mb4. Por exemplo, altere o formato de codificação do banco de dados RDS no console do RDS.

      Nota

      Comando para definir o formato de codificação da fonte de dados RDS: set names utf8mb4. Comando para verificar o formato de codificação do banco de dados RDS: show variables like 'char%'.

Sincronização para MaxCompute falha ou trunca dados porque um único campo excede o limite de 8 MB

  • Cenário: Ao sincronizar dados para o MaxCompute (ODPS), a tarefa falha ou os dados gravados são truncados porque um campo de origem excede 8 MB.

  • Causa: Em tarefas de sincronização que usam MaxCompute como destino, o MaxCompute (ODPS) Writer impõe um limite de tamanho de 8 MB por campo.

  • Solução:

    • Nas configurações avançadas do MaxCompute (ODPS) Writer, defina a política de tratamento de campos com tamanho excedido (overLengthRule) para especificar como lidar com campos acima do limite: truncar o campo para 8 MB, definir o campo como NULL ou gravar o campo sem truncamento.

    • Para cenários que envolvem objetos grandes, como arquivos ou logs, armazene os dados brutos no Object Storage Service (OSS) e mantenha apenas a URL no banco de dados. Em seguida, use o DataWorks para sincronizar a URL em vez do objeto grande em si.

    • Como etapa de pré-processamento, divida um campo com tamanho excedido em vários subcampos menores na origem, por exemplo, em segmentos de 7 MB. Sincronize os subcampos separadamente e concatene-os novamente no destino.

Nota

O limite de tamanho de campo de 8 MB e a configuração avançada overLengthRule aplicam-se ao MaxCompute (ODPS) Writer. Outros destinos de sincronização podem aplicar limites diferentes.

Retenção de valores padrão

O Data Integration preserva propriedades como valores padrão e restrições not-null ao criar uma tabela de destino?

Ao criar uma tabela de destino, o DataWorks preserva apenas os nomes das colunas, tipos de dados e comentários da tabela de origem. Ele não preserva valores padrão nem restrições (incluindo restrições not-null e índices).

Chave de divisão

Uma chave primária composta pode ser usada como chave de divisão em uma tarefa de sincronização em lote?

Tarefas de sincronização em lote não suportam o uso de chave primária composta como chave de divisão.

Sincronização incremental falha com erro DBUtilErrorCode-04, indicando que a coluna de chave primária é inválida

  • Cenário: Uma tarefa de sincronização incremental falha com um erro indicando que a coluna de chave de divisão configurada (splitPk) é inválida.

  • Causa possível: A configuração da chave de divisão não atende aos requisitos. Por exemplo, múltiplas colunas foram configuradas como chave de divisão, o tipo de dado da coluna configurada não é suportado ou a coluna configurada não existe na tabela.

  • Solução:

    1. Atualize o mapeamento da tabela de origem para visualizar a coluna de chave de divisão sugerida automaticamente pelo sistema.

    2. Certifique-se de que apenas uma única coluna esteja configurada como chave de divisão e que seu tipo de dado seja inteiro. Conforme descrito anteriormente neste documento, o splitPk suporta apenas fragmentação de dados baseada em inteiros e não aceita strings, ponto flutuante, datas ou outros tipos.

    3. Se a coluna sugerida automaticamente não atender a essas condições, altere manualmente a chave de divisão para uma única coluna de tipo inteiro que atenda aos requisitos.

Para mais informações sobre como a chave de divisão afeta o desempenho da sincronização, consulte How do I troubleshoot a batch synchronization task that takes a long time to run?

Dados ausentes

A sincronização de dados é concluída, mas os dados da tabela de destino estão inconsistentes com os da tabela de origem

Se ocorrerem problemas de qualidade de dados após a sincronização, consulte Troubleshoot data quality issues after synchronization para troubleshooting detalhado.

Ataques SSRF

A tarefa apresenta ataques SSRF** Task have SSRF attacks **Como lidar com isso?

P: Como resolver o erro "Task have SSRF attacks"?

Causa: Para garantir a segurança na cloud, o DataWorks proíbe que tarefas acessem endereços internos da rede cloud por meio de endereços IP públicos. Quando uma URL na configuração do plugin (como HTTP Reader) aponta para um endereço IP interno ou nome de domínio VPC, essa verificação de segurança é acionada.

Abordagem correta:

Solução: Para tarefas que acessam fontes de dados internas, pare de usar o grupo de recursos compartilhado e migre para um serverless resource group seguro (recomendado) ou um exclusive resource group for Data Integration.

Escrita de datas

Como preservar milissegundos ou especificar um formato personalizado de data e hora ao gravar dados temporais em texto?

Altere a tarefa de sincronização para o modo script e adicione a seguinte configuração na seção setting da página de configuração da tarefa:

"common": {
  "column": {
    "dateFormat": "yyyyMMdd",
    "datetimeFormatInNanos": "yyyyMMdd HH:mm:ss.SSS"
  }
}

Onde:

  • dateFormat especifica o formato de data usado ao converter dados do tipo DATE (sem hora) da origem para texto.

  • datetimeFormatInNanos especifica o formato de data usado ao converter dados do tipo DATETIME/TIMESTAMP (com hora) da origem para texto. É possível especificar precisão até milissegundos.

MaxCompute

Observações ao adicionar linha ou coluna no mapeamento de colunas durante a leitura de dados de tabela MaxCompute (ODPS)

  1. É possível inserir constantes. Os valores devem estar entre aspas simples, como 'abc' e '123'.

  2. Parâmetros de agendamento podem ser utilizados, como '${bizdate}'. Para informações sobre como usar parâmetros de agendamento, consulte Configure scheduling parameters.

  3. É possível inserir as colunas de partição a serem sincronizadas, como pt.

  4. Se o valor inserido não puder ser analisado, o tipo será exibido como 'Custom'.

  5. Funções ODPS não são suportadas.

  6. Se uma coluna adicionada manualmente for exibida como Custom (por exemplo, uma coluna de partição do MaxCompute ou uma coluna do LogHub não mostrada na pré-visualização de dados), isso não afeta a execução real da tarefa.

Como sincronizar colunas de partição ao ler dados de tabela MaxCompute (ODPS)?

Na lista de mapeamento de colunas, clique em Add ou Create Field abaixo das colunas da tabela de origem, insira o nome da coluna de partição (como pt) e configure o mapeamento para a coluna da tabela de destino.

Como sincronizar dados de múltiplas partições ao ler dados de tabela MaxCompute (ODPS)?

Especifique as informações de partição dos dados a serem lidos.

  • A configuração de partição ODPS suporta wildcards do shell Linux: * corresponde a zero ou mais caracteres e ? corresponde a qualquer caractere único.

  • Por padrão, a partição especificada deve existir. Caso contrário, a tarefa falhará. Se desejar que a tarefa seja bem-sucedida mesmo quando a partição não existir, defina When partitions do not exist, como: ignorar partições inexistentes e executar a tarefa normalmente. Alternativamente, mude para o modo script e adicione "successOnNoPartition": true na seção ODPS Parameter.

Por exemplo, se a tabela particionada test possuir quatro partições: pt=1,ds=hangzhou, pt=1,ds=shanghai, pt=2,ds=hangzhou e pt=2,ds=beijing, as configurações para leitura de diferentes partições são as seguintes:

  • Para ler dados da partição pt=1,ds=hangzhou, defina as informações de partição como "partition":"pt=1,ds=hangzhou".

  • Para ler dados de todas as partições sob pt=1, defina as informações de partição como "partition":"pt=1,ds=*".

  • Para ler dados de todas as partições da tabela test, defina as informações de partição como "partition":"pt=*,ds=*".

Também é possível definir condições para recuperação de dados de partição conforme suas necessidades (as operações abaixo exigem modo script):

  • Para especificar a partição máxima, adicione a seguinte configuração: /*query*/ ds=(select MAX(ds) from DataXODPSReaderPPR).

  • Para filtrar por condição, adicione a condição relevante com a configuração /*query*/ pt+expression. Por exemplo, /*query*/ pt>=20170101 and pt<20170110 recupera todos os dados da partição pt de 20170101 (inclusivo) a 20170110 (exclusivo).

Nota

/*query*/ indica que o conteúdo subsequente é reconhecido como uma condição WHERE.

Como implementar filtragem de colunas, reordenação e preenchimento de nulos no MaxCompute

Ao configurar o MaxCompute Writer, é possível realizar operações de filtragem de colunas, reordenação e preenchimento de nulos que o próprio MaxCompute não suporta nativamente. Por exemplo, para importar todas as colunas, configure "column": ["*"].

Se a tabela MaxCompute tiver três colunas a, b e c, e você quiser sincronizar apenas as colunas c e b, configure a lista de colunas como "column": ["c","b"]. Isso significa que a primeira e a segunda colunas do Reader serão importadas para as colunas c e b da tabela MaxCompute, e a nova coluna inserida a na tabela MaxCompute será definida como nula.

Tratamento de erros de configuração de colunas no MaxCompute

Para garantir a confiabilidade da gravação de dados e evitar problemas de qualidade causados por perda de dados em colunas extras, o MaxCompute Writer reporta erro se colunas adicionais forem gravadas. Por exemplo, se a tabela MaxCompute tiver as colunas a, b e c, e o MaxCompute Writer tentar gravar mais de três colunas, um erro será reportado.

Sincronização em lote falha quando a tabela de destino MaxCompute contém uma coluna do tipo JSON

  • Cenário: Uma tarefa de sincronização em lote que grava no MaxCompute (ODPS) falha, e o troubleshooting mostra que a tabela de destino contém uma coluna do tipo JSON.

  • Causa possível: O MaxCompute Writer pode não suportar gravação em coluna de destino do tipo JSON em todos os casos.

  • Solução: Verifique o schema da tabela MaxCompute de destino para confirmar se ela contém uma coluna do tipo JSON. Em caso afirmativo, tente um dos métodos a seguir:

    • Altere o tipo da coluna para STRING no lado do MaxCompute, por exemplo, executando ALTER TABLE ADD COLUMN ou uma alteração de schema equivalente.

    • Exclua a coluna do tipo JSON do mapeamento de campos para que ela não seja gravada durante a sincronização.

Observações sobre configuração de partições no MaxCompute

O MaxCompute Writer suporta gravação apenas na partição de último nível e não oferece roteamento de partição baseado em coluna. Se uma tabela tiver três níveis de partição, você deve especificar exatamente a partição de terceiro nível na configuração. Por exemplo, para gravar dados na partição de terceiro nível, configure como pt=20150101, type=1, biz=2. Não é possível configurar como pt=20150101, type=1 ou pt=20150101.

Reexecução e failover de tarefas no MaxCompute

O MaxCompute Writer garante idempotência de gravação ao configurar "truncate": true. Quando uma gravação falha e é reexecutada, o MaxCompute Writer limpa os dados anteriores e importa novos dados, garantindo consistência após cada reexecução. Se a tarefa for interrompida devido a outras exceções durante a execução, a atomicidade dos dados não é garantida. Os dados não sofrem rollback nem reexecução automática. Utilize o recurso de idempotência para reexecutar a tarefa e garantir a integridade dos dados.

Nota

Quando truncate é definido como true, todos os dados na partição ou tabela especificada são apagados. Use essa configuração com cautela.

Leitura de dados de tabela MaxCompute (ODPS) falha com erro: The download session is expired.

  • Mensagem de erro:

    Code:DATAX_R_ODPS_005:Failed to read ODPS data, Solution:[Please contact the ODPS administrator]. RequestId=202012091137444331f60b08cda1d9, ErrorCode=StatusConflict, ErrorMessage=The download session is expired.

  • Causa possível:

    Ao ler dados do MaxCompute em sincronização em lote, o sistema usa o comando tunnel do MaxCompute para upload e download de dados. Uma sessão Tunnel tem tempo de vida de 24 horas no servidor. Portanto, se uma tarefa de sincronização em lote executar por mais de 24 horas, ela falhará. Para mais informações sobre tunnel, consulte Tunnel overview.

  • Solução:

    Aumente a concorrência da tarefa de sincronização em lote e planeje adequadamente o volume de dados para garantir que a tarefa seja concluída dentro de 24 horas.

Gravação no MaxCompute (ODPS) falha com erro de bloco: Error writing request body to server

  • Mensagem de erro:

    Code:[OdpsWriter-09], Description:[Failed to write data to the ODPS destination table.]. - Failed to write block:0 to the ODPS destination table, uploadId=[202012081517026537dc0b0160354b]. Please contact the ODPS administrator for assistance. - java.io.IOException: Error writing request body to server。

  • Causa possível:

    • Possível causa 1: Exceção de tipo de dado, ou seja, os dados de origem não estão em conformidade com as especificações de tipo de dado do ODPS. Por exemplo, gravar o valor 4.2223 em um tipo de dado decimal(18,10) no ODPS.

    • Possível causa 2: Exceção de bloco ODPS ou de comunicação.

  • Solução:

    Converta os tipos de dados e utilize dados que estejam em conformidade com as especificações de tipo.

Sincronização em lote de banco completo para MaxCompute falha com erro: cdc mode not supported

  • Cenário: Uma tarefa de sincronização em lote de banco completo para MaxCompute falha com ErrorCode=MethodNotAllowed, ErrorMessage=cdc mode not supported.

  • Causa possível: Os atributos transacionais ou de captura de dados alterados (CDC) da tabela MaxCompute de destino podem não corresponder ao modo de gravação utilizado pela tarefa de sincronização.

  • Solução: Verifique se a tabela de destino foi criada com atributos CDC ou transacionais incompatíveis com o modo de gravação da tarefa de sincronização atual. Se não tiver certeza sobre os atributos da tabela, entre em contato com o suporte técnico para confirmação adicional.

Por que o grupo de recursos Serverless não aparece ao selecionar o grupo de recursos Tunnel para destino MaxCompute?

  • Cenário: Ao configurar uma tarefa de sincronização em lote com MaxCompute como destino, o seletor Tunnel resource group na configuração do destino não lista um Serverless resource group adquirido.

  • Causa: O grupo de recursos Tunnel e o grupo de recursos que executa a tarefa de sincronização, como um Serverless resource group, são dois itens de configuração independentes com finalidades distintas. O grupo de recursos Tunnel é usado exclusivamente para transmissão de upload e download de dados do MaxCompute e utiliza, por padrão, o recurso público de transmissão, ou seja, a cota MaxCompute Tunnel. O grupo de recursos que executa a tarefa serve apenas para rodar a tarefa de sincronização em si, incluindo leitura da origem, processamento de dados e agendamento. Como as duas configurações atendem a propósitos diferentes, elas são independentes e não podem ser usadas de forma intercambiável.

Nota

As opções no seletor de grupo de recursos Tunnel provêm das cotas de transmissão MaxCompute Tunnel disponíveis para sua conta. Elas não são intercambiáveis com os grupos de recursos que executam tarefas de sincronização.

MySQL

Como sincronizar tabelas MySQL fragmentadas para uma única tabela do MaxCompute

Consulte o seguinte documento para obter detalhes sobre a configuração: Synchronize sharded MySQL tables to MaxCompute.

Como lidar com caracteres chineses corrompidos ao sincronizar para uma tabela MySQL com conjunto de caracteres utf8mb4?

Adicione a fonte de dados usando uma string de conexão. Recomendamos modificar a URL JDBC para: jdbc:mysql://xxx.x.x.x:3306/database?com.mysql.jdbc.faultInjection.serverCharsetIndex=45. Para mais informações, consulte Add a MySQL data source.

Falha na escrita/leitura do MySQL com erro: Application was streaming results when the connection failed. Consider raising value of 'net_write_timeout/net_read_timeout' on the server.

  • Causa do erro:

    • net_read_timeout: O DataX divide os dados do MySQL em várias instruções SELECT de tamanho igual com base no SplitPk. Durante a execução, uma das instruções SQL excede o tempo máximo de execução permitido no lado do RDS.

    • net_write_timeout: O tempo limite de espera para enviar um bloco ao cliente está configurado com um valor muito baixo.

  • Solução:

    Adicione o parâmetro à URL de conexão da fonte de dados, defina net_write_timeout/net_read_timeout com um valor maior ou ajuste o parâmetro no console do RDS.

  • Sugestão de melhoria:

    Se a tarefa puder ser reexecutada, configure-a para reexecução automática em caso de erro.

Por exemplo: jdbc:mysql://192.168.1.1:3306/lizi?useUnicode=true&characterEncoding=UTF8&net_write_timeout=72000

Falha na sincronização em lote para o MySQL com erro: [DBUtilErrorCode-05]ErrorMessage: Code:[DBUtilErrorCode-05]Description:[Failed to write data to the configured destination table.]. - com.mysql.jdbc.exceptions.jdbc4.MySQLNonTransientConnectionException: No operations allowed after connection closed

Causa do erro:

O parâmetro do MySQL wait_timeout tem como padrão 8 horas. Se os dados ainda estiverem sendo buscados quando esse tempo limite for atingido, a tarefa de sincronização será interrompida.

Solução:

Modifique o arquivo de configuração do MySQL my.cnf (ou my.ini no Windows). Adicione o parâmetro sob o módulo do MySQL (em segundos): wait_timeout=2592000 interactive_timeout=2592000. Em seguida, reinicie e faça login no MySQL, e execute a seguinte instrução para verificar: show variables like '%wait_time%'.

Falha na leitura do banco de dados MySQL com erro: The last packet successfully received from the server was 902,138 milliseconds ago

Uso normal de CPU, mas alto uso de memória, pode causar o encerramento da conexão.

Se você confirmar que a tarefa pode ser reexecutada automaticamente, recomendamos ativar a Reexecução Automática em Caso de Erro. Para mais informações, consulte Configure auto rerun.

PostgreSQL

Falha na leitura de dados do PostgreSQL com erro: org.postgresql.util.PSQLException: FATAL: terminating connection due to conflict with recovery

  • Cenário: Ao sincronizar dados do PostgreSQL com a ferramenta de sincronização em lote, ocorre o seguinte erro: org.postgresql.util.PSQLException: FATAL: terminating connection due to conflict with recovery

  • Possível causa: Esse erro ocorre porque a extração de dados do banco de dados demora muito. Aumente os valores de max_standby_archive_delay e max_standby_streaming_delay. Para mais informações, consulte Standby Server Events.

Falha na sincronização em tempo real do AWS PostgreSQL para o MaxCompute com erro de privilégio REPLICATION ausente

  • Cenário: Uma tarefa de sincronização em tempo real do AWS PostgreSQL para o MaxCompute falha porque o usuário do PostgreSQL de origem não possui o privilégio REPLICATION.

  • Possível causa: O usuário do PostgreSQL de origem não tem o privilégio REPLICATION. Em algumas instâncias gerenciadas do AWS RDS PostgreSQL, esse atributo não pode ser concedido usando ALTER ROLE.

  • Solução: A sincronização em lote (offline, agendada) não exige o privilégio REPLICATION. Se não for possível conceder o privilégio REPLICATION na sua instância do AWS PostgreSQL, utilize uma tarefa de sincronização em lote com agendamento periódico em vez da sincronização em tempo real como solução alternativa.

Desvio de fuso horário após sincronizar uma coluna timestamp do PostgreSQL para uma coluna DATETIME do MaxCompute

  • Cenário: Após sincronizar uma coluna timestamp (sem fuso horário) do PostgreSQL para uma coluna DATETIME do MaxCompute, o valor resultante apresenta um desvio, por exemplo, de 2 horas, em relação ao valor esperado.

  • Possível causa: O tipo timestamp (sem fuso horário) do PostgreSQL armazena o valor da hora local exatamente como recebido. Já o tipo DATETIME do MaxCompute armazena valores em UTC e os converte para exibição com base no fuso horário do projeto ou da sessão. Essa diferença no comportamento de armazenamento e conversão pode causar um desvio de fuso horário.

  • Solução:

    1. Verifique se o fuso horário do servidor PostgreSQL, obtido executando SHOW timezone;, corresponde ao fuso horário do projeto MaxCompute. Você pode visualizar o fuso horário do projeto na página Basic Information do projeto MaxCompute.

    2. Se os fusos horários forem diferentes, configure o fuso horário nas configurações avançadas da tarefa de sincronização em lote. Defina o fuso horário da tarefa de sincronização para corresponder ao fuso horário do servidor PostgreSQL, de modo que os valores timestamp sejam analisados nesse fuso horário antes de serem gravados no MaxCompute, eliminando o desvio.

      Uma incompatibilidade de fuso horário entre a origem e o destino geralmente se manifesta como um deslocamento fixo de N horas em todos os campos de tempo. Por exemplo, ambas as extremidades estão definidas como Asia/Bangkok, mas os valores sincronizados diferem em 1 hora, ou o grupo de recursos executa na Alemanha e usa Europe/Berlin como padrão, enquanto seu negócio exige que os valores sejam armazenados em UTC. Nesses casos, selecione o fuso horário que você pretende usar nas configurações avançadas da tarefa.

    Nota

    Alterar o fuso horário de agendamento não afeta o fuso horário usado pelo processo do Data Integration. As duas configurações são independentes. Se as colunas de data ainda retornarem valores inesperados após ajustar o fuso horário de agendamento, defina o fuso horário explicitamente também nas configurações avançadas da tarefa de sincronização em lote.

    A configuração de fuso horário tem como padrão GMT+8. Mantenha o valor padrão quando os campos de tempo forem sincronizados corretamente e defina-o para o fuso horário esperado pelo seu negócio apenas quando ocorrer um deslocamento de tempo. No modo script, essa configuração equivale ao seguinte trecho:

    "common":{"column":{"timeZone":"Asia/Bangkok"}}

Como usar a função TO_TIMESTAMP para extração incremental baseada em tempo em uma tarefa de sincronização em lote do PostgreSQL?

  • Cenário: Ao configurar uma condição WHERE ou uma instrução querySql personalizada para sincronização incremental do PostgreSQL, é necessário converter um parâmetro de tempo em formato de string para timestamp para fins de comparação.

  • Solução: Utilize a função padrão do PostgreSQL TO_TIMESTAMP em vez da função STR_TO_DATE do MySQL, pois o PostgreSQL e o MySQL usam dialetos SQL diferentes para converter strings de data e hora. Por exemplo:

    TO_TIMESTAMP('${start_time}', 'YYYYMMDDHH24')
    TO_TIMESTAMP('${end_time}', 'YYYYMMDDHH24')

    A função TO_TIMESTAMP converte uma string no formato especificado em um objeto timestamp, que pode então ser usado para filtrar linhas dentro de um intervalo de tempo na condição WHERE ou na instrução querySql.

Oracle

Falha na sincronização em lote do Oracle com erro: ORA-00932: inconsistent datatypes na cláusula WHERE

  • Cenário: Quando uma tarefa de sincronização em lote lê dados do Oracle com uma condição WHERE, a tarefa falha com ORA-00932: inconsistent datatypes.

  • Possível causa: A cláusula WHERE compara diretamente uma coluna DATE do Oracle com um valor NUMBER, por exemplo, um literal de data escrito como um número simples. Essa comparação causa uma incompatibilidade de tipo de dados no Oracle.

  • Solução: Converta explicitamente o valor numérico da data para o tipo DATE antes da comparação. Por exemplo, use TO_DATE('20250611', 'YYYYMMDD') ou o literal DATE '2025-06-11' na condição WHERE em vez de comparar a coluna com um número simples.

RDS

Falha na sincronização em lote quando a origem é Amazon RDS com erro: Host is blocked

Ao conectar-se ao Amazon RDS e receber o erro Host is blocked, desative a verificação de integridade do balanceador de carga da Amazon. Após desativá-la, o problema de bloqueio não ocorrerá mais.

MongoDB

Erro ao adicionar uma fonte de dados MongoDB com o usuário root

Ao adicionar uma fonte de dados MongoDB, utilize um usuário criado no banco de dados que contém as tabelas a serem sincronizadas. O usuário root não é suportado.

Por exemplo, se você deseja importar a tabela name e ela está no banco de dados test, o nome do banco de dados deve ser test, e você precisa usar o nome de um usuário criado no banco de dados test.

Como usar um timestamp no parâmetro de consulta para implementar sincronização incremental ao ler o MongoDB?

Use um nó de atribuição para primeiro converter um valor do tipo data em timestamp e, em seguida, passe esse valor como parâmetro de entrada para a tarefa de sincronização de dados do MongoDB.

O fuso horário apresenta um desvio de 8 horas após sincronizar o MongoDB para uma fonte de dados de destino. Como resolver?

Defina o fuso horário na configuração do MongoDB Reader. Para mais informações, consulte MongoDB Reader.

Registros atualizados na origem durante a leitura de dados do MongoDB não são sincronizados para o destino. Como proceder?

Reinicie a tarefa após um atraso sem alterar as condições de consulta, ou seja, adie o horário de execução da tarefa mantendo a configuração inalterada.

O MongoDB Reader diferencia maiúsculas de minúsculas?

Durante a leitura de dados, o Column.name configurado pelo usuário diferencia maiúsculas de minúsculas. Uma configuração incorreta faz com que os dados lidos sejam nulos. Por exemplo:

  • Dados de origem do MongoDB:

    {
        "MY_NAME": "zhangsan"
    }
  • Configuração de colunas da tarefa de sincronização:

    {
        "column":
        [
            {
                "name": "my_name"
            }
        ]
    }

Como a grafia (maiúsculas/minúsculas) da configuração da coluna não corresponde aos dados de origem, a leitura dos dados falha.

Como configurar o tempo limite do MongoDB Reader?

O parâmetro de configuração de tempo limite é cursorTimeoutInMs, cujo padrão é 600000 ms (10 minutos). Esse parâmetro especifica o tempo total que o MongoDB Server gasta executando a consulta, excluindo o tempo de transferência de dados. Se a leitura completa dos dados for grande, o seguinte erro poderá ocorrer: MongoDBReader$Task - operation exceeded time limitcom.mongodb.MongoExecutionTimeoutException: operation exceeded time limit.

Falha na leitura do MongoDB com erro: no master

Atualmente, as tarefas de sincronização do DataWorks não suportam leitura de dados de um nó secundário. Se você configurar um nó secundário para leitura, ocorrerá o seguinte erro: no master.

Falha na leitura do MongoDB com erro: MongoExecutionTimeoutException: operation exceeded time limit

  • Análise da causa raiz:

    Causado por tempo limite do cursor.

  • Solução:

    Aumente o valor do parâmetro cursorTimeoutInMs.

Falha na leitura de sincronização em lote do MongoDB com erro: DataXException: operation exceeded time limit

Aumente a simultaneidade da tarefa e o BatchSize de leitura.

Falha na tarefa de sincronização do MongoDB com erro: no such cmd splitVector

  • Possível causa:

    Por padrão, a tarefa de sincronização usa o comando splitVector para fragmentação da tarefa. Algumas versões do MongoDB não suportam o comando splitVector, o que causa o erro no such cmd splitVector.

  • Solução:

    1. Acesse a página de configuração da tarefa de sincronização e clique no botão Converter para Script Convert to Script na parte superior. Altere a tarefa para o modo script.

    2. Na configuração de parâmetros do MongoDB, adicione o seguinte parâmetro:

      "useSplitVector" : false

      Isso evita o uso do splitVector.

Falha na sincronização em lote do MongoDB com erro: After applying the update, the (immutable) field '_id' was found to have been altered to _id: "2"

  • Mensagem de erro:

    Na tarefa de sincronização, tomando o modo assistente como exemplo, esse problema pode ocorrer quando o Write Mode (Overwrite) está definido como Yes e uma coluna que não é _id está configurada como Business Key.

    Na configuração de destino da tarefa de sincronização, selecione a fonte de dados MongoDB (nome da instância: xc_mongo_rds), defina o nome da coleção como xc_timestamp, ative o modo de sobrescrita (defina 'Overwrite' como Yes) e especifique my_id como chave primária de negócio."

  • Possível causa:

    Os dados que estão sendo gravados contêm registros onde o _id não corresponde à Business Key configurada (como my_id no exemplo acima).

  • Solução:

    • Opção 1: Modifique a tarefa de sincronização em lote para garantir que a Business Key configurada seja a mesma que _id.

    • Opção 2: Use _id como chave primária de negócio durante a sincronização de dados.

Redis

Falha na escrita no Redis no modo hash com erro: Code:[RedisWriter-04], Description:[Dirty data]. - source column number is in valid!

  • Causa:

    Quando o Redis usa o modo hash para armazenamento, os atributos e valores do hash devem aparecer em pares. Por exemplo: odpsReader: "column":[ "id", "name", "age", "address" ]. No destino, se o RedisWriter estiver configurado como: "keyIndexes":[ 0, 1], então no Redis, id e name servem como chave, age serve como atributo e address serve como valor no tipo hash. Se apenas duas colunas forem configuradas na origem ODPS, o modo hash não poderá ser usado para armazenamento no Redis, e essa exceção será lançada.

  • Solução:

    Se quiser usar apenas duas colunas, configure o modo String do Redis para armazenamento. Caso precise usar o modo hash, configure pelo menos três colunas no lado da origem.

OSS

Como lidar com dados sujos ao ler arquivos CSV com delimitadores de múltiplos caracteres?

  • Sintoma:

    Ao configurar uma tarefa de sincronização em lote para ler dados de armazenamento de arquivos como OSS ou FTP, se o arquivo estiver no formato CSV e usar vários caracteres como delimitador de coluna (como |,, ## ou ;;), a tarefa poderá falhar com um erro de dados sujos. No log de execução, você verá um erro IndexOutOfBoundsException juntamente com dados sujos.

  • Análise da causa raiz:

    O leitor csv interno ("fileFormat": "csv") no DataWorks tem limitações ao processar delimitadores de múltiplos caracteres, o que causa uma divisão imprecisa de colunas nas linhas de dados.

  • Solução:

    • Modo assistente: Altere o tipo de texto para text e especifique explicitamente o delimitador de múltiplos caracteres.

    • Modo script: Altere "fileFormat": "csv" para "fileFormat": "text" e defina corretamente o delimitador: "fieldDelimiter":"<multi-char delimiter>", "fieldDelimiterOrigin":"<multi-char delimiter>".

Existe um limite de quantidade de arquivos ao ler arquivos do OSS?

A sincronização em lote em si não limita o número de arquivos lidos pelo plugin OSS Reader. A principal limitação vem dos recursos de CU consumidos pela tarefa. Ler muitos arquivos de uma só vez pode facilmente causar erros de falta de memória. Portanto, não recomendamos configurar o parâmetro object como: *, para evitar erros OutOfMemoryError: Java heap space .

Como remover strings aleatórias dos nomes de arquivos ao gravar no OSS?

O OSS Writer grava nomes de arquivos simulando diretórios por meio de nomes de objetos. O OSS possui restrições quanto aos nomes dos objetos. Ao usar "object": "datax", os objetos gravados começam com datax, com sufixos de strings aleatórias anexados. O número de arquivos é determinado pelo número real de tarefas divididas.

Se não precisar de sufixos UUID aleatórios, configure "writeSingleObject" : "true". Para mais informações, consulte a descrição do parâmetro writeSingleObject na documentação OSS Writer.

Falha na leitura de dados do OSS com erro: AccessDenied The bucket you access does not belong to you.

  • Causa:

    A AccessKey configurada para a fonte de dados não tem permissões no bucket.

  • Solução:

    Conceda permissões de leitura no bucket à conta AccessKey configurada para a fonte de dados OSS.

Hive

Falha na sincronização em lote para Hive local com erro: Could not get block locations.

  • Análise da causa raiz:

    O parâmetro mapred.task.timeout pode estar definido com um valor muito baixo, fazendo com que o Hadoop encerre a tarefa e limpe o diretório temporário, tornando os dados temporários indisponíveis.

  • Solução:

    Na seção de fonte de dados da tarefa de sincronização em lote, se Hive read methods estiver definido como Read Data Based on Hive JDBC (Supports Conditional Filtering), defina o valor do parâmetro mapred.task.timeout em Session Configuration, por exemplo, mapred.task.timeout=600000.

DataHub

Como lidar com falhas de escrita quando o volume de dados em uma única gravação no DataHub excede o limite?

  • Mensagem de erro:

    ERROR JobContainer - Exception when job runcom.alibaba.datax.common.exception.DataXException: Code:[DatahubWriter-04], Description:[Failed to write data.]. - com.aliyun.datahub.exception.DatahubServiceException: Record count 12498 exceed max limit 10000 (Status Code: 413; Error Code: TooLargePayload; Request ID: 20201201004200a945df0bf8e11a42)

  • Possível causa:

    O erro ocorre porque o volume de dados enviado pelo DataX ao DataHub em um único lote excede o limite do DataHub. Os principais parâmetros de configuração que afetam o volume de dados enviado ao DataHub são:

    • maxCommitSize: Especifica o tamanho acumulado dos dados no buffer. Quando os dados acumulados atingem o maxCommitSize (em MB), eles são enviados ao destino em um lote. O padrão é 1 MB (1.048.576 bytes).

    • batchSize: Especifica a contagem acumulada de registros de dados no buffer para o DataX-On-Flume. Quando a contagem acumulada de registros atinge o batchSize, os dados são enviados ao destino em um lote.

  • Solução:

    Reduza os valores dos parâmetros maxCommitSize e batchSize.

LogHub

Uma coluna tem dados no LogHub, mas fica vazia após a sincronização

Este plugin diferencia maiúsculas de minúsculas nos nomes das colunas. Verifique a configuração de colunas do LogHub Reader.

Dados ausentes ao ler do LogHub

O Data Integration utiliza o momento em que os dados entram no LogHub. Verifique no console do LogHub se a coluna de metadados receive_time está dentro do intervalo de tempo configurado para a tarefa.

As colunas lidas durante o mapeamento de colunas do LogHub não correspondem ao esperado

Se isso ocorrer, edite manualmente a configuração de colunas na interface.

Por que o valor __time__ lido está fora do intervalo de tempo configurado, ou por que a contagem de registros no console para o mesmo intervalo difere da tarefa de sincronização?

A hora inicial e final configuradas na tarefa de sincronização em lote são usadas pelo Reader para chamar a API GetCursor do SLS e localizar os cursores inicial e final. Esse tempo é usado para localizar o intervalo de leitura com base no tempo de recebimento do lado do servidor SLS. A tarefa realmente lê dados dentro do intervalo do cursor, o que não equivale a filtrar pela coluna de saída __time__.

A coluna de saída __time__ vem de log.getTime() de cada entrada de log, representando o próprio tempo do log. As consultas no console do SLS normalmente usam o intervalo de tempo da consulta, instruções de consulta e colunas de índice para estatísticas, geralmente baseadas no tempo do log __time__. Portanto, mesmo que a tarefa de sincronização e o console usem os mesmos valores de tempo, o intervalo __time__ ou a contagem de registros pode diferir se os dois lados usarem métricas de tempo diferentes.

Cenários comuns:

  1. Quando há atraso na coleta ou entrega de logs, preenchimento retroativo de logs históricos ou relógios de cliente imprecisos, o tempo do log __time__ pode ser anterior ou posterior ao tempo de recebimento do lado do servidor SLS. A tarefa de sincronização localiza cursores com base no tempo de recebimento do servidor, enquanto o console faz consultas com base em __time__, o que pode gerar resultados diferentes.

  2. Quando dados são gravados em outro LogStore por meio de transformação de dados do SLS, se a instrução de transformação não definir explicitamente __time__, o __time__ do log de destino geralmente retém o tempo do log de origem em vez do tempo de execução da transformação. Nesse caso, a tarefa de sincronização pode ler esse lote de dados dentro do intervalo de tempo em que a transformação grava no LogStore de destino. No entanto, ao consultar o console do LogStore de destino pelo tempo de execução da transformação ou pelo intervalo de tempo atual, esses logs podem não ser encontrados. É necessário consultar pelo intervalo __time__ real dos logs.

  3. Quando a instrução de consulta do console, as colunas de índice, o intervalo de tempo e a instrução de filtragem de regras (SPL) na tarefa de sincronização são inconsistentes, as contagens de registros podem diferir mesmo que as métricas de tempo sejam as mesmas.

Sugestões de solução de problemas:

  1. Verifique se o intervalo de tempo da consulta no console, a instrução de consulta, as colunas de índice e a hora inicial/final e a instrução de filtragem de regras (SPL) na tarefa de sincronização estão consistentes.

  2. Inclua tanto __time__ (tempo do log) quanto __tag__:__receive_time__ (o campo observável para o tempo de recebimento do lado do servidor SLS, que requer que este campo exista nas tags do log) na configuração column para comparar o tempo do log com o tempo de recebimento do servidor.

  3. Se os dados vierem de transformação de dados do SLS, verifique se a instrução de transformação define explicitamente __time__ e ajuste o intervalo de tempo da consulta no console no LogStore de destino com base no __time__ real.

  4. Se for necessária uma reconciliação estrita pelo tempo do log no downstream, filtre ou agregue por __time__ após a gravação no destino.

Exemplo: O __time__ do log de origem é 2026-06-01 10:00:00. Uma tarefa de transformação de dados do SLS grava este log no LogStore de destino às 2026-06-12 10:00:00 sem modificar explicitamente o __time__. O __time__ do log de destino permanece 2026-06-01 10:00:00. Se as horas inicial e final da tarefa de sincronização cobrirem 2026-06-12 10:00:00, a tarefa poderá ler este log. No entanto, ao consultar o LogStore de destino no console por volta de 2026-06-12 10:00:00 com __time__ como filtro, este log pode não ser encontrado. Nesse caso, ajuste o tempo da consulta no console para cerca de 2026-06-01 10:00:00, ou defina explicitamente o __time__ do log de destino durante a transformação de dados conforme necessário.

Por que uma coluna tem valor na consulta do console do LogHub, mas fica vazia após a sincronização?

O Reader corresponde aos nomes das colunas a partir dos campos reais do conteúdo do log extraído, mapeamentos de metacampos internos do Reader e LogTag com base na configuração column. Os nomes das colunas diferenciam maiúsculas de minúsculas. Se nenhuma correspondência for encontrada, null é gerado sem erro.

As causas comuns incluem:

  1. O nome da coluna configurado em column tem grafia (maiúsculas/minúsculas) diferente da chave original do campo de log.

  2. O console exibe aliases de análise de consulta, campos de índice ou campos expandidos de JSON, que diferem da chave de log original que o Reader realmente recupera.

  3. A coluna realmente vem do LogTag e precisa ser configurada como __tag__:<tagKey>.

  4. Após configurar uma instrução de filtragem de regras (SPL) ou transformação, os nomes dos campos de saída não correspondem totalmente à configuração column.

Ao solucionar problemas, verifique primeiro as colunas da tabela de origem e a visualização de dados na página visual para confirmar os campos que o Reader realmente identifica. No modo script, você também pode definir temporariamente column como ["*"] para ver as chaves reais dos campos de conteúdo do log recuperadas pelo Reader e, em seguida, configurar column com base nas chaves originais.

Lindorm

Ao usar o modo bulk do Lindorm para gravar dados, os dados históricos são substituídos todas as vezes?

O comportamento é o mesmo da lógica de escrita da API: dados na mesma linha e mesma coluna são sobrescritos, e outros dados permanecem inalterados.

Elasticsearch

Como consultar todas as colunas em um índice ES?

Recupere o mapeamento do índice ES usando o comando curl e extraia todas as colunas do mapeamento.

  • Comando Shell para consulta:

    //es7
    curl -u username:password --request GET 'http://esxxx.elasticsearch.aliyuncs.com:9200/indexname/_mapping'
    //es6
    curl -u username:password --request GET 'http://esxxx.elasticsearch.aliyuncs.com:9200/indexname/typename/_mapping'
  • Recuperando colunas do resultado:

    {
        "indexname": {
            "mappings": {
                "typename": {
                    "properties": {
                        "field1": {
                            "type": "text"
                        },
                        "field2": {
                            "type": "long"
                        },
                        "field3": {
                            "type": "double"
                        }
                    }
                }
            }
        }
    }

    As colunas e definições de atributos sob properties na resposta representam todas as colunas do índice. Por exemplo, o índice acima contém três colunas: field1, field2 e field3.

Como configurar o nome do índice ao sincronizar dados do ES para outras fontes de dados com nomes de índices diários diferentes?

Adicione parâmetros de agendamento de data à configuração do índice para calcular automaticamente a string do índice com base em datas diferentes, permitindo alterações automáticas no nome do índice do Elasticsearch Reader. A configuração envolve três etapas: definir parâmetros de data, configurar parâmetros de índice e implantar e executar a tarefa.

  1. Defina parâmetros de data: Nas configurações de agendamento da tarefa de sincronização, adicione parâmetros para definir os parâmetros de data. A seguinte configuração var1 representa o tempo de execução da tarefa (dia atual), e var2 representa a data de negócio (dia anterior).

  2. Configure parâmetros de índice: Mude a tarefa para o modo script e configure o índice do Elasticsearch Reader usando o formato: ${variable_name}, conforme mostrado abaixo.

    {
        "type": "job",
        "version": "2.0",
        "steps": [
            {
                "stepType": "elasticsearch",
                "parameter": {
                    "retryCount": 30,
                    "scroll": "10m",
                    "column": [
                        "col18",
                        "col17"
    
                    ],
                    "index": "esstress_1_${var1}_${var2}",
                    "pageSize": 100,
                    "sort": {
                        "_id": "asc"
                    },
  3. Implante e execute a tarefa: Após a verificação, envie e implante a tarefa no Operation Center e execute-a como um agendamento periódico ou tarefa de backfill de dados.

    1. Clique no botão Running with Parameters para executar a tarefa diretamente para verificação. A execução com parâmetros substitui os parâmetros do sistema de agendamento usados na configuração da tarefa. Após a execução, verifique os logs para confirmar se o índice sincronizado atende às expectativas.

      Nota

      Ao executar com parâmetros, insira os valores dos parâmetros diretamente para teste de substituição.

    2. Se a etapa anterior for verificada conforme o esperado, a configuração da tarefa estará completa. Clique em Save e depois em Commit para enviar a tarefa de sincronização para o ambiente de produção.

      Em um workspace no modo padrão, clique em Deploy para acessar o Deployment Center e implantar a tarefa de sincronização no ambiente de produção.

  4. Resultado: A seguir, são apresentados a configuração e o resultado real do índice em tempo de execução.

    Configuração do índice no script: "index": "esstress_1_${var1}_${var2}".

    Índice resolvido em tempo de execução: esstress_1_20230106_20230105.

    ],
    "full":false,
    "gmtCreate":"2022-07-18 14:47:18",
    "gmtModified":"2022-07-18 14:47:18",
    "index":"esstress_1_20230106_20230105",
    "instanceId":"es-cn-2r42se1je001zwmt0",
    "ownerId":"1224800975333052",
    "pageSize":100,
    "password":"********",
    "privateNetworkIpWhiteList":[
        "0.0.0.0/0"
    ],

Como o Elasticsearch Reader sincroniza propriedades de campos Object ou Nested? (Por exemplo, sincronizar object.field1)

Para sincronizar propriedades de campos do tipo objeto, utilize exclusivamente o modo script. Nesse modo, configure multi conforme abaixo e especifique column usando o formato atributo.subatributo.

"multi":{
   "multi":true 
 }

Consulte o exemplo a seguir para a configuração:

#Example:
##Data in Elasticsearch
"hits": [
    {
        "_index": "mutiltest_1",
        "_type": "_doc",
        "_id": "7XAOOoMB4GR_1Dmrrust",
        "_score": 1.0,
        "_source": {
            "level1": {
                "level2": [
                    {
                        "level3": "testlevel3_1"
                    },
                    {
                        "level3": "testlevel3_2"
                    }
                ]
            }
        }
    }
]
##Reader configuration
"parameter": {
  "column": [
      "level1",
      "level1.level2",
      "level1.level2[0]"
  ],
  "multi":{
        "multi":true
    }
}
##Writer result: 1 row with 3 columns, column order matches reader configuration
COLUMN              VALUE
level1:             {"level2":[{"level3":"testlevel3_1"},{"level3":"testlevel3_2"}]}
level1.level2:      [{"level3":"testlevel3_1"},{"level3":"testlevel3_2"}]
level1.level2[0]:   {"level3":"testlevel3_1"}

Após sincronizar dados do tipo string do ODPS para o ES, as aspas parecem estar ausentes em ambos os lados. Como proceder? É possível sincronizar uma string do tipo JSON da source como um objeto NESTED no ES?

  1. As aspas duplas extras exibidas antes e depois dos caracteres são um problema de visualização no Kibana. Os dados reais não possuem essas aspas duplas no início e no fim. Utilize o comando curl ou o Postman para visualizar os dados reais. O comando curl para recuperar os dados é o seguinte:

    //es7
    curl -u username:password --request GET 'http://esxxx.elasticsearch.aliyuncs.com:9200/indexname/_mapping'
    //es6
    curl -u username:password --request GET 'http://esxxx.elasticsearch.aliyuncs.com:9200/indexname/typename/_mapping'
  2. Configure o tipo da coluna de escrita no ES como nested para sincronizar dados de string do tipo JSON do ODPS para o ES no formato aninhado. O exemplo a seguir sincroniza a coluna name para o ES no formato nested.

    • Configuração de sincronização: Defina o tipo de name como nested.

    • Resultado da sincronização: name é um tipo de objeto aninhado.

      "total": {
          "value": 1,
          "relation": "eq"
      },
      "max_score": 1.0,
      "hits": [
          {
              "_index": "test",
              "_type": "_doc",
              "_id": "bb5oqoUBlqHPyI16REEQ",
              "_score": 1.0,
              "_source": {
                  "name": [
                      {
                          "fields1": "value"
                      }
                  ]
              }
          }
      ]
      }

Os dados da source são **string "[1,2,3,4,5]"**. Como sincronizá-los para o ES como um array?

Existem dois métodos de configuração para gravar tipos de array no ES. Escolha o método de sincronização correspondente com base no formato dos dados da source.

  • Grave no ES como um tipo de array analisando os dados da source como JSON. Por exemplo, se os dados da source forem "[1,2,3,4,5]", configure json_array=true para analisar os dados da source e gravá-los na coluna do ES como um array. Configure o ColumnList com json_array=true.

    • Configuração no modo assistente.

    • Configuração no modo script:

      "column":[
        {
          "name":"docs",
          "type":"keyword",
          "json_array":true
        }
      ]
  • Grave no ES como um tipo de array analisando os dados da source com um delimitador. Por exemplo, se os dados da source forem "1,2,3,4,5", configure um delimitador splitter="," para analisar e gravar os dados na coluna do ES como um array.

    • Limitações:

      • Uma tarefa suporta apenas um delimitador. O splitter é globalmente único e não aceita delimitadores diferentes para colunas de array distintas. Por exemplo, para as colunas da source col1="1,2,3,4,5" , col2="6-7-8-9-10", não é possível configurar o splitter separadamente para cada coluna.

      • O splitter pode ser configurado como uma expressão regular. Por exemplo, se o valor da coluna da source for "6-,-7-,-8+,*9-,-10", você pode configurar splitter:".,.", sendo isso suportado também no modo assistente.

    • Configuração no modo assistente: splitter: o padrão é "-,-".

    • Configuração no modo script:

      "parameter" : {
            "column": [
              {
                "name": "col1",
                "array": true,
                "type": "long"
              }
            ],
            "splitter":","
      }

Ao gravar dados no ES, uma solicitação não autenticada é feita primeiro, mas a autenticação ainda é necessária, causando falha na solicitação. Consequentemente, todos os dados da solicitação enviada são registrados, gerando um grande volume de logs de auditoria diariamente. Como resolver?

  • Análise da causa raiz:

    O HttpClient determina que, sempre que uma conexão é estabelecida, uma solicitação não autenticada é enviada primeiro. Após o servidor retornar a exigência de autenticação (especificando o método com base na resposta), uma solicitação autenticada é então realizada. Como cada gravação de dados no ES exige o estabelecimento de uma conexão, cada operação gera uma solicitação não autenticada, que fica registrada nos logs de auditoria.

  • Solução:

    Adicione a configuração "preemptiveAuth":true no modo script.

Como sincronizar dados para o ES como tipo Date?

Existem dois métodos para configurar a gravação de datas. Escolha o mais adequado conforme sua necessidade.

  • Grave diretamente na coluna Date do ES com base no conteúdo lido pelo Reader:

    • Configure origin:true para gravar o conteúdo lido diretamente no ES.

    • Configure "format" para especificar o atributo de formato da coluna ao criar o mapping por meio da gravação no ES.

      "parameter" : {
          "column": [
              {
                  "name": "col_date",
                  "type": "date",
                  "format": "yyyy-MM-dd HH:mm:ss",
                  "origin": true
              }
                ]
      }
  • Conversão de fuso horário: Se for necessário que o Data Integration realize a conversão de fuso horário, adicione o parâmetro Timezone.

    "parameter" : {
        "column": [
            {
                "name": "col_date",
                "type": "date",
                "format": "yyyy-MM-dd HH:mm:ss",
                "Timezone": "UTC"
            }
              ]
    }

O Elasticsearch Writer falha ao especificar uma versão externa. Como proceder?

  • O type:version está configurado, mas o ES não suporta a especificação de uma versão externa.

        "column":[
                                {
                                    "name":"id",
                                    "type":"version"
                                },
      ]
  • Solução:

    Remova a configuração "type":"version". O Elasticsearch Writer não suporta a especificação de versão externa.

A leitura de sincronização em lote do Elasticsearch falha com o erro: ERROR ESReaderUtil - ES_MISSING_DATE_FORMAT, Unknown date value. please add "dataFormat". sample value:

  • Análise da causa raiz:

    O Elasticsearch Reader não consegue analisar o formato de data de uma coluna do tipo date porque o mapping da coluna de data correspondente no ES não tem um formato configurado.

  • Solução:

    • Configure o parâmetro dateFormat com o mesmo formato da coluna de data do ES, usando "||" como separador. O formato deve incluir todos os formatos de tipo de data. Por exemplo:

      "parameter" : {
            "column": [
           			"dateCol1",
              	"dateCol2",
                "otherCol"
            ],
           "dateFormat" : "yyyy-MM-dd||yyyy-MM-dd HH:mm:ss",
      }
    • Defina o formato de mapping para todas as colunas de data no banco de dados do ES.

A leitura de sincronização em lote do Elasticsearch falha com o erro: com.alibaba.datax.common.exception.DataXException: Code:[Common-00].

  • Análise da causa raiz:

    Devido às limitações de palavras-chave do fastjson, o índice ou as colunas podem conter palavras-chave como $ref.

  • Solução:

    O Elasticsearch Reader não suporta a sincronização de índices que contenham a palavra-chave $ref nos nomes das colunas. Para mais informações, consulte Elasticsearch Reader.

A gravação de sincronização em lote no Elasticsearch falha com o erro: version_conflict_engine_exception.

  • Análise da causa raiz:

    Isso acionou o mecanismo de bloqueio otimista do ES. O número da versão atual deveria ter um valor específico, mas o número da versão passado pelo comando update é diferente, causando um conflito de versão. Durante a atualização, outra operação estava excluindo dados do índice simultaneamente.

  • Solução:

    1. Verifique se há operações de exclusão de dados em andamento.

    2. Altere o método de sincronização da tarefa de Update para Index.

A gravação de sincronização em lote no Elasticsearch falha com o erro: illegal_argument_exception.

  • Análise da causa raiz:

    Ao configurar atributos avançados como similarity e properties para uma coluna, other_params é necessário para que o plugin os reconheça.

    "parameter":{
            "__datasource__type":"elasticsearch",
            "actionType":"index",
            "aliasMode":"append",
            "batchSize":1024,
            "cleanup":false,
            "column":[
                {
                    "name":"id",
                    "type":"long"
                },
                {
                    "name":"dim1_code",
                    "type":"keyword"
                },
                {
                    "analyzer":"china",
                    "name":"dim1_name",
                    "similarity":"len_similarity",
                    "type":"text"
                },
                {
                    "analyzer":"china",
                    "name":"dim1_val",
                    "similarity":"len_similarity",
                    "type":"text"
                },
                {
                    "name":"dim1_sort",
                    "type":"long"
                }
  • Solução:

    Configure other_params na configuração da coluna e adicione similarity dentro de other_params, conforme abaixo:

    {"name":"dim2_name",...,"other_params":{"similarity":"len_similarity"}}

A sincronização em lote de dados da coluna Array do ODPS para o Elasticsearch falha com o erro: dense_vector

  • Análise da causa raiz:

    Atualmente, a gravação de sincronização em lote no Elasticsearch não suporta o tipo dense_vector. Apenas os seguintes tipos são suportados:

    ID,PARENT,ROUTING,VERSION,STRING,TEXT,KEYWORD,LONG,
    INTEGER,SHORT,BYTE,DOUBLE,FLOAT,DATE,BOOLEAN,BINARY,
    INTEGER_RANGE,FLOAT_RANGE,LONG_RANGE,DOUBLE_RANGE,DATE_RANGE,
    GEO_POINT,GEO_SHAPE,IP,IP_RANGE,COMPLETION,TOKEN_COUNT,OBJECT,NESTED;
  • Solução:

    Para tipos não suportados pelo Elasticsearch Writer, proceda da seguinte forma:

    • Não recomendamos usar o Elasticsearch Writer para criar mappings de índices. Utilize um mapping personalizado.

    • Altere o tipo correspondente para NESTED.

    • Modifique a configuração para: dynamic = true, cleanup=false.

Por que a configuração de Settings não entra em vigor quando o Elasticsearch Writer cria um índice?

  • Causa:

    #Incorrect configuration
    "settings": {
      "index": {
        "number_of_shards": 1,
        "number_of_replicas": 0
      }
    }
    #Correct configuration
    "settings": {
      "number_of_shards": 1,
      "number_of_replicas": 0
    }
  • Solução:

    As configurações de Settings entram em vigor apenas quando um índice é criado, o que abrange dois casos: o índice não existe ou cleanup=true. Quando cleanup=true, a configuração de Settings não precisa incluir "index".

Em um índice personalizado, o tipo do atributo aninhado é keyword, mas por que o tipo se torna keyword após a geração automática? (Geração automática refere-se à execução de uma tarefa de sincronização com **cleanup=true**)

#Original mappings
{
  "name":"box_label_ret",
  "properties":{
    "box_id":{
      "type":"keyword"
    }
}
#After rebuilding with cleanup=true, it becomes
{
    "box_label_ret": {
      "properties": {
        "box_id": {
          "type": "text",
          "fields": {
            "keyword": {
              "type": "keyword",
              "ignore_above": 256
            }}}}
}
  • Análise da causa raiz:

    Para tipos aninhados, o Elasticsearch Writer utiliza apenas os mappings de nível superior e permite que o ES adapte automaticamente os tipos complexos aninhados. A alteração do tipo de atributo para text com a adição de fields:keyword é um comportamento de adaptação automática do ES e não afeta seu uso. Caso necessite de um formato de mapping específico, consulte Elasticsearch Writer.

  • Solução:

    Crie os mappings de índice esperados no ES antes da sincronização, defina cleanup como false na tarefa de sincronização do ES e execute a tarefa.

Kafka

O endDateTime foi configurado para especificar o intervalo limite de dados a serem sincronizados do Kafka, mas foram encontrados dados além desse horário na source de dados de destino

O Kafka Reader lê dados em lotes. Em um lote de dados, se algum registro exceder o endDateTime, a sincronização é interrompida. No entanto, os dados que ultrapassam o endDateTime nesse lote ainda são gravados na source de dados de destino.

  • Use a configuração skipExceedRecord para especificar se os dados excedentes devem ser sincronizados. Para detalhes de uso, consulte Kafka Reader. [Não recomendamos definir para não sincronizar, pois isso pode causar perda de dados.]

  • Configure o parâmetro max.poll.records do Kafka para especificar a quantidade de dados extraídos em cada lote. Combinado com a concorrência, você controla o volume de dados que pode exceder o limite. O volume de dados excedente < max.poll.records × concorrência.

Por que a tarefa continua em execução sem ler dados ou finalizar quando há poucos dados no Kafka?

  • Análise da causa raiz:

    Quando o volume de dados é pequeno ou a distribuição é desigual, algumas partições do Kafka podem não receber novos dados ou os novos dados podem não atingir o offset final especificado. Como a condição de saída da tarefa exige que todas as partições atinjam o offset final especificado, essas partições "ociosas" não satisfazem a condição, impedindo a conclusão normal da tarefa.

  • Solução:

    Defina a política de fim de sincronização como 1 minuto sem ler novos dados (no modo script, defina stopWhenPollEmpty como true e stopWhenReachEndOffset como true). A tarefa é encerrada após ler os dados do offset mais recente de todas as partições, evitando execução ociosa. Contudo, registros com timestamps anteriores ao offset final configurado que forem gravados após o término da tarefa não serão consumidos.

RestAPI

O RestAPI Writer falha com o erro: The JSON string found via path:[] is not in array format

O RestAPI Writer oferece dois modos de gravação. Ao sincronizar vários registros, defina dataMode como multiData e adicione o parâmetro dataPath:"data.list" no script. Para mais informações, consulte RestAPI Writer.Parameters
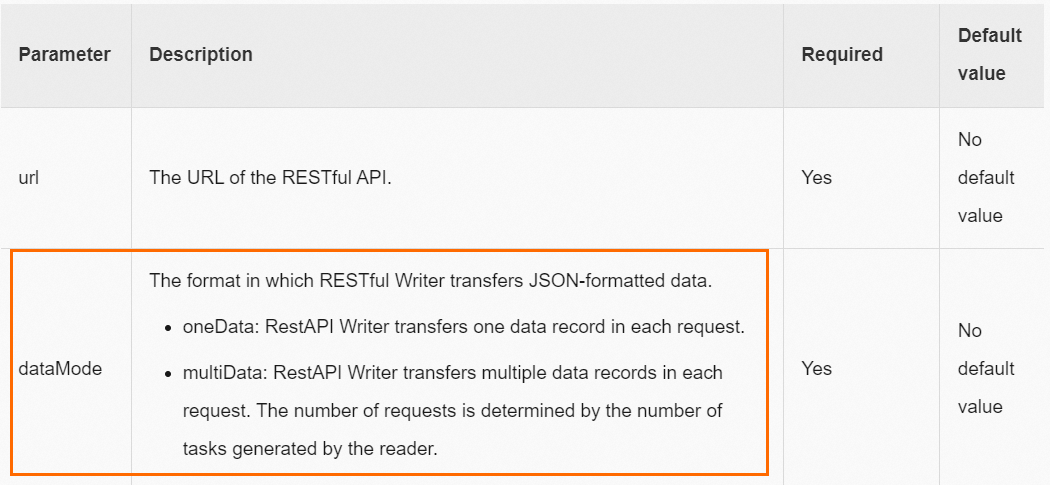
Importante

Ao configurar colunas, não adicione o prefixo "data.list".

Configuração do OTS Writer

Como configurar o OTS Writer ao gravar dados em uma tabela de destino que contém uma coluna de chave primária com incremento automático?

  1. A configuração do OTS Writer deve atender aos dois requisitos a seguir:

    "newVersion": "true",
    "enableAutoIncrement": "true",
  2. O nome da coluna de chave primária com incremento automático não deve ser configurado no OTS Writer.

  3. A soma das entradas de primaryKey e das entradas de column configuradas no OTS Writer deve ser igual ao número de colunas nos dados do OTS Reader upstream.

Configuração do modelo de séries temporais

Como interpretar as colunas **_tag e is_timeseries_tag** na configuração do modelo de séries temporais?

Exemplo: Um registro de dados possui três tags: [phone=xiaomi, RAM=8G, camera=LEICA].Data
  • Exemplo de exportação de dados (OTS Reader)

    • Para mesclar as tags acima em uma única coluna para exportação, configure da seguinte forma:

      "column": [
            {
              "name": "_tags",
            }
          ],

      O DataWorks exporta as tags como uma única coluna de dados no seguinte formato:

      ["phone=xiaomi","camera=LEICA","RAM=8G"]
    • Para exportar a tag phone e a tag camera como colunas separadas, configure da seguinte forma:

      "column": [
            {
              "name": "phone",
              "is_timeseries_tag":"true",
            },
            {
              "name": "camera",
              "is_timeseries_tag":"true",
            }
          ],

      O DataWorks exporta duas colunas de dados no seguinte formato:

      xiaomi, LEICA
  • Exemplo de importação de dados (OTS Writer)

    A source de dados upstream (Reader) possui duas colunas de dados:

    • Uma coluna contém: ["phone=xiaomi","camera=LEICA","RAM=8G"].

    • A outra coluna contém: 6499.

    Para adicionar ambas as colunas às tags, o formato esperado do campo de tag após a gravação é o seguinte:Format Configure da seguinte forma:

    "column": [
          {
            "name": "_tags",
          },
          {
            "name": "price",
            "is_timeseries_tag":"true",
          },
        ],
    • A configuração da primeira coluna importa ["phone=xiaomi","camera=LEICA","RAM=8G"] integralmente para o campo de tag.

    • A configuração da segunda coluna importa price=6499 individualmente para o campo de tag.

Nome de tabela personalizado

Como personalizar o nome da tabela para uma tarefa de sincronização em lote?

Se os nomes das suas tabelas seguirem um padrão regular, como orders_20170310, orders_20170311 e orders_20170312, onde as tabelas são diferenciadas por data e compartilham a mesma estrutura, use parâmetros de agendamento (Configure synchronization tasks in script mode) para personalizar o nome da tabela e ler automaticamente os dados da tabela do dia anterior da base de dados da source toda madrugada.

Por exemplo, se hoje for 15 de março de 2017, o sistema importa automaticamente os dados da tabela orders_20170314 na base de dados da source, e assim sucessivamente.

No modo script, altere o nome da tabela da source para uma variável, como orders_${tablename}. Como as tabelas são diferenciadas por data e você precisa ler os dados do dia anterior diariamente, atribua o valor da variável na configuração de parâmetros da tarefa como tablename=${yyyymmdd}.

Nota

Para mais informações sobre parâmetros de agendamento, consulte Configure scheduling parameters

Adição de colunas a uma tabela

Como lidar com adições (modificações) de colunas na tabela da source para sincronização em lote?

Acesse a página de configuração da tarefa de sincronização, modifique os mapeamentos de colunas para atualizar as colunas alteradas na configuração da tarefa e, em seguida, reenvie e execute a tarefa para que as alterações entrem em vigor.

Problemas de configuração de tarefas

Como proceder quando não é possível visualizar todas as tabelas ao configurar um nó de sincronização em lote?

Ao configurar um nó de sincronização em lote, a seção Source exibe apenas as primeiras 25 tabelas da source de dados selecionada por padrão. Se houver mais tabelas, insira o nome da tabela para pesquisar ou utilize o modo script para desenvolvimento.

Palavras-chave em nomes de tabelas/colunas

Como lidar com falhas em tarefas de sincronização causadas por conflitos de palavras-chave em nomes de tabelas ou colunas?

  • Causa do erro: A configuração da coluna contém palavras-chave reservadas ou colunas que começam com um número.

  • Solução: Mude a tarefa de sincronização do Data Integration para o modo script e faça o escape das colunas especiais na configuração de colunas. Para configurar tarefas no modo script, consulte Configure synchronization tasks in script mode.

    • O caractere de escape para MySQL é keyword.

    • O caractere de escape para Oracle e PostgreSQL é "keyword".

    • O caractere de escape para SQL Server é [keyword].

    Exemplo para MySQL:

    {
        "stepType": "mysql",
        "parameter": {
            "envType": 0,
            "datasource": "wpw_test_mysql",
            "column": [
                "id",
                "`order`",
                "`add`"
            ],
            "connection": [
                {
                    "datasource": "wpw_test_mysql",
                    "table": [
                        "abc"
                    ]
                }
  • Tomando uma source de dados MySQL como exemplo:

    1. Execute a seguinte instrução para criar uma tabela chamada aliyun: create table aliyun (

    2. Execute a seguinte instrução para criar uma view e atribuir um alias à coluna da tabela: create view v_aliyun as select

      Nota
      • table é uma palavra-chave do MySQL. Durante a sincronização de dados, o código concatenado causa um erro. Crie uma view e atribua um alias à coluna da tabela.

      • Não recomendamos o uso de palavras-chave como nomes de colunas de tabela.

    3. Após executar as instruções acima, utilize a view v_aliyun em vez da tabela aliyun ao configurar a tarefa de sincronização.

Mapeamento de colunas

A tarefa de sincronização em lote falha com o erro: plugin xx does not specify column

Esse erro pode ocorrer porque o mapeamento de colunas da tarefa de sincronização não está configurado corretamente ou o plugin não tem column devidamente configurado.

  1. Verifique se o mapeamento de colunas está configurado.

  2. Verifique se o plugin tem column configurado corretamente.

Source de dados não estruturados: Como lidar com o problema em que as colunas não podem ser mapeadas após clicar na pré-visualização de dados?

  • Sintoma:

    Ao clicar em Preview Data, uma mensagem semelhante à seguinte aparece, indicando que o tamanho em bytes da coluna excede o limite.

    A mensagem de erro é "Maximum column length of 1,000 exceeded in column 6 in record 1. Set the SafetySwitch property to false if you're expecting column lengths greater than 100,000 characters to avoid this error."

  • Causa: Para evitar OOM, o service da source de dados verifica o comprimento da coluna ao processar solicitações de pré-visualização de dados. Se uma única coluna exceder 1000 bytes, a mensagem acima aparece. Essa mensagem não afeta a execução real da tarefa. Ignore este erro e execute a tarefa de sincronização em lote diretamente.

    Nota

    Se o arquivo existir e a conectividade estiver normal, as seguintes situações também podem causar falha na pré-visualização de dados:

    • Uma única linha no arquivo excede o limite de tamanho em bytes de 10 MB. Nesse caso, nenhum dado é exibido, de forma semelhante à mensagem acima.

    • Uma única linha no arquivo excede o limite de contagem de 1000 colunas. Nesse caso, apenas as primeiras 1000 colunas são exibidas, com uma mensagem mostrada na 1001ª coluna.

Modificar TTL

O TTL de uma tabela sincronizada só pode ser modificado usando a instrução ALTER?

O TTL é definido no nível da tabela. Não há opção de TTL na configuração da tarefa de sincronização.

Agregação de funções

Ao sincronizar via API, há suporte para usar funções do lado da source (como MaxCompute) para agregação? Por exemplo, a tabela da source tem as colunas a e b como chaves primárias do Lindorm

A sincronização baseada em API não suporta o uso de funções do lado da source. Processe os dados usando funções da source antes de importar.