O Latency insight fornece estatísticas de latência com precisão de microssegundos para todos os comandos e eventos personalizados em uma instância Tair (Redis OSS-compatible). Use esse recurso para identificar quais eventos causaram um pico de latência, quando ele ocorreu e sua gravidade, analisando as dimensões de eventos, tempo e latência.
Pré-requisitos
Antes de começar, verifique se a instância Tair (Redis OSS-compatible) atende aos seguintes requisitos de versão secundária. Para atualizar a versão secundária, consulte Atualizar a versão secundária de uma instância.
|
Tipo de instância |
Versão secundária mínima |
Observações |
|
Instância baseada em DRAM do Tair (Enterprise Edition) |
1.6.9 |
Para coletar estatísticas de comandos de módulos do Tair, atualize para a versão 1.7.28 ou posterior |
|
Redis Open-Source Edition 5.0 |
5.1.4 |
|
|
Redis Open-Source Edition 6.0 |
0.1.15 |
|
|
Redis Open-Source Edition 7.0 |
7.0.0.6 |
Como o Latency insight funciona
O Redis 2.8.13 introduziu o monitoramento nativo de latência, mas retém apenas os dados dos últimos 160 segundos e registra somente o evento de maior latência por segundo.
O Latency insight estende essa funcionalidade com:
Persistência: retém todas as estatísticas de latência dos últimos três dias, permitindo rastrear picos de latência ao longo do tempo
Alta precisão: medições com exatidão de microssegundos para todos os eventos
Alto desempenho: implementação assíncrona com sobrecarga mínima
Consultas em tempo real: suporta consultas e agregação de dados ao vivo
Estatísticas multidimensionais: analisa uma instância em até 27 eventos, intervalos de tempo e distribuições de latência
Faturamento
Este recurso é gratuito.
Visualizar estatísticas de latência
Faça login no console do DAS.
No painel de navegação à esquerda, escolha Intelligent O&M Center > Instance Monitoring.
Localize a instância que deseja analisar e clique em ID da instância para abrir a página de detalhes.
No painel de navegação à esquerda, escolha Request Analysis > Latency Insight.
Na página Latency Insight, selecione um intervalo de tempo para visualizar as estatísticas de latência desse período.
Apenas os dados dos últimos três dias estão disponíveis, e cada consulta deve abranger no máximo uma hora.
Para instâncias cluster ou com divisão de leitura e escrita, visualize as estatísticas de Data Node e Proxy Node.
Somente comandos ou eventos que excedem o limiar configurado são registrados e exibidos. Para obter orientações sobre como resolver eventos comuns de latência, consulte Sugestões para lidar com eventos comuns de latência .
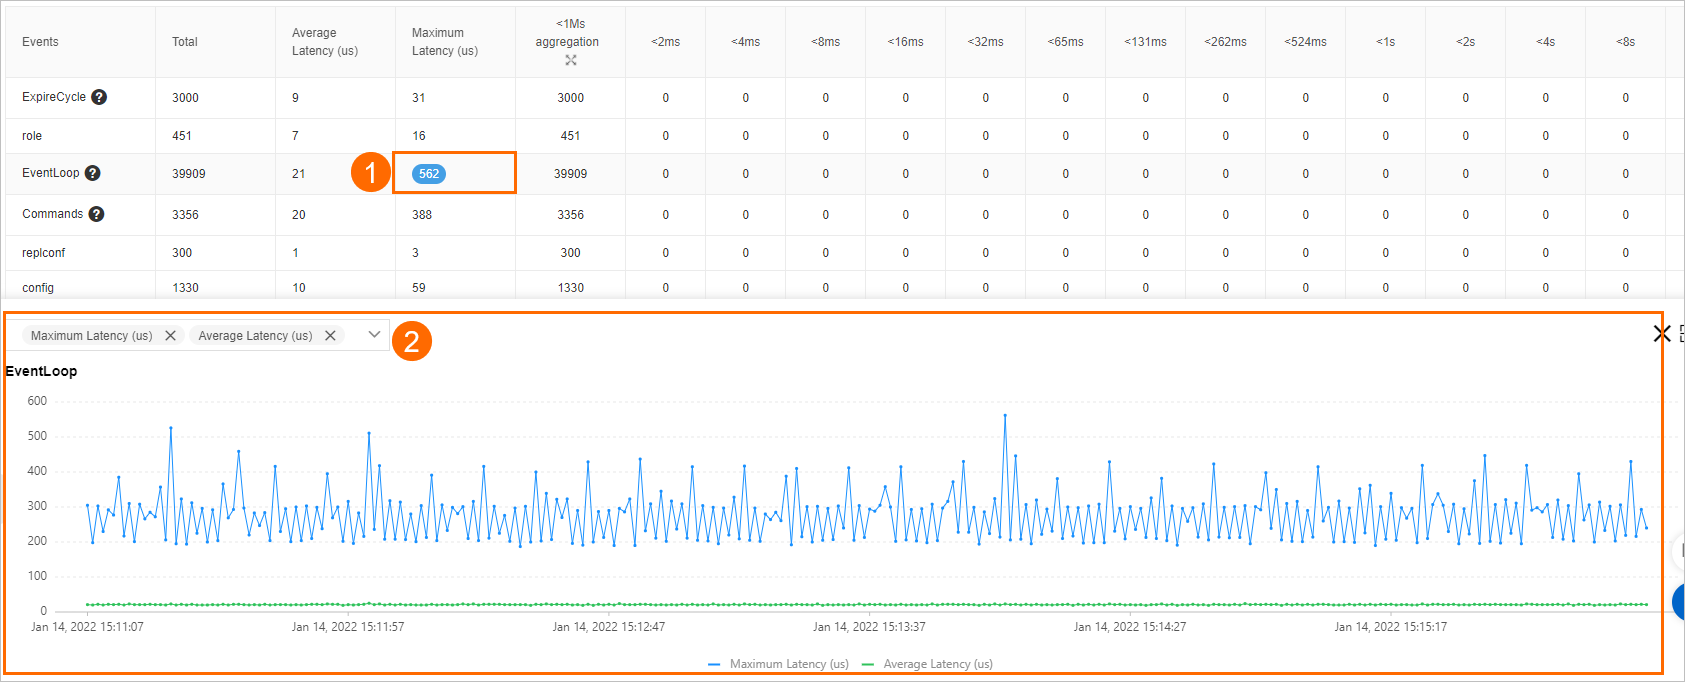
Referência de métricas
|
Métrica |
Descrição |
|
Events |
Nome do evento |
|
Total |
Número total de ocorrências |
|
Ave. Latency (μs) |
Tempo médio de execução no servidor, em microssegundos |
|
Max. Latency (μs) |
Tempo máximo de execução no servidor, em microssegundos |
|
Aggregation of instances (Latency < 1 ms) |
Quantidade de ocorrências com latência inferior a 1 ms. Clique em |
|
|
Número de ocorrências dentro de cada intervalo de milissegundos. Método de contagem: O intervalo |
 para expandir os intervalos submilissegundos:
Clique em uma contagem na tabela para abrir um gráfico de tendências desse evento. Especifique as métricas que deseja visualizar no gráfico selecionando seus nomes na lista suspensa acima dele.
Eventos especiais comuns
A tabela a seguir lista os eventos monitorados pelo Latency insight, agrupados por categoria. Cada evento é registrado apenas quando seu tempo de execução excede o limiar listado.
| Categoria | Evento | Limiar | O que mede |
|---|---|---|---|
| Evicção de memória | EvictionDel | 30 ms | Tempo para excluir chaves evictadas em um ciclo de evicção |
| EvictionLazyFree | 30 ms | Tempo para threads em segundo plano liberarem memória em um ciclo de evicção | |
| EvictionCycle | 30 ms | Tempo total do ciclo de evicção: seleção e exclusão de chaves, mais espera por threads em segundo plano | |
| Desfragmentação de memória | ActiveDefragCycle | 100 ms | Tempo para concluir uma passagem de desfragmentação de memória |
| Rehash | Rehash | 100 ms | Tempo para executar um rehash de dicionário |
| Atualização de estrutura de dados | ZipListConvertHash | 30 ms | Tempo para converter uma ziplist em um dicionário usando codificação hash |
| IntsetConvertSet | 30 ms | Tempo para converter um intset em um conjunto usando codificação set | |
| ZipListConvertZset | 30 ms | Tempo para converter uma ziplist em uma skiplist usando codificação ziplist | |
| Arquivo append-only (AOF) | AofWriteAlone | 30 ms | Tempo para gravar um AOF conforme esperado |
| AofWrite | 30 ms | Tempo total de gravação do AOF. Cada gravação gera um evento AofWrite e exatamente um destes: AofWriteAlone, AofWriteActiveChild ou AofWritePendingFsync |
|
| AofFstat | 30 ms | Latência do Fstat | |
| AofRename | 30 ms | Tempo para renomear o arquivo AOF | |
| AofReWriteDiffWrite | 30 ms | Tempo para o processo pai gravar dados incrementais do AOF enquanto um processo filho reescreve o AOF | |
| AofWriteActiveChild | 30 ms | Tempo para gravar o AOF quando outro processo filho também está gravando no disco | |
| AofWritePendingFsync | 30 ms | Tempo para gravar o AOF quando um fsync em segundo plano já está em andamento | |
| Arquivo de banco de dados Redis (RDB) | RdbUnlinkTempFile | 50 ms | Tempo para excluir o arquivo temporário RDB após a saída de um processo filho bgsave |
| Outros | Commands | 30 ms | Tempo de execução para comandos regulares não marcados como @fast |
| FastCommand | 30 ms | Tempo de execução para comandos marcados como @fast (complexidade de tempo O(1) ou O(log N)) |
|
| EventLoop | 50 ms | Tempo para concluir uma iteração do loop de eventos principal | |
| Fork | 100 ms | Tempo para chamar uma operação fork |
|
| Transaction | 50 ms | Tempo total de execução de uma transação | |
| PipeLine | 50 ms | Tempo consumido por um pipeline multithread | |
| ExpireCycle | 30 ms | Tempo para executar uma passagem de limpeza de chaves expiradas | |
| ExpireDel | 30 ms | Tempo para excluir chaves expiradas em um ciclo de limpeza | |
| SlotRdbsUnlinkTempFile | 30 ms | Tempo para excluir o arquivo temporário RDB de um slot após a saída de um processo filho bgsave |
|
| LoadSlotRdb | 100 ms | Tempo para carregar um arquivo RDB de um slot | |
| SlotreplTargetcron | 50 ms | Tempo para carregar um arquivo RDB de um slot em um banco de dados temporário e migrá-lo para o banco de dados de destino usando um processo filho |
Próximos passos
Se observar latência consistentemente alta em eventos específicos, consulte Sugestões para lidar com eventos comuns de latência para obter orientações de correção.