Este tópico descreve como configure os recursos de computação do CloudBox para atender às necessidades do seu negócio, reduzir custos e aumentar a resiliência contra falhas de hardware.
Informações básicas
O hardware do CloudBox conta com as seguintes salvaguardas:
Dispositivos de rede: o design redundante com dois dispositivos e dois uplinks garante alta continuidade de rede no CloudBox e elimina pontos únicos de falha.
Os dados permanecem seguros e confiáveis mesmo se dois servidores de armazenamento falharem simultaneamente.
Dispositivos de computação: o suporte à migração por falha e à migração a quente garante a continuidade dos negócios quando há recursos redundantes suficientes.
Este tópico aborda como escolher as SKUs de computação adequadas para atender às necessidades do negócio e configure recursos redundantes para assegurar a continuidade das operações.
Recomendações para configuração de recursos de computação
Os recursos de computação do CloudBox são fornecidos como SKUs de computação padrão, cada uma com uma configuração predefinida que combina diferentes famílias de instâncias. Ao selecione uma SKU, considere seus requisitos de poder de computação, custos e necessidade de redundância. Veja nossas recomendações:
Para obter mais informações sobre as SKUs de computação compatíveis com o CloudBox, consulte Compute SKU specifications. Se as SKUs disponíveis não atenderem às necessidades do seu negócio, entre em contato com o suporte técnico da Alibaba Cloud para solicitar uma SKU personalizada.
Escolha a configuração de SKU adequada para reduzir custos
-
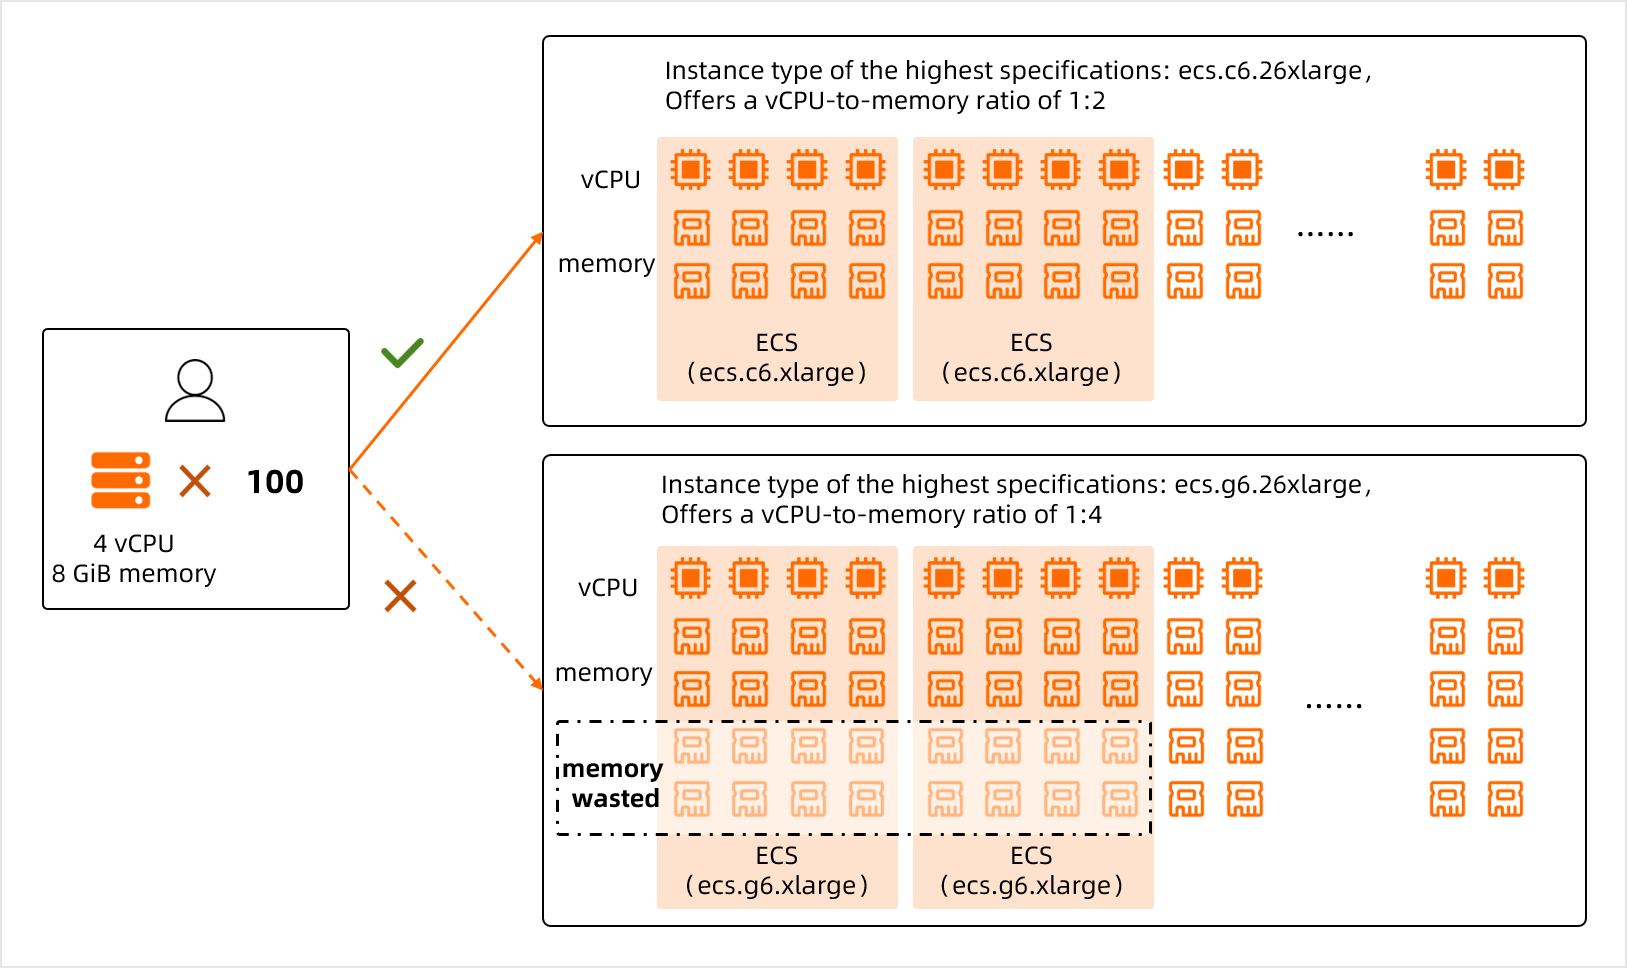
Ao selecione uma SKU, escolha aquela cuja proporção entre vCPU e memória corresponda aos requisitos do seu negócio.
Por exemplo, suponha que seu negócio precise de 100 instâncias ECS com 4 vCPUs e 8 GiB de memória cada. Isso totaliza 400 vCPUs e 800 GiB de memória, resultando em uma proporção vCPU/memória de 1:2. Nesse caso, selecione uma SKU que inclua o tipo de instância ecs.c6.26xlarge. Essa família possui proporção vCPU/memória de 1:2, atendendo às suas necessidades e evitando desperdício de memória. Por outro lado, se você selecione uma SKU com o tipo de instância ecs.g6.26xlarge, haverá desperdício de memória, pois essa família tem proporção vCPU/memória de 1:4.
-
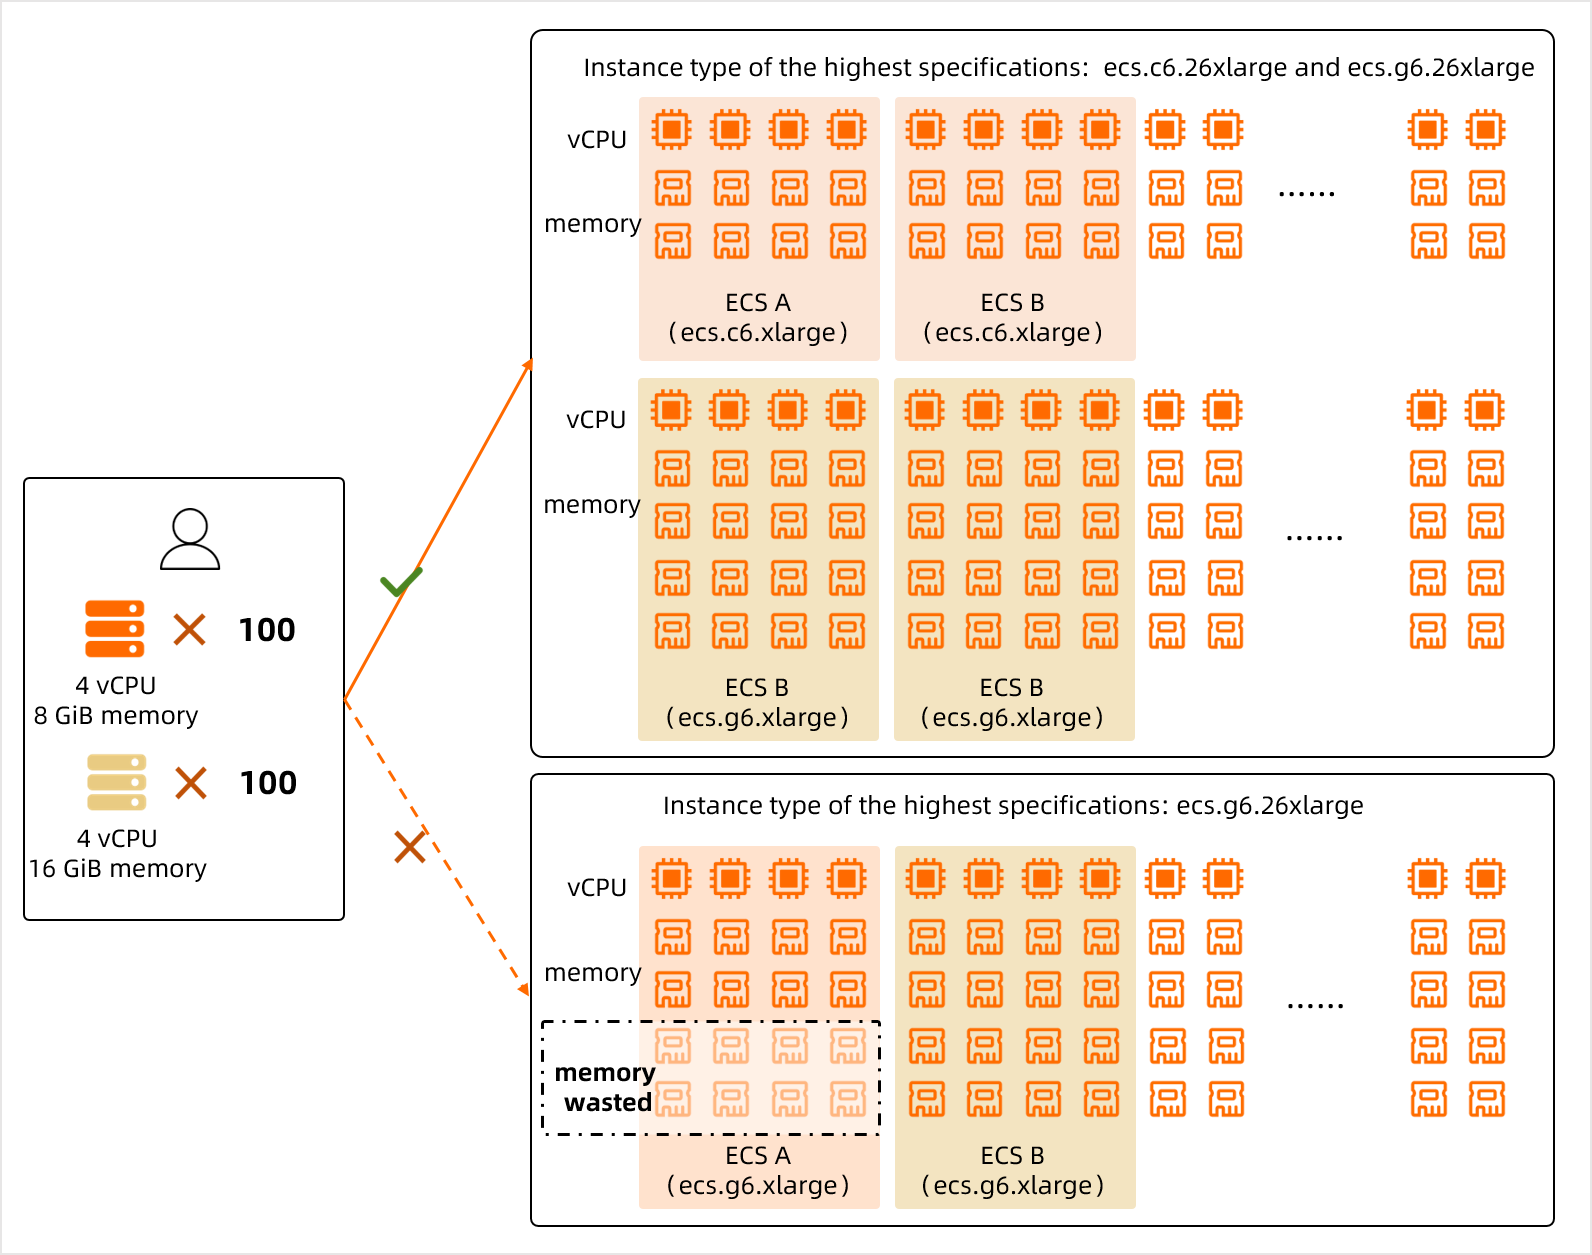
Caso seu negócio exija instâncias ECS com diferentes proporções de vCPU e memória, selecione uma SKU que combine várias famílias de instâncias para minimizar o desperdício de recursos.
Por exemplo, imagine que seu negócio precise de 100 instâncias ECS com 4 vCPUs e 8 GiB de memória, além de outras 100 instâncias com 4 vCPUs e 16 GiB de memória. O total seria de 800 vCPUs e 2.400 GiB de memória. Nesse cenário, evite selecione uma SKU composta apenas por instâncias ecs.g6.26xlarge (cada uma com 104 vCPUs e 384 GiB de memória). Em vez disso, com base nas proporções vCPU/memória dos dois tipos de instância necessários, selecione uma SKU que combine duas famílias, como uma que inclua tanto ecs.c6.26xlarge quanto ecs.g6.26xlarge.
Configure poder de computação redundante para melhorar a resposta a ameaças de hardware
A estabilidade da camada de Infraestrutura como service (IaaS) do CloudBox depende de algoritmos baseados em cloud que preveem falhas de hardware, além das capacidades de migração por falha e migração a quente. Esses recursos aumentam a resiliência da camada IaaS do CloudBox contra falhas e ameaças. No entanto, exigem recursos redundantes para migrar services rapidamente quando um dispositivo de hardware falhar.
Utilize um dos dois métodos a seguir para aumentar os recursos redundantes da camada IaaS do CloudBox e garantir a continuidade dos negócios.
-
Ao selecione SKUs, provisione recursos adicionais para redundância conforme as necessidades do seu negócio.
Esses recursos redundantes ficam disponíveis para uso a qualquer momento na crie de instâncias ECS ou de outros product cloud. Este método oferece flexibilidade operacional, mas não garante a disponibilidade de recursos de backup durante uma falha de hardware.
-
Adquira um pacote de service de valor agregado de Acordo de Nível de service (SLA) para obter garantia de SLA para seus recursos de computação.
O pacote de service de valor agregado de SLA provisiona automaticamente recursos redundantes adequados com base na sua configuração atual. Embora você não acesse diretamente esses recursos, eles são iniciados automaticamente durante uma falha de hardware. Isso assegura a disponibilidade de recursos para lidar com ameaças de hardware e melhora a continuidade dos negócios.