Após migrar dados de um cluster ClickHouse autogerenciado para a nuvem, podem surgir problemas de compatibilidade e desempenho. Para garantir uma migração tranquila, execute esta análise em um ambiente de teste antes de alternar o tráfego de produção.
Informações básicas
Clusters ClickHouse autogerenciados migrados para o ApsaraDB for ClickHouse podem apresentar os seguintes problemas:
-
Problemas de compatibilidade de versão:
Incompatibilidades no mecanismo MaterializedMySQL
Incompatibilidades de SQL
Esgotamento de recursos de CPU e memória insuficiente após a migração para o ApsaraDB for ClickHouse
Para resolver esses problemas, foque na compatibilidade e no desempenho durante a migração.
Este guia aborda:
Compatibilidade de parâmetros: compare as configurações entre clusters e alinhe-as
Compatibilidade do MaterializedMySQL: lide com as diferenças do mecanismo após a migração
Verificação de compatibilidade de SQL: teste em lote suas consultas existentes no novo cluster
Análise de gargalos de desempenho: localize as tabelas e consultas que causam problemas de CPU ou memória
Otimização de SQL: aplique correções direcionadas após identificar a causa raiz
Análise de compatibilidade
Compatibilidade de parâmetros
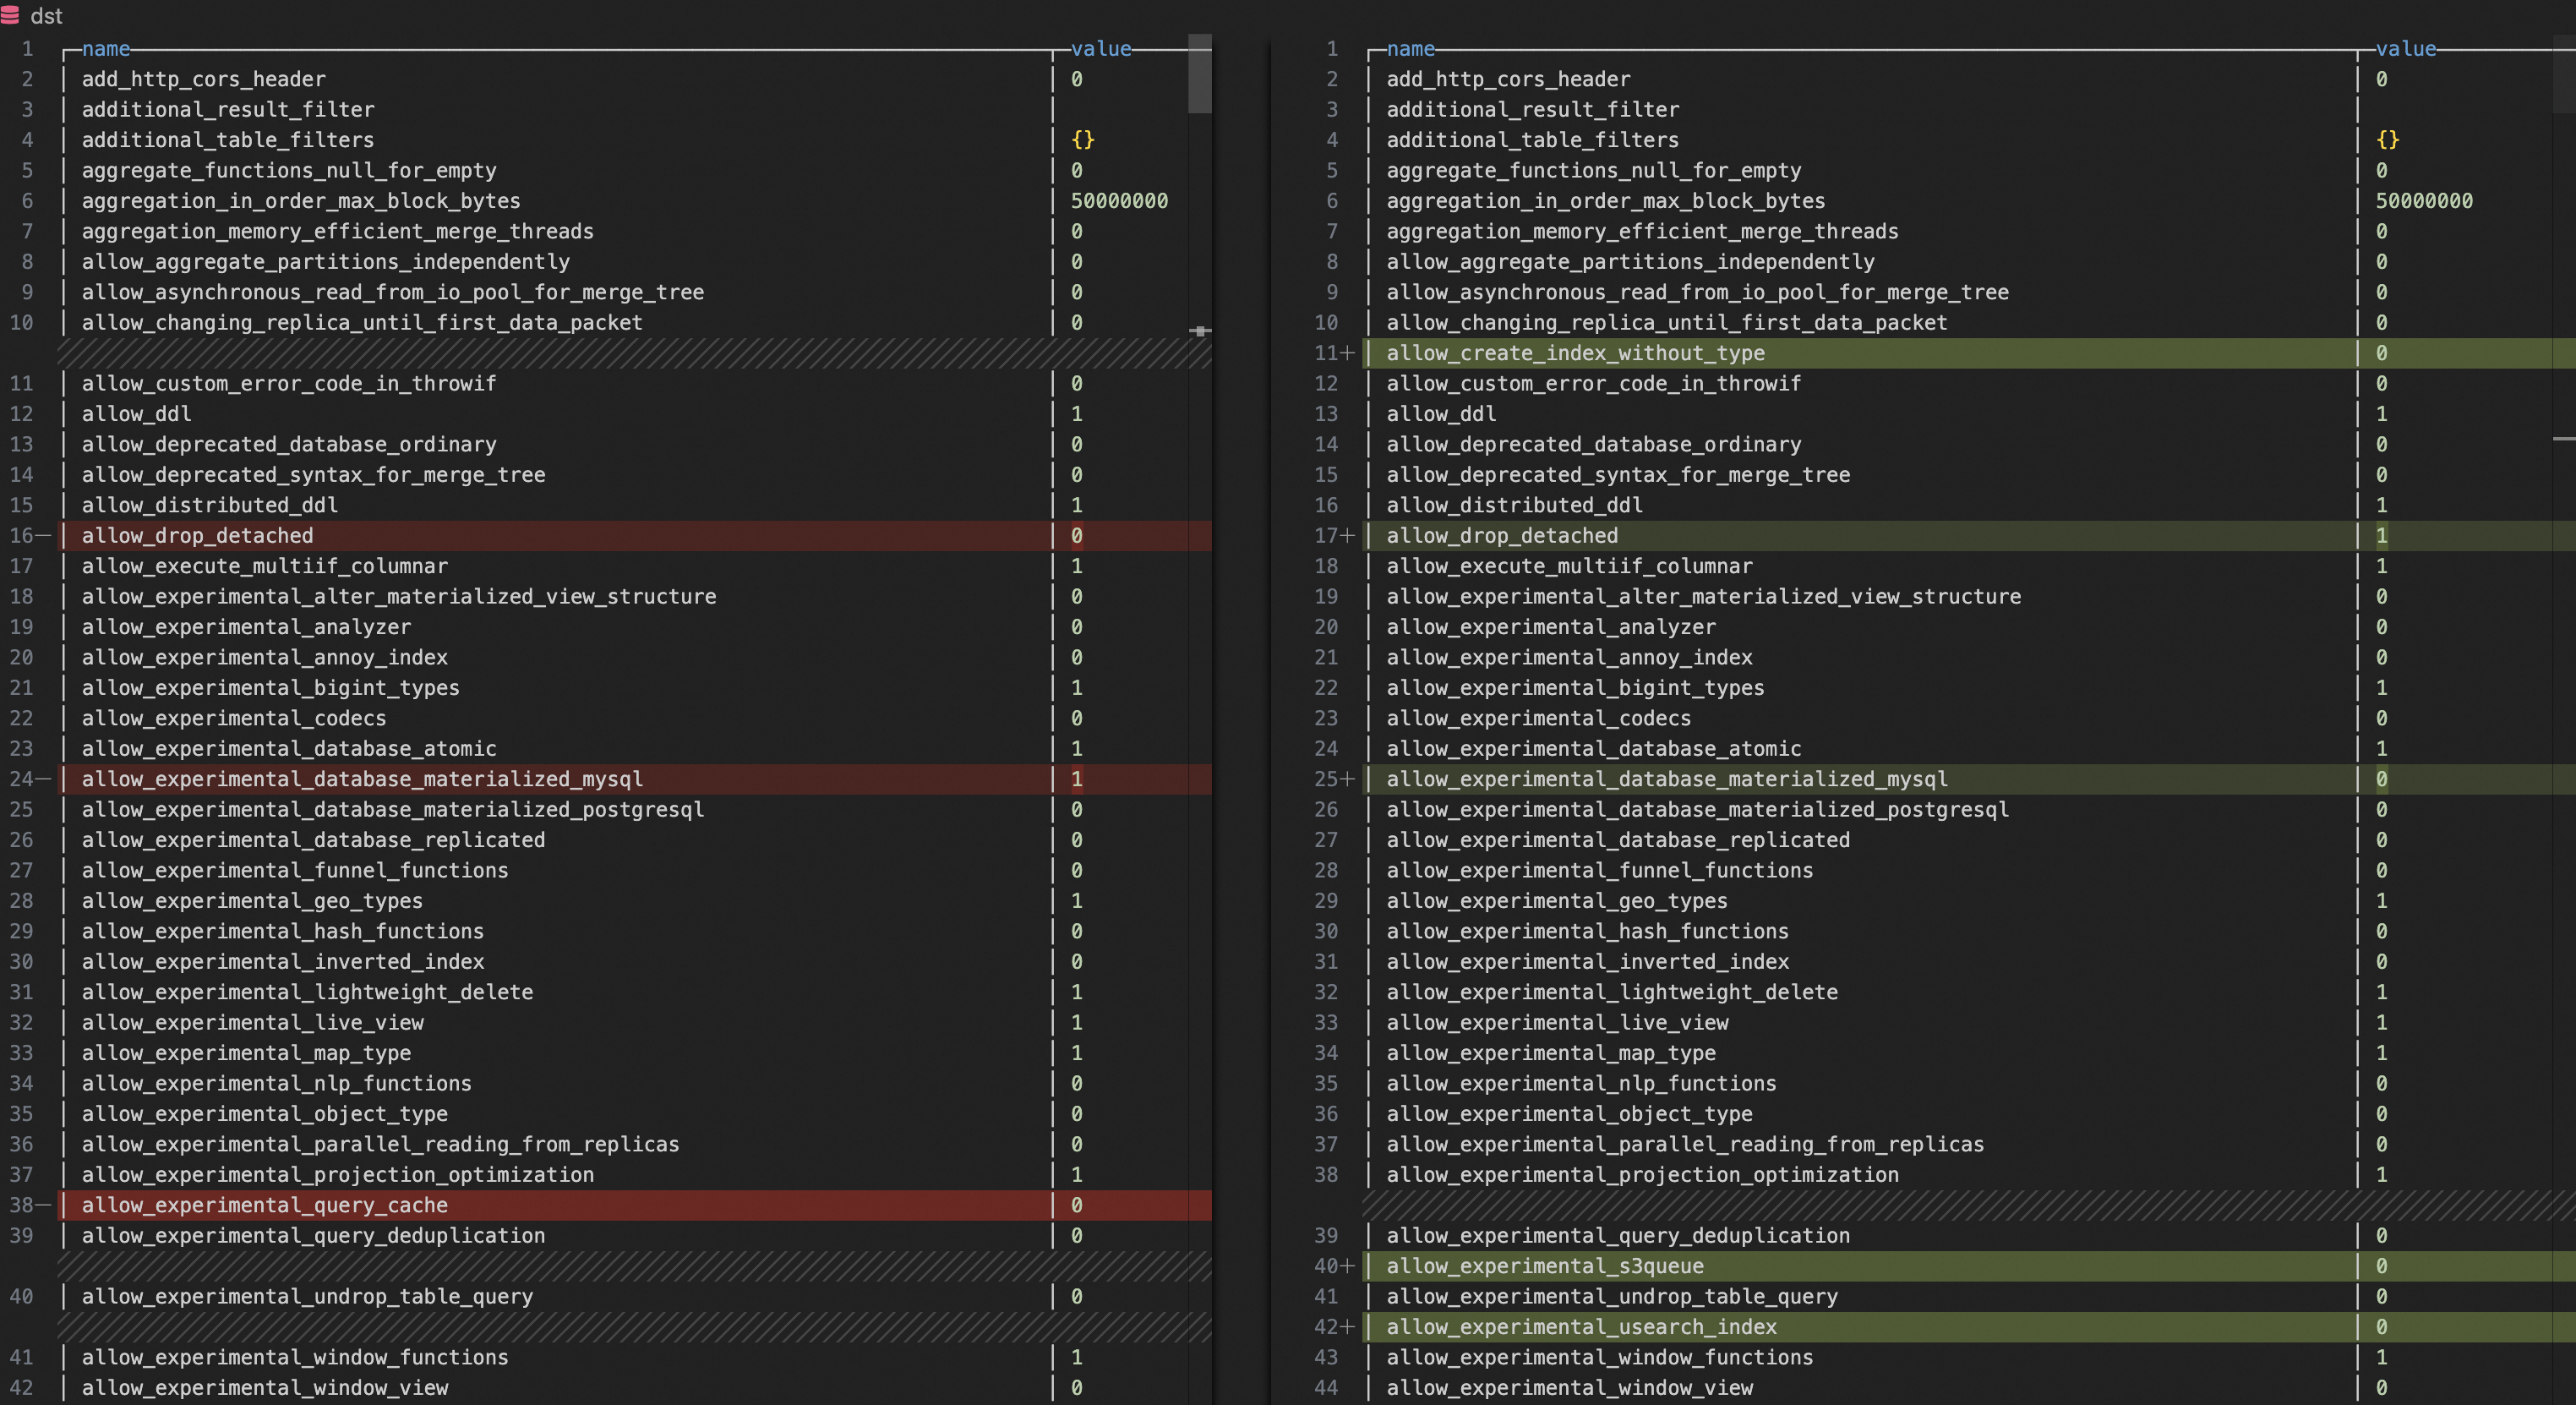
Execute esta consulta tanto no cluster autogerenciado quanto no cluster ApsaraDB for ClickHouse para exportar todos os parâmetros de configuração:
SELECT
    name,
    groupArrayDistinct(value) AS value
FROM clusterAllReplicas(`default`, system.settings)
GROUP BY name
ORDER BY name ASC
Em seguida, utilize uma ferramenta de comparação (como a comparação de arquivos integrada do VS Code) para identificar discrepâncias. Para qualquer parâmetro divergente, atualize o cluster ApsaraDB for ClickHouse para corresponder ao valor do cluster autogerenciado.
Parâmetros que afetam a compatibilidade:
compatibilityprefer_global_in_and_joindistributed_product_mode
Parâmetros que afetam o desempenho:
max_threadsmax_bytes_to_merge_at_max_space_in_poolprefer_global_in_and_join
Compatibilidade do MaterializedMySQL
Se o cluster autogerenciado sincroniza dados do MySQL usando o mecanismo MaterializedMySQL, observe como o ApsaraDB for ClickHouse gerencia esse processo após a migração.
A versão da comunidade do mecanismo MaterializedMySQL não recebe mais manutenção. O ApsaraDB for ClickHouse usa o Data Transmission Service (DTS) para sincronizar dados do MySQL. O DTS cria uma tabela local ReplacingMergeTree em cada nó do cluster e uma tabela distribuída que encaminha gravações para esses nós, substituindo completamente a tabela MaterializedMySQL.
Essa mudança arquitetônica causa dois problemas comuns:
Problema 1: Falhas em consultas IN e JOIN na tabela distribuída
No cluster autogerenciado, o MaterializedMySQL replica dados diretamente para cada shard. Após a migração, os dados fluem por uma tabela distribuída, o que altera a resolução das subconsultas IN e JOIN. Para detalhes e correções, consulte O que devo fazer se ocorrer um erro ao usar uma subconsulta em uma tabela distribuída?.
Problema 2: Dados duplicados nos resultados da consulta
A tabela ReplacingMergeTree mescla linhas duplicadas de forma assíncrona em segundo plano. Se as mesclagens atrasarem, as consultas retornarão mais duplicatas do que no cluster autogerenciado. Duas soluções estão disponíveis:
Solução 1: Forçar deduplicação no momento da consulta
Execute o comando a seguir para ativar o modificador final globalmente. Isso deduplica os resultados durante cada consulta, mas aumenta o uso de CPU e memória:
SET global final = 1;Solução 2: Ajustar a frequência de mesclagem na tabela de destino
Aumente a frequência com que o ApsaraDB for ClickHouse mescla partes na tabela ReplacingMergeTree:
ALTER TABLE <AIM_TABLE>
    MODIFY SETTING
        min_age_to_force_merge_on_partition_only = 1,
min_age_to_force_merge_seconds = 60;|
Parâmetro |
Descrição |
Padrão |
|
|
Quando definido como |
|
|
|
Intervalo de tempo entre mesclagens forçadas de partes (em segundos) |
|
Verificação de compatibilidade de SQL
Utilize um script Python para extrair instruções SELECT do log de consultas do cluster autogerenciado e reproduzi-las no ApsaraDB for ClickHouse. Consultas com falha indicam problemas de compatibilidade de SQL a resolver antes da migração.
Pré-requisitos
Antes de começar, certifique-se de ter:
Um ambiente Python 3 no servidor de verificação. Uma instância do Elastic Compute Service (ECS) da Alibaba Cloud com Linux já inclui o Python 3. Caso não use o ECS, instale o Python 3 no site oficial do Python.
Conectividade de rede do servidor de verificação para ambos os clusters. Para solucionar problemas de conectividade, consulte Como resolvo problemas de conectividade de rede entre o cluster de destino e a fonte de dados?
Verificar compatibilidade de SQL
-
Instale a biblioteca cliente Python para ClickHouse:
pip3 install clickhouse_driver -
Crie um arquivo Python com o script a seguir. Substitua os valores de espaço reservado pelos detalhes reais de conexão:
from clickhouse_driver import connect
import datetime
import logging
# pip3 install clickhouse_driver is required.

# Connection settings for the self-managed cluster
host_old = 'HOST_OLD'          # VPC endpoint
port_old = TCP_PORT_OLD        # TCP port
user_old = 'USER_OLD'          # Username
password_old = 'PASSWORD_OLD'  # Password

# Connection settings for ApsaraDB for ClickHouse
host_new = 'HOST_NEW'          # VPC endpoint
port_new = TCP_PORT_NEW        # TCP port
user_new = 'USER_NEW'          # Username
password_new = 'PASSWORD_NEW'  # Password

logging.basicConfig(level=logging.INFO, format='%(asctime)s - %(levelname)s - %(message)s')

def create_connection(host, port, user, password):
    """Establish a connection to ClickHouse."""
    return connect(host=host, port=port, user=user, password=password)

def get_query_hashes(cursor):
    """Query the query_hash list of the last two days."""
    get_queryhash_sql = '''
    select distinct normalized_query_hash from system.query_log
    where type='QueryFinish'
      and `is_initial_query`=1
      and `user` not in ('default', 'aurora')
      and lower(`query`) not like 'select 1%'
      and lower(`query`) not like 'select timezone()%'
      and lower(`query`) not like '%dms-websql%'
      and lower(`query`) like 'select%'
      and `event_time` > now() - INTERVAL 2 DAY;
    '''
    cursor.execute(get_queryhash_sql)
    return cursor.fetchall()

def get_sql_info(cursor, queryhash):
    """Query the SQL information for the specified query_hash in the last 2 days (search range is 3 days)."""
    get_sqlinfo_sql = f'''
    select `event_time`, `query_duration_ms`, `read_rows`, `read_bytes`, `memory_usage`, `databases`, `tables`, `current_database`, `query`
    from system.query_log
    where `event_time` > now() - INTERVAL 3 DAY and `type`='QueryFinish' and `normalized_query_hash`='{queryhash}' limit 1
    '''
    cursor.execute(get_sqlinfo_sql)
    sql_info = cursor.fetchone()
    if sql_info:
        return [info.strftime('%Y-%m-%d %H:%M:%S') if isinstance(info, datetime.datetime) else info for info in sql_info[:-1]], sql_info[-1]
    return None

def execute_sql_on_new_db(cursor, current_database, query_sql, execute_failed_sql):
    """Execute the SQL query on the new cluster and record any failures."""
    try:
        cursor.execute(f"USE {current_database};")
        cursor.execute(query_sql)
    except Exception as error:
        logging.error(f'query_sql execute in new db failed: {query_sql}')
        execute_failed_sql[query_sql] = error

def main():
    conn_old = create_connection(host=host_old, port=port_old, user=user_old, password=password_old)
    conn_new = create_connection(host=host_new, port=port_new, user=user_new, password=password_new)

    cursor_old = conn_old.cursor()
    cursor_new = conn_new.cursor()

    # Extract query hashes and SQL from the self-managed cluster
    old_query_hashes = get_query_hashes(cursor_old)
    old_db_execute_dir = {}
    for queryhash in old_query_hashes:
        sql_info, query = get_sql_info(cursor_old, queryhash[0])
        if sql_info:
            old_db_execute_dir[query] = sql_info

    cursor_old.close()
    conn_old.close()

    # Replay queries against ApsaraDB for ClickHouse
    execute_failed_sql = {}
    keys_list = list(old_db_execute_dir.keys())
    for query_sql in old_db_execute_dir:
        position = keys_list.index(query_sql)
        current_database = old_db_execute_dir[query_sql][-1]
        logging.info(f"new db test the {position + 1}th/{len(old_db_execute_dir)}, running sql: {query_sql}\n")
        execute_sql_on_new_db(cursor_new, current_database, query_sql, execute_failed_sql)

    # Collect execution results from ApsaraDB for ClickHouse
    new_query_hashes = get_query_hashes(cursor_new)
    new_db_execute_dir = {}
    for queryhash in new_query_hashes:
        sql_info, query = get_sql_info(cursor_new, queryhash[0])
        if sql_info:
            new_db_execute_dir[query] = sql_info

    cursor_new.close()
    conn_new.close()

    # Log results
    for query_sql in new_db_execute_dir:
        if query_sql in old_db_execute_dir:
            logging.info(f'succeed sql: {query_sql}')
            logging.info(f'old sql info: {old_db_execute_dir[query_sql]}')
            logging.info(f'new sql info: {new_db_execute_dir[query_sql]}\n')

    for query_sql in execute_failed_sql:
        logging.error('\033[31m{}\033[0m'.format(f'failed sql: {query_sql}'))
        logging.error('\033[31m{}\033[0m'.format(f'failed error: {execute_failed_sql[query_sql]}\n'))

if __name__ == "__main__":
    main()
Execute o script e revise a saída. Cada consulta com falha é registrada em vermelho com sua mensagem de erro. Investigue e corrija as falhas com base no erro específico antes de prosseguir com a migração de produção.
Análise e otimização de desempenho
Após alternar o tráfego para o ApsaraDB for ClickHouse, pode ocorrer saturação de CPU ou esgotamento de memória. As etapas a seguir ajudam a localizar sistematicamente a causa raiz, desde a identificação das tabelas problemáticas até o isolamento e correção de consultas específicas.
Se já souber qual tabela ou consulta causa o problema de desempenho, pule diretamente para a Etapa 3: Analisar o desempenho do SQL.
Etapa 1: Identificar tabelas que causam o gargalo de desempenho
Duas abordagens estão disponíveis: gráficos de chama e análise de query_log. Os gráficos de chama exigem mais configuração, mas fornecem uma divisão visual e intuitiva do uso da CPU. A análise de query_log é mais simples e dispensa ferramentas externas, mas exige interpretação manual dos dados. Use ambas em conjunto para obter uma visão mais completa.
Criar um gráfico de chama
Conecte-se ao ApsaraDB for ClickHouse usando o
clickhouse-client. Para instruções de conexão, consulte Conectar-se a um cluster ClickHouse usando a interface de linha de comando.-
Exporte o
trace_logreferente à janela de tempo em que o problema de desempenho ocorreu. Substitua<IP>,<port>e os valores deevent_timepelos valores reais:Parâmetro
Descrição
<IP>Endpoint da Virtual Private Cloud (VPC) do ApsaraDB for ClickHouse
<port>Porta TCP do ApsaraDB for ClickHouse
# trace_type = 'CPU' collects CPU call stacks.
# trace_type = 'Real' collects wall-clock call stacks.
/clickhouse/bin/clickhouse-client -h <IP> --port <port> -q \
  "SELECT arrayStringConcat(arrayReverse(arrayMap(x -> concat( addressToLine(x), '#', demangle(addressToSymbol(x)) ), trace)), ';') AS stack, count() AS samples \
  FROM system.trace_log \
  WHERE trace_type = 'CPU' \
    AND event_time >= '2025-01-08 19:31:00' \
    AND event_time < '2025-01-08 19:33:00' \
  GROUP BY trace \
  ORDER BY samples DESC \
  FORMAT TabSeparated \
  SETTINGS allow_introspection_functions=1" > cpu_trace_log.txt
Instale o
clickhouse-flamegraph. Para instruções de download e instalação, consulte clickhouse-flamegraph.-
Gere o gráfico de chama:
cat cpu_trace_log.txt | flamegraph.pl > cpu_trace_log.svgAbra o arquivo SVG para identificar as funções que mais consomem CPU. Por exemplo, se
ReplacingSortedMergeaparecer com destaque, concentre a investigação em consultas às tabelasReplacingMergeTree.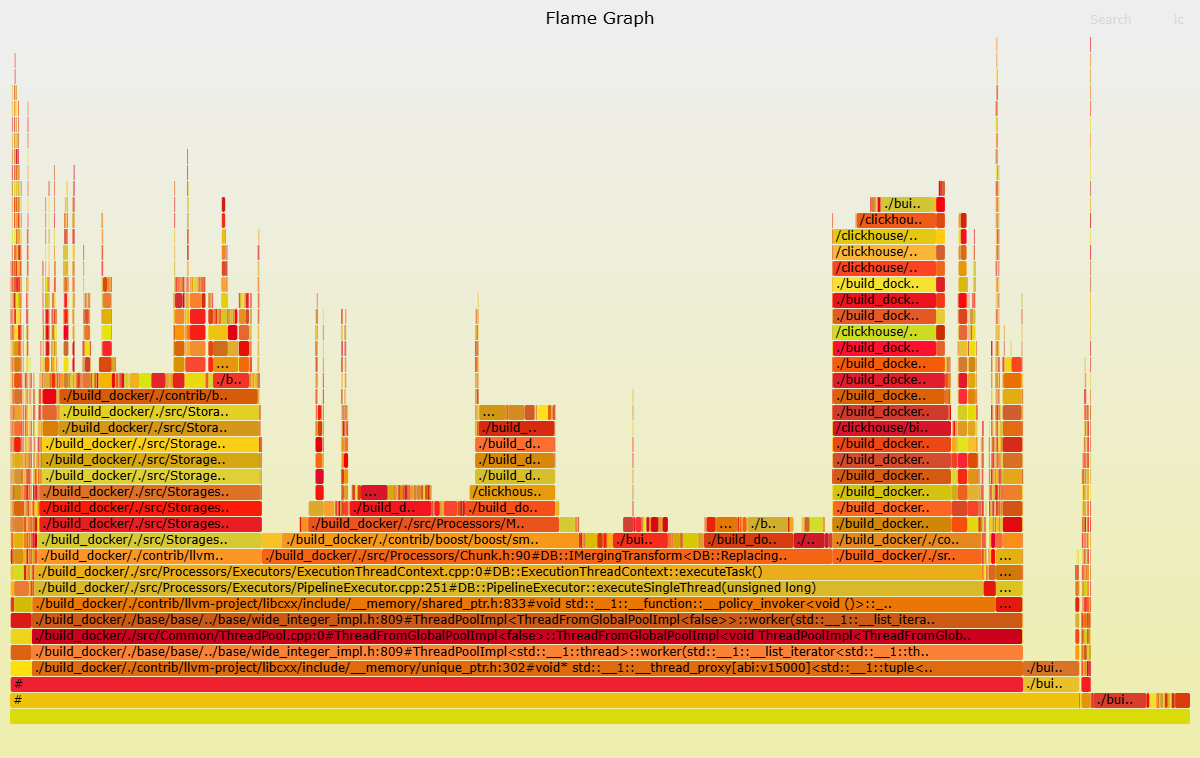
Analisar query_log
Execute estas consultas simultaneamente em ambos os clusters para realizar uma comparação dos N principais. Procure tabelas nas quais o uso de CPU ou memória seja significativamente maior no ApsaraDB for ClickHouse do que no cluster autogerenciado; essas são as candidatas.
Alto uso de CPU ou memória em uma tabela nem sempre causa degradação geral do cluster. Isso apenas indica maior probabilidade de essa tabela ser a source do problema. Compare os resultados entre ambos os clusters para confirmar.
Localizar tabelas com problemas de CPU
SELECT
    tables,
    first_value(query),
    count() AS cnt,
    groupArrayDistinct(normalizedQueryHash(query)) AS normalized_query_hash,
    sum(ProfileEvents.Values[indexOf(ProfileEvents.Names, 'UserTimeMicroseconds')]) AS sum_user_cpu,
    sum(ProfileEvents.Values[indexOf(ProfileEvents.Names, 'SystemTimeMicroseconds')]) AS sum_system_cpu,
    avg(ProfileEvents.Values[indexOf(ProfileEvents.Names, 'UserTimeMicroseconds')]) AS avg_user_cpu,
    avg(ProfileEvents.Values[indexOf(ProfileEvents.Names, 'SystemTimeMicroseconds')]) AS avg_system_cpu,
    sum(memory_usage) AS sum_memory_usage,
    avg(memory_usage) AS avg_memory_usage
FROM clusterAllReplicas(default, system.query_log)
WHERE (event_time > '2025-01-08 19:30:00') AND (event_time < '2025-01-08 20:30:00') AND (query_kind = 'Select')
GROUP BY tables
ORDER BY sum_user_cpu DESC
LIMIT 5
Localizar tabelas com problemas de memória
SELECT
    tables,
    first_value(query),
    count() AS cnt,
    groupArrayDistinct(normalizedQueryHash(query)) AS normalized_query_hash,
    sum(ProfileEvents.Values[indexOf(ProfileEvents.Names, 'UserTimeMicroseconds')]) AS sum_user_cpu,
    sum(ProfileEvents.Values[indexOf(ProfileEvents.Names, 'SystemTimeMicroseconds')]) AS sum_system_cpu,
    avg(ProfileEvents.Values[indexOf(ProfileEvents.Names, 'UserTimeMicroseconds')]) AS avg_user_cpu,
    avg(ProfileEvents.Values[indexOf(ProfileEvents.Names, 'SystemTimeMicroseconds')]) AS avg_system_cpu,
    sum(memory_usage) AS sum_memory_usage,
    avg(memory_usage) AS avg_memory_usage
FROM clusterAllReplicas(default, system.query_log)
WHERE (event_time > '2025-01-08 19:30:00') AND (event_time < '2025-01-08 20:30:00') AND (query_kind = 'Select')
GROUP BY tables
ORDER BY sum_memory_usage
LIMIT 5
Substitua os valores de event_time pela janela de tempo em que o problema de desempenho ocorreu.
Etapa 2: Identificar consultas que causam o gargalo de desempenho
Após identificar a tabela problemática na Etapa 1, execute as consultas a seguir para isolar as instruções SQL específicas que causam o problema. Substitua <AIM_TABLE> pelo nome da tabela da Etapa 1 e atualize event_time para corresponder à janela de tempo alvo.
Localizar consultas SQL que causam problemas de CPU
SELECT
    tables,
    first_value(query),
    count() AS cnt,
    normalizedQueryHash(query) AS normalized_query_hash,
    sum(ProfileEvents.Values[indexOf(ProfileEvents.Names, 'UserTimeMicroseconds')]) AS sum_user_cpu,
    sum(ProfileEvents.Values[indexOf(ProfileEvents.Names, 'SystemTimeMicroseconds')]) AS sum_system_cpu,
    avg(ProfileEvents.Values[indexOf(ProfileEvents.Names, 'UserTimeMicroseconds')]) AS avg_user_cpu,
    avg(ProfileEvents.Values[indexOf(ProfileEvents.Names, 'SystemTimeMicroseconds')]) AS avg_system_cpu,
    sum(memory_usage) AS sum_memory_usage,
    avg(memory_usage) AS avg_memory_usage
FROM clusterAllReplicas(default, system.query_log)
WHERE (event_time > '2025-01-08 19:30:00') AND (event_time < '2025-01-08 20:30:00') AND (query_kind = 'Select') AND has(tables, '<AIM_TABLE>')
GROUP BY
    tables,
    normalized_query_hash
ORDER BY sum_user_cpu DESC
LIMIT 5
Localizar consultas SQL que causam problemas de memória
SELECT
    tables,
    first_value(query),
    count() AS cnt,
    normalizedQueryHash(query) AS normalized_query_hash,
    sum(ProfileEvents.Values[indexOf(ProfileEvents.Names, 'UserTimeMicroseconds')]) AS sum_user_cpu,
    sum(ProfileEvents.Values[indexOf(ProfileEvents.Names, 'SystemTimeMicroseconds')]) AS sum_system_cpu,
    avg(ProfileEvents.Values[indexOf(ProfileEvents.Names, 'UserTimeMicroseconds')]) AS avg_user_cpu,
    avg(ProfileEvents.Values[indexOf(ProfileEvents.Names, 'SystemTimeMicroseconds')]) AS avg_system_cpu,
    sum(memory_usage) AS sum_memory_usage,
    avg(memory_usage) AS avg_memory_usage
FROM clusterAllReplicas(default, system.query_log)
WHERE (event_time > '2025-01-08 19:30:00') AND (event_time < '2025-01-08 20:30:00') AND (query_kind = 'Select') AND has(tables, 'AIM_TABLE')
GROUP BY
    tables,
    normalized_query_hash
ORDER BY sum_memory_usage
LIMIT 5
Etapa 3: Analisar o desempenho do SQL
Use EXPLAIN PIPELINE e system.query_log para entender por que uma consulta específica está lenta.
Analise o plano de execução:
EXPLAIN PIPELINE <SQL with performance issues>Para detalhes sobre como ler a saída do EXPLAIN, consulte a documentação do EXPLAIN do ClickHouse.
Analise as métricas de execução do query_log:
SELECT
    hostname() AS host,
    *
FROM clusterAllReplicas(`default`, system.query_log)
WHERE
    event_time > '2025-01-18 00:00:00'
    AND event_time < '2025-01-18 03:00:00'
    AND initial_query_id = '<INITIAL_QUERY_ID>'
    AND type = 'QueryFinish'
ORDER BY query_start_time_microseconds
Substitua <INITIAL_QUERY_ID> pelo ID da consulta da instrução a investigar e atualize event_time para cobrir a janela de tempo relevante.
Concentre-se nestes campos na saída:
|
Campo |
O que procurar |
|
|
Contadores detalhados para tempo de CPU, E/S de disco, alocação de memória e rede. Compara o uso de recursos entre nós. Consulte a referência de eventos do sistema. |
|
|
Parâmetros de configuração ativos durante a consulta. Ajuda a identificar configurações que podem causar comportamento inesperado. Consulte a referência de configurações. |
|
|
Tempo total de execução da consulta. Se uma subconsulta estiver excepcionalmente lenta, use seu |
Se as métricas sozinhas não explicarem a degradação do desempenho, extraia as informações de execução da mesma consulta do cluster autogerenciado e compare-as lado a lado com os resultados do ApsaraDB for ClickHouse. Diferenças nos valores de ProfileEvents frequentemente revelam a causa raiz.
Etapa 4: Otimizar SQL
Após identificar a consulta lenta, aplique as otimizações relevantes a seguir. A maioria das regressões de desempenho após a migração tem uma causa raiz específica. Concentre-se na técnica correspondente às suas descobertas em vez de aplicar todas de uma vez.
|
Otimização |
Descrição |
|
Otimização de índice |
Identifique colunas usadas frequentemente em cláusulas WHERE e crie um índice para elas. |
|
Tipos de dados |
Utilize os tipos de dados mais apropriados para reduzir a sobrecarga de armazenamento e acelerar leituras. |
|
**Evitar |
Selecione apenas as colunas necessárias para reduzir E/S e transferência de rede. |
|
Usar chave primária e colunas indexadas no WHERE |
Filtre em colunas indexadas para habilitar a poda de dados. |
|
Usar PREWHERE |
Mova condições de filtro seletivas para |
|
Usar GLOBAL JOIN para tabelas distribuídas |
Substitua o |
|
Ajustar |
Aumentar |
|
Criar materialized views |
Para consultas complexas executadas frequentemente com resultados estáveis, pré-agregue com uma materialized view. |
|
Ajustar compressão de dados |
O ClickHouse comprime dados por padrão. Ajustar o algoritmo e o nível de compressão pode melhorar a eficiência de armazenamento e a velocidade da consulta. |
|
Expandir o cache de consultas |
Para consultas estáveis e repetidas frequentemente, aumente |