Saiba como selecionar chaves de partição de tabela no ApsaraDB for ClickHouse para otimizar o desempenho e aumentar a eficiência do gerenciamento de dados.
Chaves de partição
O recurso de partição organiza os dados em segmentos lógicos com base em chaves especificadas e os divide em fragmentos separados (partes) conforme a chave de partição.
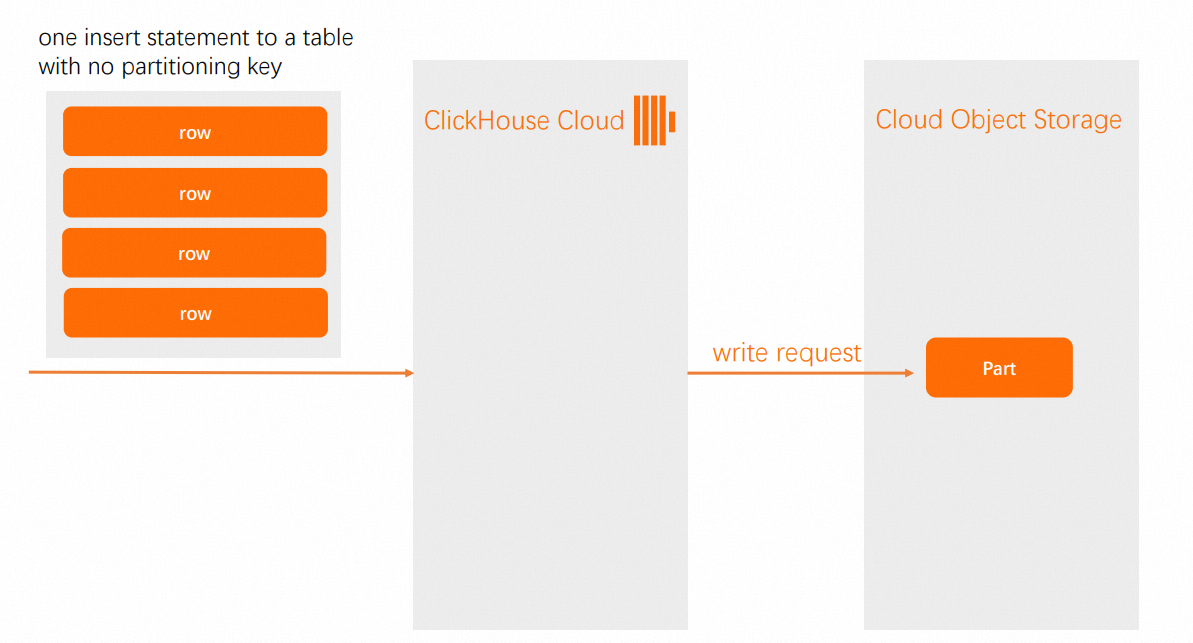
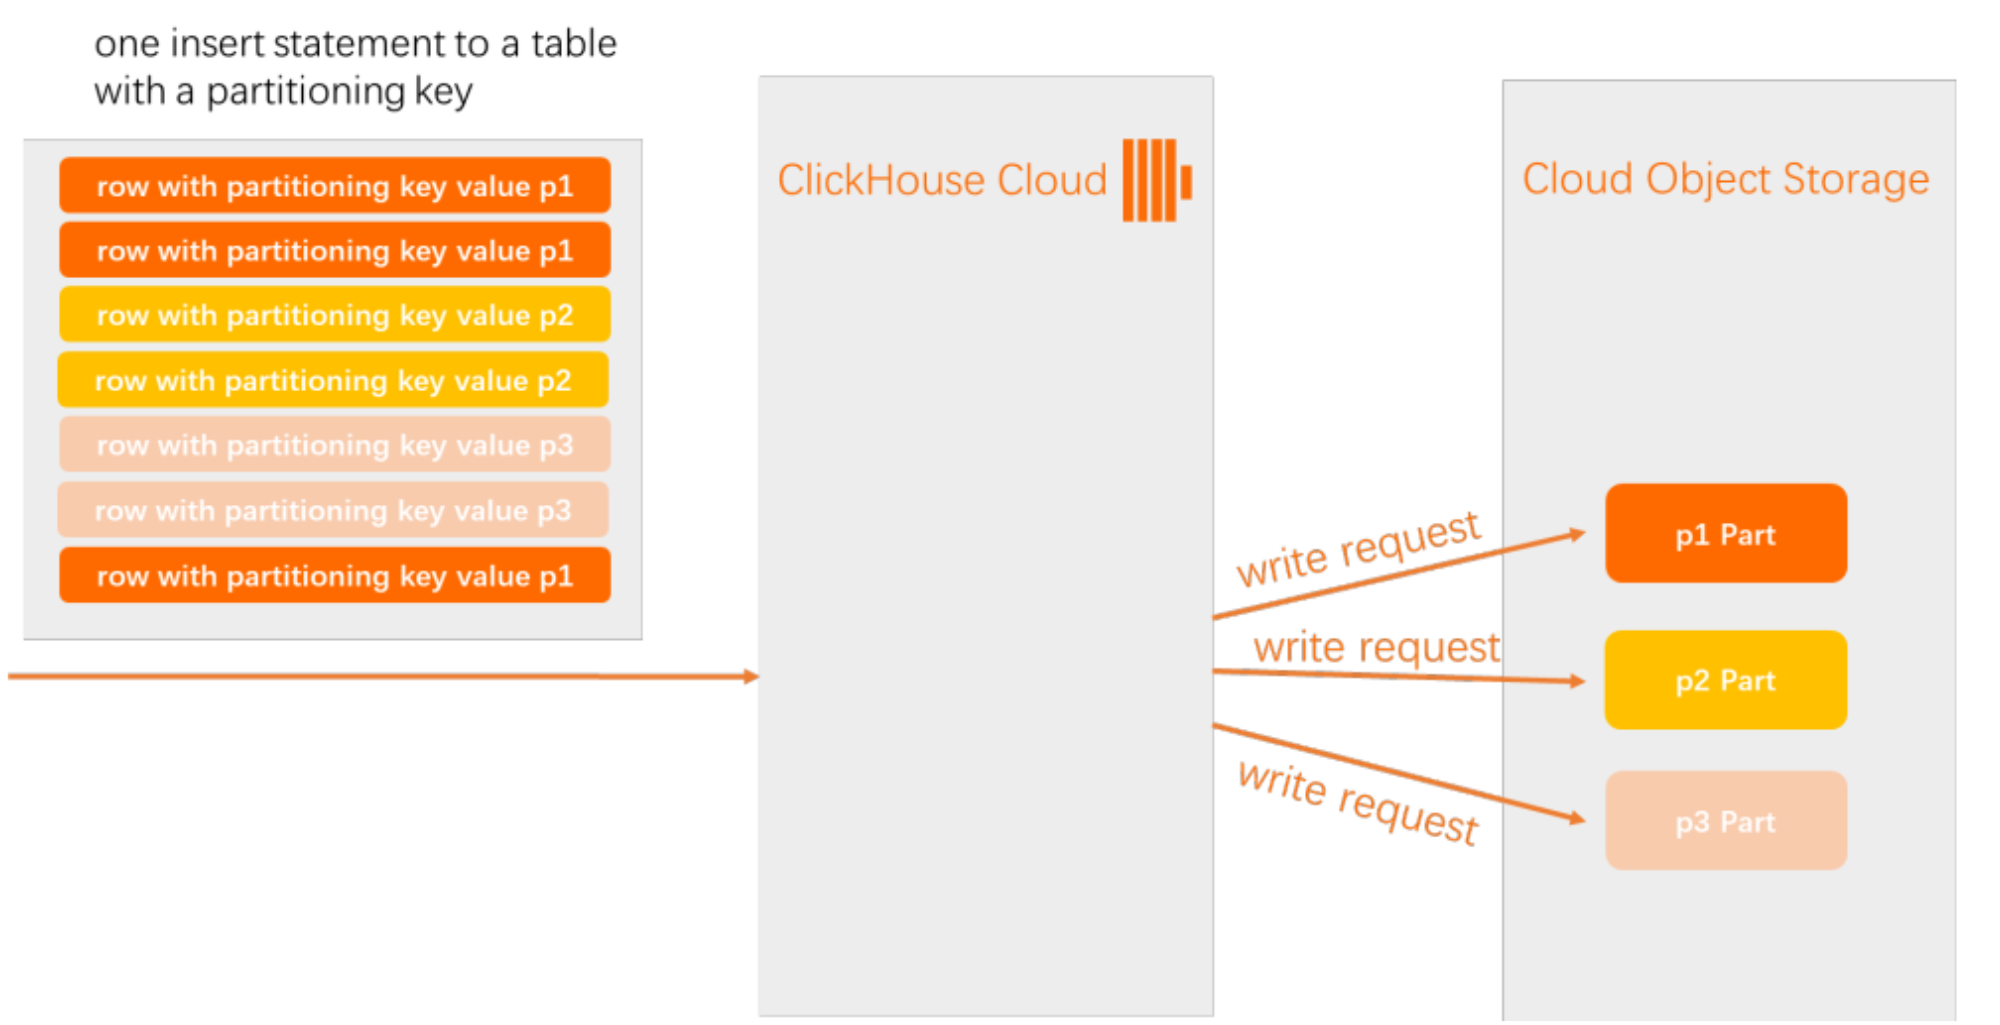
No ApsaraDB for ClickHouse Enterprise Edition, ao inserir várias linhas em uma tabela sem chave de partição, todos os dados são gravados em uma única nova parte de dados. Quando a tabela utiliza uma chave de partição, o sistema executa as seguintes operações:
Verifica os valores da chave de partição das linhas inseridas.
Crie uma parte de dados no armazenamento para cada valor exclusivo de chave de partição.
Atribui as linhas às partes de dados correspondentes com base nos valores da chave de partição.
|
Tabela sem chave de partição
|
Tabela com chave de partição
|
Princípios fundamentais
Para reduzir as solicitações de gravação nos buckets do Object Storage Service que armazenam dados do ApsaraDB for ClickHouse Enterprise Edition, escolha chaves de partição com baixa cardinalidade (poucos valores distintos) e campos fáceis de gerenciar, como tempo. As chaves primárias devem abranger campos frequentemente filtrados em uma ordem lógica. Evite campos de alta cardinalidade, particionamento excessivamente granular e chaves primárias irrelevantes para aproveitar totalmente o desempenho do ClickHouse.
-
O particionamento é uma ferramenta de gerenciamento de dados
Utilize o particionamento para expiração de dados, armazenamento em camadas e exclusão em lote, em vez de usá-lo como ferramenta de otimização de consultas. Para obter mais informações, consulte Choosing a Partitioning Key.
-
Escolha um campo de baixa cardinalidade como chave de partição
Mantenha o número de partições entre 100 e 1.000. Evite campos de alta cardinalidade (campos com muitos valores distintos, como user_id ou números de dispositivo) como chaves de partição. Caso contrário, o número de partes pode crescer exponencialmente, degradando o desempenho ou causando erros de "too many parts".
-
O método mais comum é o particionamento baseado em tempo
Particione por mês ou dia usando funções como toYYYYMM(date), toStartOfMonth(date) ou toDate(date). Isso simplifica o gerenciamento do ciclo de vida dos dados e o armazenamento em camadas quente/frio. Para obter mais informações, consulte Custom Partitioning Key.
-
As chaves de partição devem estar alinhadas ao ciclo de vida dos dados, arquivamento, limpeza e outros requisitos de gerenciamento
Escolha dimensões que suportem o gerenciamento em lote sob a perspectiva de negócios. Para obter mais informações, consulte Applications of partitioning.
Recomendações de design de tabela
Priorize o particionamento baseado em tempo
Em cenários de log, séries temporais e monitoramento, particione por mês ou dia. Por exemplo, uma tabela de logs particionada por mês, com os dados de cada mês em uma partição separada, oferece as seguintes vantagens:
Gerenciamento de dados eficiente: Exclua, arquive ou mova dados em lotes por partição usando as ferramentas de gerenciamento de dados. Por exemplo, em vez de usar
ALTER TABLE DELETEpara excluir dados expirados, utilizeDROP PARTITIONpara remover uma partição inteira sem verificar a tabela completa.Implementação facilitada de gerenciamento do ciclo de vida de dados (TTL): Combine partições com políticas de TTL para limpar automaticamente dados expirados, simplificando as operações e a manutenção.
A eliminação de partições melhora a eficiência das consultas: Ao filtrar por tempo, o ClickHouse verifica apenas as partições relevantes, reduzindo a E/S e acelerando as consultas.
Evite campos de alta cardinalidade para particionamento
Não use IDs de usuário, números de pedido ou números de dispositivo como chaves de partição. Por exemplo, se uma tabela usar user_id como chave de partição, cada usuário exclusivo gera uma partição separada, resultando nas seguintes desvantagens:
Explosão de partições: Cada ID de usuário exclusivo gera uma partição, excedendo em muito o intervalo recomendado de 100 a 1.000, o que sobrecarrega o gerenciamento de metadados e o sistema de arquivos.
Falha na mesclagem em segundo plano: O ClickHouse mescla partes apenas dentro da mesma partição. Muitas partições impedem a mesclagem eficaz, deixando diversas partes pequenas que degradam o desempenho de consultas e gravações.
Degradação do desempenho de consultas: A verificação de grandes quantidades de metadados de partição durante as consultas reduz a eficiência geral.
Esgotamento de recursos da instância: Partes de partição excessivas consomem muita memória e identificadores de arquivo, podendo fazer com que o ClickHouse inicie lentamente ou falhe completamente.
Evite particionamento excessivamente granular
Não particione por hora, minuto ou segundo, a menos que o volume de dados seja extremamente grande e existam requisitos específicos. Por exemplo, o particionamento por minuto com toYYYYMMDDhhmm(event_time) gera 1.440 partições por dia e mais de 500.000 por ano, apresentando as seguintes desvantagens:
-
Excesso de partições: O particionamento muito fino ultrapassa em muito o intervalo recomendado de 100 a 1.000, aumentando significativamente a carga sobre o gerenciamento de metadados e do sistema de arquivos.
Erro típico:
DB::Exception: Too many parts (N). Merges are processing significantly slower than inserts. Falha na mesclagem em segundo plano: O ClickHouse mescla partes apenas dentro da mesma partição. Um número excessivo de partições impede a mesclagem eficaz, deixando muitas partes pequenas que degradam o desempenho.
Degradação do desempenho de consultas e gravações: A verificação de grandes volumes de metadados de partição reduz a eficiência das consultas, enquanto o número excessivo de partes também torna as gravações mais lentas.
Use campos originais ou expressões simples como chaves de partição
Evite funções complexas para que o ClickHouse possa aplicar a eliminação de partições de forma eficaz.
Projete chaves de partição em conjunto com chaves primárias
Utilize chaves primárias para abranger campos de filtro comuns em consultas e chaves de partição para o gerenciamento de dados.
Por exemplo, para uma tabela de logs que é frequentemente consultada por intervalo de tempo e nome de serviço e requer limpeza periódica de dados expirados:
Chave de partição: toYYYYMM(event_time) cria uma partição por mês, permitindo exclusão em lote mensal, arquivamento e armazenamento em camadas quente/frio.
Chave primária: (service_name, event_time) permite que consultas como
WHERE service_name = 'A' AND event_time BETWEEN ...utilizem totalmente o índice de chave primária para uma eliminação eficiente de dados.
Exemplos de design de tabela
CREATE TABLE logs
(
    event_time DateTime,
    service_name String,
    log_level String,
    message String
)
ENGINE = MergeTree
PARTITION BY toYYYYMM(event_time)         -- Partition by month for easy data management
ORDER BY (service_name, event_time)       -- Primary key covers commonly filtered fields
Escolhas de chave de partição não recomendadas
Chave de partição como user_id (alta cardinalidade): Uma partição por usuário, resultando em excesso de partições, falha de mesclagem e desempenho extremamente baixo.
Chave de partição como device_id (alta cardinalidade): Assim como no caso anterior, causa erros de "too many parts" e partições ingerenciáveis.
Chave de partição como order_id (alta cardinalidade): Uma partição por pedido, causando fragmentação extrema.
Chave de partição como name (string de alta cardinalidade): Número de partições incontrolável e difícil de gerenciar.
Chave de partição como toHour(event_time) (granularidade excessiva): 24 partições por dia, gerando um número extremamente alto de partições ao longo do tempo e falha de mesclagem.
Chave de partição como toMinute(event_time) (granularidade extrema): Explosão de partições, afetando gravemente o desempenho.
Chave primária como campo de alta cardinalidade com ordem ilógica: Por exemplo, ORDER BY (user_id, event_time), mas as consultas são geralmente por event_time, resultando em baixa utilização do índice de chave primária.
Chave primária com muitos campos: Por exemplo, ORDER BY (a, b, c, d, e, f, g, h, i, j), resultando em tamanho grande do índice de chave primária e alto consumo de memória.
Chave primária como campo de baixa cardinalidade: Por exemplo, ORDER BY (status), com apenas alguns valores de status, resultando em capacidade de eliminação do índice de chave primária extremamente baixa.
Chave de partição e chave primária totalmente não relacionadas, e nenhuma delas abrange condições comuns de consulta: Por exemplo, a chave de partição é region, a chave primária é type, mas as consultas são geralmente por event_time, resultando em nenhuma aceleração de consultas nem por partição nem por chave primária.