A versão mais recente do ARMS Prometheus é a Helm v1.1.17, correspondente ao agent v4.0.0. Esta versão traz diversas melhorias para aumentar a estabilidade da coleta, corrigir bugs conhecidos e otimizar o consumo de recursos.
Se o seu cluster executa um agent do ARMS Prometheus da série v3.x.x, recomendamos fortemente a atualização para a versão mais recente. Versões anteriores podem conter componentes não otimizados e apresentar risco de desconexão de dados.
Novidades da v4.0.0
|
Tipo de alteração |
Descrição |
|
Novo |
Job de coleta adicionado para eventos de cluster, com suporte ao painel de Kubernetes Deployment. |
|
Novo |
Métricas de automonitoramento baseadas em Service Level Agreements (SLAs) incluídas para alimentar o painel de estabilidade de SLA. |
|
Novo |
Suporte a autenticação BasicAuth no ServiceMonitor. O Secret deve estar no mesmo namespace do ServiceMonitor. |
|
Novo |
Recurso de metadados de métricas disponível para exibir o significado de métricas específicas. |
|
Novo |
O agent agora transmite sua versão de chart ao servidor, que utiliza o número da versão para inicializar ou atualizar painéis. |
|
Novo |
Métricas de automonitoramento do RemoteWrite adicionadas para rastrear a duração de envio de cada lote de dados. |
|
Novo |
Métricas de automonitoramento para erros e latência na coleta de métricas básicas adicionadas. |
|
Novo |
Métricas de automonitoramento para erros e latência na coleta de métricas de negócio adicionadas. |
|
Melhoria |
Ajuste no |
|
Melhoria |
Aprimoramento no método de service discovery para jobs de coleta CSI, focado principalmente na coleta de PersistentVolume (PV). |
|
Melhoria |
Otimização na frequência de execução de |
|
Melhoria |
Simplificação de algumas entradas de log e enriquecimento de outras para fornecer informações de tempo mais detalhadas sobre o pipeline de scraping. |
|
Melhoria |
Jobs de coleta de métricas básicas agora usam intervalo e timeout de scraping fixos, desacoplados da configuração global para reduzir interferências. |
|
Melhoria |
Lógica de interação otimizada no modo multi-replica master-slave. Réplicas master e worker deixam de interferir umas nas outras, aumentando a estabilidade geral. |
|
Melhoria |
Estratégia de distribuição de targets pela réplica master aprimorada, reduzindo o consumo de CPU em aproximadamente 30% e o de memória em 40%, melhorando o desempenho da coleta. |
|
Melhoria |
Processamento de |
|
Melhoria |
Lógica do listener Informer otimizada para cenários multitenant, reduzindo o consumo de CPU em cerca de 20%. |
|
Melhoria |
Tratamento aprimorado para falhas intermitentes de resolução do CoreDNS. O agent agora recorre a um endereço IP em cache, diminuindo a dependência de resolução DNS em tempo real e aumentando a estabilidade na transmissão de dados. |
|
Melhoria |
Lógica de distribuição de configurações de scraping via |
|
Melhoria |
Estratégia de pré-scraping na réplica master otimizada para reduzir o consumo de recursos e melhorar as capacidades de service discovery e agendamento de targets. |
|
Melhoria |
Tratamento adaptativo para lotes de dados individuais que excedem 1 MB, reduzindo a perda de dados causada por limitações do backend. |
|
Correção |
Problema resolvido no |
|
Correção |
Problema corrigido em cenários multitenant onde atualizações atrasadas no cache de rótulos de Pod dividiam uma única série temporal em duas. |
|
Correção |
Falha ocasional solucionada na distribuição de targets pela réplica master para uma réplica reiniciada ou com erro de Out-Of-Memory (OOM), que resultava em targets de scraping perdidos. |
|
Correção |
Problemas corrigidos na análise de tipo de Secret e na transmissão de cabeçalhos no RemoteWrite. |
|
Correção |
Problema resolvido em que a ação de desativação de |
|
Correção |
Aplicação incorreta corrigida de parâmetros padrão globais e |
Riscos da atualização
Risco da atualização: A atualização para Helm v1.1.17/agent v4.0.0 é disruptiva. Dependendo da carga de coleta de métricas do seu cluster (quantidade de targets e séries temporais), pode ocorrer uma breve interrupção nos dados. A indisponibilidade deve durar entre 0 e 5 minutos, mas esse tempo varia entre clusters.
Antes da atualização: Execute as verificações prévias descritas em Step 1: Pre-upgrade checks (Required) para minimizar impactos nos dados de monitoramento do cluster.
Após a atualização: Caso identifique problemas nos dados, siga os passos em Step 3: Post-upgrade checks (Optional). Se o problema persistir, consulte Post-upgrade FAQ. Para suporte adicional, entre em contato com nossos especialistas técnicos pelo DingTalk (ID: aliprometheus).
Procedimento de atualização
Etapa 1: Verificações pré-atualização (obrigatório)
Ao atualizar de uma versão do Helm anterior à 1.1.16 para a versão 1.1.17, a atualização não preserva suas configurações personalizadas de parâmetros. Verifique todas as configurações customizadas antes de prosseguir. Para manter essas configurações, reaplique-as manualmente após a conclusão da atualização.
Atualizações a partir da versão 1.1.16 do Helm herdam automaticamente os parâmetros personalizados, eliminando a necessidade de reaplicação em atualizações subsequentes. Siga estes passos para verificar seus parâmetros antes da atualização:
Faça login no console do Container Service for Kubernetes (ACK).
Clique em no nome do cluster desejado. No painel de navegação à esquerda, escolha Workload > Stateless. Selecione o namespace
arms-prom. Localize o workloadarms-prometheus-ack-arms-prometheuse, na coluna Operation, escolha More > View YAML para visualizar a configuração YAML completa.-
Verifique os parâmetros abaixo e anote quaisquer valores personalizados que deseje manter:
spec.replicas: O valor padrão após a atualização é 1. Se o valor atual for diferente, anote-o.-
spec.containers.args: Parâmetros de inicialização do agent para modo multitenant. Se o modo multitenant não estiver ativado, este campo pode não existir. Caso tenha personalizado esses parâmetros, registre seus valores:tenant_useridtenant_clusteridtenant_token
-
spec.containers.resources: Os limites padrão são 3 Cores e 4 GiB de memória. As solicitações padrão são 1 Core e 1 GiB de memória.Se suas configurações forem diferentes, anote os valores para reaplicá-los após a atualização.
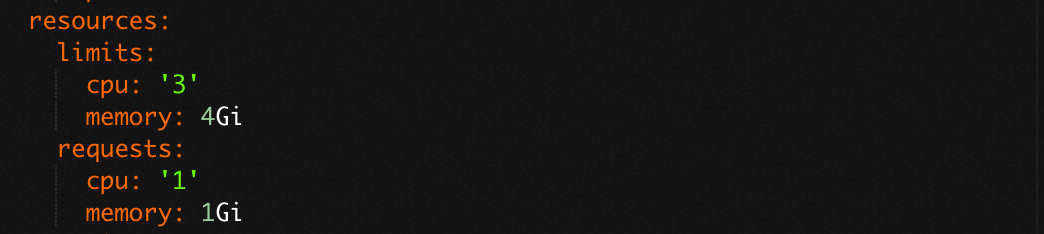
Após a atualização, utilize o mesmo método para visualizar a configuração YAML, edite o arquivo para reaplicar seus valores personalizados e clique em Update para salvar as alterações.

Etapa 2: Procedimento de atualização
Recomendamos atualizar a versão do Helm do componente ARMS Prometheus pelo console do ACK. Siga estes passos:
Faça login no console do Container Service for Kubernetes (ACK).
Clique em no nome do cluster desejado. No painel de navegação à esquerda, escolha Operations > Component Management. Clique em na aba Logs and Monitoring, localize o cartão ack-arms-prometheus e clique em Upgrade.
-
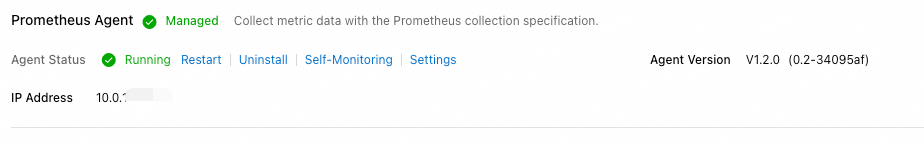
Após a conclusão da atualização, escolha Operations > Managed Service for Prometheus no painel de navegação à esquerda. No canto superior direito, clique em Go to ARMS Prometheus. Você será redirecionado para a página de lista de instâncias do Prometheus no console do Managed Service for Prometheus, onde poderá visualizar o status do agent e detalhes da coleta de métricas.
Para verificar a atualização, clique em Settings no painel de navegação à esquerda e confira a versão do componente na aba Settings.
Etapa 3: Verificações pós-atualização (opcional)
Faça login no console do ARMS.
No painel de navegação à esquerda, escolha .
Faça login no console do Cloud Monitor.
No painel de navegação à esquerda, escolha para abrir a lista de instâncias do Managed Service for Prometheus.
Clique em no nome da instância do Prometheus desejada. No painel de navegação à esquerda, clique em Service Discovery. Clique em na aba Targets para revisar o status dos seus jobs de coleta.
No painel de navegação à esquerda, clique em Settings. Na aba Self-Monitoring, clique em View Grafana Dashboard no canto superior direito. Após a atualização, monitore o status operacional do agent. Certifique-se de que o número de réplicas está correto e que não há anomalias nas taxas de envio de dados, no consumo de recursos ou na contagem de erros.
-
Na página Self-Monitoring, clique em na aba Agent Self-monitoring para visualizar o painel de automonitoramento do agent do Prometheus.
Após a atualização, verifique os quatro jobs básicos de coleta de métricas:
_arms/kubelet/cadvisor,_arms/kubelet/metric,_kube-state-metricsenode-exporter. Utilize o seletor de intervalo de tempo no canto superior direito para comparar dados antes e depois da atualização e verificar possíveis problemas de coleta.
Perguntas frequentes pós-atualização
Incompatibilidade na contagem de réplicas após a atualização
Verifique se alguma réplica do agent está no estado Pending. O agent do ARMS Prometheus exige que todas as réplicas estejam no estado Running para funcionar corretamente. Visualize o status de todas as réplicas na página Workload > Stateless do cluster desejado no console do ACK, sob o namespace arms-prom.
Alto consumo de recursos após a atualização
Verifique a existência de erros na transmissão de dados. Tais erros podem causar acúmulo de dados na memória do agent, levando ao aumento do consumo de recursos. Visualize o uso de memória e CPU do agent do Prometheus no console do ACK. Acesse a página Operations > Managed Service for Prometheus do cluster desejado, clique em na aba Others e localize a seção Prometheus Agent para visualizar o uso de recursos.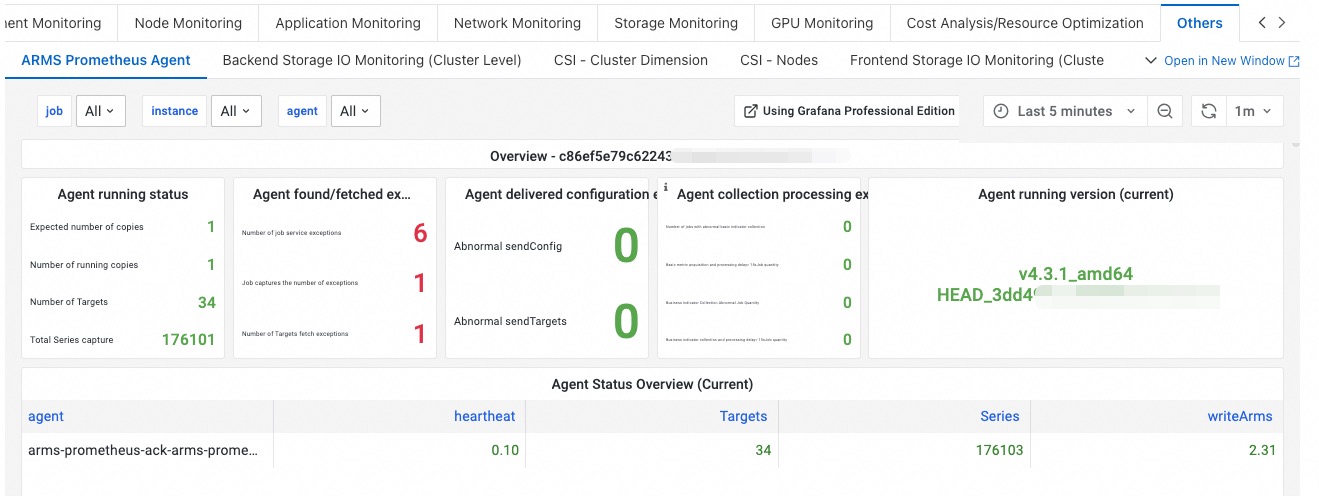
Métricas básicas ausentes ou descontínuas
Caso note problemas com métricas básicas como node_*** (ícone ①), container_*** (ícone ②), kubelet_*** (ícone ③) ou kube_*** (ícone ④), verifique se os jobs de coleta correspondentes estão reportando erros. Consulte o status desses jobs na aba Service Discovery > Targets no console do Managed Service for Prometheus. Se encontrar erros, entre em contato com nossos especialistas técnicos pelo DingTalk (ID: aliprometheus) para obter assistência.
Queda de tráfego ou perda de dados no RemoteWrite
Se você não configurou o RemoteWrite, ignore esta questão.
Se o RemoteWrite estiver configurado, observe que na v4.0.0 do agent a configuração
write_relabel_configsagora vem habilitada por padrão, diferentemente das versões anteriores. Se sua configuração incluir ações comodropoukeep, você poderá observar uma queda no tráfego. Ajuste essa configuração conforme necessário. Para isso, acesse a página Settings no console do Managed Service for Prometheus. Na aba Settings, clique em Edit Prometheus.yaml e modifique a configuração.