Após instalar um probe na sua aplicação, o ARMS inicia o monitoramento. Na página Application Overview, é possível visualizar métricas essenciais, como contagem de requisições, contagem de erros, latência e quantidade de instâncias.
Pré-requisitos
O ARMS Application Monitoring oferece uma nova página de detalhes de monitoramento para usuários que ativaram o novo modelo de faturamento. Para obter detalhes sobre esse modelo, consulte {{XREF_0}}.
Caso ainda não tenha ativado o novo modelo de faturamento, mas deseje acessar a nova página de detalhes de monitoramento, clique em Switch to New Version na página Application List.
Um probe já deve estar instalado na sua aplicação. Para instruções, consulte {{XREF_1}}.
Visualizar a Visão Geral da Aplicação
Faça login no ARMS console. No painel de navegação à esquerda, escolha .
-
Na página Application List, selecione a região na barra de navegação superior e clique no nome da aplicação.
NotaOs ícones na coluna Language têm os seguintes significados:
 : aplicação Java conectada ao Application Monitoring.
 : aplicação Golang conectada ao Application Monitoring.
 : aplicação Python conectada ao Application Monitoring.
-: aplicação conectada ao Managed Service for OpenTelemetry.
Na barra de navegação superior, clique em Application Overview.
Descrição do Painel
A página Application Overview adapta automaticamente seu painel conforme a integração da sua aplicação. A exibição das métricas de CPU difere entre ambientes ECS e de contêiner.
Em cenários com contêineres, se você integrou o Managed Service for Prometheus, o painel prioriza os dados do Managed Service for Prometheus para exibir as métricas. Para instruções sobre como integrar contêineres ao Managed Service for Prometheus, consulte {{XREF_2}}.
Caso seu ambiente de contêiner não tenha integração com o Managed Service for Prometheus, verifique se a versão do probe do Application Monitoring é 4.1.0 ou posterior. Essa versão exibe métricas básicas de contêiner. Para mais detalhes sobre o probe, consulte {{XREF_3}}.
Ambiente ECS
|
Painel |
Estilo |
Descrição |
|
Request Count |
Ticker board |
Número total de requisições da aplicação durante o período especificado. Variação diária: Alteração percentual na contagem de requisições em comparação ao mesmo período do dia anterior. |
|
Error Count |
Ticker board |
Quantidade total de erros da aplicação no período definido. Variação diária: Diferença percentual na contagem de erros comparada ao mesmo intervalo do dia anterior. |
|
Average Latency |
Ticker board |
Latência média da aplicação durante o período selecionado. Variação diária: Mudança percentual na latência média em relação ao mesmo período do dia anterior. |
|
Instance Count |
Ticker board |
Total de instâncias da aplicação no período especificado. Variação diária: Percentual de mudança na quantidade de instâncias comparado ao mesmo horário do dia anterior. |
|
Request Count |
Gráfico de colunas |
Tendência da contagem de requisições ao longo do período, empilhada por tipo de chamada. |
|
Error Count |
Gráfico de colunas / linhas |
Contagem de erros: Evolução dos erros no período, exibida em gráfico de colunas com valores no eixo Y esquerdo. Taxa de erros: Tendência da taxa de erros no intervalo selecionado, mostrada com valores no eixo Y direito. |
|
Elapsed Time |
Gráfico de linhas |
Comportamento da latência durante o período, apresentando valores médios, P99, P90 e P75. |
|
Peak CPU Utilization |
Gráfico de favos de mel |
Pico de utilização de CPU do host que executa a aplicação no período analisado. Os seguintes status estão disponíveis:
|
|
Top Services by Request Count |
TOP 5 |
As cinco interfaces de serviço com maior volume total de requisições no período. Tipos de chamada suportados incluem:
|
|
Top Services by Error Count |
TOP 5 |
Cinco interfaces de serviço com mais erros acumulados no intervalo de tempo. Os tipos de chamada compatíveis são:
|
|
Top Services by Average Latency |
TOP 5 |
Principais cinco interfaces de serviço por latência média no período escolhido. Tipos de chamada aceitos incluem:
|
|
Top Instances by Peak CPU Utilization |
TOP 5 |
Hosts com maior utilização de CPU durante o intervalo de tempo definido. |
Ambiente de Contêiner (Edição Prometheus)
|
Painel |
Estilo |
Descrição |
|
Request Count |
ticker board |
Volume total de requisições da aplicação no período informado. Variação diária: Diferença percentual no número de requisições em relação ao mesmo período do dia anterior. |
|
Error Count |
ticker board |
Soma total de erros da aplicação durante o intervalo especificado. Variação diária: Comparação percentual da contagem de erros com o mesmo horário do dia prévio. |
|
Average Latency |
Ticker board |
Média de latência da aplicação no período determinado. Variação diária: Alteração percentual na latência média frente ao mesmo período do dia anterior. |
|
Instance Count |
Ticker board |
Quantidade total de instâncias da aplicação no intervalo de tempo. Variação diária: Percentual de mudança na contagem de instâncias comparado ao mesmo momento do dia anterior. |
|
Request Count |
Gráfico de colunas |
Evolução das requisições ao longo do tempo, segmentada por tipo de chamada. |
|
Error Count |
Gráfico de colunas / linhas |
Contagem de erros: Histórico de erros no período, apresentado em colunas no eixo Y esquerdo. Taxa de erros: Comportamento da taxa de erros no intervalo, plotado no eixo Y direito. |
|
Elapsed Time |
Gráfico de linhas |
Tendência de latência no período, incluindo médias e percentis P99, P90 e P75. |
|
CPU Usage |
Gráfico de favos de mel |
Uso de CPU do contêiner durante o período. Em cenários multicluster, apenas o cluster que reportou primeiro é exibido. |
|
Top Services by Request Count |
TOP 5 |
Lista das cinco interfaces com maior tráfego de requisições no intervalo. Protocolos de chamada suportados:
|
|
Top Services by Error Count |
TOP 5 |
Ranking das cinco interfaces com maior incidência de erros no período. Tipos de chamada incluídos:
|
|
Top Services by Average Latency |
TOP 5 |
Cinco interfaces de serviço com maiores tempos médios de resposta no período. Chamadas suportadas nesta visualização:
|
|
CPU Usage Ranking |
TOP 5 |
Contêineres com maior consumo de CPU no intervalo. Em ambientes multicluster, mostra-se apenas o cluster de reporte mais antigo. |
Ambiente de Contêiner (Edição de Coleta Própria do ARMS)
|
Painel |
Estilo |
Descrição |
|
Request Count |
Ticker board |
Total acumulado de requisições da aplicação no período. Variação diária: Diferença percentual em relação ao mesmo período do dia anterior. |
|
Error Count |
Ticker board |
Somatório de erros registrados pela aplicação no intervalo de tempo. Variação diária: Comparativo percentual de erros com o mesmo horário do dia prévio. |
|
Average Latency |
Ticker board |
Valor médio de latência da aplicação durante o período. Variação diária: Mudança percentual na latência média comparada ao dia anterior. |
|
Instance Count |
ticker board |
Número total de instâncias ativas da aplicação no intervalo. Variação diária: Percentual de alteração na quantidade de instâncias frente ao mesmo período anterior. |
|
Request Count |
Gráfico de colunas |
Histórico de requisições no período, agrupado por tipo de chamada. |
|
Error Count |
Gráfico de colunas / linhas |
Contagem de erros: Volume de erros ao longo do tempo, representado em colunas no eixo Y esquerdo. Taxa de erros: Evolução da taxa de falhas no período, indicada no eixo Y direito. |
|
Elapsed Time |
Gráfico de linhas |
Análise temporal da latência, destacando média e percentis P99, P90 e P75. |
|
CPU Usage |
Gráfico de favos de mel |
Consumo de CPU do contêiner durante o intervalo especificado. |
|
Top Services by Request Count |
TOP 5 |
Interfaces de serviço com maior número absoluto de requisições no período. Esta lista abrange os seguintes tipos de chamada:
|
|
Top Services by Error Count |
TOP 5 |
Maiores geradores de erros entre as interfaces de serviço no intervalo. Compatível com estes protocolos de chamada:
|
|
Top Services by Average Latency |
TOP 5 |
Serviços com as maiores latências médias registradas no período. Abrange os seguintes tipos de comunicação:
|
|
Top Containers by CPU Usage |
TOP 5 |
Contêineres que apresentaram maior uso de processador no intervalo de tempo. |
Recursos do Painel
Pontos de Ação
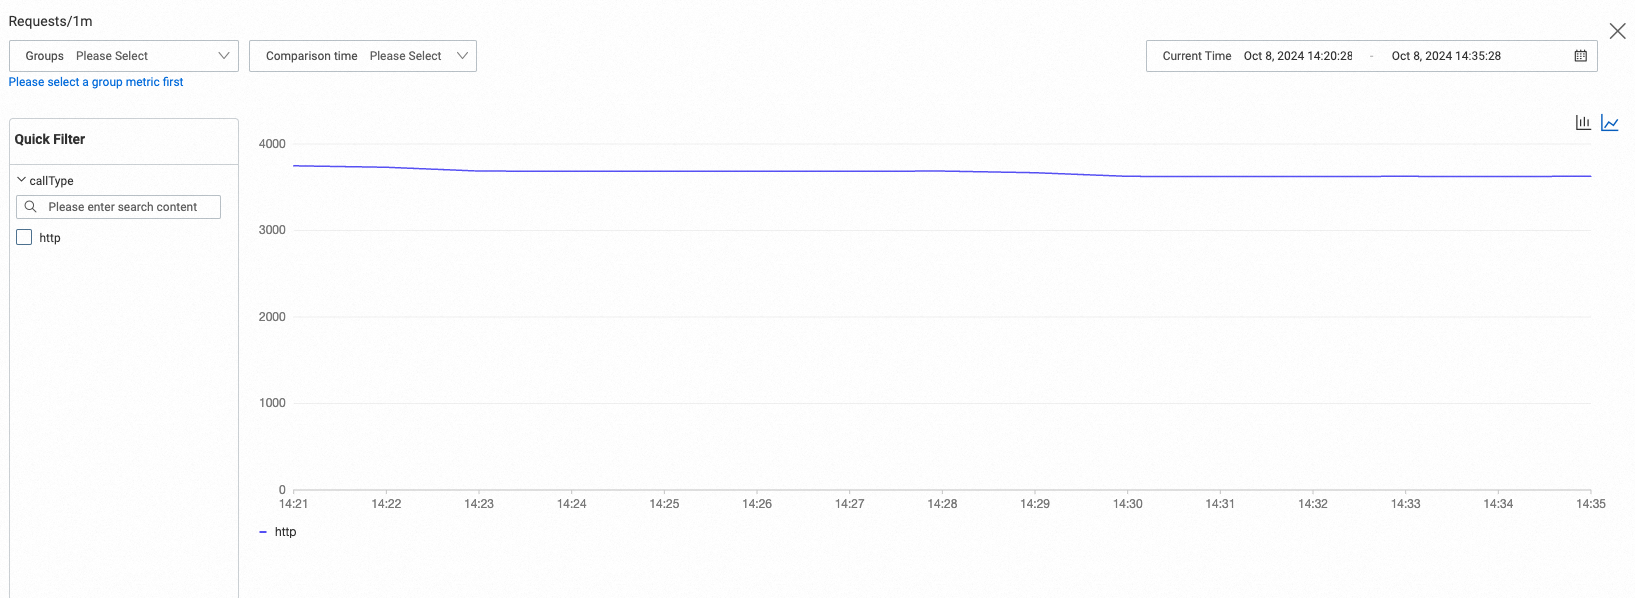
Clique no ícone  em um painel de tendência para visualizar comparações agrupadas e históricas.
-
As opções de agrupamento incluem campos básicos e tags de instância:
Campos básicos incluem _traffic_mse_gray (grayscale). Tags padrão de instância abrangem app, workloadKind, app_kubernetes_io_managed_by, armsBPFCreateAppName, entre outros.
Campos básicos: Rótulos comuns a todas as métricas. Atualmente, serverIp está exposto para comparações agrupadas.
Tags de instância: Além das tags padrão, adicione tags personalizadas para habilitar mais capacidades de comparação agrupada. Para instruções, consulte {{XREF_4}}.
Tempo de comparação: Selecione um intervalo de comparação para analisar dados em relação ao período atual.
Consultas
Clique no ícone  em um painel para visualizar o PromQL correspondente. Utilize essa consulta diretamente no Prometheus ou Grafana para configurações personalizadas.
Por exemplo, a expressão de consulta para o painel Request Count / 1m é sum by (callType,)(sum_over_time(arms_app_requests_count_...[1m])), que agrega contagens de requisições por minuto pela dimensão callType. Clique no ícone de cópia ao lado da caixa de entrada de consulta para obter o PromQL completo.
Execute consultas PromQL para visualizar métricas relacionadas na página Metric Explorer no console do Managed Service for Prometheus. Para instruções, consulte {{XREF_5}}.
Ao configurar painéis no Grafana, utilize diretamente o PromQL correspondente aos painéis. Para instruções sobre integração de fontes de dados, consulte {{XREF_6}}.
Perguntas Frequentes
Ausência de Dados de Latência P99
Métricas de quantil vêm desativadas por padrão. Para visualizar esses dados, ative as estatísticas de quantil na página Custom Configuration. Para instruções, consulte {{XREF_7}}.
Volume Total de Requisições na Página Application Overview do Console Legado Não Corresponde à Soma dos Últimos Cinco Minutos
O ARMS exibe dados por um minuto a mais do que o intervalo selecionado. Por exemplo, "últimos 5 minutos" mostra, na verdade, 6 minutos de dados, e "últimos 30 minutos" apresenta 31 minutos.
Contagem de SQL Lento na Página Application Overview do Console Legado Difere dos Resultados da API POP
Consultas via API POP incluem requisições lentas de bancos de dados, bancos NoSQL e caches, enquanto o console considera apenas requisições lentas relacionadas a bancos de dados. Isso causa discrepâncias.
Para alinhar os resultados da consulta POP com os dados do console, adicione uma condição de filtro rpcType à sua consulta.
Exemplo:
QueryMetricByPageRequest.Filters filters2 = QueryMetricByPageRequest
.Filters
.builder()
.key("rpcType")
.value("60|62|63|65|66|67|68|69|58|59")
.build();
Contagem de Instâncias Excede as Instâncias em Execução Real
Se o intervalo de tempo da consulta for muito longo, instâncias destruídas também entram na contagem total.
Divergência na Contagem Total de Requisições Entre as Páginas Application Overview dos Consoles Novo e Legado
A página Application Overview no novo console exibe dados sob a perspectiva do fornecedor de serviço e inclui tarefas agendadas. Já a página Application Overview no console legado não contabiliza dados de tarefas agendadas.