Após a instalação do agente Python para a sua aplicação de Large Language Model (LLM), o Application Real-Time Monitoring Service (ARMS) inicia o monitoramento. Na página Overview, é possível visualizar as principais métricas da sua aplicação LLM, como o número de chamadas ao modelo, o uso de tokens, a contagem de traces e a contagem de sessões.
Pré-requisitos
O agente deve estar instalado para a sua aplicação LLM. Para mais informações, consulte Connect an LLM application or inference service to ARMS.
Visão geral da aplicação LLM
Acesse o console do ARMS. No painel de navegação à esquerda, escolha .
Na página Application list, selecione uma região na parte superior da página e clique no nome da aplicação de destino.
Na barra de navegação superior, clique em Overview.
Painel
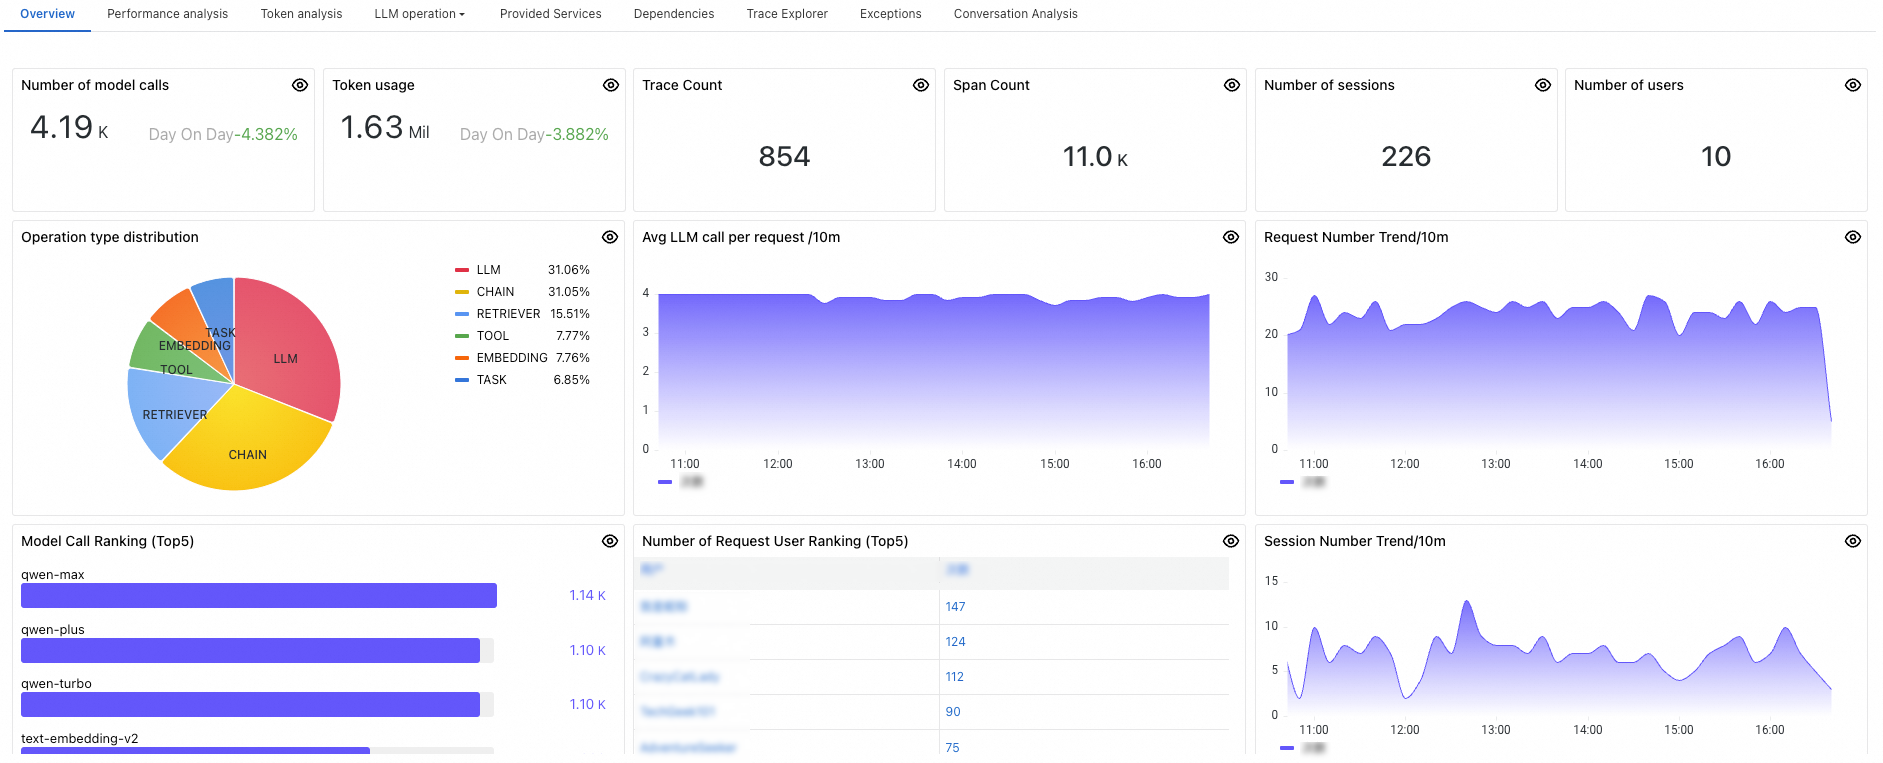
Painel | Descrição |
Número de chamadas ao modelo | Número de vezes que a aplicação chama o LLM no intervalo de tempo selecionado. |
Uso de tokens | Número de tokens consumidos pela aplicação no intervalo de tempo selecionado. |
Contagem de traces | Número de traces gerados pela aplicação no intervalo de tempo selecionado. |
Contagem de spans | Número de spans gerados pela aplicação no intervalo de tempo selecionado. |
Contagem de sessões | Número de sessões iniciadas pela aplicação no intervalo de tempo selecionado. |
Número de usuários | Número total de usuários únicos que interagem com a aplicação no intervalo de tempo selecionado. |
Distribuição por tipo de operação |
|
Média de chamadas ao LLM por requisição | Número médio de chamadas ao LLM por requisição, calculado em intervalos de um minuto. |
Tendência de contagem de requisições | Acompanha o número de requisições à aplicação LLM por minuto. |
Classificação de chamadas ao modelo | Lista os 5 LLMs chamados com mais frequência na aplicação. |
Classificação de usuários por contagem de requisições | Lista os 5 usuários que mais fizeram requisições na aplicação. |
Tendência de contagem de sessões | Acompanha o número de sessões da aplicação LLM por minuto. |