O Application Real-Time Monitoring Service (ARMS) utiliza métricas de quantil, como P50, P75, P90 e P99, para representar as distribuições de latência na sua aplicação. Este tópico aborda como o agente do ARMS computa esses quantis, os compromissos de precisão da abordagem de histograma e quando utilizar quantis baseados em agente em vez dos quantis do Trace Explorer.
Métricas de quantil no monitoramento
A latência média oculta outliers. Se 99% das requisições forem concluídas em 10 ms, mas 1% levar 5.000 ms, a média parecerá saudável, enquanto uma parcela significativa dos usuários enfrentará baixo desempenho.
Os quantis (também chamados de percentis) resolvem esse problema ao mostrar a latência em pontos específicos da distribuição:
|
Quantil |
Significado |
|
P50 |
A mediana. Metade de todas as requisições é mais rápida e a outra metade é mais lenta. |
|
P75 |
75% das requisições são concluídas com esta latência ou menos. |
|
P90 |
90% das requisições são concluídas com esta latência ou menos. |
|
P99 |
99% das requisições são concluídas com esta latência ou menos. Apenas 1% é mais lento. |
P90 e P99 são especialmente úteis para entender a latência de cauda — a experiência dos usuários mais lentos.
Exemplo
Considere 14 pontos de dados: [2, 3, 6, 7, 8, 9, 10, 12, 14, 15, 16, 17, 18, 20]
Os valores exatos dos quantis são:
P50: 10
P75: 16
P90: 18
P99: 20
Ative estatísticas de quantil
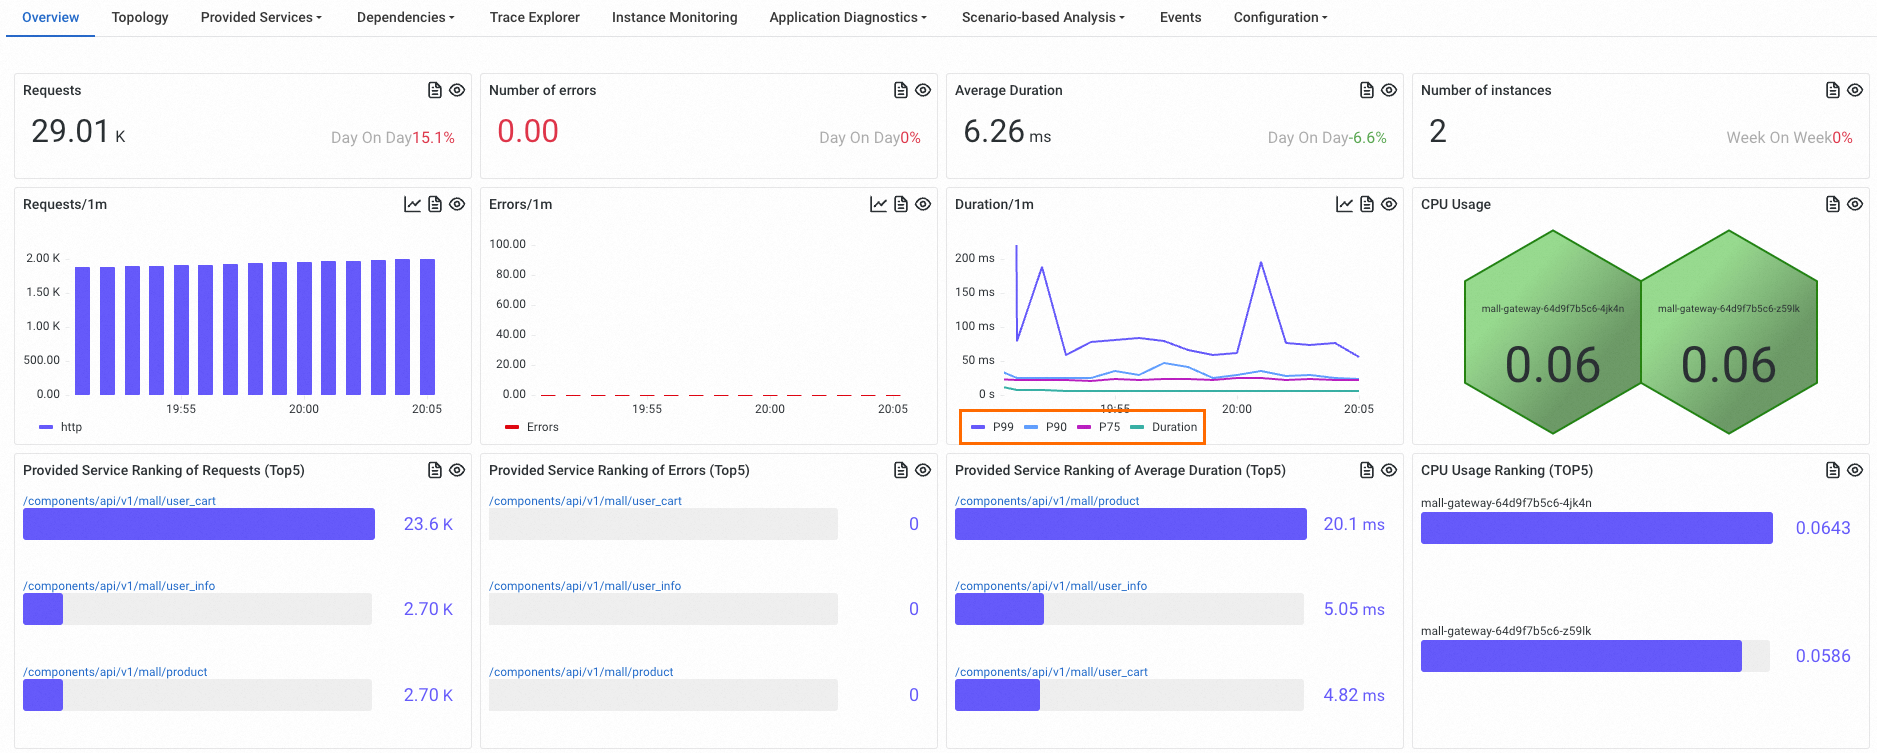
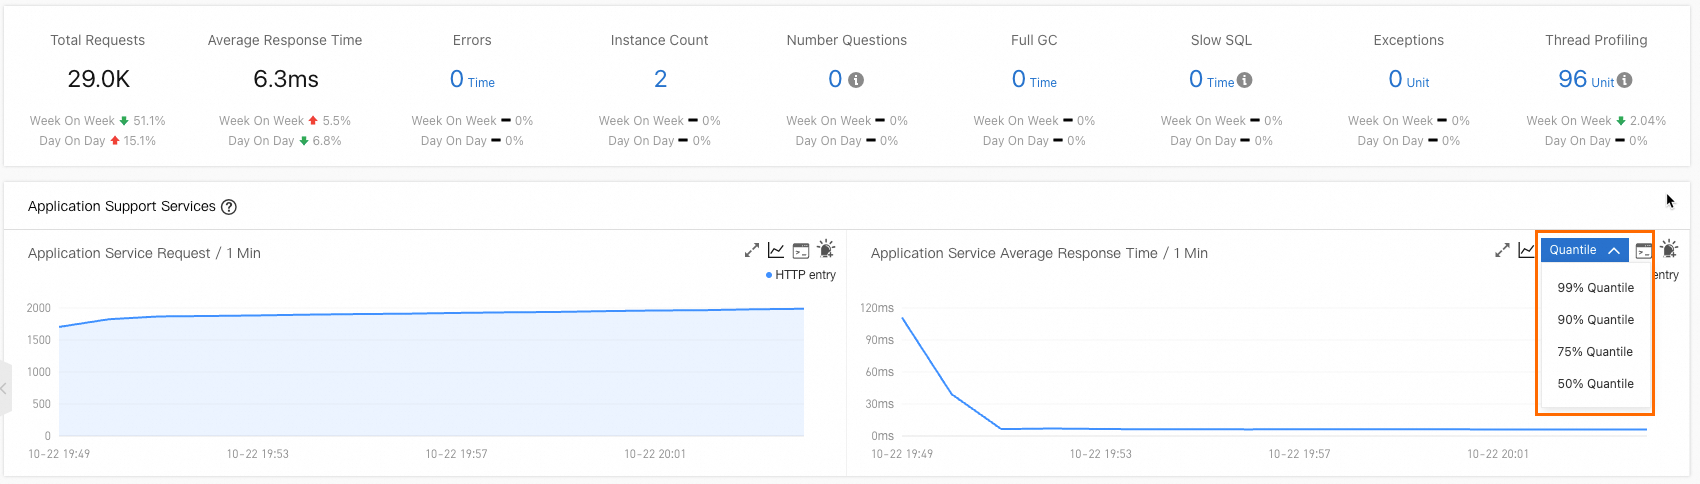
Para coletar métricas de quantil, ative Quantile Statistics no console do ARMS.
New console
Para obter detalhes, consulte Personalizar configurações para uma aplicação Java.
Old console
Para obter detalhes, consulte Personalizar configurações da aplicação.
Como o agente do ARMS calcula quantis
O agente do ARMS (v4.x e posterior) calcula quantis de latência usando um histograma de limites fixos com interpolação linear. Em vez de armazenar cada valor individual de latência, o agente conta quantas requisições se enquadram em cada bucket predefinido.
Limites dos buckets
Os limites padrão dos buckets são (em milissegundos):
[0.0, 5.0, 10.0, 25.0, 50.0, 75.0, 100.0, 250.0, 500.0, 750.0, 1000.0, 2500.0, 5000.0, 7500.0, 10000.0]Esses limites criam 16 buckets:
|
Bucket |
Intervalo (ms) |
|
0 |
(-Infinity, 0.0] |
|
1 |
(0.0, 5.0] |
|
2 |
(5.0, 10.0] |
|
3 |
(10.0, 25.0] |
|
4 |
(25.0, 50.0] |
|
5 |
(50.0, 75.0] |
|
6 |
(75.0, 100.0] |
|
7 |
(100.0, 250.0] |
|
8 |
(250.0, 500.0] |
|
9 |
(500.0, 750.0] |
|
10 |
(750.0, 1000.0] |
|
11 |
(1000.0, 2500.0] |
|
12 |
(2500.0, 5000.0] |
|
13 |
(5000.0, 7500.0] |
|
14 |
(7500.0, 10000.0] |
|
15 |
(10000.0, +Infinity] |
Etapas de cálculo
O cálculo possui duas fases: contagem por bucket e interpolação linear.
Fase 1: Contar requisições por bucket
A latência de cada requisição recebida incrementa o contador do bucket correspondente. Usando os dados de exemplo [2, 3, 6, 7, 8, 9, 10, 12, 14, 15, 16, 17, 18, 20]:
|
Bucket |
Intervalo (ms) |
Contagem |
Valores |
|
0 |
(-Infinity, 0.0] |
0 |
-- |
|
1 |
(0.0, 5.0] |
2 |
2, 3 |
|
2 |
(5.0, 10.0] |
5 |
6, 7, 8, 9, 10 |
|
3 |
(10.0, 25.0] |
7 |
12, 14, 15, 16, 17, 18, 20 |
|
4-15 |
(25.0, +Infinity] |
0 |
-- |
Fase 2: Interpolação linear
Para calcular um quantil específico, o ARMS localiza o bucket alvo e realiza a interpolação dentro dele.
Exemplo passo a passo do P75:
Encontre a posição alvo. Total de pontos de dados = 14. A posição P75 é 14 x 0,75 = 10,5. O ARMS arredonda esse valor para cima: a contagem cumulativa alvo é 11.
-
Identifique o bucket alvo. Acumule as contagens da esquerda para a direita até que a soma atinja 11:
Bucket 0: cumulativo = 0
Bucket 1: cumulativo = 2
Bucket 2: cumulativo = 7
Bucket 3: cumulativo = 14 (primeiro a atingir 11) — este é o bucket alvo.
Interpole dentro do bucket. Os buckets 0-2 já contabilizam 7 pontos de dados. O ARMS precisa de mais 4 pontos (11 - 7 = 4) do Bucket 3, que contém 7 pontos no total. O Bucket 3 abrange (10.0, 25.0]: P75 = 10.0 + (25.0 - 10.0) x 4 / 7 = 18.6
O P75 exato dos dados brutos é 16, mas a estimativa baseada em histograma é 18,6. Essa diferença ocorre porque a interpolação linear pressupõe que os dados estejam uniformemente distribuídos dentro de um bucket, o que raramente acontece. Quanto maior a largura do bucket, maior o erro potencial.
Compromissos de precisão
A abordagem de histograma de limites fixos é altamente eficiente, mas introduz erros de estimativa em determinados cenários.
Pontos fortes
Baixa sobrecarga. Apenas os contadores dos buckets são armazenados — não há necessidade de manter cada valor individual de latência na memória.
Limitações
Em cenários com latências extremamente baixas, latências extremamente altas ou muito poucas amostras, os quantis calculados podem ser imprecisos. A precisão depende de quão bem os limites dos buckets correspondem à sua distribuição real de latência:
|
Cenário |
Impacto |
Motivo |
|
Latências concentradas em um bucket amplo |
Erro maior |
A interpolação linear assume distribuição uniforme dentro do bucket, mas os dados reais podem ser assimétricos. |
|
Latências muito baixas (submilissegundo) |
Erro maior |
Todos os valores abaixo de 5 ms caem em um único bucket de 5 ms de largura, reduzindo a precisão. |
|
Latências muito altas (acima de 10.000 ms) |
Erro maior |
Todos os valores acima de 10.000 ms caem no Bucket 15, que é aberto, tornando a interpolação menos confiável. |
|
Poucas amostras |
Erro maior |
Com dados esparsos, o bucket onde um valor se enquadra tem um impacto desproporcional no resultado. |
|
Latências distribuídas em buckets estreitos |
Erro menor |
Os buckets de 5 ms e 10 ms de largura na extremidade inferior fornecem granularidade mais fina. |
Como o Trace Explorer calcula quantis
O Trace Explorer calcula quantis com base nas latências de todos os spans que satisfazem as condições de filtragem da página e nas funções SQL do Simple Log Service. Para mais informações, consulte a função approx_percentile em Visão geral das funções.