Use o Data Transmission Service (DTS) para replicar continuamente dados de um banco de dados MySQL hospedado em uma instância ECS para uma instância do AnalyticDB for PostgreSQL. O DTS gerencia a carga inicial completa e a sincronização incremental contínua, mantendo os dados analíticos atualizados sem intervenção manual.
Pré-requisitos
Antes de começar, verifique se você tem:
Um banco de dados MySQL (versão 5.1, 5.5, 5.6, 5.7 ou 8.0) em execução em uma instância ECS
Logs binários habilitados no banco de dados MySQL de source e uma conta de banco de dados criada para a tarefa de sincronização. Para obter instruções de configuração, consulte Criar uma conta para um banco de dados MySQL auto-gerenciado e configurar logs binários. A conta do banco de dados requer as seguintes permissões: SELECT (nos objetos a serem sincronizados), REPLICATION CLIENT, REPLICATION SLAVE e SHOW VIEW.
Chaves primárias definidas em todas as tabelas que você planeja sincronizar
Uma instância do AnalyticDB for PostgreSQL. Para obter instruções de configuração, consulte Crie uma instância do AnalyticDB for PostgreSQL
Limitações
Objetos suportados: Apenas tabelas. Não é possível sincronizar bancos de dados ou schemas diretamente.
Operações SQL suportadas:
DML: INSERT, UPDATE, DELETE
DDL: Apenas ADD COLUMN. CREATE TABLE não é suportado. Para sincronizar uma nova tabela adicionada após o início da tarefa, adicione-a manualmente aos objetos selecionados. Consulte Adicionar um objeto a uma tarefa de sincronização de dados.
Tipos de dados não suportados: BIT, VARBIT, GEOMETRY, ARRAY, UUID, TSQUERY, TSVECTOR, TXID_SNAPSHOT, POINT. O DTS não sincroniza colunas com esses tipos de dados.
Índices de prefixo: Índices de prefixo não são sincronizados. Se suas tabelas de source usarem índices de prefixo, a sincronização dos dados poderá falhar.
Ferramentas de DDL online: Não use gh-ost ou pt-online-schema-change durante uma tarefa de sincronização ativa. Caso contrário, a sincronização de dados pode falhar.
Topologias de sincronização suportadas
Sincronização unidirecional um para um
Sincronização unidirecional um para muitos
Sincronização unidirecional muitos para um
Mapeamento de termos
O MySQL e o AnalyticDB for PostgreSQL usam terminologias diferentes para os mesmos conceitos:
|
MySQL |
AnalyticDB for PostgreSQL |
|
Database |
Schema |
|
Table |
Table |
Configure uma tarefa de sincronização
Etapa 1: Adquirir uma instância do DTS
Adquirir uma instância do DTS. Na página de compra, defina as seguintes opções:
Source Instance: MySQL
Target Instance: AnalyticDB for PostgreSQL
Synchronization Topology: One-Way Synchronization
Etapa 2: Configure o canal de sincronização
Faça login no console do DTS.
No painel de navegação à esquerda, clique em Data Synchronization.
Na parte superior da página Synchronization Tasks, selecione a região onde a instância de destino está localizada.
Localize a instância do DTS e clique em Configure Synchronization Channel na coluna Actions.
-
Configure as instâncias de source e de destino.
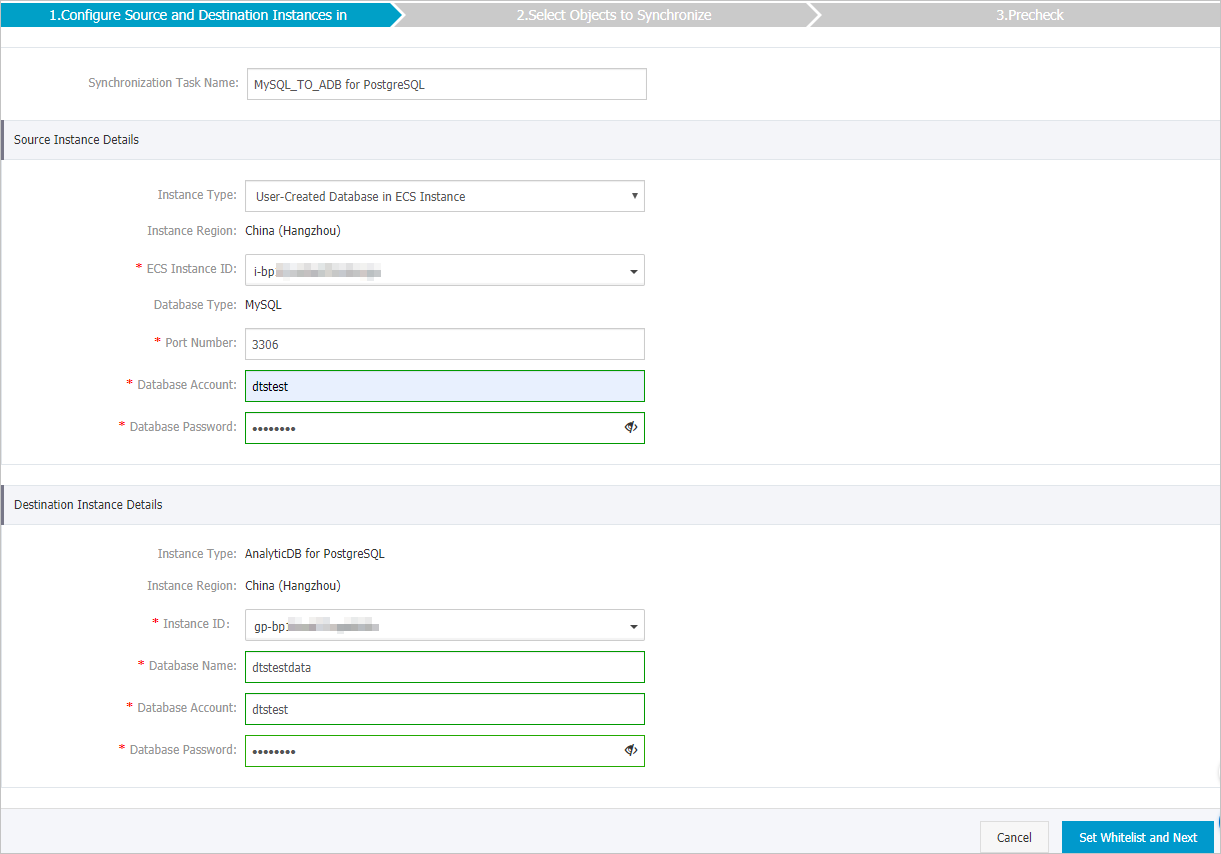
Detalhes da instância de source
Parâmetro
Descrição
Nome da tarefa de sincronização
O DTS gera um nome automaticamente. Especifique um nome descritivo para facilitar a identificação. O nome não precisa ser único.
Tipo de instância
Selecione User-Created Database in ECS Instance.
Região da instância
A região de source selecionada na página de compra. Somente leitura.
id da instância
Selecione a instância ECS que hospeda o banco de dados MySQL auto-gerenciado.
Tipo de banco de dados
Definido como MySQL. Somente leitura.
Número da porta
Insira a porta do serviço MySQL. Padrão: 3306.
Conta do banco de dados
Insira a conta do MySQL para a tarefa de sincronização. Esta conta requer as permissões listadas em Pré-requisitos.
Senha do banco de dados
Insira a senha da conta do banco de dados.
Detalhes da instância de destino
Parâmetro
Descrição
Tipo de instância
Definido como AnalyticDB for PostgreSQL. Somente leitura.
Região da instância
A região de destino selecionada na página de compra. Somente leitura.
id da instância
Selecione a instância do AnalyticDB for PostgreSQL de destino.
Nome do banco de dados
Insira o nome do banco de dados de destino.
Conta do banco de dados
Insira a initial account da instância do AnalyticDB for PostgreSQL ou uma conta com a permissão RDS_SUPERUSER. Para mais informações, consulte Crie uma conta de banco de dados e Gerencie usuários e permissões.
Senha do banco de dados
Insira a senha da conta do banco de dados de destino.
-
Clique em Set Whitelist and Next.
O DTS adiciona automaticamente os blocos CIDR dos servidores DTS à regra de entrada da instância ECS e à lista de permissões do AnalyticDB for PostgreSQL, permitindo que o DTS acesse ambas as instâncias.
Etapa 3: Selecione objetos e política de sincronização
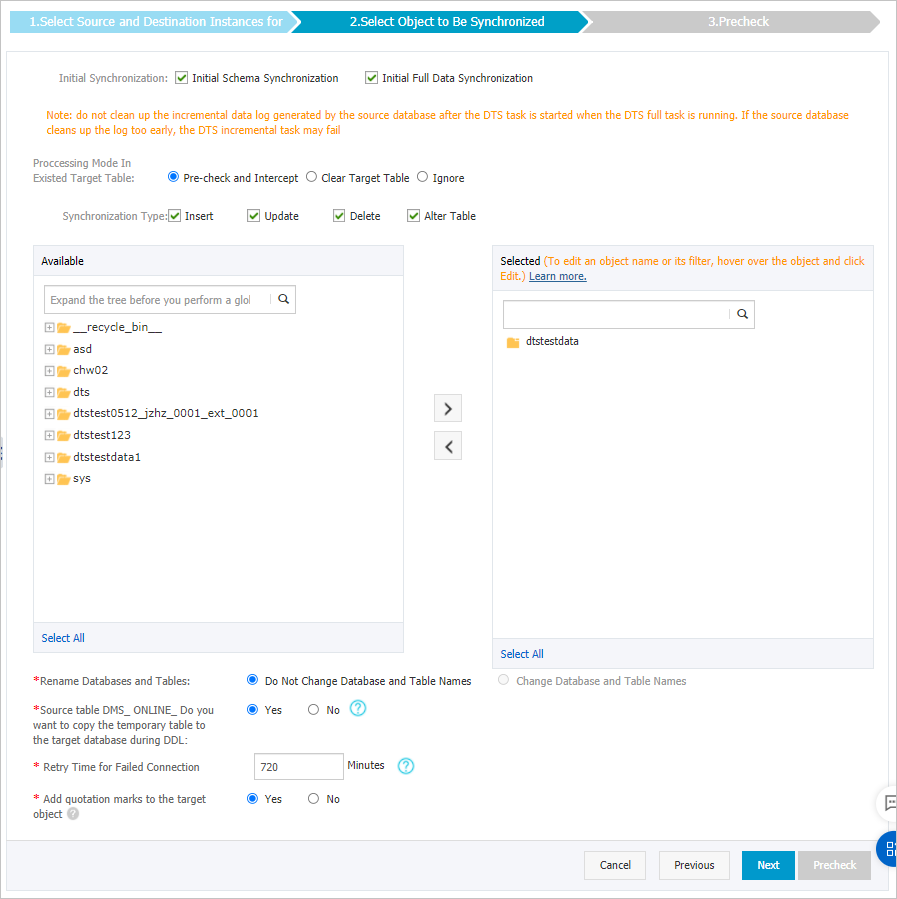
Defina as seguintes configurações:
|
Configuração |
Opções e descrição |
|
Initial synchronization |
Selecione Initial Schema Synchronization e Initial Full Data Synchronization. O DTS copia o schema e os dados para a instância de destino antes de iniciar a sincronização incremental. |
|
Processing mode of conflicting tables |
Clear Target Table: Limpa os dados da tabela de destino antes da sincronização completa inicial. Use esta opção para reiniciar os dados ou após uma execução de teste. Ignore: Anexa dados aos registros existentes. Use esta opção para mesclar dados de várias tabelas de source em uma única tabela de destino. |
|
Synchronization type |
Selecione as operações DML a serem sincronizadas: Insert, Update, Delete, AlterTable. |
|
Objects to synchronize |
Na seção Available, selecione as tabelas para sincronização e mova-as para a seção Selected usando o ícone |
|
Replicate temporary tables when DMS performs DDL operations |
Aplicável caso você use o DMS para executar operações DDL online na source. Yes: Sincroniza tabelas temporárias geradas por operações DDL online. Operações DDL extensas podem causar atrasos na sincronização. No: Ignora tabelas temporárias e sincroniza apenas os dados DDL originais. Isso pode bloquear as tabelas de destino. |
|
Retry time for failed connections |
Padrão: 720 minutos (12 horas). O DTS tenta reconectar dentro desta janela. Se a conexão for restaurada a tempo, a tarefa de sincronização será retomada automaticamente. Defina este valor com base nos seus requisitos de disponibilidade. A instância do DTS é cobrada durante o período de nova tentativa. |
 . Para renomear objetos na instância de destino, use o recurso de
Etapa 4: Defina chave primária e colunas de distribuição (apenas sincronização inicial de schema)
Esta etapa aparece somente se você tiver selecionado Initial Schema Synchronization. Especifique a coluna de chave primária e a coluna de distribuição para cada tabela sincronizada com o AnalyticDB for PostgreSQL.
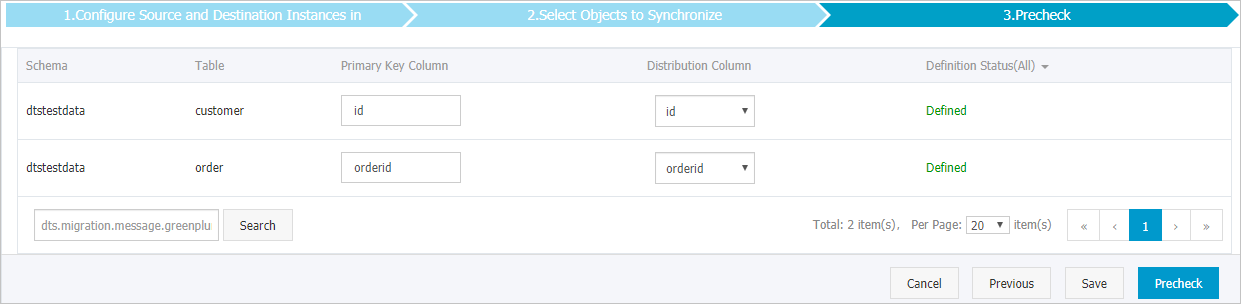
Para mais informações, consulte Defina restrições e Defina distribuição de tabela.
Etapa 5: Execute a pré-verificação e iniciar a sincronização
Clique em Precheck no canto inferior direito. O DTS valida a configuração antes de iniciar a tarefa. Se alguma verificação falhar, clique em no ícone
 ao lado do item com falha para obter detalhes. Corrija o problema e execute a pré-verificação novamente. Caso um item com falha não seja crítico para o seu cenário de uso, clique em Ignore para ignorá-lo e execute a pré-verificação outra vez.
Quando a mensagem The precheck is passed aparecer, feche a caixa de diálogo. A tarefa de sincronização iniciará automaticamente.
-
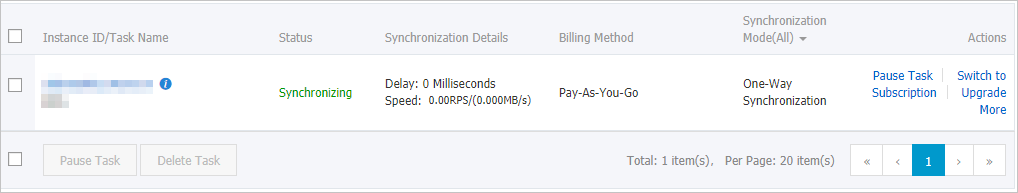
Aguarde a conclusão da sincronização inicial. O status da tarefa mudará para Synchronizing assim que a sincronização incremental começar. Monitore o status da tarefa na página Synchronization Tasks.
Considerações sobre desempenho
Durante a sincronização inicial completa de dados, o DTS lê da source e grava no destino simultaneamente. Em bancos de dados com carga elevada, especificações reduzidas ou grandes volumes de dados, isso pode afetar o desempenho. Para minimizar esse impacto, execute a sincronização fora dos horários de pico, quando a utilização da cpu tanto na source quanto no destino estiver abaixo de 30%.