Use o Data Transmission Service (DTS) para replicar dados de uma instância ApsaraDB RDS for PostgreSQL de origem em uma instância AnalyticDB for PostgreSQL destinada a análises e relatórios. O DTS gerencia a carga inicial completa e as alterações incrementais contínuas (INSERT, UPDATE, DELETE), mantendo o banco de dados analítico sincronizado sem exportações manuais.
Pré-requisitos
Antes de começar, verifique se você tem:
Tabelas com chaves primárias definidas para sincronização. O DTS usa replicação lógica para captura de dados alterados (CDC). Tabelas sem chaves primárias não permitem rastrear mudanças no nível da linha.
Uma instância AnalyticDB for PostgreSQL de destino. Para mais informações, consulte Criar uma instância AnalyticDB for PostgreSQL.
Limitações
Analise estas restrições antes de configurar a tarefa de sincronização:
Não há suporte para sincronização de schema. O DTS não copia schemas da origem para o destino. Crie manualmente o banco de dados, os schemas e as tabelas de destino antes de iniciar a tarefa.
Apenas tabelas podem ser selecionadas como objetos de sincronização. Não há suporte para views, sequences e outros tipos de objetos.
Tipos de dados sem suporte: BIT, VARBIT, GEOMETRY, UUID, TSQUERY, TSVECTOR e TXID_SNAPSHOT. Colunas com esses tipos são ignoradas durante a sincronização.
Operações DDL não são propagadas automaticamente. Se você executar um comando DDL em uma tabela de origem durante a sincronização, aplique o mesmo DDL na tabela de destino e reinicie a tarefa.
Uma tarefa por banco de dados. Cada tarefa de sincronização abrange apenas um banco de dados de origem. Para sincronizar vários bancos, crie uma tarefa distinta para cada um.
O failover entre primário e secundário tem suporte apenas no ApsaraDB RDS for PostgreSQL 11. Em outras versões do RDS e em bancos de dados PostgreSQL autogerenciados, um failover causa falha na tarefa. Se precisar de suporte a failover em uma instância PostgreSQL 11, defina o parâmetro
rds_failover_slot_modecomosyncantes de realizar o procedimento. Para mais detalhes, consulte Failover de Slot de Replicação Lógica.
Faturamento
|
Tipo de sincronização |
Tarifa |
|
Sincronização de schema e sincronização completa de dados |
Gratuita |
|
Sincronização incremental de dados |
Paga. Para mais informações, consulte Visão geral do faturamento. |
Considerações importantes
Transações longas e acúmulo de WAL
O DTS usa write-ahead logging (WAL) para capturar alterações incrementais. Se uma transação de longa duração permanecer aberta no banco de dados de origem, o PostgreSQL não conseguirá remover os segmentos de WAL gerados antes do início dessa transação. Esses segmentos se acumulam no disco até que a transação seja confirmada (commit) ou revertida (rollback). Se o disco da origem encher, a tarefa de sincronização falhará.
Para mitigar esse risco, monitore as transações abertas na instância de origem durante a sincronização ativa e mantenha as transações curtas.
Novas tabelas criadas após o início da sincronização
O DTS detecta tabelas criadas no banco de dados de origem após o início da tarefa, mas essas tabelas exigem a configuração prévia de identidade no nível da linha:
ALTER TABLE schema.table REPLICA IDENTITY FULL;Execute este comando em cada nova tabela antes que o DTS a processe para garantir que as alterações nas linhas sejam capturadas corretamente.
Preparar a instância de origem
O DTS usa replicação lógica do PostgreSQL para capturar mudanças incrementais. A replicação lógica exige que o parâmetro wal_level esteja definido como logical.
A alteração do parâmetro wal_level requer a reinicialização da instância. Planeje essa mudança fora dos horários de pico para minimizar o impacto na carga de trabalho.
Faça login no console do ApsaraDB RDS.
No painel de navegação à esquerda, clique em Instances.
Na barra de navegação superior, selecione a região onde a instância ApsaraDB RDS for PostgreSQL está localizada.
Clique no ID da instância.
No painel de navegação à esquerda, clique em Parameters.
Na página Parameters, localize
wal_levele defina seu valor comological. Para mais informações, consulte Modificar parâmetros de uma instância ApsaraDB RDS for PostgreSQL.Reinicie a instância para aplicar a alteração.
Preparar a instância de destino
Crie o banco de dados, o schema e as tabelas de destino na instância AnalyticDB for PostgreSQL com base no schema da origem. O DTS não cria esses objetos automaticamente. Para sintaxe SQL, consulte Sintaxe SQL.
Criar uma tarefa de sincronização
-
Adquira uma instância de sincronização de dados. Para mais informações, consulte Comprar uma instância DTS.
Na página de compra, defina Source Instance como PostgreSQL , defina Destination Instance como AnalyticDB for PostgreSQL e configure Synchronization Topology como One-Way Synchronization .
-
Faça login no console do DTS.
Se você for redirecionado para o console do Data Management (DMS), passe o ponteiro sobre o ícone
 no canto inferior direito e clique no ícone
 para retornar ao console do DTS. Se estiver na nova versão do console do DTS, clique no ícone
 no canto inferior direito.
No painel de navegação à esquerda, clique em Data Synchronization.
Na parte superior da página Data Synchronization Tasks, selecione a região onde a instância de destino reside.
Localize a instância de sincronização de dados e clique em Configure Task na coluna Actions.
-
Configure as instâncias de origem e de destino.
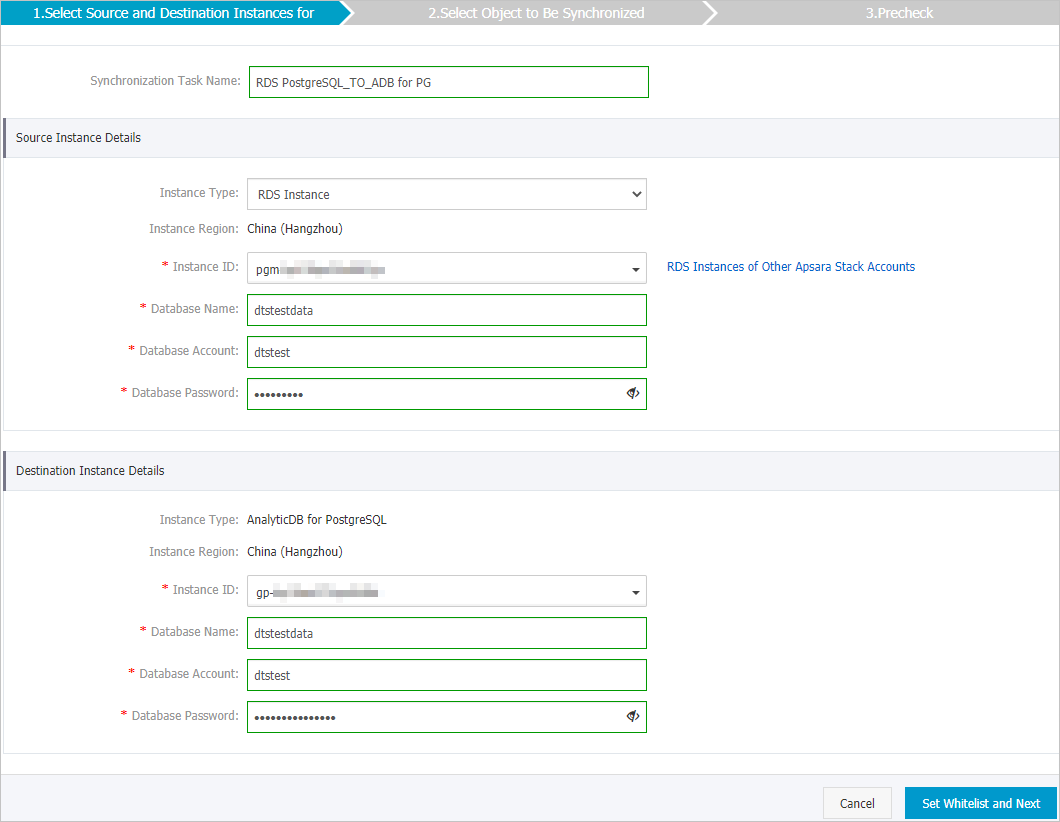
Detalhes da instância de origem
Parâmetro
Descrição
Synchronization task name
Nome gerado automaticamente pelo DTS. Especifique um nome descritivo para facilitar a identificação da tarefa. Não é necessário que seja único.
Instance type
Selecione RDS Instance.
Instance region
Região de origem selecionada na página de compra. Este valor não pode ser alterado.
Instance ID
ID da instância ApsaraDB RDS for PostgreSQL.
Database name
Nome do banco de dados de origem.
Database account
Conta privilegiada da instância ApsaraDB RDS for PostgreSQL. A conta deve ser proprietária do banco de dados selecionado. Se a origem executar PostgreSQL 9.4 e você sincronizar apenas operações DML, a permissão REPLICATION é suficiente.
Database password
Senha da conta do banco de dados.
Detalhes da instância de destino
Parâmetro
Descrição
Instance type
Fixo como AnalyticDB for PostgreSQL.
Instance region
Região de destino selecionada na página de compra. Este valor não pode ser alterado.
Instance ID
ID da instância AnalyticDB for PostgreSQL de destino.
Database name
Nome do banco de dados de destino. O banco já deve existir na instância. Caso contrário, crie um banco de dados primeiro.
Database account
A conta inicial da instância AnalyticDB for PostgreSQL. Também é possível usar uma conta com a permissão RDS_SUPERUSER. Para mais informações, consulte Criar uma conta de banco de dados e Gerenciar usuários e permissões.
Database password
Senha da conta do banco de dados.
-
Clique em Set Whitelist and Next. O DTS adiciona automaticamente seus blocos CIDR de servidor à lista de permissões de endereços IP das instâncias de banco de dados Alibaba Cloud. Para bancos autogerenciados hospedados em instâncias Elastic Compute Service (ECS), o DTS adiciona os blocos CIDR às regras do grupo de segurança do ECS; se o banco abranger várias instâncias ECS, adicione os blocos CIDR manualmente em cada uma. Para bancos implantados em data centers locais ou fornecidos por terceiros, adicione os blocos CIDR manualmente. Para mais informações, consulte Adicionar blocos CIDR dos servidores DTS.
AvisoAdicionar blocos CIDR do servidor DTS à sua lista de permissões ou regras de grupo de segurança aumenta a exposição da rede. Antes de prosseguir, avalie as implicações de segurança e tome medidas adequadas, como usar credenciais fortes, restringir portas expostas, auditar chamadas de API, revisar regras da lista de permissões regularmente e conectar-se via Express Connect, VPN Gateway ou Smart Access Gateway (SAG) em vez da internet pública.
-
Configure a política de sincronização e os objetos a serem sincronizados.
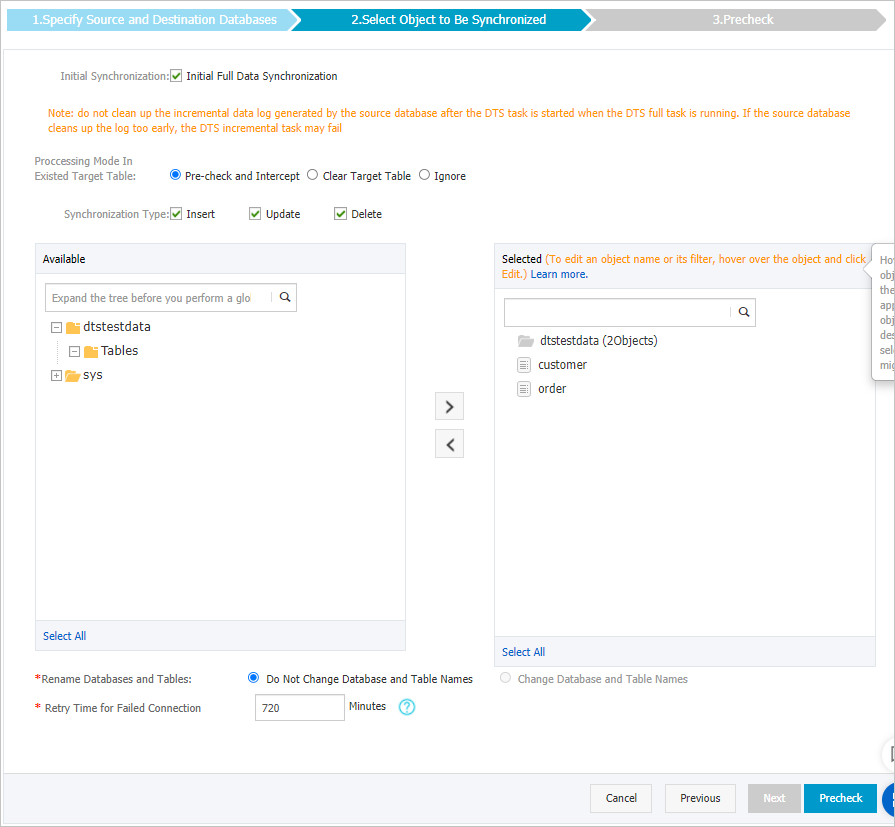
Parâmetro
Descrição
Initialize synchronization
Initial Full Data Synchronization vem selecionado por padrão. O DTS sincroniza todos os dados existentes do banco de origem antes de iniciar a sincronização incremental.
Processing mode of conflicting tables
Clear Data: Ignora a verificação de tabela vazia na pré-checagem e limpa os dados da tabela de destino antes da carga completa. Ideal para testes de tarefa antes de migrar para dados de produção. Ignore: Ignora a verificação de tabela vazia e anexa dados aos existentes na tabela de destino. Recomendado ao consolidar dados de várias tabelas de origem em uma única tabela de destino.
Synchronization type
Selecione os tipos de operação a sincronizar: Insert, Update e Delete. A opção AlterTable aparece listada, mas não tem suporte.
Select the objects to be synchronized
Na seção Available, selecione uma ou mais tabelas e clique no ícone
 para movê-las à seção Selected. Apenas tabelas podem ser selecionadas. Para renomear objetos sincronizados no destino, use o recurso de mapeamento de nomes de objetos. Para mais detalhes, consulte Mapeamento de nomes de objetos.
Retry time for failed connections
Padrão: 720 minutos (12 horas). Se o DTS não conseguir se conectar à origem ou ao destino dentro desse período, a tarefa falhará. Ajuste conforme sua tolerância a indisponibilidade. O faturamento do DTS continua durante as tentativas de reconexão; portanto, libere a instância DTS prontamente se a origem ou o destino for desativado.
-
Clique em Precheck.
O DTS executa uma pré-checagem antes de iniciar a tarefa. Se a pré-checagem falhar, clique no ícone
 ao lado de cada item com falha para visualizar detalhes, corrigir os problemas e executar a pré-checagem novamente. Você também pode ignorar itens específicos com falha e reexecutar a pré-checagem se os problemas não afetarem seu caso de uso.
Após a mensagem Precheck Passed aparecer, feche a caixa de diálogo Precheck. A tarefa de sincronização será iniciada automaticamente.
-
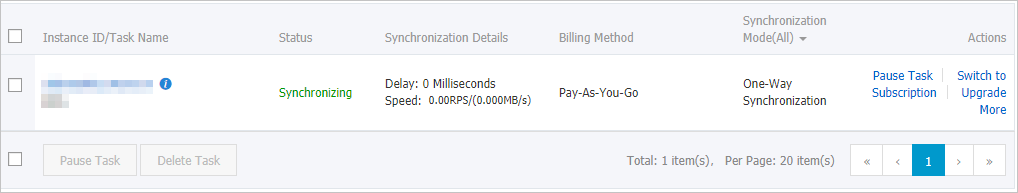
Na página Synchronization Tasks, aguarde até que a tarefa atinja o estado Synchronizing, indicando que a sincronização inicial completa foi concluída e a sincronização incremental está ativa.
Próximos passos
Para renomear tabelas ou colunas no banco de dados de destino, consulte Renomear um objeto a ser sincronizado.
Para monitorar a latência da sincronização e a integridade da tarefa, visualize os detalhes da tarefa no console do DTS.