A ferramenta de importação do AnalyticDB for MySQL carrega arquivos locais delimitados em um cluster AnalyticDB for MySQL Data Warehouse Edition via Java Database Connectivity (JDBC). Ela oferece desempenho superior ao da instrução LOAD DATA, pois permite a importação simultânea de vários arquivos e o ajuste de batchSize e concurrency para maximizar o throughput de escrita.
Como funciona
A ferramenta se conecta a uma instância do Server Load Balancer (SLB), que distribui o tráfego entre vários nós front-end. Esses nós analisam os protocolos MySQL e as instruções SQL, gravam os dados e agendam as consultas. Em seguida, os dados fluem dos nós front-end para os nós de armazenamento, onde são persistidos.
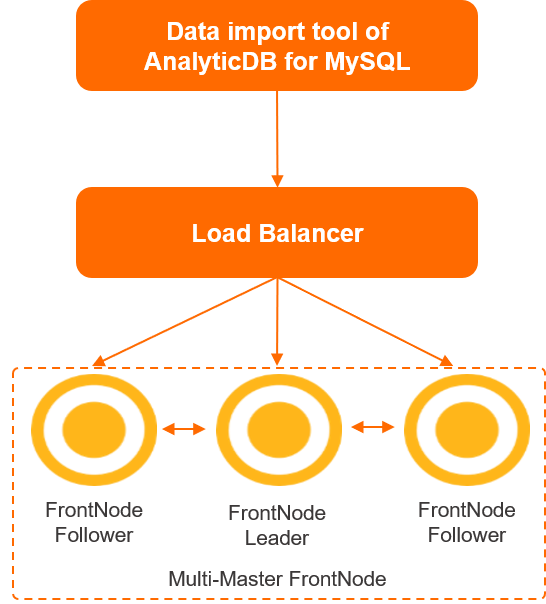
Pré-requisitos
Antes de começar, verifique se você possui:
Java 1.8 ou posterior instalado (execute
java -versionpara verificar)Acesso de rede ao endpoint do cluster AnalyticDB for MySQL
Um banco de dados e uma tabela de destino já criados no cluster
Importar dados
|
Etapa |
Descrição |
|
Etapa 1: Baixe e descompacte a ferramenta de importação |
Baixe e descompacte o pacote da ferramenta. |
|
Etapa 2: Preparar os arquivos de dados |
Verifique o formato do arquivo, a ordem das colunas e os delimitadores. |
|
Etapa 3: Configure o script de importação |
Defina os parâmetros de conexão, arquivo e desempenho. |
|
Etapa 4: Execute a importação |
Execute o script e monitore o progresso. |
Etapa 1: Baixe e descompacte a ferramenta de importação
-
Crie um diretório de trabalho:
mkdir -p /u01/loadata -
Acesse o diretório:
# cd /u01/loadata -
Baixe a ferramenta:
wget https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20220811/gpvn/adb-import-tool.tar.gz -
Descompacte o pacote:
tar zxvf adb-import-tool.tar.gz
O pacote extrai os seguintes arquivos:
adb-import.sh.template
adb-import.sh.template.md5
adb-import-tool.jar
adb-import-tool.jar.md5
Etapa 2: Preparar os arquivos de dados
Verifique o formato do arquivo
Anote o caminho absoluto dos arquivos ou pastas a serem importados.
Identifique o delimitador de linha e o delimitador de coluna. Você definirá esses valores nos parâmetros do script.
-
Confirme se a ordem das colunas nos seus arquivos corresponde à instrução
CREATE TABLE. ExecuteSHOW CREATE TABLEno banco de dados para verificar. Sua tabela e um arquivo de dados correspondente podem ter a seguinte aparência:CREATE TABLE `product_info` ( `id` bigint NOT NULL, `name` varchar, `price` decimal(15, 2) NOT NULL ) DISTRIBUTED BY HASH(`id`) INDEX_ALL='Y';1|tv|1000.0 2|computer|2000.0 3|cup|15.8Os arquivos devem conter pelo menos duas colunas. Um delimitador à direita na última coluna é aceito — tanto
1|abc|3.0quanto1|abc|3.0|são válidos.
Campos vazios são tratados como null por padrão. Por exemplo,4||5.0insere null na colunaname, e não uma string vazia. Colunas de incremento automático são gerenciadas automaticamente — nenhum pré-processamento é necessário.
Dividir arquivos grandes
Dividir um arquivo grande em segmentos permite que a ferramenta de importação os leia simultaneamente. Recomenda-se um tamanho de segmento de 1 a 2 GB.
Para um arquivo de 128 GB chamado filename.txt, divida-o em 64 segmentos de 2 GB cada:
# split -l$((`wc -l < filename.txt`/64 + 1)) filename.txt filename.txt.split -da 2;A ferramenta lê todos os 64 segmentos simultaneamente durante a importação.
Etapa 3: Configure o script de importação
O arquivo adb-import.sh.template é um modelo reutilizável. Copie-o e renomeie-o para cada tabela — por exemplo, adb-import-product_info.sh para a tabela product_info.
Parâmetros obrigatórios
Defina estes parâmetros para cada tarefa de importação:
####################################
# Path to the Java command.
# If Java is already on your PATH, leave this as-is.
####################################
java_cmd=java

####################################
# Absolute path to the import tool JAR.
# If the script and JAR are in the same directory, leave this as-is.
####################################
jar_path=adb-import-tool.jar

####################################
# Database connection settings.
# If encryptPassword=true, provide a Base64-encoded password.
####################################
host=host
port=3306
user=adbuser
password=pwd
database=dbname
encryptPassword=false

####################################
# Table name.
####################################
tableName=please_set_table_name

####################################
# Path to the file or folder to import.
# For multiple files, separate paths with commas (,).
####################################
dataPath=please_set_data_file_path_or_dir_path

####################################
# The number of files that are imported in a concurrent manner.
# To fully leverage the performance of AnalyticDB for MySQL, set this
# parameter to a number within the range of 16 to 96.
####################################
concurrency=64

####################################
# The number of values that are written when the import operation is performed.
# Specify this parameter based on the lengths of individual rows.
# To fully leverage the performance of AnalyticDB for MySQL, set this
# parameter to a number within the range of 1024 to 4096.
# Smaller batches make individual failed rows easier to identify.
####################################
batchSize=4096

####################################
# File encoding. Valid values: UTF-8, GBK.
####################################
encoding=UTF-8

####################################
# Row delimiter.
# For non-printable characters, use hexadecimal notation.
# Example: \x0d\x06\x08\x0a -> hex0d06080a
####################################
lineSeparator="\\n"

####################################
# Column delimiter.
# For non-printable characters, use hexadecimal notation.
# Example: \x07\x07 -> hex0707
####################################
delimiter="\\|"
Parâmetros opcionais
Ajuste estes parâmetros para cenários específicos:
####################################
# JVM heap size. Increase if you see frequent garbage collection (GC).
####################################
jvmopts="-Xmx12G -Xms12G"

####################################
# Max number of files read concurrently from a folder.
####################################
maxConcurrentNumOfFilesToImport=64

####################################
# How to handle empty fields.
# false (default): empty fields become null.
# true: empty fields become '' (empty string).
####################################
nullAsQuotes=false

####################################
# Print the actual row count of the destination table after each file.
####################################
printRowCount=false

####################################
# Max characters to display for failed SQL statements.
####################################
failureSqlPrintLengthLimit=1000

####################################
# Dry-run mode. true=display INSERT statements only, false=execute them.
####################################
disableInsertOnlyPrintSql=false

####################################
# Skip the header row in each file.
####################################
skipHeader=false

####################################
# Buffer pool size for INSERT batches.
# Separates I/O and compute, improving client throughput.
####################################
windowSize=128

####################################
# Escape backslashes (\) and apostrophes (') in column values.
# true (default): safe for all data but slightly slower.
# false: faster, but only use if your data contains neither character.
####################################
escapeSlashAndSingleQuote=true

####################################
# Ignore batches that fail to import instead of stopping.
####################################
ignoreErrors=false

####################################
# Print failed SQL statements.
####################################
printErrorSql=true

####################################
# Print the stack trace when a SQL error occurs.
####################################
printErrorStackTrace=true
Etapa 4: Execute a importação
-
Execute o script de importação:
sh adb-import-product_info.sh;A seguinte entrada de log confirma que o script foi iniciado:
[2021-03-13 17:50:24.730] add consumer consumer-01 -
A ferramenta não exibe uma barra de progresso. Para verificar quantas linhas foram carregadas, consulte a tabela de destino:
mysql > select count(*) from dbname.product_info; -
Ao concluir a importação, a ferramenta imprime um resumo: quantas linhas foram lidas por arquivo, quanto tempo cada arquivo levou, o tempo total decorrido e se todos os arquivos foram processados com sucesso.
Todos os arquivos tiveram sucesso:
all import finished successfullyUm ou mais arquivos falharam:
all import finished with ERROR!
Se ocorrer um erro durante o processo de importação de dados, a ferramenta encerra imediatamente a operação e fornece os detalhes das instruções SQL com falha. A tabela de destino conterá dados parciais. ExecuteTRUNCATE TABLE table_namepara limpar a tabela de destino e execute a operação de importação novamente. Você também pode executarDROP TABLE table_namepara excluir a tabela de destino e criar outra tabela para a importação.
Perguntas frequentes
Como verifico se o gargalo está no cliente ou no servidor?
Execute estes comandos na máquina cliente para identificar saturação de recursos:
|
Comando |
O que ele mostra |
|
|
Utilização da CPU |
|
|
Uso de memória |
|
|
Carga geral do sistema |
|
|
Largura de banda de leitura do disco e utilização |
|
|
Detalhes do garbage collection do Java |
Se o jstat mostrar GC frequente, aumente o heap da JVM definindo jvmopts como -Xmx16G -Xms16G.
Como importo várias tabelas com um único script?
Se todas as tabelas compartilharem os mesmos delimitadores, parametrize tableName e dataPath:
tableName=$1
dataPath=$2
Em seguida, execute uma invocação separada por tabela:
# sh adb-import.sh table_name001 /path/table_001
# sh adb-import.sh table_name002 /path/table_002
# sh adb-import.sh table_name003 /path/table_003
Como executo a importação em segundo plano?
# nohup sh adb-import.sh &Verifique os logs:
# tail -f nohup.outConfirme se o processo está em execução:
# ps -ef|grep importComo ignoro erros de importação?
Se ocorrerem erros de execução de SQL, defina ignoreErrors=true. A ferramenta continua a importação e registra os arquivos afetados, os números das linhas iniciais e as instruções com falha. Se o parâmetro batchSize for especificado, o número da linha com defeito será menor ou igual ao número da linha inicial mais o valor de batchSize.
Incompatibilidades na contagem de colunas não podem ser ignoradas. Quando o número de colunas em uma linha não corresponde à definição da tabela, a ferramenta interrompe imediatamente o processamento desse arquivo. Verifique o arquivo manualmente antes de tentar novamente. A mensagem de erro tem a seguinte aparência:
[ERROR] 2021-03-22 00:46:40,444 [producer- /test2/data/lineitem.csv.split00.100-41] analyticdb.tool.ImportTool
(ImportTool.java:591) -bad line found and stop import! 16, file = /test2/data/tpch100g/lineitem.csv.split00.100, rowCount = 7, current row = 3|123|179698|145|73200.15|0.06|0.00|R|F|1994-02-02|1994-01-04|1994-02-
23|NONE|AIR|ongside of the furiously brave acco|
Como identifico a causa de um erro de importação?
Existem três abordagens:
-
Aumente o comprimento de impressão do SQL para ver mais detalhes da instrução com falha:
printErrorSql=true failureSqlPrintLengthLimit=1500 -
Reduza o
batchSizepara localizar a linha com defeito:batchSize=10 -
Isole um segmento de arquivo específico se você já identificou qual arquivo dividido contém o erro:
dataPath=/u01/this/is/the/directory/where/product_info/stores/file007
Como executo a ferramenta no Windows?
No Windows, nenhum script shell é fornecido. Chame o JAR diretamente usando a interface de linha de comando:
usage: java -jar adb-import-tool.jar [-a <arg>] [-b <arg>] [-B <arg>] [-c <arg>]
      [-D <arg>] [-d <arg>] [-E <arg>] [-f <arg>] [-h <arg>] [-I <arg>]
      [-k <arg>] [-l <arg>] [-m <arg>] [-n <arg>] [-N <arg>] [-O <arg>]
      [-o <arg>] [-p <arg>] [-P <arg>] [-Q <arg>] [-s <arg>]  [-S <arg>]
      [-t <arg>] [-T <arg>] [-u <arg>] [-w <arg>][-x <arg>] [-y <arg>] [-z <arg>]
Parâmetros obrigatórios:
|
Sinalizador |
Descrição |
|
|
Endpoint do cluster |
|
|
Conta do banco de dados |
|
|
Senha da conta |
|
|
Número da porta |
|
|
Nome do banco de dados |
|
|
Caminho absoluto para o arquivo ou pasta. Para vários arquivos, separe os caminhos com vírgulas (,). |
|
|
Nome da tabela de destino |
Parâmetros opcionais:
|
Sinalizador |
Padrão |
Descrição |
|
|
|
(vazio) |
Crie um arquivo marcador quando a importação é concluída. Deixe em branco para desativar. |
|
|
|
|
Linhas por lote INSERT. Defina entre 1024 e 4096 para obter o melhor throughput. |
|
|
|
|
Ative a criptografia de senha em Base64. |
|
|
|
|
Imprime a contagem de linhas da tabela de destino após cada arquivo. |
|
|
|
|
Ignora a primeira linha de cada arquivo. |
|
|
|
|
Escapa |
|
|
|
|
Continua a importação quando ocorrem erros de SQL. |
|
|
|
|
Número de linhas a ignorar no início de cada arquivo (semelhante a |
|
|
|
|
` |
Delimitador de coluna. Para caracteres não imprimíveis, use notação hexadecimal (por exemplo, |
|
|
|
Máximo de arquivos lidos simultaneamente de uma pasta. |
|
|
|
|
|
|
|
|
|
Imprime instruções SQL que falham na execução. |
|
|
|
|
Tamanho do pool de conexões do banco de dados. |
|
|
|
|
Codificação do arquivo. Valores válidos: |
|
|
|
|
|
|
|
|
|
Delimitador de linha. Para caracteres não imprimíveis, use notação hexadecimal (por exemplo, |
|
|
|
|
Imprime o stack trace quando ocorre um erro de SQL. |
|
|
|
|
Tamanho do buffer pool para lotes INSERT. Separa E/S de computação para melhorar o desempenho do cliente. |
|
|
|
|
Anexa nomes de colunas às instruções INSERT (por exemplo, |
|
|
|
|
Máximo de caracteres a exibir para instruções SQL com falha. |
|
|
|
|
Parâmetros adicionais de conexão JDBC. Exemplo: |
Exemplos:
Importar um único arquivo com parâmetros padrão:
java -Xmx8G -Xms8G -jar adb-import-tool.jar \
  -hyourhost.ads.aliyuncs.com -uadbuser -ppassword -P3306 -Dtest \
  --dataFile /data/lineitem.sample --tableName LINEITEM
Importar todos os arquivos em uma pasta com throughput máximo:
java -Xmx16G -Xms16G -jar adb-import-tool.jar \
  -hyourhost.ads.aliyuncs.com -uadbuser -ppassword -P3306 -Dtest \
  --dataFile /data/tpch100g --tableName LINEITEM \
  --concurrency 64 --batchSize 2048