Ao receber uma consulta, o AnalyticDB for MySQL a divide em vários stages. O sistema distribui esses stages entre nós worker e nós executor para leitura e processamento de dados. Alguns stages podem ser executados em paralelo, enquanto outros possuem dependências e precisam ser executados sequencialmente. Essa complexidade dificulta a análise da duração de instruções SQL complexas. Use os detalhes de stage e task no console ou via API para analisar consultas lentas.
Procedimento
Faça login no console do AnalyticDB for MySQL. No canto superior esquerdo do console, selecione uma região. No painel de navegação à esquerda, clique em Clusters. Localize o cluster que deseja gerenciar e clique no ID do cluster.
No painel de navegação à esquerda, clique em Diagnostics and Optimization.
Na seção SQL Queries, clique em Diagnose na consulta desejada.
Clique na aba Stages & Tasks. A seção Query Properties, no topo da página, exibe informações como horário de início e término, nome de usuário, tempo de fila, duração total, pico de memória, volume de dados verificados, volume de dados retornados, status e grupo de recursos. A aba Stages & Tasks lista os detalhes de execução de cada stage, incluindo Stage ID, status, linhas e volume de dados de entrada/saída, pico de memória e duração acumulada. Para obter uma descrição dos resultados da consulta de stage, consulte Stage parameters.
-
Para solucionar problemas de uma consulta lenta, clique em um Stage ID para visualizar os detalhes de todas as tasks nesse stage. Para obter uma descrição dos resultados da consulta de task, consulte Task parameters.
ImportanteOs detalhes da task estão disponíveis apenas para consultas que levam mais de 1 segundo para serem concluídas.
Parâmetros
Parâmetros de stage
|
Parâmetro |
Descrição |
|
Stage ID |
Identificador exclusivo do stage. Este ID corresponde ao ID do stage na árvore do plano de execução. |
|
Status |
Status de execução do stage. Valores válidos:
|
|
Input rows |
Número de linhas nos dados de entrada do stage. |
|
Input data size |
Tamanho dos dados de entrada do stage. |
|
Output rows |
Número de linhas nos dados de saída do stage. |
|
Output data size |
Tamanho dos dados de saída do stage. |
|
Peak memory |
Uso máximo de memória do stage. |
|
Cumulative duration |
Soma do tempo consumido por todos os operadores no stage. Este parâmetro ajuda a identificar stages que consomem muito tempo ou têm alto uso de CPU. Não é possível comparar diretamente a duração acumulada com a duração da consulta. Considere também o paralelismo do stage para determinar a relação entre a duração da consulta e a duração acumulada. |
Parâmetros de task
|
Parâmetro |
Descrição |
|
Task ID |
Identificador exclusivo da task. Por exemplo, em |
|
Status |
Status de execução da task. Valores válidos:
|
|
Input data |
Número de linhas e tamanho dos dados de entrada da task. Ordene as tasks por este valor para verificar se há skew de dados na entrada do stage. Se existir skew de dados, isso indica que a cláusula GROUP BY ou JOIN possui uma chave de distribuição ineficiente. Rastreie o stage anterior para resolver o problema. Nota
O skew de dados ocorre quando uma chave de distribuição ineficiente causa distribuição desigual de dados entre os nós worker. |
|
Output data |
Número de linhas e tamanho dos dados de saída da task. Examine as propriedades do nó Aggregation ou Join no plano de operador do stage atual para mapeá-las à instrução SQL e verificar se campos combinados são usados na chave de partição ou na condição JOIN. Por exemplo, |
|
Peak memory |
Memória máxima usada durante a execução da task. O pico de memória é proporcional ao tamanho dos dados de entrada. Ele ajuda a determinar se uma consulta falhou devido a uso de memória altamente desequilibrado em determinados nós. |
|
Table read duration |
Quando a árvore de operadores de um stage contém um operador TableScan, este parâmetro indica o tempo total gasto por todos os operadores TableScan no stage para ler dados da tabela. Essa duração é um valor acumulado de várias máquinas e threads e não pode ser comparada diretamente com a duração da consulta. Compare-a com a duração acumulada para determinar se o tempo de execução de um stage é gasto principalmente na varredura de dados. |
|
Data read from tables |
Quando a árvore de operadores de um stage contém um operador TableScan, este parâmetro indica o número de linhas e a quantidade de dados lidos da tabela de origem por todos os operadores TableScan no stage. Ordene este campo para determinar se existe skew de dados na tabela de origem. Se existir, use o console para diagnosticar o skew da chave de distribuição. Para mais informações, consulte Data modeling diagnostics. |
|
Created at |
Horário em que a task foi criada. |
|
Queuing duration |
Tempo que a task permaneceu na fila antes do início da execução. |
|
Ended at |
Horário em que a task terminou a execução. |
|
Interval between start and end time |
Tempo decorrido entre o horário de criação da task e seu horário de término. Por exemplo, se uma task foi criada às 2022-12-12 12:00:00 e terminou às 2022-12-12 12:00:04, o intervalo é de 4s. Compare este intervalo com a duração da consulta para identificar onde ocorrem gargalos de desempenho. Por exemplo, se a duração da consulta for 6s e o intervalo for 4s, o gargalo está no stage atual. Para obter um método de cálculo detalhado, consulte Example: Calculating task duration and concurrency. |
|
Cumulative duration |
Soma do tempo de execução de todas as threads nesta task. Para obter um método de cálculo detalhado, consulte Example: Calculating task duration and concurrency. |
|
Computing time ratio |
Razão entre o tempo real de processamento de dados e o ciclo de vida da subtask. Fórmula: Computing time ratio = (Cumulative duration / Subtask concurrency) / Interval between start and end time. Nesta fórmula, (Cumulative duration / Subtask concurrency) representa o tempo médio que cada thread gastou processando dados, enquanto o intervalo inclui o tempo real de processamento, a duração da fila da subtask e a latência de rede. Para obter um método de cálculo detalhado, consulte Example: Calculating task duration and concurrency. Nota
Uma razão de tempo de computação menor sugere um intervalo maior entre o início e o fim, indicando a necessidade de identificar operadores que consomem muito tempo. Por outro lado, uma razão maior sugere um intervalo menor, o que aponta para problemas como espera de recursos ou latência de rede. |
|
Subtask concurrency |
Cada task é executada por múltiplas threads concorrentes em uma única máquina. O número de threads executando tasks de computação simultaneamente é a concorrência da subtask. Para obter um método de cálculo detalhado, consulte Example: Calculating task duration and concurrency. |
|
Execution node |
Endereço IP interno do nó onde a task foi executada. Se várias consultas apresentarem long tail no mesmo nó, investigue esse nó específico. Nota
Long tail ocorre quando algumas tasks em uma execução distribuída do AnalyticDB for MySQL demoram significativamente mais para serem concluídas do que outras tasks. |
Exemplo: Cálculo de duração e concorrência da task
Este exemplo mostra como calcular o intervalo entre o horário de início e término, a duração acumulada, a razão de tempo de computação e a concorrência da subtask para uma task chamada Task 2.1.
Suponha que a Task 2.1 pertença ao stage[2], que contém quatro operadores: StageOutput, Join, TableScan e RemoteSource. A figura a seguir mostra a árvore de operadores.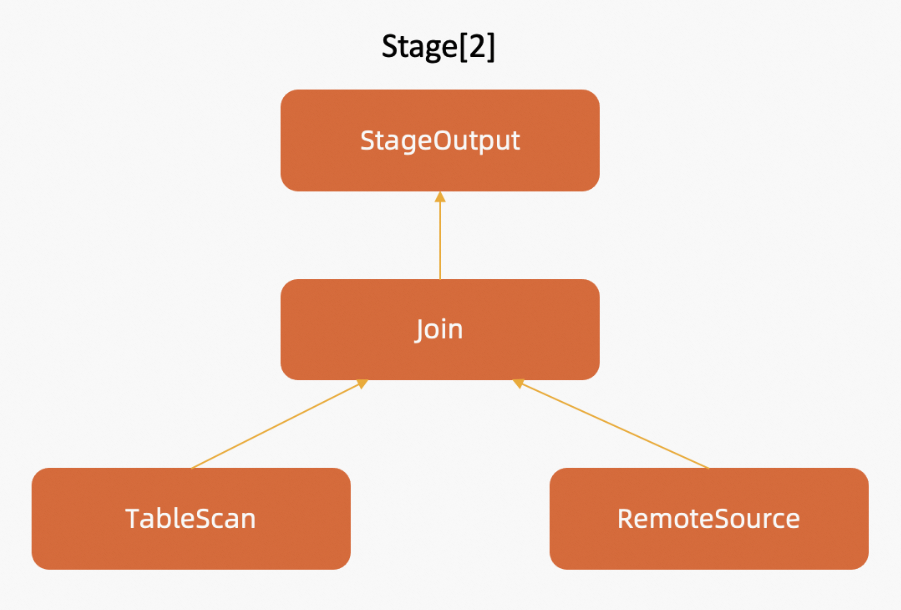
Os operadores na árvore são executados em paralelo em vários nós, seguindo a direção das setas. A Task 2.1 é executada em quatro threads concorrentes no nó com endereço IP 192.168.12.23. Os tempos de processamento de dados são 5s para a Thread 1 e Thread 2, e 6s para a Thread 3 e Thread 4. A figura a seguir ilustra o processo.
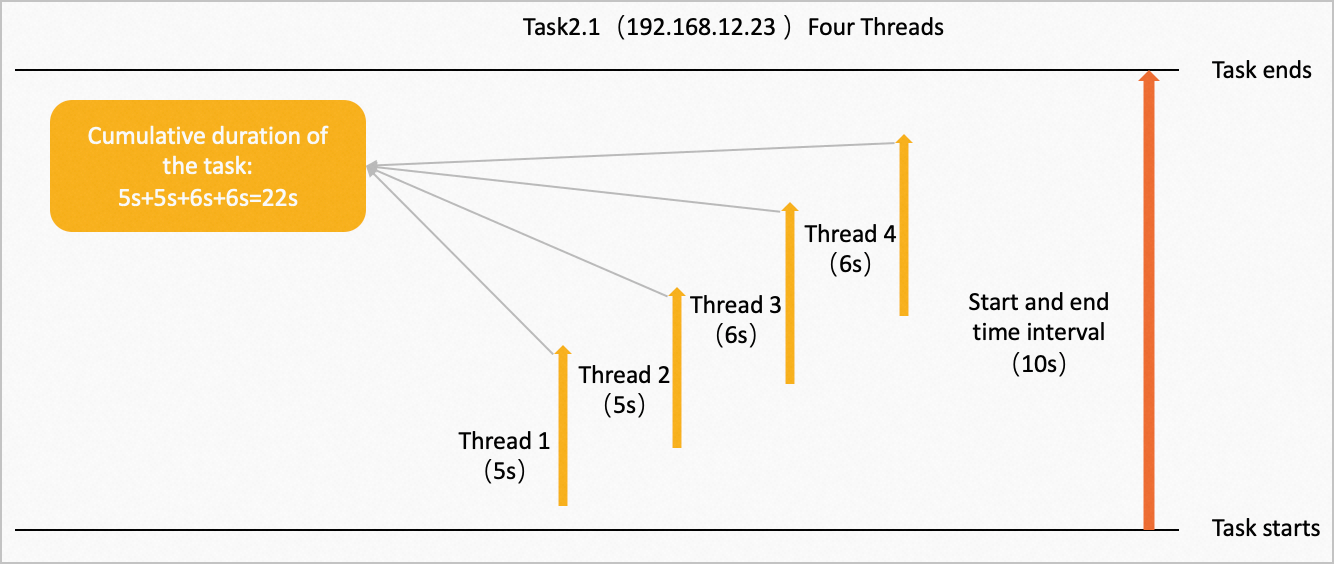
A duração acumulada da task é a soma dos tempos de execução de todas as threads: 5 + 5 + 6 + 6 = 22s.
O intervalo entre o horário de início e término é de 10s.
A razão de tempo de computação é (duração acumulada / concorrência da subtask) / intervalo entre o horário de início e término: (22s / 4) / 10s = 0,55.
APIs relacionadas
|
API |
Descrição |
|
Obtém os detalhes de execução de uma instrução SQL. |
|
|
Obtém os detalhes de execução de subtasks distribuídas para um ID de consulta e ID de stage especificados. |