Quando os campos GROUP BY têm alta cardinalidade — como número de celular ou ID de usuário — a agregação em duas etapas padrão do AnalyticDB for MySQL executa trabalho desnecessário. A agregação parcial realiza cálculos de hash, deduplicação e funções de agregação, mas produz quase tantas linhas quanto recebe e não reduz o volume de dados enviado pela rede. Use a dica /*+ aggregation_path_type=single_agg*/ para ignorar a agregação parcial e eliminar essa sobrecarga.
Funcionamento da agregação em duas etapas
O AnalyticDB for MySQL é um serviço distribuído de data warehouse. Por padrão, ele executa uma consulta GROUP BY em duas etapas:
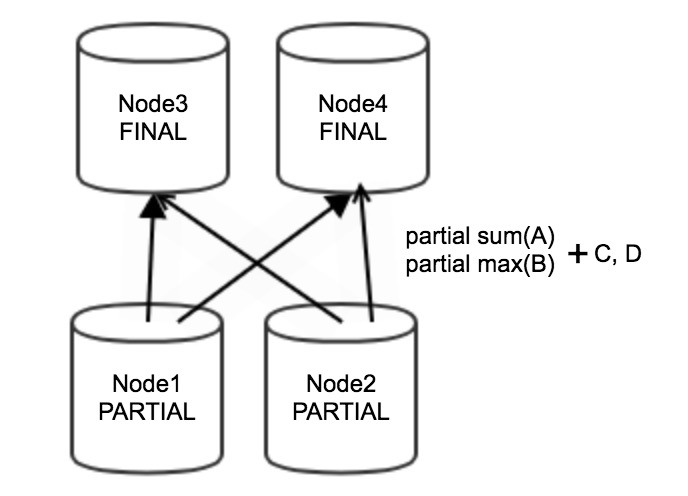
Agregação parcial — Os nós upstream (por exemplo, Node 1 e Node 2) executam a agregação parcial nos dados locais. Como esse processo é baseado em fluxo, os dados não se acumulam nos nós de agregação e o uso de memória permanece baixo. A agregação parcial reduz o volume de dados enviados pela rede aos nós downstream.
Redistribuição de dados e agregação final — Após a agregação parcial, os dados são redistribuídos entre os nós com base nos campos GROUP BY. Os nós downstream (por exemplo, Node 3 e Node 4) executam a agregação final. O nó de agregação final precisa manter todos os valores e dados de estado de agregação de cada grupo na memória até processar todas as linhas desse grupo, o que pode resultar em alto uso de memória. Para saber mais sobre como os dados se movem entre as etapas, consulte Fatores que afetam o desempenho da consulta.
Exemplo: A consulta a seguir agrupa dados por duas colunas e calcula um valor agregado por grupo:
SELECT sum(A), max(B) FROM tb1 GROUP BY C,D;O Node 1 e o Node 2 produzem resultados parciais — partial sum(A), partial max(B), C e D — e os enviam ao Node 3 e ao Node 4 para a agregação final.
Ignorar a agregação parcial para campos GROUP BY de alta cardinalidade
Quando aplicar esta otimização
A agregação em duas etapas é eficiente quando a agregação parcial reduz significativamente o número de linhas. Ela se torna um gargalo quando os campos GROUP BY têm alta cardinalidade (muitos valores únicos), como número de celular ou ID de usuário:
Condição: A taxa de agregação é baixa. A agregação parcial gera quase tantas linhas quanto recebe e não reduz o volume de dados enviado aos nós downstream.
Efeito: A etapa de agregação parcial ainda executa cálculos de hash, deduplicação e funções de agregação. Isso consome recursos computacionais sem diminuir o tráfego de rede.
Solução: Adicione a dica
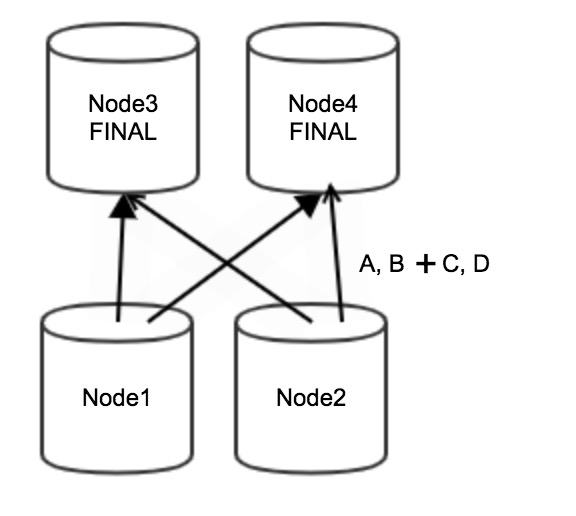
/*+ aggregation_path_type=single_agg*/para ignorar totalmente a agregação parcial. Todos os dados são enviados diretamente aos nós downstream para a agregação final, o que elimina a sobrecarga computacional desnecessária.
Aplicar a dica
Adicione a dica imediatamente após SELECT:
SELECT /*+ aggregation_path_type=single_agg*/ sum(A), max(B) FROM tb1 GROUP BY C,D;Após a aplicação da dica, o Node 1 e o Node 2 ignoram a agregação parcial. Todos os dados brutos (A, B, C e D) são redistribuídos diretamente ao Node 3 e ao Node 4 para a agregação final.
Compensações
|
Fator |
Agregação em duas etapas (padrão) |
Agregação única (dica) |
|
Mais indicado para |
Campos GROUP BY de baixa cardinalidade |
Campos GROUP BY de alta cardinalidade |
|
Uso de rede |
Menor — a agregação parcial reduz o volume de dados |
Maior — todos os dados brutos são redistribuídos |
|
Sobrecarga computacional |
Maior quando a taxa de agregação é baixa |
Menor — sem etapa de agregação parcial |
|
Memória no nó final |
Volume de dados menor, mas ainda mantido na memória |
Potencialmente alta — todas as linhas se acumulam |
Quando não utilizar esta otimização
Evite usar a dica nas seguintes situações:
Campos GROUP BY de baixa cardinalidade — Se houver poucos valores de grupo únicos, a agregação parcial reduz efetivamente o tráfego de rede. Ignorá-la desperdiça esse benefício.
Ambientes com restrição de memória — Esta dica não reduz o uso de memória no nó de agregação final. Quando a taxa de agregação é baixa, todos os dados se acumulam na memória dos nós downstream para deduplicação e agregação. Verifique se os nós downstream têm memória suficiente antes de aplicar a dica.
Observações de uso
A dica aplica-se a todas as consultas de agrupamento e agregação na instrução SQL, não apenas a operadores específicos.
Antes de adicionar a dica, revise o plano de execução para identificar quais operadores de agregação têm baixa taxa de agregação. Confirme se o benefício esperado supera o aumento da pressão de memória nos nós de agregação final.