O AHPA utiliza dados de utilização de GPU do Prometheus Adapter, combinados com tendências históricas de carga e algoritmos de previsão, para estimar as necessidades futuras de recursos de GPU. Ele ajusta automaticamente o número de réplicas de pods ou aloca recursos de GPU para escalar horizontalmente antes que os recursos fiquem limitados e reduzir a escala quando estiverem ociosos. Essa abordagem reduz custos e melhora a eficiência do cluster.
Pré-requisitos
Crie um cluster de GPU gerenciado. Para mais informações, consulte Add GPU nodes to a cluster.
Instale o componente AHPA e configure a source das métricas. Para mais informações, consulte Elastic scaling prediction (AHPA).
Ative o monitoramento do Prometheus e garanta a coleta de pelo menos sete dias de dados históricos da aplicação (GPU) no Prometheus. Para mais informações, consulte Connect to and configure Alibaba Cloud Prometheus monitoring.
Como funciona
Na computação de alto desempenho (HPC), especialmente no treinamento e na inferência de modelos de deep learning, o gerenciamento granular e o ajuste dinâmico de recursos de GPU aumentam a utilização e reduzem custos. O Container Service for Kubernetes oferece suporte ao dimensionamento elástico com base em métricas de GPU. Use o Prometheus para coletar métricas essenciais de GPU, como utilização em tempo real e uso de memória da GPU. Em seguida, utilize o Prometheus Adapter para transformar essas métricas em um formato compatível com Kubernetes e integrá-las ao AHPA. O AHPA usa esses dados, juntamente com tendências históricas de carga e algoritmos de previsão, para estimar as necessidades futuras de recursos de GPU e ajustar automaticamente o número de réplicas de pods ou a alocação de recursos de GPU. Isso garante que o scale-out ocorra antes que os recursos fiquem limitados e que o scale-in aconteça rapidamente quando os recursos estiverem ociosos, reduzindo custos e melhorando a eficiência do cluster.
Etapa 1: Implantar o Metrics Adapter
-
Obtenha o endpoint interno da API HTTP.
Faça login no console do ARMS.
No painel de navegação à esquerda, escolha .
Na página Instances, selecione a região onde seu cluster Container Service for Kubernetes está localizado.
Clique no nome da instância do Prometheus de destino. No painel de navegação à esquerda, clique em Settings para obter o endpoint interno em http API address.
-
Implante o ack-alibaba-cloud-metrics-adapter.
Faça login no console do ACK. No painel de navegação à esquerda, clique em .
Na página Marketplace, clique na aba App Catalog, pesquise por ack-alibaba-cloud-metrics-adapter e clique nele.
Na página ack-alibaba-cloud-metrics-adapter, clique em Quick Deployment no canto superior direito.
No assistente de Basic Information, selecione seu Cluster e Namespace, depois clique em Next.
-
No assistente de Parameters, selecione uma Chart Version. Na seção Parameter, defina o endpoint interno da API HTTP obtido na Etapa 1 como valor para
prometheus.urle clique em OK.prometheus: enabled: true url: http://
Etapa 2: Implementar a previsão elástica do AHPA com base em métricas de GPU
Este tópico implanta um service de inferência de modelo em uma GPU e envia solicitações continuamente para ele. O AHPA realiza a previsão elástica com base na utilização da GPU.
-
Implante o service de inferência.
-
Execute o comando a seguir para implantar o service de inferência.
-
Execute o comando a seguir para verificar o status dos pods.
kubectl get pods -o wideSaída esperada:
NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES bert-intent-detection-7b486f6bf-f**** 1/1 Running 0 3m24s 10.15.1.17 cn-beijing.192.168.94.107 <none> <none> -
Execute o comando a seguir para chamar o service de inferência e verificar a implantação.
Use o comando
kubectl get svc bert-intent-detection-svcpara obter o endereço IP do nó de GPU e substitua47.95.XX.XXno comando a seguir.curl -v "http://47.95.XX.XX/predict?query=Music"Saída esperada:
*   Trying 47.95.XX.XX...
* TCP_NODELAY set
* Connected to 47.95.XX.XX (47.95.XX.XX) port 80 (#0)
> GET /predict?query=Music HTTP/1.1
> Host: 47.95.XX.XX
> User-Agent: curl/7.64.1
> Accept: */*
>
* HTTP 1.0, assume close after body
< HTTP/1.0 200 OK
< Content-Type: text/html; charset=utf-8
< Content-Length: 9
< Server: Werkzeug/1.0.1 Python/3.6.9
< Date: Wed, 16 Feb 2022 03:52:11 GMT
<
* Closing connection 0
PlayMusic #Intent recognition result.
Se a solicitação HTTP retornar o código de status
200e um resultado de reconhecimento de intenção, o service de inferência foi implantado com sucesso.
-
-
Configure o AHPA.
Este exemplo utiliza a utilização de GPU. O scale-out é acionado quando a utilização da GPU de um pod excede 20%.
-
Configure a source de métricas do AHPA.
-
Crie um arquivo chamado application-intelligence.yaml com o seguinte conteúdo.
prometheusUrldefine o endpoint para o Alibaba Cloud Prometheus. Use o endpoint interno obtido na Etapa 1.apiVersion: v1 kind: ConfigMap metadata: name: application-intelligence namespace: kube-system data: prometheusUrl: "http://cn-shanghai-intranet.arms.aliyuncs.com:9090/api/v1/prometheus/da9d7dece901db4c9fc7f5b*******/1581204543170*****/c54417d182c6d430fb062ec364e****/cn-shanghai" -
Execute o comando a seguir para implantar o application-intelligence.
kubectl apply -f application-intelligence.yaml
-
-
Implante o AHPA.
-
Crie um arquivo chamado fib-gpu.yaml com o seguinte conteúdo.
O modo está definido como
observer. Para mais informações sobre parâmetros, consulte metric description. -
Execute o comando a seguir para implantar o AHPA.
kubectl apply -f fib-gpu.yaml -
Execute o comando a seguir para verificar o status do AHPA.
kubectl get ahpaSaída esperada:
NAME             STRATEGY   REFERENCE               METRIC   TARGET(%)   CURRENT(%)   DESIREDPODS   REPLICAS   MINPODS   MAXPODS   AGE
fib-gpu          observer   bert-intent-detection   gpu      20          0          0            1          10        50        6d19h
A saída esperada mostra que
CURRENT(%)é0eTARGET(%)é20. Isso significa que a utilização atual da GPU é de 0%. O scale-out elástico é acionado quando a utilização da GPU excede 20%.
-
-
-
Teste o dimensionamento elástico do service de inferência.
-
Execute o comando a seguir para acessar o service de inferência.
-
Enquanto acessa o service, execute o comando a seguir para verificar o status do AHPA.
kubectl get ahpaSaída esperada:
NAME             STRATEGY   REFERENCE               METRIC   TARGET(%)   CURRENT(%)   DESIREDPODS   REPLICAS   MINPODS   MAXPODS   AGE
fib-gpu          observer   bert-intent-detection   gpu      20          189          10            4          10        50        6d19h
A saída esperada mostra que a utilização atual da GPU
CURRENT(%)excede o valor deTARGET(%). O dimensionamento elástico é acionado e o número desejado de podsDESIREDPODSé10. -
Execute o comando a seguir para visualizar a tendência de previsão.
kubectl get --raw '/apis/metrics.alibabacloud.com/v1beta1/namespaces/default/predictionsobserver/fib-gpu'|jq -r '.content' |base64 -d > observer.htmlA figura a seguir mostra um exemplo de tendência de previsão com base em sete dias de métricas históricas de GPU:
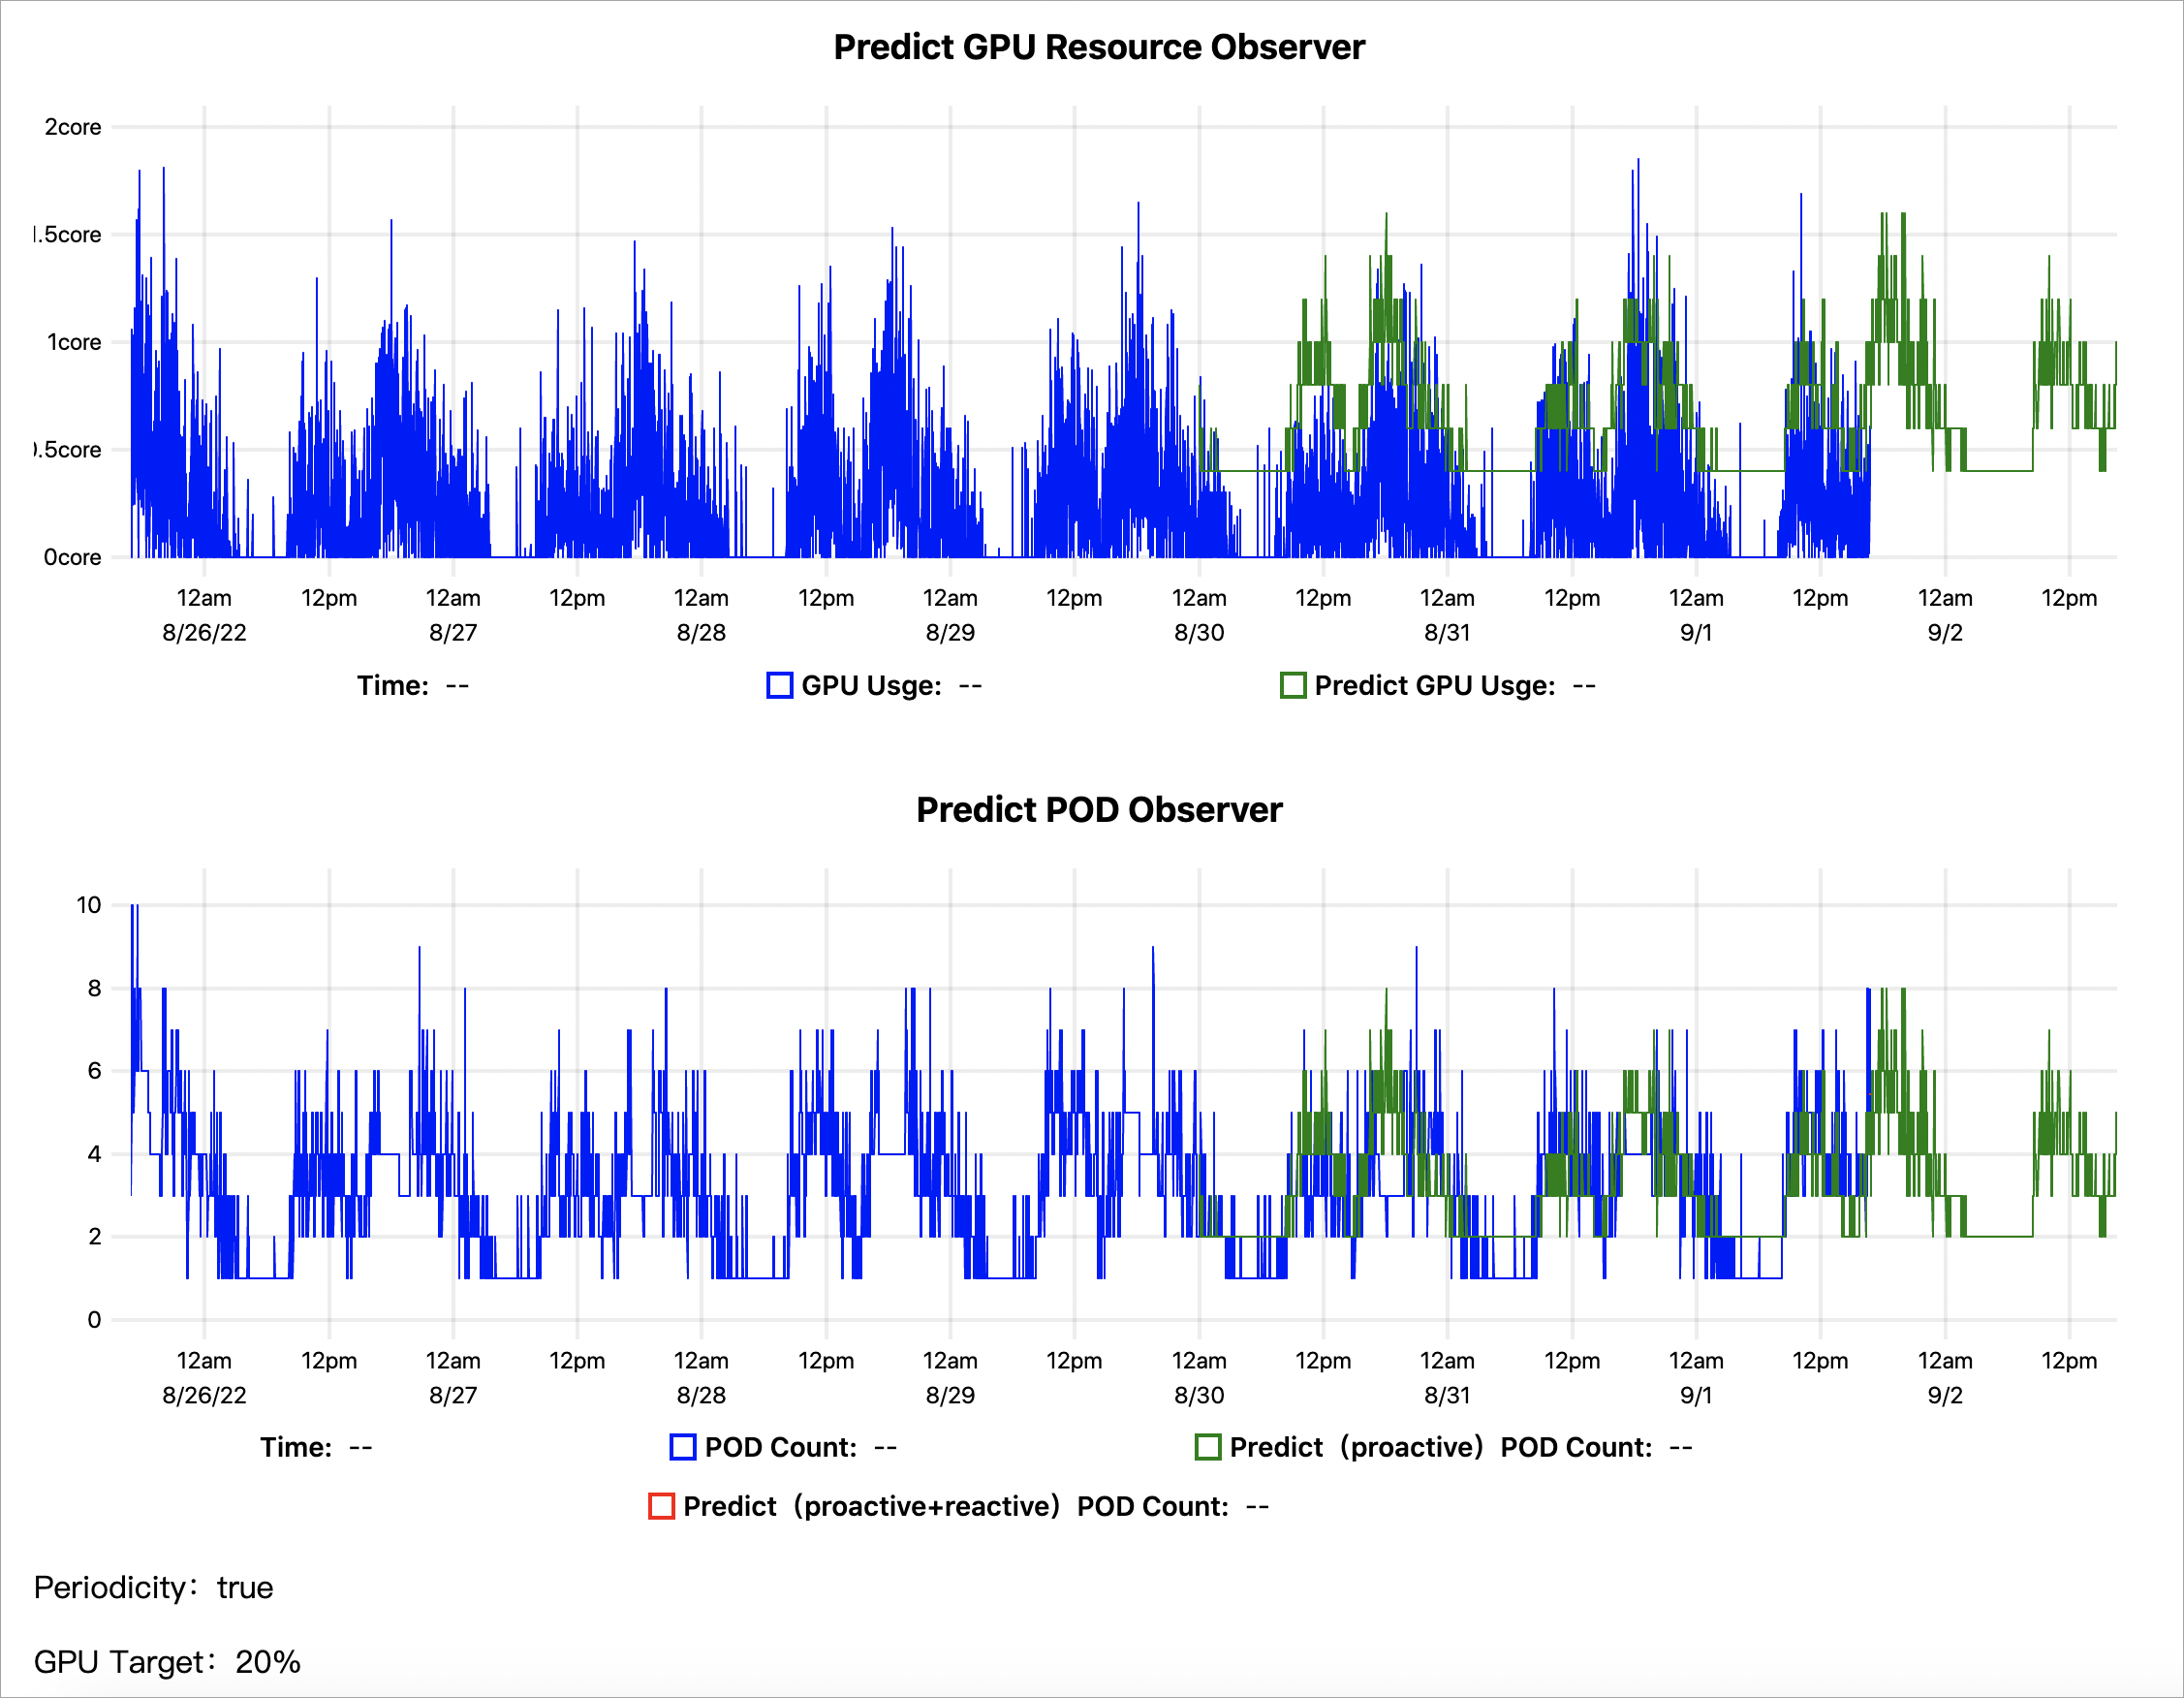
Predict GPU Resource Observer: A linha azul mostra o uso real da GPU. A linha verde mostra o uso da GPU previsto pelo AHPA. A curva verde está majoritariamente acima da curva azul, indicando que a capacidade de GPU prevista é suficiente.
Predict POD Observer: A linha azul mostra o número real de pods escalados. A linha verde mostra o número de pods previstos pelo AHPA. A curva verde está majoritariamente abaixo da curva azul, indicando que o AHPA prevê menos pods. Defina o modo de dimensionamento elástico como
autopara usar a contagem prevista de pods, o que economiza recursos e evita desperdício.
Os resultados da previsão atendem às expectativas. Após a observação, se os resultados continuarem satisfatórios, defina o modo de dimensionamento elástico como
autopara que o AHPA gerencie o dimensionamento.
-
Referências
O Knative Serverless oferece suporte aos recursos elásticos do AHPA (Advanced Horizontal Pod Autoscaler). Quando as necessidades de recursos da aplicação são periódicas, a previsão elástica pré-aquece os recursos e resolve problemas de cold start no Knative. Para mais informações, consulte Use AHPA elastic prediction in Knative.
Em muitos cenários, as aplicações precisam dimensionar com base em métricas personalizadas, como QPS de solicitações HTTP ou tamanho da fila de mensagens. O AHPA fornece um mecanismo de External Metrics. Combinado com o componente alibaba-cloud-metrics-adapter, ele oferece opções de dimensionamento mais ricas. Para mais informações, consulte Configure custom metrics with AHPA to scale applications.