Este tópico aborda o fluxo de diagnóstico, métodos de solução de problemas, verificações comuns e soluções para problemas relacionados ao Nginx Ingress.
Índice
|
Categoria |
Conteúdo |
|
Processo de diagnóstico |
|
|
Abordagens de solução de problemas |
|
|
Métodos comuns de solução de problemas |
|
|
Problemas comuns e soluções |
|
Informações básicas
A comunidade Kubernetes mantém o Ingress NGINX Controller oficial. O Nginx Ingress Controller no ACK utiliza a versão da comunidade e oferece suporte a todas as anotações da comunidade.
Implante um Nginx Ingress Controller no cluster para analisar as regras de encaminhamento do Ingress. O controller recebe solicitações, compara-as com as regras e as encaminha para os pods do Service de backend. A relação entre um Service, um Nginx Ingress e o Nginx Ingress Controller é a seguinte:
Um Service abstrai um ou mais serviços de backend idênticos.
Um Nginx Ingress define regras de proxy reverso que roteiam solicitações HTTP/HTTPS para pods do Service com base no host e no caminho da URL.
O Nginx Ingress Controller analisa as regras do Nginx Ingress. Quando um Ingress é alterado, o controller atualiza suas regras de encaminhamento e roteia as solicitações recebidas para o pod do Service apropriado.
O Nginx Ingress Controller recupera alterações do Ingress no API Server, gera arquivos de configuração do balanceador de carga (como nginx.conf) e recarrega o balanceador de carga (por exemplo, nginx -s reload) para aplicar as novas regras de roteamento.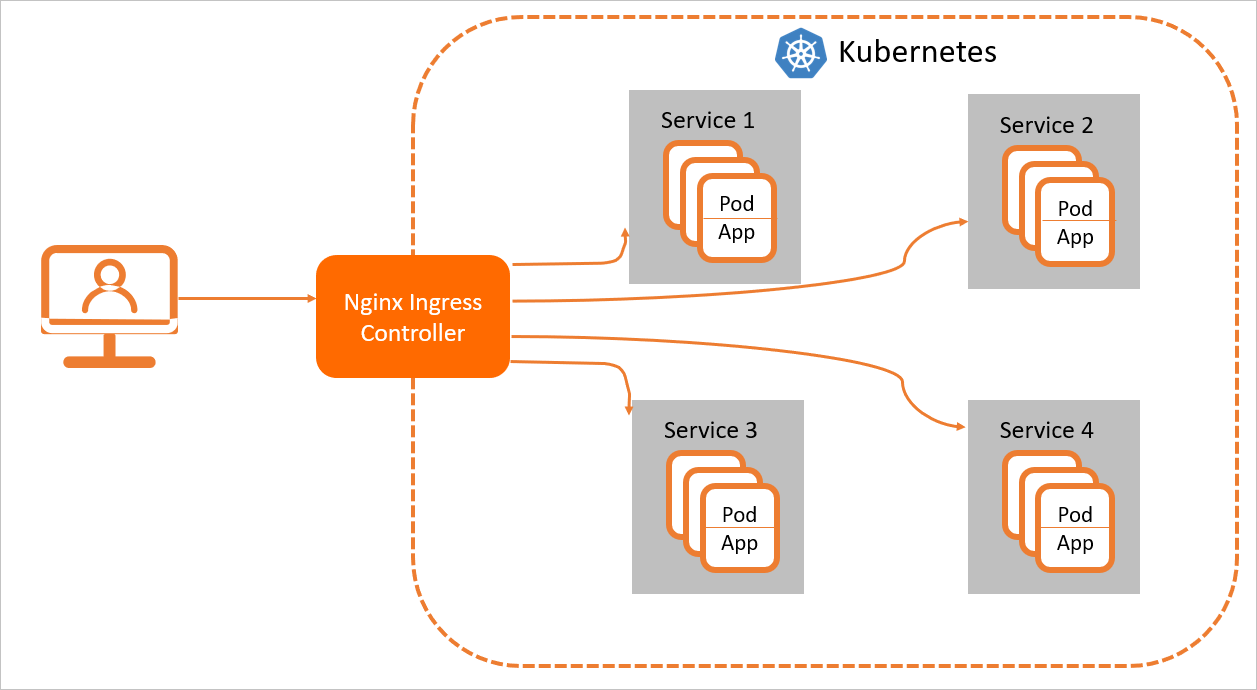
Fluxo de solução de problemas
-
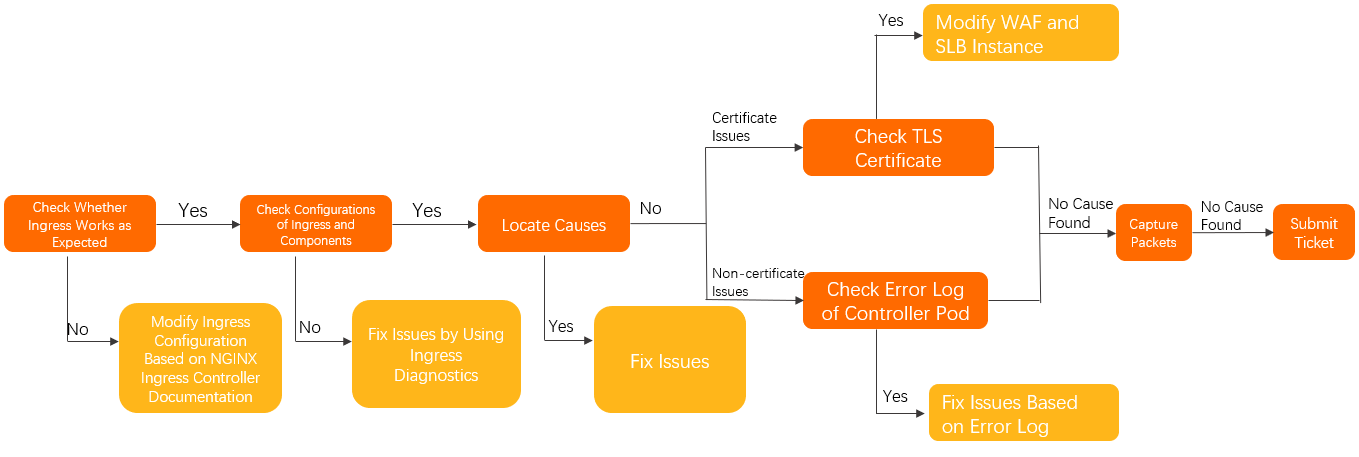
Siga estas etapas para isolar o problema no Ingress e verificar a configuração do seu ingress controller.
No Pod do controller, confirme se o acesso funciona conforme o esperado. Para obter mais informações, consulte Manually access the Ingress and backend Pods in the controller Pod.
Verifique se você está usando o NGINX Ingress Controller corretamente. Para obter mais informações, consulte a documentação da comunidade do NGINX Ingress Controller.
Use o recurso de diagnóstico do Ingress para verificar as configurações do Ingress e dos componentes e aplique as alterações recomendadas. Para obter instruções detalhadas, consulte Use the Ingress diagnostic feature.
Siga o troubleshooting guide para diagnosticar e resolver o problema.
-
Se as etapas anteriores não resolverem o problema, execute as seguintes verificações:
-
Para problemas com certificados TLS:
-
Verifique se a integração com WAF ou WAF transparente está ativada para o nome de domínio.
Em caso afirmativo, garanta que nenhum certificado TLS esteja configurado para a integração com WAF ou WAF transparente.
Caso contrário, prossiga para a próxima etapa.
-
Verifique se o SLB usa um listener de camada 7.
Em caso afirmativo, garanta que nenhum certificado TLS esteja configurado para o listener de camada 7.
Caso contrário, prossiga para a próxima etapa.
-
Para problemas não relacionados a certificados TLS, verifique o log de erros no Pod do controller. Para obter mais informações, consulte Check the error log in the controller Pod.
-
Se o problema persistir, realize uma captura de pacotes no Pod do controller e nos Pods da aplicação correspondente para identificar a causa raiz. Para obter mais informações, consulte Packet capture.
Solução de problemas
|
Área do problema |
Sintoma |
Solução |
|
Falha de acesso |
Um Pod dentro do cluster não consegue acessar um Ingress. |
Cannot access the external address of a cluster LoadBalancer from within the cluster |
|
Um Ingress não consegue acessar a si mesmo. |
||
|
Não é possível acessar serviços TCP ou UDP. |
||
|
Problemas de acesso HTTPS |
O Ingress serve um certificado desatualizado ou padrão. |
|
|
Ocorre um erro |
An "SSL_ERROR_RX_RECORD_TOO_LONG" error occurs during HTTPS access |
|
|
Problemas ao criar um resource Ingress |
Ocorre o erro "failed calling webhook...". |
A "failed calling webhook" error occurs when you create an Ingress resource |
|
Um Ingress é criado, mas não entra em vigor. |
||
|
Comportamento de acesso inesperado |
Não é possível obter o IP de origem do cliente. |
|
|
A lista de permissões de IP não entra em vigor ou não funciona conforme o esperado. |
||
|
Não é possível conectar-se a um service gRPC exposto por um Ingress. |
||
|
A versão canary não tem efeito. |
||
|
Regras canary incorretas roteiam o tráfego erroneamente. |
||
|
Ocorre o erro |
||
|
Ocorrem erros como 502, 503, 413 ou 499. |
||
|
Alguns resources falham ao carregar em uma página. |
Ocorre um erro 404 ao acessar resources com a anotação |
Some resources fail to load or a blank screen appears after a rewrite to the root directory |
|
Solicitações de resources retornam |
Métodos comuns de solução de problemas
Usar diagnósticos do Ingress
Faça login no ACK console. No painel de navegação à esquerda, clique em Clusters.
Na página Clusters, clique no nome do seu cluster. No painel de navegação à esquerda, clique em .
Na página Diagnostics, clique em Ingress diagnostics.
-
No painel Ingress diagnostics, clique em Diagnose, insira a URL onde o problema ocorre, como https://www.example.com. Selecione I have read and agree e clique em Start Diagnosis.
Após a conclusão do diagnóstico, resolva o problema com base nos resultados.
Visualizar logs do pod do controller no Log Service
O formato do log de acesso para o Ingress controller é definido em um ConfigMap. Por padrão, este é o ConfigMap nginx-configuration no namespace kube-system.
Por padrão, o Ingress controller do ACK usa o seguinte formato de log:
$remote_addr - [$remote_addr] - $remote_user [$time_local]
    "$request" $status $body_bytes_sent "$http_referer" "$http_user_agent" $request_length
    $request_time [$proxy_upstream_name] $upstream_addr $upstream_response_length
$upstream_response_time $upstream_status $req_id $host [$proxy_alternative_upstream_name]Se você modificar o formato de log, também deverá atualizar as regras de coleta de logs no Log Service. Caso contrário, os logs não poderão ser exibidos corretamente no console do Log Service. Tenha cuidado ao modificar o formato de log.
Os logs do Ingress controller estão disponíveis no Log Service console. Para obter detalhes, consulte Collect container logs from an ACK cluster.
Na aba Raw Logs do console do Log Service, cada entrada de log do Ingress controller é exibida como um par chave-valor. Além dos campos de acesso HTTP, cada entrada de log inclui campos de metadados do Kubernetes, como _container_name_, _namespace_ e _pod_name_.
Alguns nomes de campos no Log Service console diferem daqueles nos logs reais. A tabela a seguir lista os campos e suas descrições.
|
Campo |
Descrição |
|
|
O endereço IP real do cliente. |
|
|
As informações da solicitação, incluindo o método de solicitação, URL e versão HTTP. |
|
|
O tempo total da solicitação, medido desde o recebimento do primeiro byte do cliente até o envio do último byte da resposta. Esse valor pode ser afetado por fatores como as condições de rede do cliente e pode não representar a velocidade real de processamento da solicitação. |
|
|
O endereço do upstream de backend. Este campo estará vazio se a solicitação não conseguir alcançar um backend. Se a solicitação for tentada novamente em vários upstreams, seus endereços serão listados, separados por vírgulas. |
|
|
O código de status HTTP retornado pelo upstream de backend. Um código de status HTTP padrão indica que a resposta se originou do upstream de backend. Se nenhum backend estiver disponível, o valor será 502. Se a solicitação for tentada novamente em vários upstreams, seus códigos de status serão listados, separados por vírgulas (,). |
|
|
O tempo de resposta do upstream de backend, em segundos. |
|
|
O nome do upstream de backend. O formato de nomenclatura é |
|
|
O nome do upstream alternativo. Este campo não estará vazio se a solicitação for roteada para um upstream alternativo, como um service canary. |
Por padrão, você também pode visualizar logs de acesso recentes diretamente no container executando o seguinte comando:
kubectl logs <controller-pod-name> -n <namespace> | lessExemplo de saída:
42.11.**.** - [42.11.**.**]--[25/Nov/2021:11:40:30 +0800]"GET / HTTP/1.1" 200 615 "_" "curl/7.64.1" 76 0.001 [default-nginx-svc-80] 172.16.254.208:80 615 0.000 200 46b79dkahflhakjhdhfkah**** 47.11.**.**[]
42.11.**.** - [42.11.**.**]--[25/Nov/2021:11:40:31 +0800]"GET / HTTP/1.1" 200 615 "_" "curl/7.64.1" 76 0.001 [default-nginx-svc-80] 172.16.254.208:80 615 0.000 200 fadgrerthflhakjhdhfkah**** 47.11.**.**[]
Verificar logs de erros no pod do controller
Examine os logs no pod do Ingress controller para restringir um problema. Os logs de erro em um pod do controller são divididos em dois tipos:
-
Logs de erro do controller: Esses logs geralmente são gerados quando há um erro na configuração do Ingress. Execute o seguinte comando para filtrar logs de erro do controller:
kubectl logs <controller-pod-name> -n <namespace> | grep -E ^[WE]NotaQuando o Ingress controller inicia, ele pode gerar várias entradas de log de aviso (W). Isso é normal. Por exemplo, avisos sobre um kubeConfig ausente ou uma classe de Ingress não especificada não afetam a operação normal do Ingress controller e podem ser ignorados.
-
Logs de erro do Nginx: Esses logs são gerados quando ocorre um erro durante o processamento da solicitação. Execute o seguinte comando para filtrar logs de erro do Nginx:
kubectl logs <controller-pod-name> -n <namespace> | grep error
Acessar pods do Ingress e do backend
-
Execute o seguinte comando para obter um shell no pod do controller:
kubectl exec <controller-pod-name> -n <namespace> -it -- bash -
Ferramentas como curl e OpenSSL vêm pré-instaladas no pod. Use essas ferramentas para testar a conectividade e verificar as configurações de certificado.
-
Execute os seguintes comandos para testar o acesso ao backend através do Ingress:
# Replace your.domain.com with the domain name that you want to test. curl -H "Host: your.domain.com" http://127.0.0.1/ # for http curl --resolve your.domain.com:443:127.0.0.1 https://127.0.0.1/ # for https -
Execute o seguinte comando para verificar as informações do certificado:
openssl s_client -servername your.domain.com -connect 127.0.0.1:443 -
Acesse o pod do backend para verificar seu comportamento.
NotaO Ingress controller não acessa os pods do backend usando o IP do cluster do Service. Em vez disso, ele acessa os IPs dos pods diretamente.
-
Execute o seguinte comando para obter o endereço IP do pod do backend:
kubectl get pod -n <namespace> <pod-name> -o wideExemplo de saída:
NAME                      READY    STATUS    RESTARTS   AGE    IP            NODE                        NOMINATED NODE    READINESS GATES
nginx-dp-7f5fcc7f-****    1/1      Running   0          23h    10.71.0.146   cn-beijing.192.168.**.**    <none>            <none>
A saída indica que o endereço IP do pod do backend é 10.71.0.146.
-
Execute o seguinte comando no pod do controller para acessar o pod do backend e confirmar que a conexão está funcionando:
curl http://<your-pod-ip>:<port>/path
-
-
Comandos de solução de problemas do Nginx Ingress
-
kubectl-plugin
O Ingress controller oficial do Kubernetes era originalmente baseado no Nginx, mas mudou para OpenResty na versão 0.25.0. O controller observa alterações nos resources do Ingress no API server, gera automaticamente a configuração correspondente do Nginx e recarrega o Nginx para aplicar as alterações. Para obter mais informações, consulte a documentação oficial.
À medida que os resources do Ingress crescem, todas as configurações são consolidadas em um único e extenso arquivo nginx.conf, que se torna difícil de depurar. Desde a versão 0.14.0, a seção upstream é gerada dinamicamente usando lua-resty-balancer, aumentando ainda mais a complexidade da depuração. Para resolver isso, a comunidade contribuiu com um plugin kubectl, ingress-nginx, para simplificar o processo de depuração das configurações do ingress-nginx. Para obter mais informações, consulte kubectl-plugin.
Execute o seguinte comando para recuperar informações sobre os services de backend atualmente conhecidos pelo controller ingress-nginx:
kubectl ingress-nginx backends -n ingress-nginx -
Comando dbg
Além do plugin kubectl, use o comando
dbgpara visualizar informações e realizar diagnósticos.-
Execute o seguinte comando para obter um shell no container do Nginx Ingress:
kubectl exec -it -n kube-system <nginx-ingress-pod-name> -- bash -
Execute
/dbgpara visualizar uma saída semelhante à seguinte:nginx-ingress-controller-69f46d8b7-qmt25:/$ /dbg dbg is a tool for quickly inspecting the state of the nginx instance Usage: dbg [command] Available Commands: backends Inspect the dynamically-loaded backends information certs Inspect dynamic SSL certificates completion Generate the autocompletion script for the specified shell conf Dump the contents of /etc/nginx/nginx.conf general Output the general dynamic lua state help Help about any command Flags: -h, --help help for dbg --status-port int Port to use for the lua HTTP endpoint configuration. (default 10246) Use "dbg [command] --help" for more information about a command.
Verifique se existe um certificado para um nome de domínio específico.
/dbg certs get <hostname>Liste todas as informações dos services de backend.
/dbg backends all -
Status do Nginx Ingress
O Nginx fornece um endpoint de status integrado que gera estatísticas de tempo de execução. No container do Nginx Ingress, use curl para acessar o endpoint nginx_status na porta 10246 e visualizar estatísticas de solicitações e conexões.
-
Execute o seguinte comando para obter um shell no container do Nginx Ingress:
kubectl exec -itn kube-system <nginx-ingress-pod-name> bash -
Execute o seguinte comando para visualizar as estatísticas atuais de solicitações e conexões do Nginx:
nginx-ingress-controller-79c5b4d87f-xxx:/etc/nginx$ curl localhost:10246/nginx_status
Active connections: 12818
server accepts handled requests
 22717127 22717127 823821421
Reading: 0 Writing: 382 Waiting: 12483
Desde a inicialização, o Nginx lidou com 22.717.127 conexões e processou 823.821.421 solicitações, com uma média de cerca de 36,2 solicitações por conexão.
Active connections: O número total de conexões ativas. Neste exemplo, o valor é 12.818.
Reading: O número de conexões onde o Nginx está lendo cabeçalhos de solicitação. Neste exemplo, o valor é 0.
Writing: O número de conexões onde o Nginx está enviando respostas. Neste exemplo, o valor é 382.
Waiting: O número de conexões keep-alive. Neste exemplo, o valor é 12.483.
Captura de pacotes
Se não for possível determinar a causa de um problema, realize uma captura de pacotes.
Com base nas descobertas iniciais, determine se o problema de rede está no pod do Ingress ou no pod da aplicação. Se não houver informações suficientes, capture pacotes em ambos os pods.
Faça login no nó que hospeda o pod da aplicação ou o pod do Ingress afetado.
-
Na instância ECS (não dentro de um container), execute o seguinte comando para capturar tráfego relacionado a um pod específico e salvá-lo em um arquivo:
tcpdump -i any host <Ingress-pod-IP-or-application-pod-IP> -C 20 -W 200 -w /tmp/ingress.pcap Monitore os logs. Quando o erro esperado ocorrer, pare a captura de pacotes.
-
Correlacione as informações dos pacotes capturados com os logs de erro da aplicação para identificar o problema.
NotaEm circunstâncias normais, a captura de pacotes não afeta seus services. Ela adiciona apenas uma pequena carga de CPU e E/S de disco.
O comando anterior rotaciona os arquivos de captura. Ele pode gerar no máximo 200 arquivos .pcap, cada um com 20 MB de tamanho.
Falha no acesso intracluster ao endereço do balanceador de carga externo
Sintoma
Em um cluster, pods em alguns nós não conseguem acessar pods do backend através do endereço externo do Nginx Ingress Controller (o endereço IP da instância do balanceador de carga), enquanto pods em outros nós conseguem.
Causa
Esse problema é causado pela configuração externalTrafficPolicy do service do controller, que determina como o tráfego externo é tratado. Quando definida como Local, apenas pods do backend no mesmo nó que um pod do controller podem receber solicitações. Quando definida como Cluster, todos os pods do backend podem ser acessados normalmente. Quando resources dentro do cluster usam o endereço externo de um service de balanceador de carga, as solicitações também são tratadas como tráfego externo.
Solução
(Recomendado) Acesse o service de dentro do cluster Kubernetes usando seu ClusterIP ou nome do service. O nome do service para o ingress é
nginx-ingress-lb.kube-system.Execute o comando
kubectl edit svc nginx-ingress-lb -n kube-systempara editar o service do ingress. Altere oexternalTrafficPolicydo service de balanceador de carga paraCluster. Se o plugin de rede de container do cluster for Flannel, o IP de origem do cliente será perdido. Se você usar Terway, o IP de origem do cliente será preservado.
-
Para obter mais informações sobre anotações de service, consulte Configure Classic Load Balancer (CLB) by using annotations.
Exemplo:
apiVersion: v1
kind: Service
metadata:
  annotations:
    service.beta.kubernetes.io/backend-type: eni   # Direct to ENI.
  labels:
    app: nginx-ingress-lb
  name: nginx-ingress-lb
  namespace: kube-system
spec:
  externalTrafficPolicy: Cluster
Não é possível acessar o Ingress controller
Sintoma
Em um cluster Flannel, ao acessar o Ingress a partir de um pod do Ingress via nome de domínio, IP do SLB ou ClusterIP, algumas ou todas as solicitações falham.
Causa
A configuração padrão do Flannel desativa o hairpinning.
Solução
(Recomendado) Recrie o cluster com o plugin de rede Terway e migre suas cargas de trabalho para o novo cluster.
-
Se não for possível recriar o cluster, modifique a configuração do Flannel para ativar o
hairpinMode. Após modificar a configuração, recrie os pods do Flannel para aplicar as alterações.-
Execute o seguinte comando para editar a configuração do Flannel:
kubectl edit cm kube-flannel-cfg -n kube-system -
Na seção cni-conf.json da saída, adicione
"hairpinMode": trueao objetodelegate.Exemplo:
cni-conf.json: | { "name": "cb0", "cniVersion":"0.3.1", "type": "flannel", "delegate": { "isDefaultGateway": true, "hairpinMode": true } } -
Execute o seguinte comando para excluir os pods do Flannel. O sistema os recria automaticamente com a nova configuração.
kubectl delete pod -n kube-system -l app=flannel
-
Certificado TLS padrão ou antigo ainda é servido
Sintoma
Após adicionar ou modificar um Secret no cluster e especificar o secretName em um Ingress, as solicitações ainda são atendidas com o certificado padrão (Kubernetes Ingress Controller Fake Certificate) ou um certificado antigo.
Causa
O certificado não é retornado pelo ingress controller no cluster.
O controller não carregou o certificado corretamente porque ele é inválido.
O ingress controller usa Server Name Indication (SNI) para servir o certificado correto, mas o handshake TLS pode não incluir a extensão SNI.
Solução
-
Verifique se o handshake TLS inclui a extensão SNI usando um dos seguintes métodos:
Use um navegador moderno que ofereça suporte a SNI.
Ao testar o certificado com o comando
openssl s_client, inclua o parâmetro-servername.Ao usar
curl, mapeie o nome de domínio com o parâmetro--resolveou editando seu arquivo hosts, em vez de enviar uma solicitação para um endereço IP com um cabeçalhoHost.
Confirme que nenhum certificado TLS está configurado no WAF, acesso transparente do WAF ou listener de camada 7 do SLB. O certificado TLS deve ser retornado pelo ingress controller no cluster.
Execute diagnósticos do Ingress no console de Operações Inteligentes para verificar problemas de configuração e logs de erro. Para obter mais informações, consulte Use Ingress diagnostics.
-
Execute o seguinte comando para verificar manualmente os logs de erro do Pod do Ingress e faça alterações com base nas sugestões nos logs.
kubectl logs <ingress pod name> -n <pod namespace> | grep -E ^[EW]
Não é possível conectar-se ao gRPC via Ingress
Sintoma
Não é possível acessar um service gRPC através de um Ingress.
Causa
O resource Ingress não possui a Annotation para o protocolo de backend.
Services gRPC exigem uma conexão TLS quando expostos através de um Ingress.
Solução
Adicione a seguinte Annotation ao resource Ingress:
nginx.ingress.kubernetes.io/backend-protocol: "GRPC".Garanta que o cliente envie tráfego criptografado pela porta TLS.
Não é possível conectar-se ao service HTTPS do backend
Sintomas
Não é possível acessar o service HTTPS atrás do Ingress.
As solicitações podem retornar um código de status 400 com a mensagem
The plain HTTP request was sent to HTTPS port.
Causa
O Ingress controller envia solicitações HTTP para o Pod do backend por padrão.
Solução
Defina a seguinte anotação no seu resource Ingress: nginx.ingress.kubernetes.io/backend-protocol:"HTTPS".
Não é possível preservar o IP de origem nos pods do Ingress
Sintoma
O endereço IP de origem do cliente não é preservado no Pod do Ingress. Em vez disso, a aplicação recebe um endereço IP interno, como o IP do nó ou um endereço do intervalo 100.XX.XX.XX.
Causa
O
externalTrafficPolicydo Service que expõe o Ingress está definido comoCluster.A instância do Server Load Balancer (SLB) está configurada como um proxy de camada 7.
Um Web Application Firewall (WAF) ou um service WAF transparente está sendo usado.
Solução
-
Se o seu Service tiver
externalTrafficPolicydefinido comoClustere for exposto por uma instância SLB de camada 4:Altere
externalTrafficPolicyparaLocal. Essa alteração pode impedir que pods dentro do cluster acessem o Ingress através do endereço IP do SLB. Para obter uma solução, consulte Cannot access the external address of a cluster LoadBalancer from within the cluster. -
Se você usar um proxy de camada 7, como uma instância SLB de camada 7, WAF ou WAF transparente, siga estas etapas:
Garanta que seu proxy de camada 7 esteja configurado para adicionar o cabeçalho de solicitação X-Forwarded-For.
No ConfigMap do Ingress Controller (nginx-configuration no namespace kube-system por padrão), adicione
enable-real-ip: "true".Verifique os logs para confirmar que o IP de origem está preservado.
Se o caminho do tráfego envolver várias etapas de encaminhamento, como um service de proxy reverso adicional na frente do Ingress Controller, ative
enable-real-ipe verifique o valor do camporemote_addrnos logs. Isso ajuda a determinar se o container do Ingress recebe o endereço IP de origem do cliente no cabeçalho de solicitação X-Forwarded-For. Caso contrário, garanta que o endereço IP de origem seja adicionado à solicitação, por exemplo no cabeçalho X-Forwarded-For, antes que a solicitação chegue ao Ingress Controller.
Regra Canary falha ao entrar em vigor
Sintomas
Você configurou uma versão canary no cluster, mas a regra canary não entra em vigor.
Causa
Ao usar anotações
canary-*, a anotaçãonginx.ingress.kubernetes.io/canary: "true"não está definida.Para versões do Nginx Ingress Controller anteriores à 0.47.0, o campo
Hostna sua regra de Ingress deve conter o nome de domínio do seu service e não pode estar vazio.
Solução
Defina a anotação
nginx.ingress.kubernetes.io/canary: "true"ou defina o campo Host na sua regra de Ingress como o nome de domínio do seu service. Para obter mais informações, consulte Routing rules.Se esses cenários não se aplicarem, consulte Traffic is not distributed as configured in the canary release rule or traffic is routed to the canary service.
Tráfego inesperado é roteado para o service canary
Sintoma
Você configurou uma regra canary, mas o tráfego não é distribuído conforme especificado. Você também pode notar que o tráfego de outros ingresses padrão está sendo roteado para o service canary.
Causa
O Nginx Ingress Controller aplica uma regra canary não a um único ingress, mas a todos os ingresses que compartilham o mesmo service.
Para obter mais informações sobre esse comportamento, consulte Um ingress com uma regra canary afeta todos os ingresses que compartilham o mesmo service.
Solução
Para ativar uma versão canary para um ingress (incluindo aqueles que usam service-match e anotações canary-* relacionadas), crie services dedicados (um service estável e um service canary) que apontem para os pods existentes. Em seguida, ative a regra canary nesse ingress específico. Para obter mais informações, consulte Implement canary releases and blue-green deployments by using Nginx Ingress.
Erro ao criar um Ingress: "failed calling webhook"
Sintomas
Ao criar um resource Ingress, você recebe um erro "Internal error occurred: failed calling webhook...".
O código de erro completo é APISERVER_500. A mensagem detalhada é Internal error occurred: failed calling webhook "validate.nginx.ingress.kubernetes.io": Post https://ingress-nginx-controller-admission.kube-system.svc:443/networking/v1beta1/ingresses?timeout=10s: context deadline exceeded. A frase 'context deadline exceeded' indica a causa raiz: tempo limite de chamada do webhook.
Causa
Ao criar um resource Ingress, um Service — por padrão, ingress-nginx-controller-admission — deve validar sua configuração. Se um componente na cadeia de chamadas estiver indisponível (por exemplo, se o Service ou o Ingress Controller for excluído), a validação falhará e o API server rejeitará o resource Ingress.
Solução
Verifique a cadeia de chamadas do webhook para garantir que todos os resources necessários estejam em execução corretamente. A cadeia é: ValidatingWebhookConfiguration → Service → Pod.
Verifique se o Pod do Ingress Controller tem o recurso de admissão ativado e está acessível externamente.
Se o Ingress Controller for excluído ou se você não precisar da funcionalidade de webhook, exclua o resource ValidatingWebhookConfiguration.
Erro SSL_ERROR_RX_RECORD_TOO_LONG durante acesso HTTPS
Sintoma
Você recebe um erro ao acessar HTTPS: SSL_ERROR_RX_RECORD_TOO_LONG ou routines:CONNECT_CR_SRVR_HELLO:wrong version number.
Causa
A solicitação HTTPS é enviada para uma porta não HTTPS, como uma porta HTTP.
As causas comuns incluem:
A porta 443 no SLB está mapeada para a porta 80 no Pod do Ingress.
A porta 443 no Service do Ingress controller está mapeada para a porta 80 no Pod do Ingress.
Solução
Modifique as configurações do SLB ou do Service para rotear o tráfego HTTPS para a porta correta.
Códigos de erro HTTP comuns
Sintoma
As solicitações retornam erros não-2xx ou não-3xx, como 502, 503, 413 ou 499.
Causas e soluções
Verifique o log de acesso para determinar se o erro foi retornado pelo Ingress Controller. Para obter mais informações, consulte Use Log Service to view the access logs of an NGINX Ingress controller. Em caso afirmativo, veja as seguintes soluções:
-
Erro 413
Causa: O Nginx Ingress Controller funciona corretamente, mas o tamanho dos dados da solicitação excede o limite permitido.
Solução: Execute
kubectl edit cm -n kube-system nginx-configurationpara modificar a configuração do controller. Ajuste os valores denginx.ingress.kubernetes.io/client-max-body-sizeenginx.ingress.kubernetes.io/proxy-body-sizeconforme necessário (padrão:20m).
-
Erro 499
Causa: O cliente desconectou prematuramente. Isso não indica necessariamente um problema com o componente ou o service de backend.
-
Solução:
Um pequeno número de erros 499 pode ser normal e ignorado, dependendo da sua aplicação.
Se ocorrer um grande número de erros 499, verifique se o tempo de processamento do seu service de backend e o tempo limite de solicitação do lado do cliente estão configurados conforme o esperado.
-
Erro 502
Causa: O Nginx Ingress Controller funciona corretamente, mas o pod do Controller não consegue se conectar ao pod do backend de destino.
-
Solução:
-
Se o erro sempre ocorrer:
Configurações incorretas para o Service de backend ou pods podem causar esse erro. Verifique a configuração de porta do Service de backend e o código da aplicação no container.
-
Se o erro ocorrer intermitentemente:
Uma carga alta no pod do Nginx Ingress Controller pode causar esse erro. Avalie a carga verificando o número de solicitações e conexões na instância do balanceador de carga associada ao controller. Consulte Configure an NGINX Ingress controller for high-load scenarios para alocar mais resources ao controller.
Esse erro pode ocorrer se o pod do backend fechar ativamente a sessão. O Nginx Ingress Controller ativa conexões persistentes por padrão. Garanta que o período de tempo limite ocioso do backend para conexões persistentes seja maior que o período de tempo limite ocioso do controller (padrão: 900 segundos).
Se não for possível identificar o problema usando os métodos anteriores, realize uma captura de pacotes para análise.
-
-
Erro 503
Causa: O Ingress Controller não consegue encontrar nenhum pod de backend ou todos os pods de backend estão inacessíveis.
-
Solução:
-
Se o erro ocorrer intermitentemente:
Consulte as soluções para o erro 502.
Verifique o estado de prontidão do service de backend e configure verificações de integridade apropriadas.
-
Se o erro sempre ocorrer:
Verifique se o Service de backend está configurado corretamente e possui um endpoint.
-
-
O erro net::ERR_HTTP2_SERVER_REFUSED_STREAM
Sintomas
Alguns resources falham ao carregar e o console do desenvolvedor do navegador exibe o erro
net::ERR_HTTP2_SERVER_REFUSED_STREAMounet::ERR_FAILED.Causa
O número de solicitações simultâneas de resources excede o limite máximo de streams para uma conexão HTTP/2.
Solução
(Recomendado) No ConfigMap, aumente
http2-max-concurrent-streams(padrão: 128) para um valor apropriado para sua carga de trabalho. Para obter detalhes, consulte http2-max-concurrent-streams.Alternativamente, desative o suporte a HTTP/2 no ConfigMap definindo
use-http2comofalse. Para obter detalhes, consulte use-http2.
Erro: "The param of ServerGroupName is illegal"
Causa
ServerGroupName usa o formato
namespace+svcName+port. Um nome de grupo de servidores deve ter de 2 a 128 caracteres, começar com uma letra ou um caractere chinês e pode conter dígitos, pontos (.), sublinhados (_) e hífens (-).Solução
Modifique o nome do grupo de servidores para cumprir os requisitos de nomenclatura.
Erro de criação do Ingress: "certificate signed by unknown authority"
Ao criar um Ingress, o cluster retorna um erro com o código
APISERVER_500e a seguinte mensagem:Internal error occurred: failed calling webhook "validate.nginx.ingress.kubernetes.io": Post https://ingress-nginx-controller-admission.kube-system.svc:443/networking/v1beta1/ingresses?timeout=10s: x509: certificate signed by unknown authority.Causa
Esse erro ocorre se várias implantações de Ingress no seu cluster compartilharem resources como Secrets, services ou configurações de Webhook. Essa sobreposição de resources causa uma incompatibilidade de certificado SSL quando o Webhook de admissão se comunica com seu service de backend, levando a uma falha de validação.
Solução
Reimplante seus Ingresses e garanta que cada implantação use um conjunto exclusivo de resources. Para obter mais informações sobre os resources em uma implantação de Ingress, consulte What updates are performed when you upgrade Nginx Ingress Controller in ACK component management?.
Reinício do Pod do Ingress devido a falhas nas verificações de integridade
Sintoma
Falhas nas verificações de integridade fazem com que o Pod do controller seja reiniciado.
Causa
As verificações de integridade podem falhar se o Pod do Ingress ou seu nó estiver sob alta carga.
As verificações de integridade podem falhar se o parâmetro de kernel
tcp_tw_reuseoutcp_timestampsestiver definido nos nós do cluster.
Solução
Escale horizontalmente os Pods do Ingress e verifique se o problema foi resolvido. Para obter detalhes, consulte Deploying the Nginx Ingress Controller for high availability.
Desative o parâmetro de kernel
tcp_tw_reuseou defina-o como 2 e desative o parâmetro de kerneltcp_timestamps. Em seguida, verifique se o problema foi resolvido.
Adicionar services TCP e UDP
-
Adicione uma entrada ao ConfigMap
tcp-servicesouudp-services. Por padrão, esses ConfigMaps estão no namespaceingress-nginx.Por exemplo, para mapear a porta externa 9000 para a porta 8080 do service
example-gono namespacedefault:apiVersion: v1 kind: ConfigMap metadata: name: tcp-services namespace: ingress-nginx data: 9000: "default/example-go:8080" # Maps port 9000 to port 8080 of the service. Adicione a porta mapeada à definição do container na Implantação do Ingress. Por padrão, esta é a Implantação
nginx-ingress-controllerno namespaceingress-nginx.-
Adicione a porta mapeada ao Service que expõe o Ingress controller.
Para obter mais informações, consulte Exposing TCP and UDP services.
Regras do Ingress não entram em vigor
Sintoma
Você adiciona ou modifica uma regra do Ingress, mas ela não entra em vigor.
Possíveis causas
Um erro na configuração do Ingress impede que a nova regra do Ingress seja carregada corretamente.
O resource Ingress está configurado incorretamente.
O Ingress controller não possui as permissões necessárias para observar alterações nos resources do Ingress.
Um Ingress existente usa
server-aliaspara um nome de domínio, o que entra em conflito com o novo Ingress e faz com que a regra seja ignorada.
Soluções
Use a ferramenta de diagnóstico do Ingress no console de O&M Inteligente para diagnosticar o problema e siga as orientações na tela. Para obter mais informações, consulte Use the Ingress diagnostic feature.
-
Verifique os resources do Ingress existentes quanto a erros de configuração ou conflitos:
Se você usar uma expressão regular em um caminho que não possui a anotação
rewrite-target, garanta que a anotaçãonginx.ingress.kubernetes.io/use-regex: "true"esteja configurada.Verifique se o PathType está definido conforme o esperado. Por padrão,
ImplementationSpecificfunciona de forma idêntica aPrefix.
Garanta que o ClusterRole, ClusterRoleBinding, Role, RoleBinding e ServiceAccount associados ao Ingress controller existam. Por padrão, todos eles são nomeados ingress-nginx.
Entre no container do pod do controller e inspecione as regras adicionadas no arquivo nginx.conf.
-
Execute o seguinte comando para verificar manualmente os logs do container e identificar o problema.
kubectl logs <ingress pod name> -n <pod namespace> | grep -E ^[EW]
Reescrita de caminho causa falha de carregamento ou tela branca
Sintoma
Após usar a anotação
rewrite-targetdo Ingress para reescrever um caminho de acesso, alguns resources falham ao carregar ou uma tela branca aparece.Causa
A anotação
rewrite-targetnão está configurada com uma expressão regular.A aplicação usa caminhos absolutos codificados rigidamente para solicitar resources.
Solução
Configure a anotação
rewrite-targetcom uma expressão regular e um grupo de captura. Para obter mais informações, consulte Rewrite.Verifique se as solicitações do frontend usam o caminho correto.
Corrigir análise de logs do SLS após uma atualização
Sintoma
O componente ingress-nginx-controller possui duas versões principais: 0,20 e 0,30. Após atualizar o componente da versão 0,20 para a 0,30 usando Add-ons no console, o Ingress Dashboard exibe incorretamente informações de tráfego para o service de backend quando você usa versão canary ou implantação azul-verde.
Causa
As versões 0,20 e 0,30 usam formatos de log padrão diferentes. Como resultado, o Ingress Dashboard analisa incorretamente os logs quando você usa versão canary ou implantação azul-verde.
Solução
Para corrigir esse problema, atualize o
nginx-configuration configmape a configuraçãok8s-nginx-ingress.-
Atualize o
nginx-configuration configmap.-
Se você não modificou o
nginx-configuration configmap, salve o conteúdo a seguir comonginx-configuration.yamle executekubectl apply -f nginx-configuration.yaml.apiVersion: v1 kind: ConfigMap data: allow-backend-server-header: "true" enable-underscores-in-headers: "true" generate-request-id: "true" ignore-invalid-headers: "true" log-format-upstream: $remote_addr - [$remote_addr] - $remote_user [$time_local] "$request" $status $body_bytes_sent "$http_referer" "$http_user_agent" $request_length $request_time [$proxy_upstream_name] $upstream_addr $upstream_response_length $upstream_response_time $upstream_status $req_id $host [$proxy_alternative_upstream_name] max-worker-connections: "65536" proxy-body-size: 20m proxy-connect-timeout: "10" reuse-port: "true" server-tokens: "false" ssl-redirect: "false" upstream-keepalive-timeout: "900" worker-cpu-affinity: auto metadata: labels: app: ingress-nginx name: nginx-configuration namespace: kube-system -
Se você modificou o
nginx-configuration configmap, execute o seguinte comando para corrigir o problema sem sobrescrever sua configuração:kubectl edit configmap nginx-configuration -n kube-system
No final do campo
log-format-upstream, adicione[$proxy_alternative_upstream_name], salve e saia. -
-
Atualize a configuração
k8s-nginx-ingress.Salve o conteúdo a seguir como
k8s-nginx-ingress.yamle execute o comandokubectl apply -f k8s-nginx-ingress.yamlpara aplicar a configuração.
Erro: "cannot list/get/update resource"
Sintoma
Ao verificar erros em um Pod do controller conforme descrito em Check for error logs in a controller Pod, você pode encontrar um log de erro semelhante a este:
User "system:serviceaccount:kube-system:ingress-nginx" cannot list/get/update resource "xxx" in API group "xxx" at the cluster scope/ in the namespace "kube-system"Causa
O Nginx Ingress Controller não possui as permissões necessárias para atualizar os resources relevantes.
Solução
-
Verifique o log para determinar se um ClusterRole ou um Role está causando o problema.
Se o log contiver
at the cluster scope, o problema é causado pelo ClusterRole (ingress-nginx).O log contém
in the namespace "kube-system", indicando que o problema é causado pelo Role (kube-system/ingress-nginx).
-
Verifique se as permissões e vinculações necessárias existem.
-
Para um ClusterRole:
Garanta que o ClusterRole
ingress-nginxe o ClusterRoleBindingingress-nginxexistam. Se não existirem, crie-os, restaure-os de um backup ou desinstale e reinstale o componente.-
Garanta que o ClusterRole
ingress-nginxcontenha a permissão indicada no log (no exemplo abaixo, a permissão paralisto resourceingressesno grupo de APInetworking.k8s.io). Se a permissão estiver ausente, adicione-a manualmente ao ClusterRole.E0629 17:26:22.916137 8 reflector.go:138] k8s.io/client-go@v0.23.6/tools/cache/reflector.go:167: Failed to watch *v1.Ingress: failed to list *v1.Ingress: ingresses.networking.k8s.io is forbidden: User "system:serviceaccount:kube-system:ingress-nginx" cannot list resource "ingresses" in API group "networking.k8s.io" at the cluster scope
-
Para um Role:
Garanta que o Role
kube-system/ingress-nginxe o RoleBindingkube-system/ingress-nginxexistam. Se não existirem, crie-os, restaure-os de um backup ou desinstale e reinstale o componente.-
Garanta que o Role
ingress-nginxcontenha a permissão indicada no log (no exemplo abaixo, a permissãoupdatepara o ConfigMapingress-controller-leader-nginx). Se a permissão estiver ausente, adicione-a manualmente ao Role.E0629 17:07:09.111640 9 leaderelection.go:367] Failed to update lock: configmaps "ingress-controller-leader-nginx" is forbidden: User "system:serviceaccount:kube-system:ingress-nginx" cannot update resource "configmaps" in API group "" in the namespace "kube-system"
Falha no teste do arquivo de configuração
Sintoma
Ao verificar os logs do controller no pod conforme descrito em Check error logs in the controller pod, você pode encontrar um log de erro como o seguinte:
requeuing……nginx: configuration file xxx test failed (multiple lines)Causa
Um erro de configuração impede que o Nginx recarregue sua configuração. A causa geralmente é um erro de sintaxe em uma regra de ingress ou um snippet injetado no ConfigMap.
Solução
-
Verifique as mensagens de erro nos logs para identificar o problema. Ignore mensagens com nível
warn. Se uma mensagem de erro não for clara, use o arquivo e o número da linha do log para inspecionar o arquivo no pod. Por exemplo, o log a seguir mostra um erro no arquivo/tmp/nginx/nginx-cfg2825306115na linha 449.E0629 19:54:09.340338 8 queue.go:130] "requeuing" err=< ----------------------------------------------------------------------- Error: exit status 1 2022/06/29 19:54:09 [warn] 179#179: the "http2_max_field_size" directive is obsolete, use the "large_client_header_buffers" directive instead in /tmp/nginx/nginx-cfg2825306115:146 nginx: [warn] the "http2_max_field_size" directive is obsolete, use the "large_client_header_buffers" directive instead in /tmp/nginx/nginx-cfg2825306115:146 2022/06/29 19:54:09 [warn] 179#179: the "http2_max_header_size" directive is obsolete, use the "large_client_header_buffers" directive instead in /tmp/nginx/nginx-cfg2825306115:147 nginx: [warn] the "http2_max_header_size" directive is obsolete, use the "large_client_header_buffers" directive instead in /tmp/nginx/nginx-cfg2825306115:147 2022/06/29 19:54:09 [warn] 179#179: the "http2_max_requests" directive is obsolete, use the "keepalive_requests" directive instead in /tmp/nginx/nginx-cfg2825306115:148 nginx: [warn] the "http2_max_requests" directive is obsolete, use the "keepalive_requests" directive instead in /tmp/nginx/nginx-cfg2825306115:148 2022/06/29 19:54:09 [emerg] 179#179: unexpected "}" in /tmp/nginx/nginx-cfg2825306115:449 nginx: [emerg] unexpected "}" in /tmp/nginx/nginx-cfg2825306115:449 nginx: configuration file /tmp/nginx/nginx-cfg2825306115 test failedExecute os seguintes comandos para verificar a configuração ao redor da linha especificada quanto a erros.
# Log in to the pod.
kubectl exec -n <namespace> <controller pod name> -it -- bash
# View the file with line numbers to inspect the configuration around the error.
cat -n /tmp/nginx/nginx-cfg2825306115
Use a mensagem de erro e o arquivo de configuração para identificar e corrigir a configuração incorreta.
Erro: "Unexpected error validating SSL certificate"
Sintoma
Ao verificar os logs do pod do Controller conforme descrito em Check error logs in the controller pod, você pode encontrar logs de erro do controller semelhantes aos seguintes:
Unexpected error validating SSL certificate "xxx" for server "xxx"W0629 20:39:10.993206 7 controller.go:1364] Unexpected error validating SSL certificate "default/tls-secret" for server "test.example.com": x509: certificate is not valid for any names, but wanted to match test.example.com W0629 20:39:10.993238 7 controller.go:1365] Validating certificate against DNS names. This will be deprecated in a future version W0629 20:39:10.993252 7 controller.go:1370] SSL certificate "default/tls-secret" does not contain a Common Name or Subject Alternative Name for server "test.example.com": x509: certificate is not valid for any names, but wanted to match test.example.comCausa
Esse erro é causado por uma configuração incorreta de
certificate. Uma causa comum é uma incompatibilidade entre osdomain names configurados no resourceingresse osdomain names incluídos nocertificate. Alguns logs de nível de aviso, como umsubject alternative nameausente, podem não afetar a funcionalidade docertificate. Determine se isso é um problema real para o seu caso de uso.Solução
Use a mensagem de erro para verificar os seguintes problemas com o
certificateno seucluster.Verifique se o formato e o conteúdo do arquivo de
certificate(.crt) e do arquivo de chave privada (.key) estão corretos.Garanta que os
domain names nocertificate, como ocommon nameou umsubject alternative name, correspondam aodomain nameconfigurado no resourceingress.Verifique se o
certificateexpirou.
Arquivos de configuração residuais no controller
Sintoma
Versões do Nginx Ingress Controller anteriores à 1,10 possuem um bug conhecido. Normalmente, o controller limpa prontamente os arquivos
nginx-cfggerados. No entanto, se um erro em uma configuração do Ingress invalidar onginx.confrenderizado, o controller falha ao remover esses arquivos de configuração defeituosos. Esse acúmulo gradual de arquivosnginx-cfgxxxconsome espaço significativo em disco.1.6M nginx-cfg1093913015 1.6M nginx-cfg1093943092 1.6M nginx-cfg1093985057 1.6M nginx-cfg1093989258 1.6M nginx-cfg1094101515 1.6M nginx-cfg1094200269 1.6M nginx-cfg1094291268 1.6M nginx-cfg1094298834 1.6M nginx-cfg1094398542 0 nginx-cfg1094455202 1.6M nginx-cfg1094500903 1.6M nginx-cfg1094513787 1.6M nginx-cfg1094539327 1.6M nginx-cfg1094651267 0 nginx-cfg1094749495 0 nginx-cfg1094766605 1.6M nginx-cfg1094774347 1.6M nginx-cfg1094799028 1.6M nginx-cfg109483858 1.6M nginx-cfg1094903817 1.6M ...Causa
Uma falha na lógica de limpeza causa esse problema. O mecanismo de limpeza remove arquivos de configuração gerados corretamente, mas falha ao remover os inválidos, deixando-os no sistema. Para obter mais detalhes, consulte o Issue #11568 do GitHub da comunidade.
Solução
Para resolver esse problema, use uma das seguintes soluções.
Atualize o Nginx Ingress Controller para a versão 1,10 ou posterior. Para obter detalhes, consulte Upgrade Nginx Ingress Controller components.
Exclua periodicamente os arquivos
nginx-cfgxxxresiduais. Escreva um script para automatizar esse processo e reduzir o esforço manual.Valide novas configurações do Ingress antes de aplicá-las para evitar a geração de arquivos de configuração inválidos.
Pods presos em Pending após atualização do controller
Sintoma
Ao atualizar o Nginx Ingress Controller, os pods podem falhar ao serem agendados e permanecer no estado Pending por muito tempo.
Causa
Durante uma atualização do Nginx Ingress Controller, as regras padrão de afinidade de nó e anti-afinidade de pod podem impedir que novos pods sejam agendados. É necessário garantir que o cluster tenha resources disponíveis suficientes.
Execute os seguintes comandos para investigar a causa raiz:
kubectl -n kube-system describe pod <pending-pod-name>kubectl -n kube-system get eventsSolução
Tente uma das seguintes soluções.
Escale horizontalmente os resources do cluster: Adicione novos nós para atender aos requisitos de afinidade. Para obter mais informações, consulte Manually scale a node pool.
-
Ajuste a afinidade: Se os resources forem limitados, relaxe o requisito de anti-afinidade de pod executando o comando
kubectl edit deploy nginx-ingress-controller -n kube-system. Isso permite que os pods sejam agendados no mesmo nó, mas essa abordagem pode reduzir sua alta disponibilidade.
Confusão de stream TCP com múltiplos CLBs para Nginx Ingress
Sintomas
Em um cluster Container Service for Kubernetes (ACK) que usa Flannel CNI e o modo de rede IPVS, pode ocorrer uma confusão de stream TCP sob alta concorrência se o Nginx Ingress Controller estiver vinculado a vários Classic Load Balancers (CLBs). Capturas de pacotes podem revelar as seguintes anomalias.
Retransmissão de pacotes
Redefinição de conexão TCP
Nas capturas de pacotes do
ingress pod, filtrar porTCP streamno Wireshark revela retransmissões de pacotes e sinais de redefinição. A seguir está um exemplo da saída da análise de protocolo:Filter: tcp.stream eq 7517 Frame 197967: 2582 bytes on wire (20656 bits), 2582 bytes captured (20656 bits) Ethernet II, Src: 66:4b:c1:20:9a:0a (66:4b:c1:20:9a:0a), Dst: d6:79:26:1b:14:4d (d6:79:26:1b:14:4d) Internet Protocol Version 4, Src: 172.30.3.183, Dst: xxx Transmission Control Protocol, Src Port: 80, Dst Port: 1458, Seq: 1284522488, Ack: 173965101, Len: 2516 Selected packet (Frame 197967): Src: 172.30.3.183 -> Dst: xxx TCP Seq: 2516 Sequence number: 1284522488 Acknowledgement: 173965101 Timestamp value: 1789595929 Hex dump (partial): 0000 d6 79 26 1b 14 4d 66 4b c1 20 9a 0a 08 45 b0 0010 ... Info column shows multiple entries including: [ACK] Seq=xxx Ack=xxx [TCP Window Full] [TCP Retransmission] [RST]Causa
Em um cluster ACK configurado com o plugin de rede Flannel, os CLBs encaminham tráfego para a
NodePortnonodeonde o Nginx Ingress Controller está em execução. No entanto, quando váriosServicesusam diferentesNodePorts, podem ocorrer conflitos de sessão no IPVS sob alta concorrência.Solução
Use um único balanceador de carga: Crie apenas um
LoadBalancer Servicepara o Nginx Ingress Controller. Vincule manualmente outros CLBs àNodePortdo nó para reduzir a probabilidade de conflitos.Evite múltiplas NodePorts ativas: Em um único
node, evite ter váriasNodePortsativas para reduzir o risco de conflitos de sessão IPVS.
-