Esta página responde às perguntas mais comuns sobre o dimensionamento instantâneo de nós no Container Service for Kubernetes (ACK). Use as descrições de sintomas abaixo para ir diretamente à seção mais relevante para o seu problema.
Sintomas comuns:
Pods travados no estado
Pendingsem adição de novos nós — consulte Por que o dimensionamento instantâneo de nós falha ao adicionar nós?Nós não removidos após a redução das cargas de trabalho — consulte Por que o dimensionamento instantâneo de nós falha ao remover nós?
Dimensionamento de nós não acionado em cluster gerenciado — consulte Por que o dimensionamento de nós não funciona no meu cluster gerenciado ACK mesmo com a autorização de função concluída?
Limitações
Quais são as limitações conhecidas do dimensionamento instantâneo de nós?
Limitações de recurso:
O dimensionamento instantâneo de nós não oferece suporte ao modo rápido (swift mode).
Um pool de nós pode conter até 180 nós por lote de expansão.
Não é possível desativar a redução de escala no nível do cluster. Para proteger nós individuais contra remoção, consulte Como impedir que o dimensionamento instantâneo de nós remova nós específicos?
O dimensionamento instantâneo de nós não verifica o estoque de instâncias preemptíveis. Se o Billing Method de um pool de nós estiver definido como instâncias preemptíveis e a opção Use Pay-as-you-go Instances When Spot Instances Are Insufficient estiver ativada, o sistema provisionará uma instância pay-as-you-go mesmo quando houver estoque suficiente de instâncias preemptíveis.
Diferença na estimativa de recursos:
Os recursos disponíveis em um nó recém-provisionado podem ser ligeiramente inferiores às especificações listadas para o tipo de instância, pois o sistema operacional subjacente e os daemons do sistema consomem parte desses recursos. Para mais detalhes, consulte Por que o tamanho da memória de uma instância comprada é diferente do tamanho da memória definido em seu tipo de instância?
Devido a essa sobrecarga, as estimativas de recursos usadas pelo add-on podem ser um pouco maiores do que os recursos realmente alocáveis em um novo nó. Considere os pontos a seguir ao definir as solicitações de recursos dos pods:
Mantenha-se abaixo da capacidade total da instância. O total de recursos solicitados — CPU, memória e disco — deve ser menor que as especificações listadas para o tipo de instância. Como diretriz geral, mantenha as solicitações totais de recursos de um pod abaixo de 70% da capacidade do nó.
Considere os pods estáticos manualmente. O add-on considera apenas as solicitações de recursos de pods gerenciados pelo Kubernetes (pods pendentes e pods do DaemonSet). Se você executar pods estáticos fora do gerenciamento do DaemonSet, reserve capacidade para eles manualmente.
Teste pods grandes antecipadamente. Caso um pod solicite mais de 70% dos recursos de um nó, teste e confirme se ele pode ser agendado em um nó do mesmo tipo de instância antes de depender da expansão automática.
Tipos de recursos simuláveis limitados:
O dimensionamento instantâneo de nós consegue simular e avaliar apenas certos tipos de recursos ao decidir se deve expandir. Para a lista completa, consulte Quais tipos de recursos o dimensionamento instantâneo de nós pode simular?
Restrições de armazenamento:
O autoscaler não tem conhecimento das restrições de armazenamento no nível do pod, tais como:
Necessidade de execução em uma zona específica para acessar um volume persistente (PV).
Requisito de um nó que ofereça suporte a um tipo específico de disco, como ESSD.
Se sua carga de trabalho tiver essas dependências de armazenamento, configure um pool de nós dedicado antes de ativar o Auto Scaling nesse pool. Predefina a zona, o tipo de instância e o tipo de disco na configuração do pool de nós para garantir que os novos nós provisionados sempre atendam aos requisitos de armazenamento do pod.
Comportamento de expansão
Quais tipos de recursos o dimensionamento instantâneo de nós pode simular?
O dimensionamento instantâneo de nós avalia as decisões de expansão com base nos seguintes tipos de recursos:
cpu
memory
ephemeral-storage
aliyun.com/gpu-mem  # Shared GPUs only
nvidia.com/gpu
O dimensionamento instantâneo de nós seleciona o tipo de instância com o tamanho adequado para um pod?
Sim. O autoscaler escolhe o tipo de instância mais eficiente em termos de recursos que atenda às solicitações do pod.
Por exemplo, se um pool de nós contiver um tipo 4 vCPU / 8 GiB e um tipo 12 vCPU / 48 GiB, um pod que solicite 2 vCPU acionará o provisionamento de um nó 4 vCPU / 8 GiB. Se posteriormente você substituir o tipo 4 vCPU / 8 GiB por um tipo 8 vCPU / 16 GiB, o add-on se adaptará automaticamente e provisionará nós 8 vCPU / 16 GiB para solicitações futuras semelhantes.
Se um pool de nós tiver vários tipos de instância, como o dimensionamento instantâneo de nós escolhe qual provisionar?
O dimensionamento instantâneo de nós segue um processo de seleção em três etapas:
Filtragem por disponibilidade. O sistema identifica e exclui periodicamente tipos de instância com estoque insuficiente na região.
Ordenação por tamanho. Os tipos de instância restantes são classificados em ordem crescente pela contagem de vCPU.
Seleção da primeira correspondência. Começando pelo menor, o add-on verifica cada tipo em relação às solicitações de recursos do pod pendente e provisiona o primeiro tipo que as atenda. Tipos maiores não são avaliados depois que uma correspondência é encontrada.
Como monitorar a integridade do estoque dos tipos de instância no meu pool de nós?
O dimensionamento instantâneo de nós atualiza periodicamente o status do estoque para os tipos de instância em pools de nós com Auto Scaling ativado. Quando o status do estoque de um tipo de instância muda, o add-on emite um evento do Kubernetes chamado InstanceInventoryStatusChanged. Monitore esses eventos para acompanhar a disponibilidade e ajustar a configuração do pool de nós antes que ocorram falhas de expansão. Para mais detalhes, consulte Visualizar o status de integridade do dimensionamento instantâneo de nós.
Como reduzir o risco de falhas de expansão devido a estoque insuficiente?
Configure seu pool de nós com uma variedade maior de tipos de instância:
Adicione vários tipos de instância ao pool de nós ou use uma configuração de instância generalizada.
Ative várias zonas para o pool de nós.
Por que o dimensionamento instantâneo de nós falha ao adicionar nós?
Verifique as causas comuns a seguir:
Estoque insuficiente
Os tipos de instância no pool de nós estão sem estoque. Para diagnosticar, monitore os eventos InstanceInventoryStatusChanged ou verifique o status de integridade do pool de nós. Para resolver, adicione mais tipos de instância ou zonas. Consulte Como reduzir o risco de falhas de expansão devido a estoque insuficiente?
Tipo de instância muito pequeno para o pod
As solicitações de recursos do pod excedem o que a instância pode fornecer após a subtração da sobrecarga do sistema. A especificação listada da instância refere-se à capacidade bruta. O ACK reserva uma parte para processos de sistema do Kubernetes (kubelet, kube-proxy, Terway, runtime de contêiner e outros add-ons).
Para diagnosticar, compare as solicitações de recursos do pod com os recursos alocáveis do nó usando kubectl describe node <node-name> e verifique a seção Allocatable. Para detalhes sobre recursos reservados, consulte:
Autorização incompleta
O dimensionamento de nós requer autorização de função. Para diagnosticar, verifique se o token necessário (addon.aliyuncsmanagedautoscalerrole.token) existe em um Secret dentro do namespace kube-system. Para resolver, siga Ativar elasticidade instantânea para nós para concluir a configuração.
Nós anormais no pool de nós
O dimensionamento instantâneo de nós pausa a expansão quando o pool contém nós anormais, para preservar a estabilidade do sistema. Para diagnosticar, verifique se há nós em estado NotReady ou de erro usando kubectl get nodes. Resolva todos os nós anormais antes que a expansão seja retomada.
Como configurar recursos personalizados para um pool de nós com dimensionamento instantâneo ativado?
Adicione tags ECS com o seguinte prefixo ao pool de nós. O add-on lê essas tags para determinar os recursos personalizados disponíveis e seus valores.
É necessária a versão 0.2.18 ou posterior do ACK GOATScaler. Para atualizar, consulte Gerenciar add-ons .
Formato da tag:
goatscaler.io/node-template/resource/{resource-name}:{resource-size}Exemplo:
goatscaler.io/node-template/resource/hugepages-1Gi:2GiComportamento de redução
Por que o dimensionamento instantâneo de nós falha ao remover nós?
Os nós são protegidos contra redução em várias condições. Execute kubectl describe node <node-name> e revise os eventos ou anotações para identificar a causa.
Bloqueios relacionados a pods:
Limiar de redução não atingido. O total de solicitações de recursos dos pods no nó excede o limiar de redução configurado.
Presença de pods no kube-system. Pods em execução no namespace
kube-systembloqueiam a redução.Restrições obrigatórias de agendamento. Os pods possuem regras de afinidade ou topologia que impedem sua execução em outros nós.
PodDisruptionBudget (PDB) ativo. Os pods são regidos por um PodDisruptionBudget e a contagem mínima disponível já foi atingida.
Bloqueios no nível do nó:
A opção de reduzir apenas nós vazios está ativada, mas o nó não está vazio. Consulte É possível configurar o dimensionamento instantâneo de nós para reduzir apenas nós vazios?
O nó foi adicionado nos últimos 10 minutos. O add-on impõe um período de espera de 10 minutos após a entrada de um nó no pool antes que ele se torne elegível para redução.
Existem nós offline no pool. Um nó offline é uma instância ECS em execução que não possui um objeto de nó correspondente no Kubernetes. O add-on pausa a redução quando detecta nós offline. A versão 0.5.3 e posteriores incluem limpeza automática de nós offline. A versão 0.5.3 está em lançamento canário — envie um ticket para solicitar acesso. Para versões anteriores, exclua as instâncias ECS residuais manualmente. Para verificar se há nós offline: na página Node Pools, clique em Sync Node Pool e, em seguida, clique em Details. Na aba Nodes, procure por nós no estado offline. Para atualizar o add-on, consulte Add-ons.
Quais tipos de pods podem impedir que o dimensionamento instantâneo de nós remova um nó?
Pods não gerenciados por um controlador nativo do Kubernetes — como Deployment, ReplicaSet, Job ou StatefulSet — podem bloquear a redução. Pods que não podem ser encerrados com segurança ou migrados para outro nó também bloqueiam a redução.
Comportamento de dimensionamento personalizado
Como controlar o comportamento de redução por pod?
Use a anotação goatscaler.io/safe-to-evict no pod:
Para impedir a redução do nó: defina
"goatscaler.io/safe-to-evict": "false".Para permitir a redução do nó: defina
"goatscaler.io/safe-to-evict": "true".
Como forçar a exclusão de nós específicos durante uma redução?
Adicione o taint goatscaler.io/force-to-delete:true:NoSchedule ao nó de destino. Após adicionar esse taint, o dimensionamento instantâneo de nós exclui o nó imediatamente, sem verificar o status dos pods ou drená-los.
A exclusão forçada ignora a evicção de pods e pode causar interrupções de serviço ou perda de dados. Use com cautela.
Como impedir que o dimensionamento instantâneo de nós remova nós específicos?
Adicione a anotação "goatscaler.io/scale-down-disabled": "true" ao nó:
kubectl annotate node <nodename> goatscaler.io/scale-down-disabled=trueÉ possível configurar o dimensionamento instantâneo de nós para reduzir apenas nós vazios?
Sim. Configure isso no nível do nó ou no nível do cluster. As configurações no nível do nó têm precedência sobre as configurações no nível do cluster.
Configuração no nível do nó:
Adicione um rótulo ao nó específico:
Para ativar (reduzir apenas se estiver vazio):
goatscaler.io/scale-down-only-empty:truePara desativar (permitir redução com pods):
goatscaler.io/scale-down-only-empty:false
Configuração no nível do cluster:
No console do ACKconsole do ACK, acesse a página Add-ons.
Localize o ACK GOATScaler e siga as instruções na tela para definir
ScaleDownOnlyEmptyNodescomotrueoufalse.
O add-on de dimensionamento instantâneo de nós
O add-on de dimensionamento instantâneo de nós é atualizado automaticamente?
Não. O ACK não atualiza automaticamente o ACK GOATScaler, exceto durante manutenções gerais do sistema ou grandes atualizações da plataforma. Atualize-o manualmente na página Add-ons no console do ACKconsole do ACK.
Por que o dimensionamento de nós não funciona no meu cluster gerenciado ACK mesmo com a autorização de função concluída?
A causa mais provável é a ausência de um token. O dimensionamento de nós em clusters gerenciados pelo ACK depende de um token chamado addon.aliyuncsmanagedautoscalerrole.token em um Secret dentro do namespace kube-system. O ACK usa a Worker Role do cluster para autenticar operações de auto scaling e, se esse token estiver ausente, o dimensionamento falhará.
Para verificar, execute o comando a seguir e confira se o token existe:
kubectl get secret -n kube-system | grep addon.aliyuncsmanagedautoscalerrolePara corrigir isso, reaplique a política necessária por meio do assistente de autorização:
Na página Clusters, clique em Clusters. No painel de navegação à esquerda, escolha Nodes > Node Pools.
Na página Node Pools, clique em Enable ao lado de Node Scaling.
-
Siga as instruções na tela para autorizar a
KubernetesWorkerRolee anexar a política de sistemaAliyunCSManagedAutoScalerRolePolicy.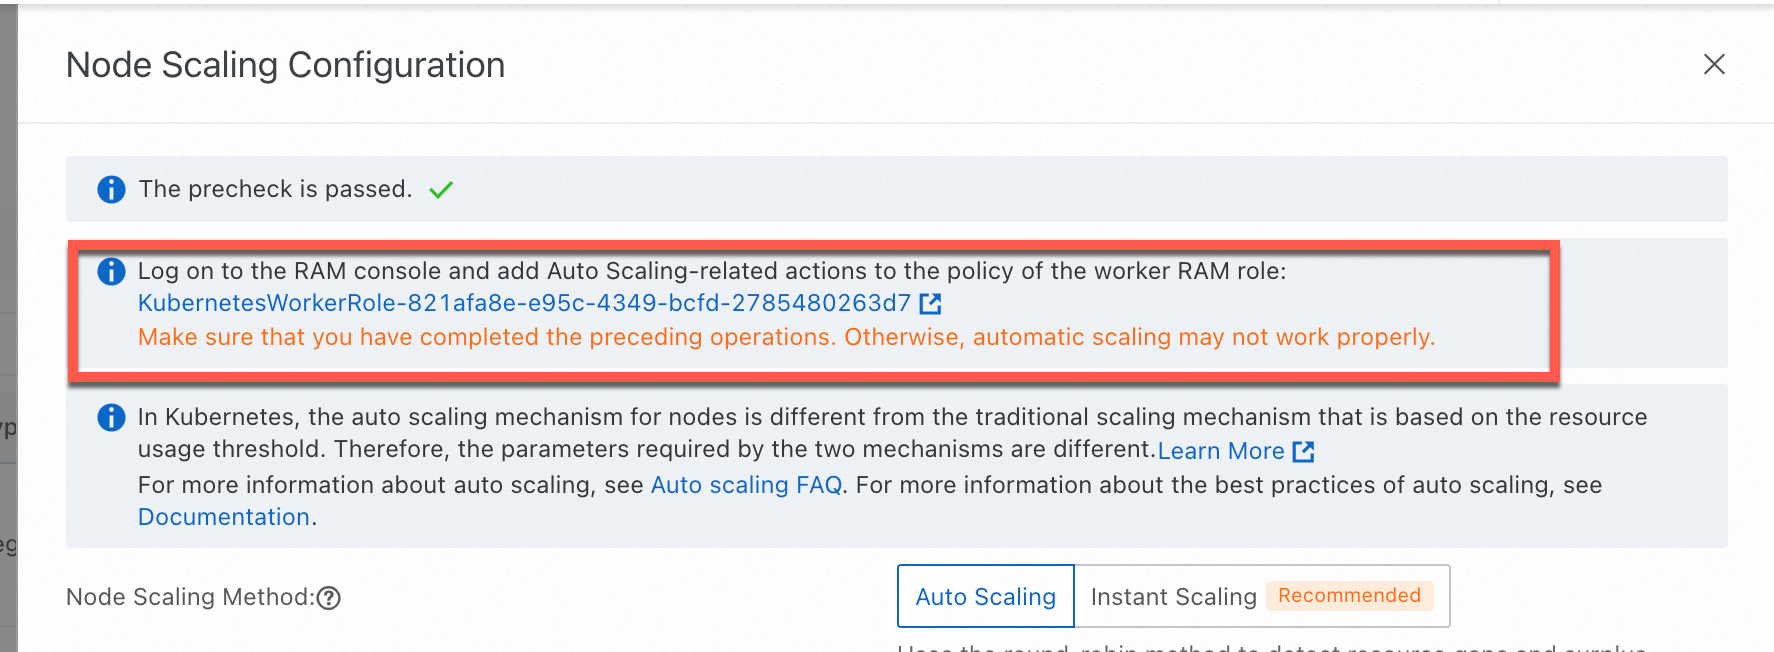
Reinicie manualmente o Deployment
cluster-autoscaler(auto scaling de nós) ou o Deploymentack-goatscaler(dimensionamento instantâneo de nós) no namespacekube-systempara que as permissões atualizadas entrem em vigor.