Configure o Knative Pod Autoscaler (KPA) para dimensionar pods do Knative Serving por concorrência ou RPS no ACK.
Pré-requisitos
Antes de começar, verifique se você possui:
Um cluster gerenciado ACK ou cluster ACK Serverless executando Kubernetes 1.20 ou posterior criado.
O Knative implantado no cluster.
Como funciona
O Knative Serving injeta um contêiner sidecar queue-proxy em cada pod. Esse sidecar relata métricas de concorrência ao KPA, que ajusta a quantidade de pods com base nessas métricas e no algoritmo configurado.

Algoritmo de dimensionamento
O KPA calcula a quantidade alvo de pods com esta fórmula:
Number of pods = Number of concurrent requests / (Pod maximum concurrency × Target utilization)Exemplo: Com containerConcurrency definido como 10 e utilização alvo de 70%, 100 requisições simultâneas resultam em: 100 / (10 × 0,7) = 15 pods (arredondado para cima).
Modos estável e de pânico
O KPA utiliza dois modos para responder aos padrões de tráfego:
Modo estável — é o padrão. O KPA calcula a média de concorrência entre os pods durante a janela estável (padrão: 60 s) e ajusta a quantidade de pods para corresponder a esse valor.
Modo de pânico — ativado durante picos de tráfego. O KPA usa uma janela de pânico mais curta (padrão: 6 s; stable window × panic-window-percentage) para detectar aumentos repentinos. Quando a quantidade de pods no modo de pânico ≥ panic-threshold-percentage / 100 × pods prontos (padrão: 2×), o KPA adota a contagem de pânico em vez da contagem estável.
Configure o ConfigMap config-autoscaler
Os padrões globais do KPA residem no ConfigMap config-autoscaler no namespace knative-serving. Anotações por revisão substituem esses padrões.
Inspecione a configuração atual:
kubectl -n knative-serving describe cm config-autoscalerA tabela a seguir lista os principais parâmetros. Todos os valores são os padrões.
|
Parâmetro |
Padrão |
Descrição |
|
|
|
Máximo de requisições simultâneas por pod (limite flexível, global) |
|
|
|
Porcentagem de utilização alvo para dimensionamento baseado em concorrência |
|
|
|
RPS alvo por pod |
|
|
|
Capacidade de pico antes que o Activator armazene requisições em buffer. |
|
|
|
Janela de tempo para cálculo da média no modo estável |
|
|
|
Janela de pânico como porcentagem da janela estável (padrão: 6 s) |
|
|
|
O pânico é acionado quando os pods desejados ≥ |
|
|
|
Proporção máxima de pods desejados por evento de scale-out: |
|
|
|
Os pods reduzem para, no máximo, metade da contagem atual por atividade |
|
|
|
Define se serviços ociosos devem ser reduzidos a zero pods |
|
|
|
Tempo máximo para encerramento de rede durante o scale-to-zero |
|
|
|
Tempo mínimo que o último pod permanece ativo após o término do tráfego |
|
|
|
Tipo de autoscaler. Valores suportados: |
|
|
|
Capacidade de requisição do serviço Activator |
|
|
|
Quantidade inicial de pods por revisão |
|
|
|
Define se uma revisão pode iniciar com zero pods |
|
|
|
Mínimo de pods por revisão (0 = sem limite inferior) |
|
|
|
Máximo de pods por revisão (0 = ilimitado) |
|
|
|
Tempo com concorrência reduzida antes do scale-in. Diferente de |
O parâmetro scale-to-zero-grace-period limita a duração da programação de rede durante o scale-to-zero. Ajuste-o apenas se observar perda de requisições durante o scale-to-zero — ele não controla quanto tempo o último pod permanece ativo. Para manter o último pod após o fim do tráfego, use scale-to-zero-pod-retention-period.
Configure métricas de dimensionamento
Defina a métrica de dimensionamento por revisão com a anotação autoscaling.knative.dev/metric. Padrão: concurrency.
|
Métrica |
Classe de autoscaler necessária |
Descrição |
|
|
|
Requisições simultâneas em andamento por pod |
|
|
|
Requisições por segundo por pod |
|
|
|
Utilização de CPU |
|
|
|
Utilização de memória |
|
Métricas personalizadas |
Variável |
Métricas personalizadas conforme os requisitos da aplicação |
Métrica de concorrência (padrão)
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/metric: "concurrency"
Métrica de RPS
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/metric: "rps"
Métrica de CPU
O dimensionamento baseado em CPU exige a classe de autoscaler HPA.
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/class: "hpa.autoscaling.knative.dev"
        autoscaling.knative.dev/metric: "cpu"
Métrica de memória
O dimensionamento baseado em memória também exige a classe de autoscaler HPA.
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/class: "hpa.autoscaling.knative.dev"
        autoscaling.knative.dev/metric: "memory"
Configure alvos de dimensionamento
Os alvos de dimensionamento definem o valor da métrica que o KPA mantém por pod. Configure por revisão ou globalmente.
Alvo de concorrência
Por revisão — use autoscaling.knative.dev/target:
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/target: "50"
Global — atualize o ConfigMap config-autoscaler:
apiVersion: v1
kind: ConfigMap
metadata:
  name: config-autoscaler
  namespace: knative-serving
data:
  container-concurrency-target-default: "200"
Alvo de RPS
Por revisão:
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/target: "150"
        autoscaling.knative.dev/metric: "rps"
    spec:
      containers:
        - image: registry.cn-hangzhou.aliyuncs.com/knative-sample/helloworld-go:73fbdd56
Global:
apiVersion: v1
kind: ConfigMap
metadata:
  name: config-autoscaler
  namespace: knative-serving
data:
  requests-per-second-target-default: "150"
Configure limites de concorrência
Os limites de concorrência restringem as requisições simultâneas por pod. O KPA suporta dois tipos.
Limite flexível de concorrência
Um limite flexível é o alvo que o KPA busca atingir. Ele não é aplicado rigidamente — picos podem excedê-lo momentaneamente.
Por revisão:
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/target: "200"
Global:
apiVersion: v1
kind: ConfigMap
metadata:
  name: config-autoscaler
  namespace: knative-serving
data:
  container-concurrency-target-default: "200"
Limite rígido de concorrência
Um limite rígido é aplicado estritamente — requisições excedentes são armazenadas em buffer. Defina um limite rígido apenas quando sua aplicação tiver um limite superior absoluto de concorrência; valores baixos reduzem o throughput e aumentam a latência.
Por revisão — use o campo de especificação containerConcurrency (não é uma anotação):
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    spec:
      containerConcurrency: 50
Utilização alvo
A utilização alvo controla o nível de ocupação dos pods antes que o KPA inicie o scale-out. Com 70% de utilização e containerConcurrency: 10, o KPA cria um novo pod quando a concorrência média nos pods existentes atinge 7. Valores menores fazem o KPA realizar o scale-out mais cedo, reduzindo a latência de cold start.
Por revisão:
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/target-utilization-percentage: "70"
    spec:
      containers:
        - image: registry.cn-hangzhou.aliyuncs.com/knative-sample/helloworld-go:73fbdd56
Global:
apiVersion: v1
kind: ConfigMap
metadata:
  name: config-autoscaler
  namespace: knative-serving
data:
  container-concurrency-target-percentage: "70"
Configure o scale-to-zero
Ative ou desative o scale-to-zero globalmente
Defina enable-scale-to-zero como "false" para manter pelo menos um pod em execução quando um serviço estiver ocioso:
apiVersion: v1
kind: ConfigMap
metadata:
  name: config-autoscaler
  namespace: knative-serving
data:
  enable-scale-to-zero: "false"
Configure o período de carência do scale-to-zero
O parâmetro scale-to-zero-grace-period limita a duração da programação de rede durante o scale-to-zero.
Aumente este valor apenas se observar perda de requisições durante o scale-to-zero. Ele não controla quanto tempo o último pod permanece ativo. Para manter o último pod, use scale-to-zero-pod-retention-period.
apiVersion: v1
kind: ConfigMap
metadata:
  name: config-autoscaler
  namespace: knative-serving
data:
  scale-to-zero-grace-period: "40s"
Configure o período de retenção do pod
O parâmetro scale-to-zero-pod-retention-period mantém o último pod ativo por uma duração mínima após o término do tráfego, evitando cold starts em serviços com tráfego intermitente.
Por revisão:
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/scale-to-zero-pod-retention-period: "1m5s"
    spec:
      containers:
        - image: registry.cn-hangzhou.aliyuncs.com/knative-sample/helloworld-go:73fbdd56
Global:
apiVersion: v1
kind: ConfigMap
metadata:
  name: config-autoscaler
  namespace: knative-serving
data:
  scale-to-zero-pod-retention-period: "42s"
Configure limites de dimensionamento
Os limites de dimensionamento definem as quantidades mínima e máxima de réplicas para uma revisão.
|
Anotação |
Parâmetro (global) |
Finalidade |
|
|
|
Limite inferior — o KPA nunca dimensiona abaixo desta quantidade |
|
|
|
Limite superior — o KPA nunca dimensiona acima desta quantidade (0 = ilimitado) |
O parâmetromin-scalemantém um limite permanente de pods. Para atrasar o scale-in sem um limite permanente, usescale-down-delaynoconfig-autoscaler— os pods ainda serão reduzidos após o atraso.
Exemplos
Exemplo 1: Dimensionar por alvo de concorrência
Implante uma aplicação com dimensionamento automático com alvo de concorrência de 10 e teste com 50 requisições simultâneas.
Implante o Knative em um cluster ACK ou em um cluster ACK Serverless.
-
Crie o arquivo
autoscale-go.yamlcom o seguinte conteúdo:apiVersion: serving.knative.dev/v1 kind: Service metadata: name: autoscale-go namespace: default spec: template: metadata: labels: app: autoscale-go annotations: autoscaling.knative.dev/target: "10" # Concurrency target: 10 requests per pod spec: containers: - image: registry.cn-hangzhou.aliyuncs.com/knative-sample/autoscale-go:0.1 -
Aplique o manifesto:
kubectl apply -f autoscale-go.yaml -
Obtenha o endereço do gateway de Ingress. ALB:
kubectl get albconfig knative-internetSaída esperada:
NAME               ALBID                    DNSNAME                                              PORT&PROTOCOL   CERTID   AGE
knative-internet   alb-hvd8nngl0lsdra15g0   alb-hvd8nng******.cn-beijing.alb.aliyuncs.com                            2
MSE:
kubectl -n knative-serving get ing stats-ingressSaída esperada:
NAME            CLASS                  HOSTS   ADDRESS                         PORTS   AGE
stats-ingress   knative-ingressclass   *       101.201.XX.XX,192.168.XX.XX   80      15d
ASM:
kubectl get svc istio-ingressgateway --namespace istio-system --output jsonpath="{.status.loadBalancer.ingress[*]['ip']}"Saída esperada:
121.XX.XX.XXKourier:
kubectl -n knative-serving get svc kourierSaída esperada:
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE kourier LoadBalancer 10.0.XX.XX 39.104.XX.XX 80:31133/TCP,443:32515/TCP 49m -
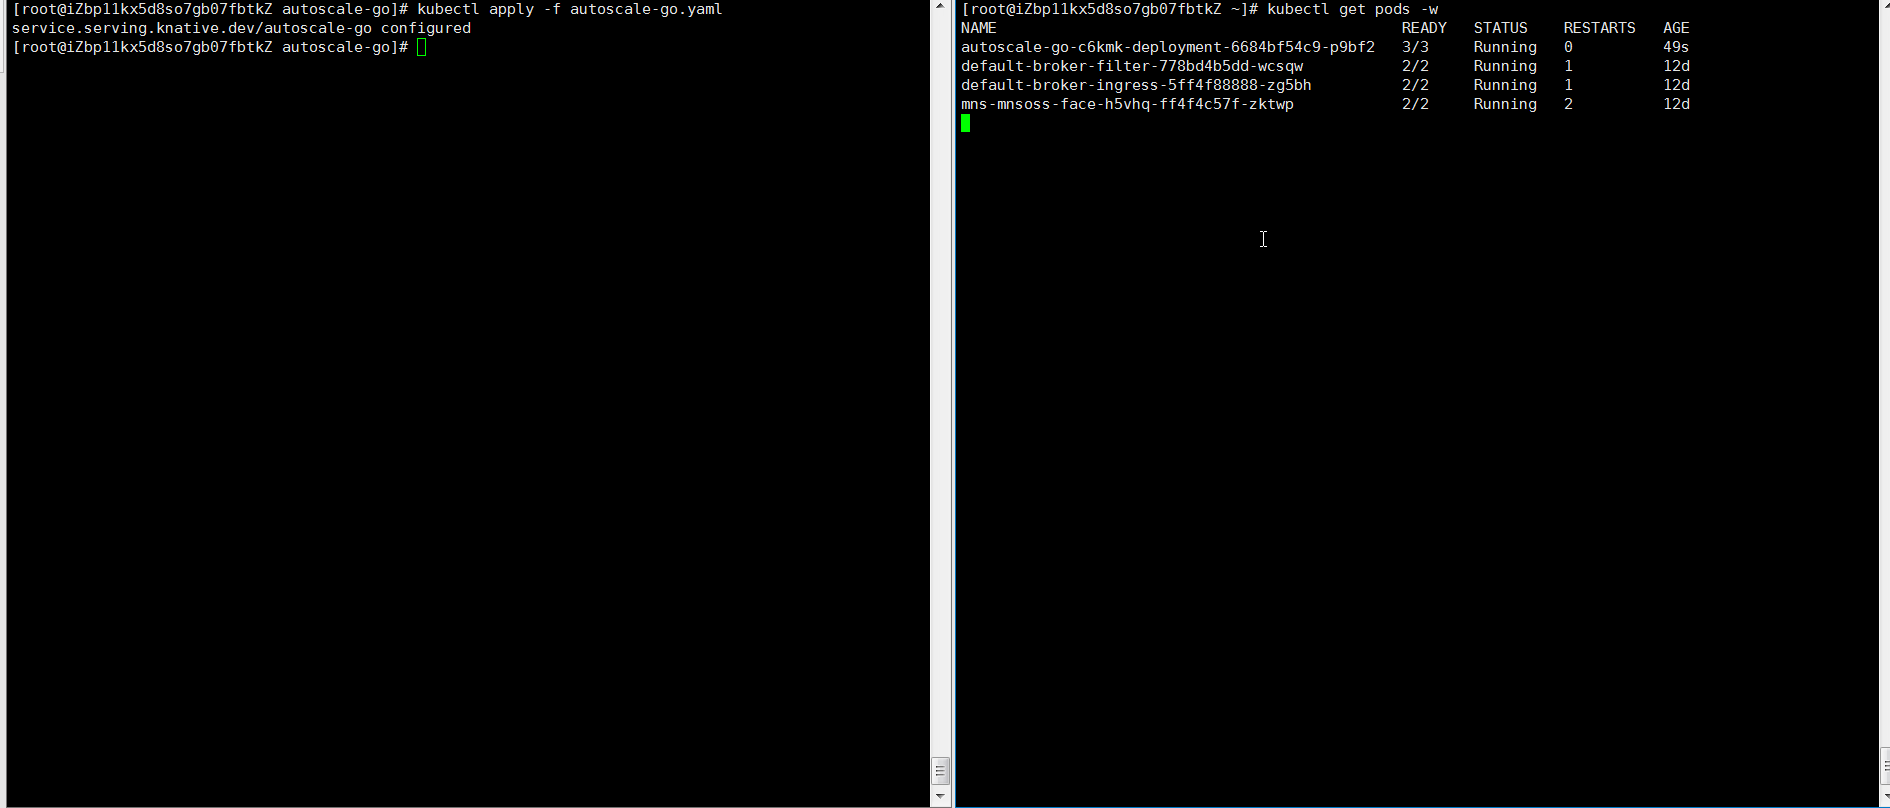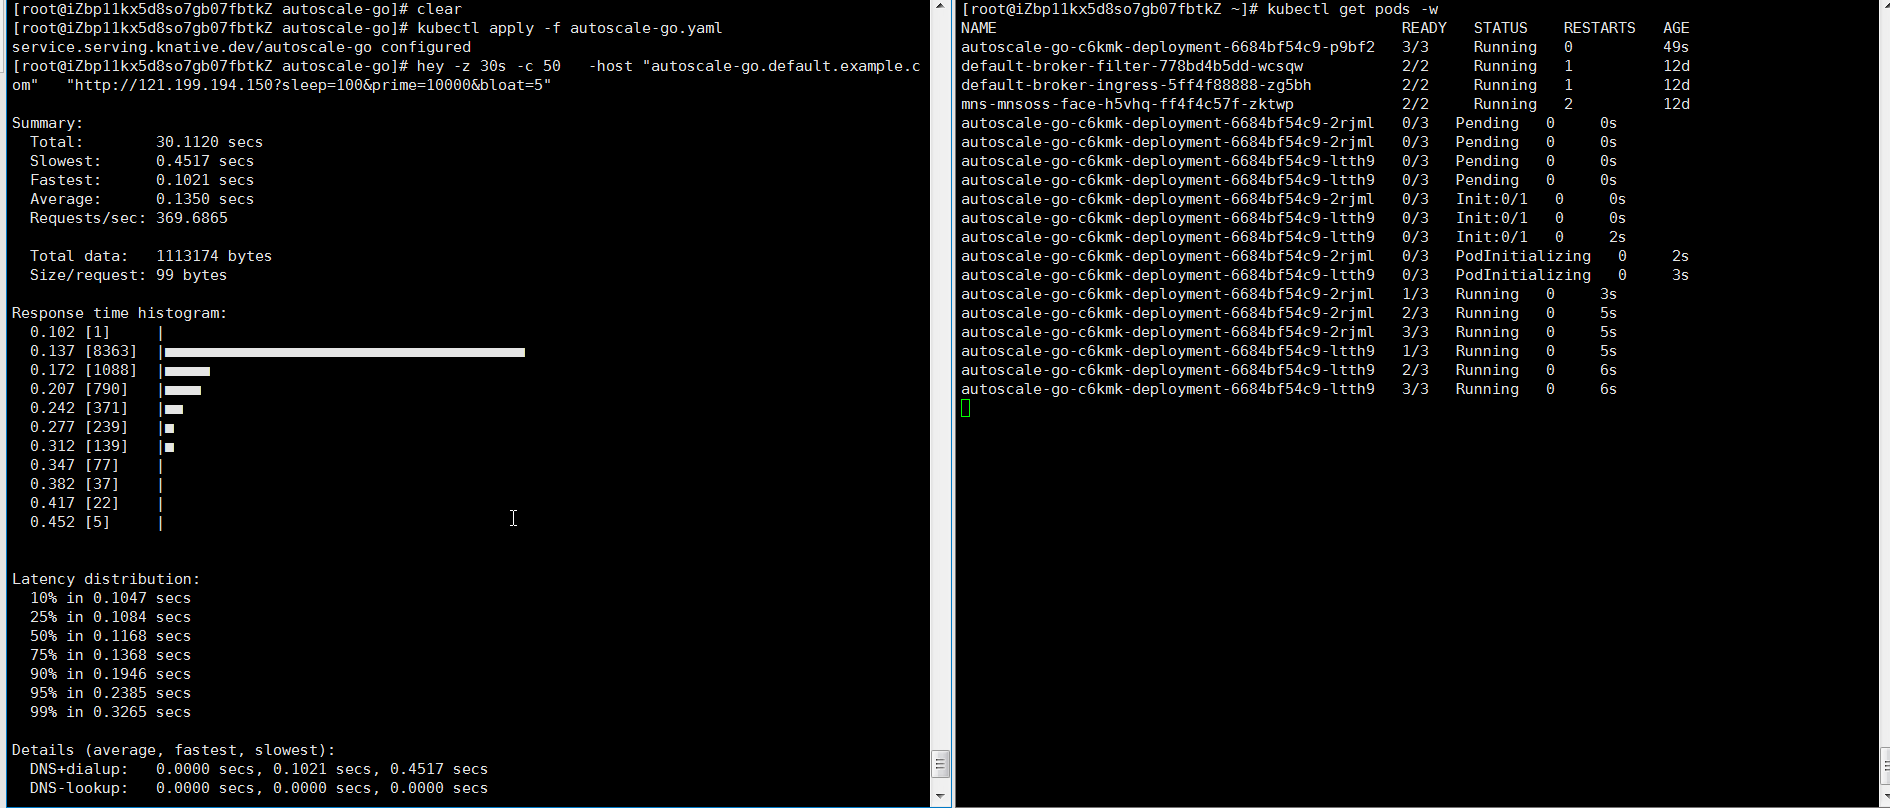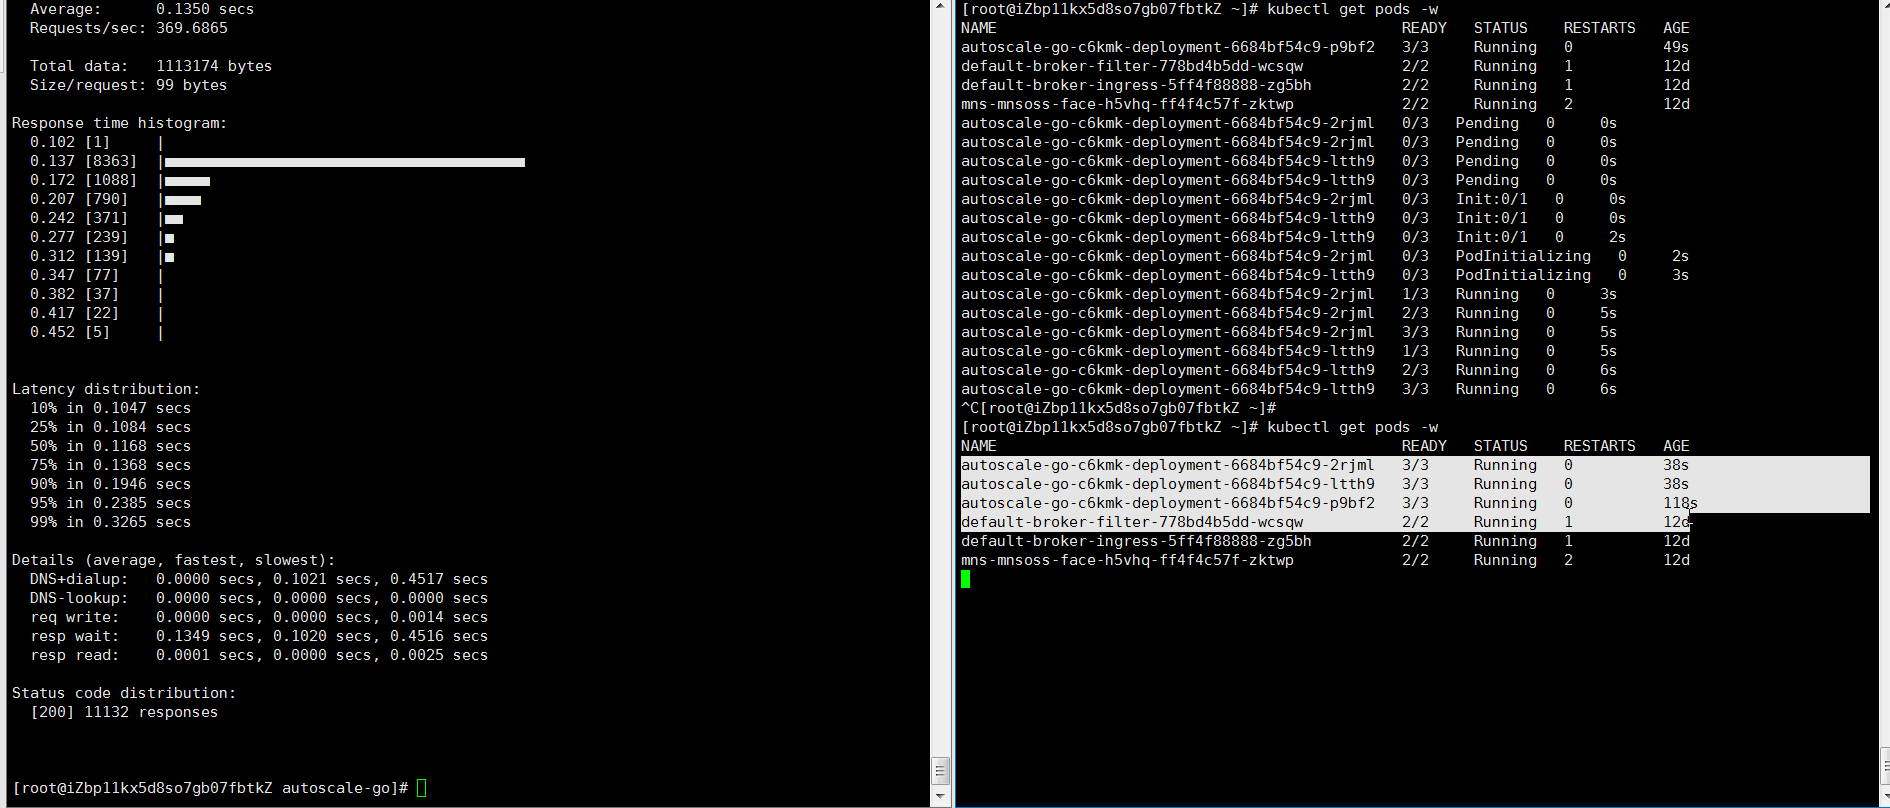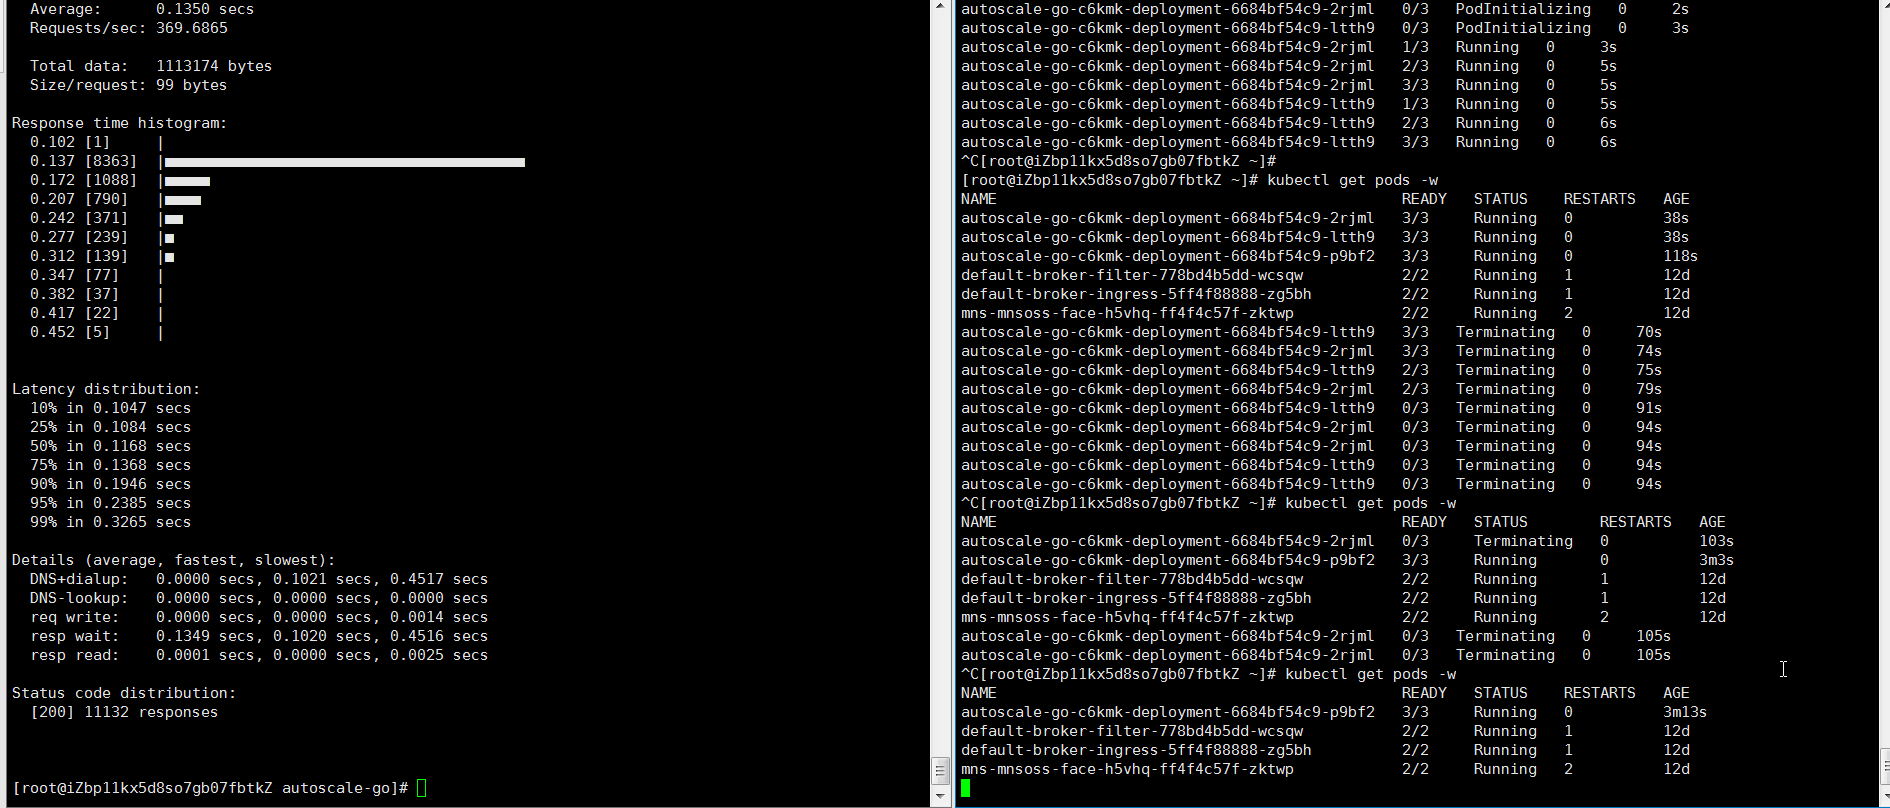
Envie 50 requisições simultâneas por 30 segundos com o hey:
hey -z 30s -c 50 \
  -host "autoscale-go.default.example.com" \
  "http://121.199.XXX.XXX"  # Replace with your Ingress gateway address
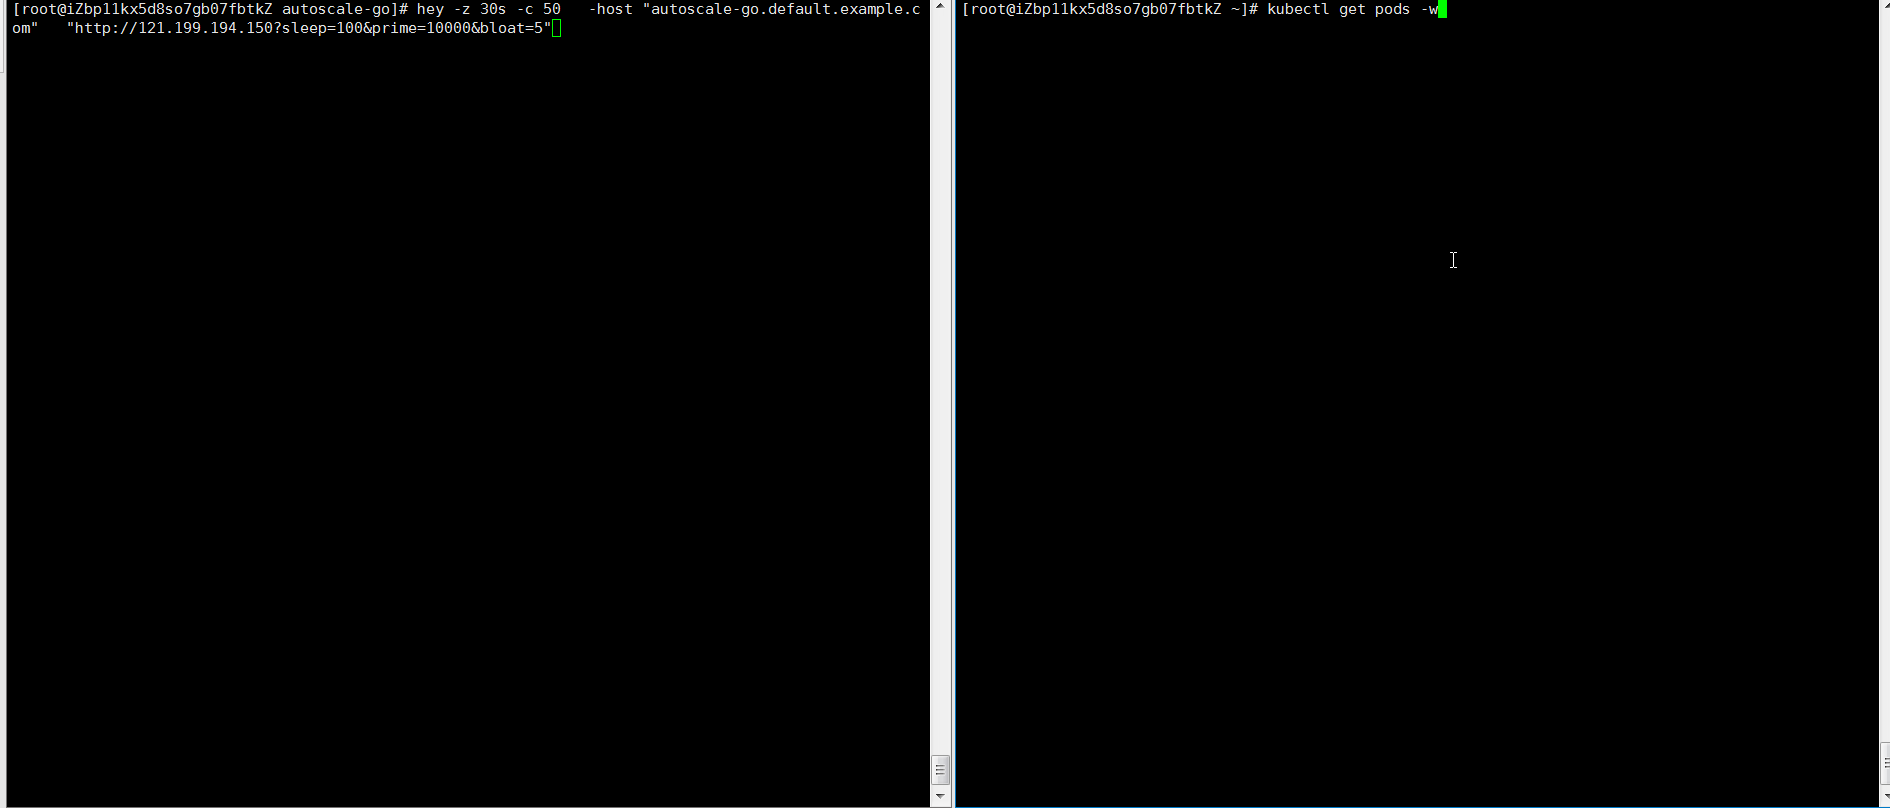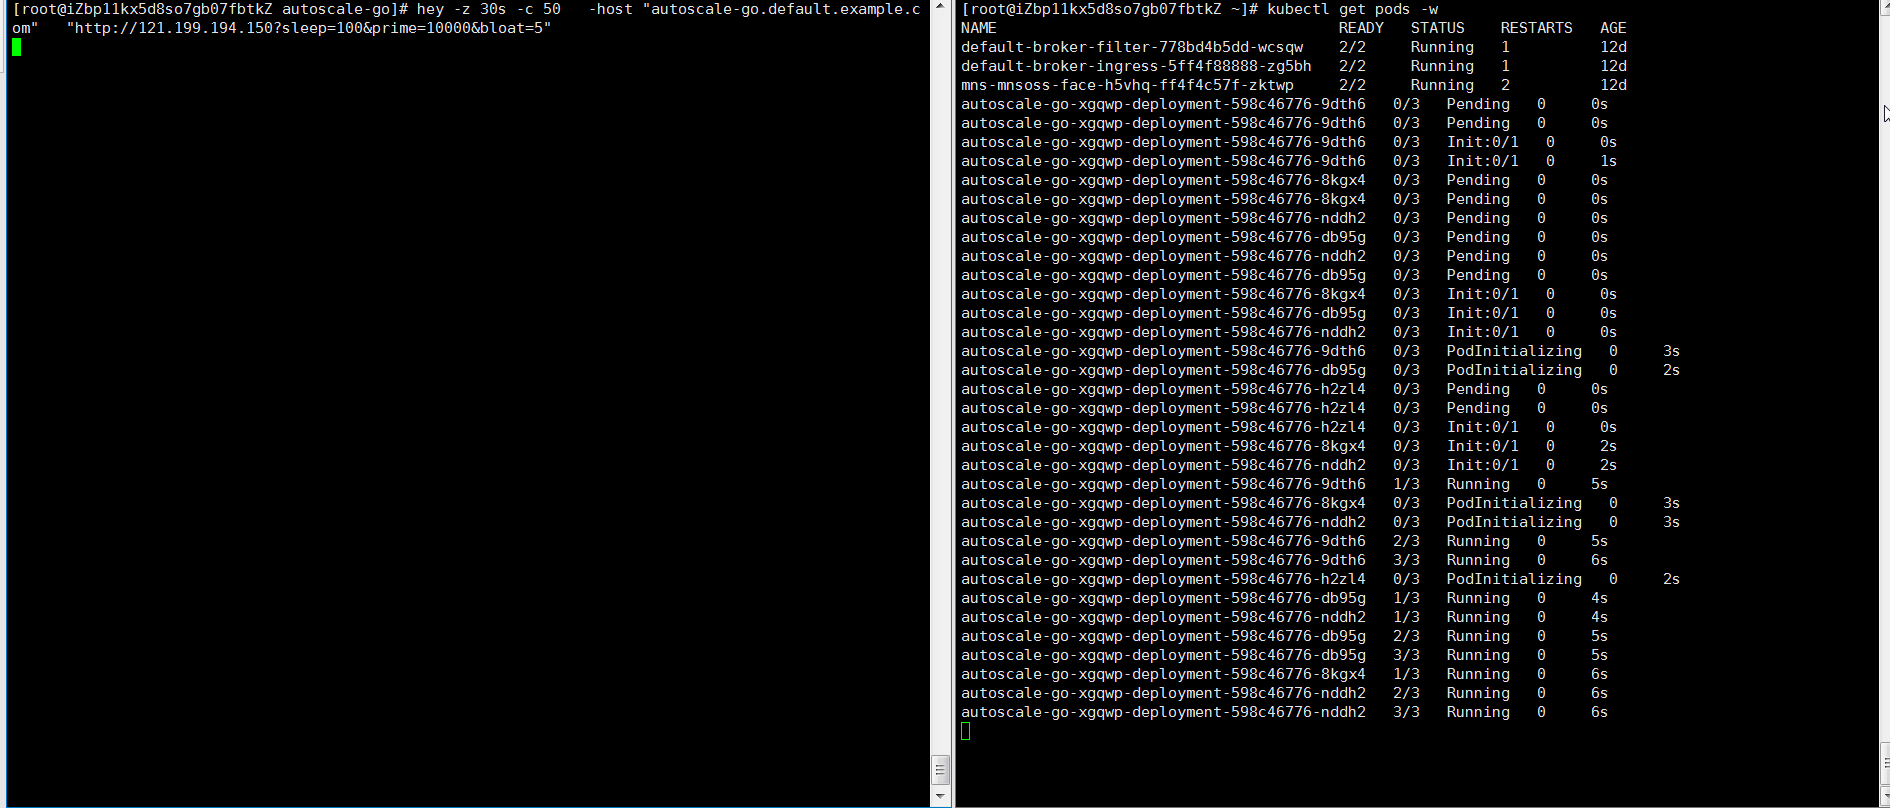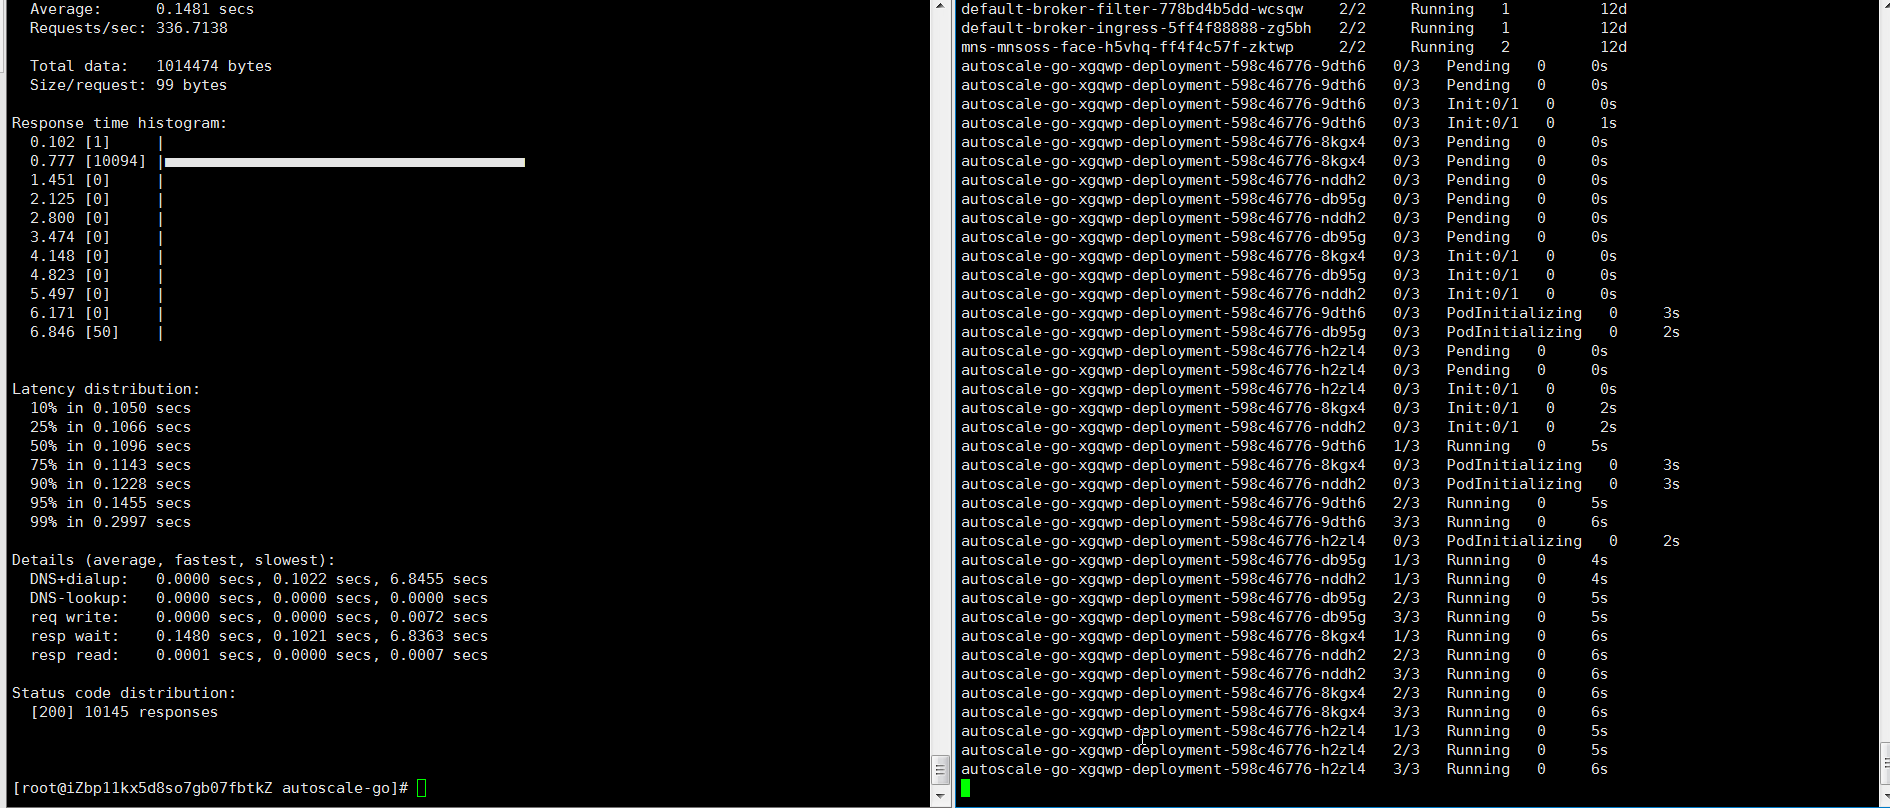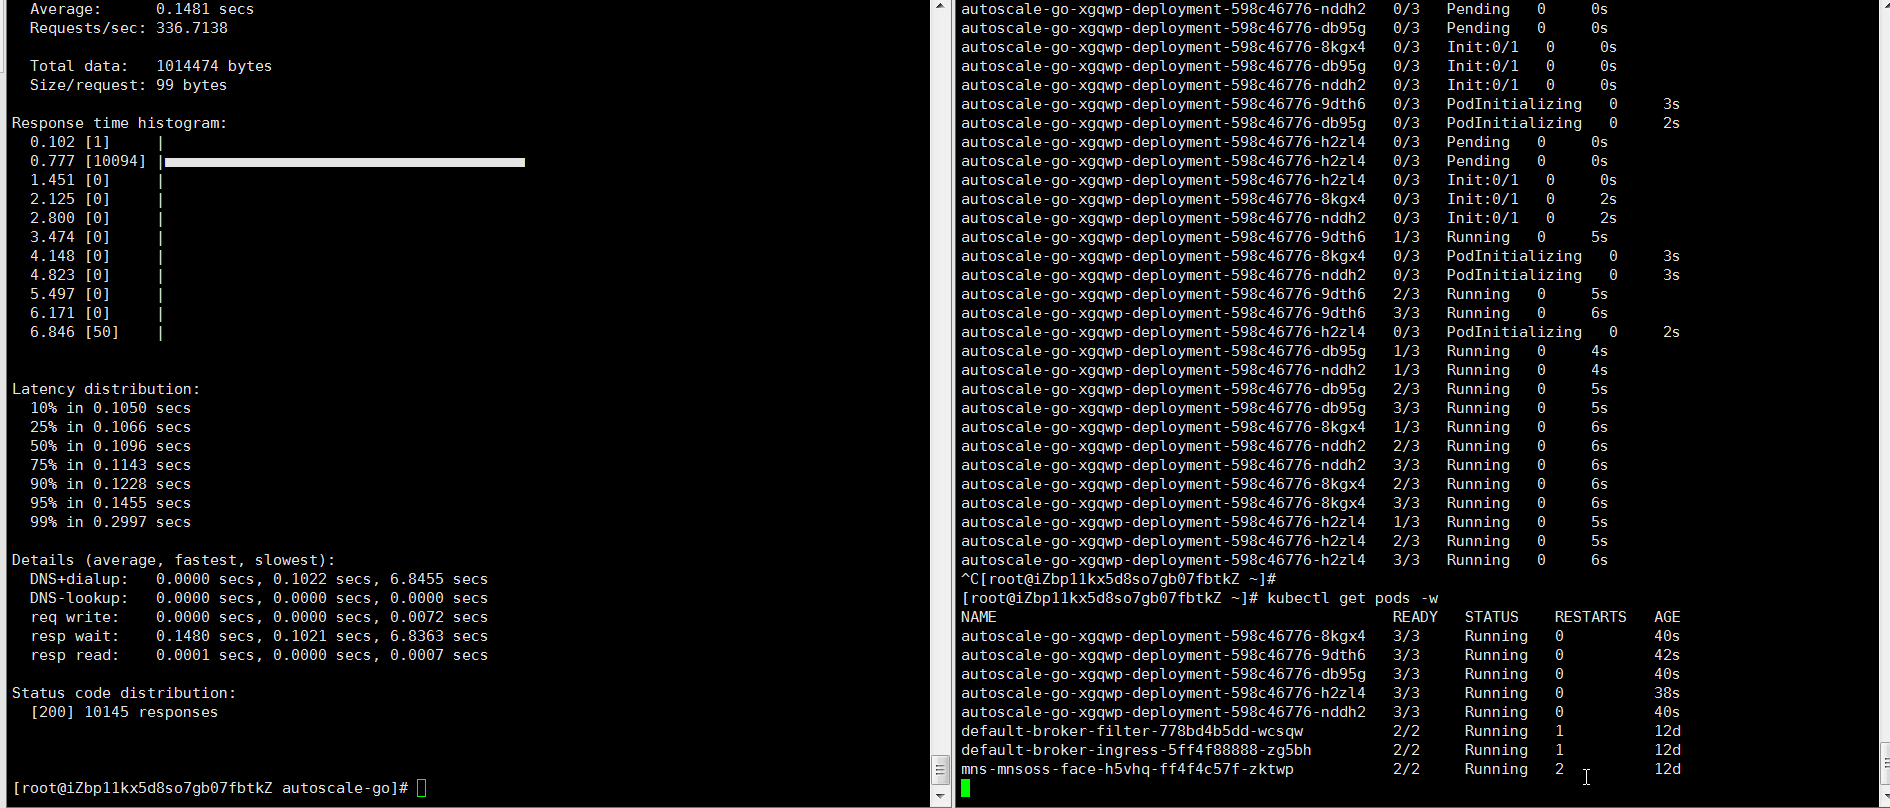
Saída esperada: O KPA adiciona 5 pods: 50 requisições simultâneas ÷ alvo de 10 = 5 pods.
Exemplo 2: Dimensionar com limites
Adicione min-scale: 1 e max-scale: 3 para manter um pod em execução e limitar a implantação a três pods.
Implante o Knative em um cluster ACK ou em um cluster ACK Serverless.
-
Crie o arquivo
autoscale-go.yamlcom o seguinte conteúdo:apiVersion: serving.knative.dev/v1 kind: Service metadata: name: autoscale-go namespace: default spec: template: metadata: labels: app: autoscale-go annotations: autoscaling.knative.dev/target: "10" autoscaling.knative.dev/min-scale: "1" # Keep at least 1 pod running autoscaling.knative.dev/max-scale: "3" # Cap at 3 pods spec: containers: - image: registry.cn-hangzhou.aliyuncs.com/knative-sample/autoscale-go:0.1 -
Aplique o manifesto:
kubectl apply -f autoscale-go.yaml Obtenha o endereço do gateway de Ingress (Exemplo 1, etapa 4).
-
Envie 50 requisições simultâneas por 30 segundos:
hey -z 30s -c 50 \
  -host "autoscale-go.default.example.com" \
  "http://121.199.XXX.XXX"  # Replace with your Ingress gateway address
Saída esperada: O KPA dimensiona para 3 pods (máximo) durante a carga e retorna para 1 pod (mínimo) depois — sem cold starts na próxima requisição.