Os volumes persistentes (PVs) do OSS aceitam múltiplos clientes, mas o suporte completo a gravação prejudica o desempenho de leitura. A separação de leitura e gravação resolve esse problema ao direcionar as operações por caminhos de montagem distintos, melhorando o throughput em cargas de trabalho com uso intenso de leitura, como treinamento de modelos, inferência e análise de dados.
Implemente a separação de leitura e gravação para PVs do OSS com ossfs ou o OSS SDK, conforme demonstrado em um job de treinamento de reconhecimento de escrita MNIST.
Pré-requisitos
Verifique se você possui:
A versão mais recente do componente Container Storage Interface (CSI) instalada. Diferentes clientes exigem versões distintas do CSI. Consulte Gerencie os componentes csi-plugin e csi-provisioner.
Um bucket do OSS na mesma conta Alibaba Cloud do cluster.
Não recomendamos o acesso ao OSS entre contas diferentes.
Escolha um cliente
Os PVs do OSS suportam três clientes: ossfs 1,0, ossfs 2,0 e strmvol. Todos permitem acesso somente leitura, mas as capacidades de gravação variam:
|
Cliente |
Somente leitura |
Leitura/gravação |
Mais indicado para |
|
ossfs 1,0 |
Sim |
Gravação completa |
Cargas gerais de leitura/gravação; modo de leitura direta disponível (v1.91+) |
|
ossfs 2,0 |
Sim |
Apenas gravações sequenciais por acréscimo |
Cargas com predominância de leitura; requer CSI >= 1.33.1 |
|
strmvol |
Sim |
— |
Muitos arquivos pequenos (datasets, logs de séries temporais, backtesting quantitativo) |
Consulte a Referência de seleção de cliente.
Casos de uso
Acesso somente leitura
Defina o modo de acesso do PV como ReadOnlyMany para evitar modificações acidentais nos dados. Essa configuração é adequada para inferência, análise de dados e consultas de logs.
Para cargas com predominância de leitura, utilize o ossfs 2,0 (CSI >= 1.33.1). Consulte Usar PVs com ossfs 2,0.
Quando houver muitos arquivos pequenos, prefira o strmvol. Consulte Usar PVs com strmvol.
Configure os parâmetros de otherOpts listados abaixo para ajustar o ossfs 1,0 em cenários somente leitura. A maioria das cargas funciona bem com os valores padrão.
|
Parâmetro |
Padrão |
Descrição |
|
|
Desativado |
Habilita o cache de buffer do kernel para leituras não críticas em tempo real. Utiliza memória livre para armazenamento em cache. |
|
|
20 |
Shards simultâneos para upload e download de arquivos grandes. |
|
|
20 |
Número máximo de requisições simultâneas de listagem de metadados. Deve ser >= |
|
|
1000 |
Quantidade de entradas de metadados mantidas em cache. Defina como |
|
|
Desativado |
Modo de leitura direta para cenários somente leitura (ossfs >= 1.91). Consulte Recursos e testes de desempenho da nova versão do ossfs 1,0 e Otimização de desempenho para cenários somente leitura. |
Acesso de leitura e gravação
Defina o modo de acesso do PV como ReadWriteMany para cargas de trabalho que precisam gravar dados.
O ossfs não garante consistência em gravações concorrentes. Vários escritores operando sobre os mesmos objetos podem corromper os dados. Utilize apenas um escritor por caminho ao salvar checkpoints.
Excluir ou modificar arquivos no caminho montado também exclui ou modifica os objetos correspondentes no bucket do OSS. Ative o versionamento para proteger seus dados contra perda acidental.
Em cargas intensivas de leitura que utilizam caminhos separados para leitura e gravação (como treinamento de modelos), monte o caminho de leitura como ReadOnlyMany com cache ativado e processe as gravações por meio de um PV ReadWriteMany ou diretamente pelo OSS SDK.
Como funciona a separação de leitura e gravação
A separação de leitura e gravação direciona as operações por pontos de montagem distintos, cada um apontando para um subcaminho diferente do mesmo bucket do OSS. Isso isola o I/O de leitura do I/O de gravação.
Caminho de leitura: monte um subcaminho (por exemplo,
/tf-train/train/data) comoReadOnlyManycom cache ativado. Leituras repetidas são atendidas diretamente da memória.Caminho de gravação: monte um subcaminho diferente (por exemplo,
/tf-train/training_logs) comoReadWriteManyou grave diretamente via SDK.
Exemplo: Treinamento de reconhecimento de escrita MNIST
O job de treinamento executa as seguintes etapas:
Lê o dataset de treinamento de
/tf-train/train/datano bucket do OSS usando um PV somente leitura.Grava os checkpoints de treinamento em
/tf-train/training_logsutilizando um PV de leitura/gravação ou o OSS SDK.
Baixe o dataset MNIST e faça o upload para /tf-train/train/data no seu bucket do OSS:
Organização dos arquivos no bucket do OSS:

Implementar operações de leitura e gravação com ossfs
Como as gravações de checkpoint são acréscimos sequenciais, tanto o ossfs 1,0 quanto o ossfs 2,0 funcionam para o caminho de gravação.
-
Implante a aplicação de treinamento. A aplicação monta o subcaminho
/tf-traindo bucket do OSS no diretório/mntdo pod. Consulte Usar volumes provisionados estaticamente com ossfs 1,0 ou Usar PVs com ossfs 2,0.-
Crie um PV com ossfs 1,0:
cat << EOF | kubectl apply -f - apiVersion: v1 kind: Secret metadata: name: oss-secret namespace: default stringData: akId: "<your-accesskey-id>" akSecret: "<your-accesskey-secret>" --- apiVersion: v1 kind: PersistentVolume metadata: name: tf-train-pv labels: alicloud-pvname: tf-train-pv spec: capacity: storage: 10Gi accessModes: - ReadWriteMany persistentVolumeReclaimPolicy: Retain csi: driver: ossplugin.csi.alibabacloud.com volumeHandle: tf-train-pv nodePublishSecretRef: name: oss-secret namespace: default volumeAttributes: bucket: "<your-bucket-name>" url: "oss-<region>.aliyuncs.com" otherOpts: "-o max_stat_cache_size=0 -o allow_other" path: "/tf-train" --- apiVersion: v1 kind: PersistentVolumeClaim metadata: name: tf-train-pvc spec: accessModes: - ReadWriteMany resources: requests: storage: 10Gi selector: matchLabels: alicloud-pvname: tf-train-pv EOF -
Crie o pod de treinamento:
Durante o treinamento, o ossfs envia os arquivos de
/mnt/training_logs(pod) para/tf-train/training_logs(bucket do OSS).cat << EOF | kubectl apply -f - apiVersion: v1 kind: Pod metadata: labels: app: tfjob name: tf-mnist namespace: default spec: containers: - command: - sh - -c - python /app/main.py env: - name: NVIDIA_VISIBLE_DEVICES value: void - name: gpus value: "0" - name: workers value: "1" - name: TEST_TMPDIR value: "/mnt" image: registry.cn-beijing.aliyuncs.com/tool-sys/tf-train-demo:rw imagePullPolicy: Always name: tensorflow ports: - containerPort: 20000 name: tfjob-port protocol: TCP volumeMounts: - name: train mountPath: "/mnt" workingDir: /root priority: 0 restartPolicy: Never securityContext: {} terminationGracePeriodSeconds: 30 volumes: - name: train persistentVolumeClaim: claimName: tf-train-pvc EOF
-
-
Verifique as leituras e gravações de dados.
-
Verifique o status do pod:
kubectl get pod tf-mnistAguarde até que o status mude de
RunningparaCompleted:NAME READY STATUS RESTARTS AGE tf-mnist 0/1 Completed 0 2m12s -
Verifique o tempo de carregamento dos dados:
kubectl logs tf-mnist | grep dataloadSaída esperada:
dataload cost time: 1.54191803932 Faça login no OSS Management Console e confirme a existência dos arquivos em
/tf-train/training_logsdentro do bucket.
-
Otimizar o desempenho de leitura com separação de leitura e gravação
Divida o único PV de leitura/gravação em dois: um PV somente leitura com ajuste de cache para o dataset e um PV de gravação para os checkpoints. Apenas a configuração de montagem muda — o código de treinamento permanece igual.
Duas opções de gravação estão disponíveis:
Opção 1: usar um PV ossfs separado de leitura/gravação para escrever os checkpoints.
Opção 2: usar o OSS SDK para gravar os checkpoints diretamente, sem passar pelo ossfs.
Opção 1: Gravar usando um PV ossfs de leitura/gravação
-
Crie um PV ossfs 1,0 somente leitura para o dataset. As principais alterações de configuração são:
Defina
accessModescomoReadOnlyManytanto no PV quanto no PVC. Monte o subcaminho do dataset/tf-train/train/data.-
Em
otherOpts, adicione-o kernel_cache -o max_stat_cache_size=10000 -o umask=022:kernel_cacheativa o cache de leitura em memória.max_stat_cache_size=10000armazena 10.000 entradas de metadados em cache (~40 MB). Ajuste conforme o tipo de instância e o tamanho do dataset.umask=022concede permissão de leitura a processos não root no contêiner.
cat << EOF | kubectl apply -f - apiVersion: v1 kind: Secret metadata: name: oss-secret namespace: default stringData: akId: "<your-accesskey-id>" akSecret: "<your-accesskey-secret>" --- apiVersion: v1 kind: PersistentVolume metadata: name: tf-train-pv labels: alicloud-pvname: tf-train-pv spec: capacity: storage: 10Gi accessModes: - ReadOnlyMany persistentVolumeReclaimPolicy: Retain csi: driver: ossplugin.csi.alibabacloud.com volumeHandle: tf-train-pv nodePublishSecretRef: name: oss-secret namespace: default volumeAttributes: bucket: "<your-bucket-name>" url: "oss-<region>.aliyuncs.com" otherOpts: "-o kernel_cache -o max_stat_cache_size=10000 -o umask=022 -o allow_other" path: "/tf-train/train/data" --- apiVersion: v1 kind: PersistentVolumeClaim metadata: name: tf-train-pvc spec: accessModes: - ReadOnlyMany resources: requests: storage: 10Gi selector: matchLabels: alicloud-pvname: tf-train-pv EOF -
Crie um PV ossfs 1,0 de leitura/gravação para os checkpoints, montando o subcaminho
/tf-train/training_logs. O cache de metadados fica desativado (max_stat_cache_size=0) porque gravações sequenciais de checkpoint não se beneficiam de cache.cat << EOF | kubectl apply -f - apiVersion: v1 kind: PersistentVolume metadata: name: tf-logging-pv labels: alicloud-pvname: tf-logging-pv spec: capacity: storage: 10Gi accessModes: - ReadWriteMany persistentVolumeReclaimPolicy: Retain csi: driver: ossplugin.csi.alibabacloud.com volumeHandle: tf-logging-pv nodePublishSecretRef: name: oss-secret namespace: default volumeAttributes: bucket: "<your-bucket-name>" url: "oss-<region>.aliyuncs.com" otherOpts: "-o max_stat_cache_size=0 -o allow_other" path: "/tf-train/training_logs" --- apiVersion: v1 kind: PersistentVolumeClaim metadata: name: tf-logging-pvc spec: accessModes: - ReadWriteMany resources: requests: storage: 10Gi selector: matchLabels: alicloud-pvname: tf-logging-pv EOF -
Implante o pod de treinamento com ambos os PVs montados.
Nenhuma alteração de código é necessária. Monte ambos os PVs — o PV somente leitura em
/mnt/train/datae o PV de leitura/gravação em/mnt/training_logs.cat << EOF | kubectl apply -f - apiVersion: v1 kind: Pod metadata: labels: app: tfjob name: tf-mnist namespace: default spec: containers: - command: - sh - -c - python /app/main.py env: - name: NVIDIA_VISIBLE_DEVICES value: void - name: gpus value: "0" - name: workers value: "1" - name: TEST_TMPDIR value: "/mnt" image: registry.cn-beijing.aliyuncs.com/tool-sys/tf-train-demo:rw imagePullPolicy: Always name: tensorflow ports: - containerPort: 20000 name: tfjob-port protocol: TCP volumeMounts: - name: train mountPath: "/mnt/train/data" - name: logging mountPath: "/mnt/training_logs" workingDir: /root priority: 0 restartPolicy: Never securityContext: {} terminationGracePeriodSeconds: 30 volumes: - name: train persistentVolumeClaim: claimName: tf-train-pvc - name: logging persistentVolumeClaim: claimName: tf-logging-pvc EOF
Opção 2: Gravar usando o OSS SDK
Grave os checkpoints diretamente no OSS com o SDK — nenhum PV de leitura/gravação é necessário. O pod lê de um PV somente leitura e grava via SDK.
-
Adicione o OSS Python SDK à imagem do contêiner:
RUN pip install oss2Consulte Instalação.
-
Modifique o código de treinamento para enviar os checkpoints usando o SDK. O código original salva checkpoints em
log_dira cada 100 iterações usandotf.train.Savercommax_to_keep=0, gerando 10 conjuntos de checkpoint após 1.000 iterações.Defina
max_to_keep=1para reter apenas o checkpoint mais recente, reduzindo o uso de memória.Envie cada checkpoint para o OSS com
put_object_from_filelogo após salvá-lo.
Utilize I/O assíncrono com o SDK para aumentar ainda mais o throughput quando os caminhos de leitura e gravação estiverem separados.
def train():
    ...
saver = tf.train.Saver(max_to_keep=0)

    for i in range(FLAGS.max_steps):
        if i % 10 == 0:  # Record summaries and test-set accuracy
            summary, acc = sess.run([merged, accuracy], feed_dict=feed_dict(False))
            print('Accuracy at step %s: %s' % (i, acc))
            if i % 100 == 0:
                print('Save checkpoint at step %s: %s' % (i, acc))
                saver.save(sess, FLAGS.log_dir + '/model.ckpt', global_step=i)
Substitua pelo envio baseado no SDK. Duas alterações reduzem o uso de memória e eliminam a necessidade do PV de leitura/gravação: leia o AccessKey e as configurações do bucket a partir de variáveis de ambiente. Consulte Configure access credentials.
import oss2
from oss2.credentials import EnvironmentVariableCredentialsProvider

auth = oss2.ProviderAuth(EnvironmentVariableCredentialsProvider())
url = os.getenv('URL','<default-url>')
bucketname = os.getenv('BUCKET','<default-bucket-name>')
bucket = oss2.Bucket(auth, url, bucketname)

...
def train():
  ...
  saver = tf.train.Saver(max_to_keep=1)

 for i in range(FLAGS.max_steps):
    if i % 10 == 0:  # Record summaries and test-set accuracy
      summary, acc = sess.run([merged, accuracy], feed_dict=feed_dict(False))
      print('Accuracy at step %s: %s' % (i, acc))
      if i % 100 == 0:
        print('Save checkpoint at step %s: %s' % (i, acc))
        saver.save(sess, FLAGS.log_dir + '/model.ckpt', global_step=i)
        # FLAGS.log_dir = os.path.join(os.getenv('TEST_TMPDIR', '/mnt'),'training_logs')
        for path,_,file_list in os.walk(FLAGS.log_dir) :
          for file_name in file_list:
            bucket.put_object_from_file(os.path.join('tf-train/training_logs', file_name), os.path.join(path, file_name))
A imagem modificada do contêiner é
registry.cn-beijing.aliyuncs.com/tool-sys/tf-train-demo:ro. -
Implante o pod com o PV somente leitura e as credenciais do SDK. O pod define
accessModescomoReadOnlyManye passaOSS_ACCESS_KEY_IDeOSS_ACCESS_KEY_SECRETpara que o SDK autentique com as mesmas credenciais do PV.cat << EOF | kubectl apply -f - apiVersion: v1 kind: Secret metadata: name: oss-secret namespace: default stringData: akId: "<your-accesskey-id>" akSecret: "<your-accesskey-secret>" --- apiVersion: v1 kind: PersistentVolume metadata: name: tf-train-pv labels: alicloud-pvname: tf-train-pv spec: capacity: storage: 10Gi accessModes: - ReadOnlyMany persistentVolumeReclaimPolicy: Retain csi: driver: ossplugin.csi.alibabacloud.com volumeHandle: tf-train-pv nodePublishSecretRef: name: oss-secret namespace: default volumeAttributes: bucket: "<your-bucket-name>" url: "oss-<region>.aliyuncs.com" otherOpts: "-o kernel_cache -o max_stat_cache_size=10000 -o umask=022 -o allow_other" path: "/tf-train/train/data" --- apiVersion: v1 kind: PersistentVolumeClaim metadata: name: tf-train-pvc spec: accessModes: - ReadOnlyMany resources: requests: storage: 10Gi selector: matchLabels: alicloud-pvname: tf-train-pv --- apiVersion: v1 kind: Pod metadata: labels: app: tfjob name: tf-mnist namespace: default spec: containers: - command: - sh - -c - python /app/main.py env: - name: NVIDIA_VISIBLE_DEVICES value: void - name: gpus value: "0" - name: workers value: "1" - name: TEST_TMPDIR value: "/mnt" - name: OSS_ACCESS_KEY_ID #The source of the AccessKey is the same as that of the PV. valueFrom: secretKeyRef: name: oss-secret key: akId - name: OSS_ACCESS_KEY_SECRET #The source of the AccessKey is the same as that of the PV. valueFrom: secretKeyRef: name: oss-secret key: akSecret - name: URL #You can ignore this if a default URL is configured. value: "https://oss-<region>.aliyuncs.com" - name: BUCKET #You can ignore this if a default BUCKET is configured. value: "<bucket-name>" image: registry.cn-beijing.aliyuncs.com/tool-sys/tf-train-demo:ro imagePullPolicy: Always name: tensorflow ports: - containerPort: 20000 name: tfjob-port protocol: TCP volumeMounts: - name: train mountPath: "/mnt/train/data" workingDir: /root priority: 0 restartPolicy: Never securityContext: {} terminationGracePeriodSeconds: 30 volumes: - name: train persistentVolumeClaim: claimName: tf-train-pvc EOF
Verificar a separação de leitura e gravação
Após implantar com qualquer uma das opções de gravação:
-
Verifique o status do pod:
kubectl get pod tf-mnistAguarde até que o status mude para
Completed:NAME READY STATUS RESTARTS AGE tf-mnist 0/1 Completed 0 2m25s -
Verifique o tempo de carregamento dos dados:
kubectl logs tf-mnist | grep dataloadCom a separação de leitura e gravação e o cache do kernel ativado, o tempo de carregamento diminui:
dataload cost time: 0.843528985977A linha de base sem separação é de aproximadamente 1,54 segundo. Jobs de treinamento maiores e carregamentos repetidos de dados apresentam melhorias ainda mais significativas.
-
Faça login no OSS Management Console e confirme que os arquivos de checkpoint estão presentes em
/tf-train/training_logsdentro do bucket.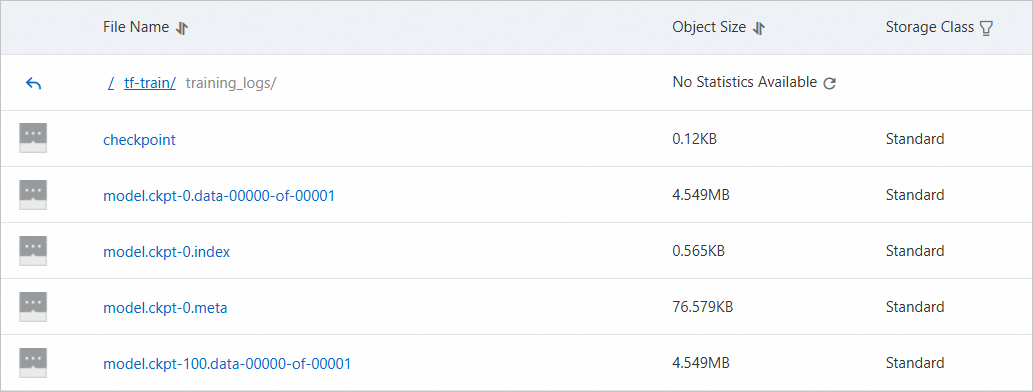
Referências
Referência do OSS SDK
Este tópico utiliza o Python SDK. Outros SDKs disponíveis:
Para outros SDKs (PHP, Node.js, Browser.js, .NET, Android, iOS, Ruby), consulte a Referência do SDK.
Outras ferramentas de gravação
As ferramentas abaixo também permitem gravar no OSS:
|
Ferramenta |
Referência |
|
OpenAPI |
|
|
Interface de linha de comando ossutil |
|
|
Ferramenta gráfica de gerenciamento ossbrowser |