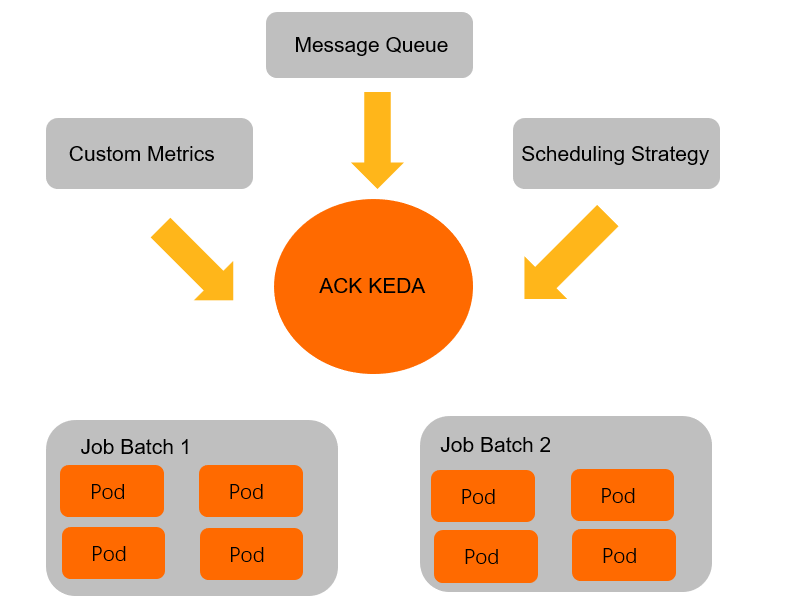
Em cargas de trabalho orientadas a eventos, como jobs offline e streaming de dados, o dimensionamento horizontal de pods baseado em CPU e memória pode ter resposta lenta. O ack-keda monitora filas de eventos de fontes como bancos de dados e message queues, cria réplicas de Jobs ou Deployments em segundos e reduz a escala para zero após a conclusão das tarefas. Isso garante agendamento eficiente em tempo real e otimização de custos.
Como funciona
O ack-keda é uma versão aprimorada do KEDA (Kubernetes-based Event-driven Autoscaling) integrada ao ACK. Ele introduz um Scaler que conecta as fontes de eventos às aplicações.

Monitoramento da fonte de eventos: O
Scalerse conecta a uma fonte externa de eventos — como o MongoDB — e consulta periodicamente uma métrica. Por exemplo, a quantidade de documentos que atendem a determinadas condições.-
Acionamento do dimensionamento da aplicação:
Quando o
Scalerdetecta acúmulo de eventos — como dados não processados —, o ack-keda dimensiona a carga de trabalho associada a umScaledJobouScaledObject. Para isso, cria um Job ou adiciona réplicas ao Deployment.Caso o
Scalernão identifique pendências, o ack-keda reduz a escala da carga de trabalho. Para Jobs, ele remove os recursos concluídos para evitar desperdício de capacidade e acúmulo de metadados.
Principais capacidades:
Amplo suporte a fontes de eventos: Compatível com origens de dados como Apache Kafka, MySQL, PostgreSQL, RabbitMQ e MongoDB. Consulte RabbitMQ Queue.
Controle flexível de concorrência: Use
maxReplicaCountpara limitar tarefas simultâneas e proteger sistemas downstream contra picos de tráfego.Limpeza automática de metadados: Após a finalização de uma tarefa, o
ScaledJobremove Jobs e pods concluídos. Essa ação reduz a pressão sobre o servidor de API causada pelo acúmulo de metadados.
ScaledJob vs. ScaledObject
Use ScaledJob quando cada evento corresponder a uma tarefa discreta e de longa duração executada até a conclusão em seu próprio pod. O ack-keda agenda um Job por evento: ele inicializa, processa o evento e encerra. Esse isolamento impede que tarefas lentas bloqueiem outras e permite controle preciso de concorrência via maxReplicaCount.
Prefira ScaledObject quando os eventos gerarem throughput contínuo e sua carga de trabalho for melhor atendida por um pool de réplicas de Deployment de longa duração.
O tutorial abaixo usa ScaledJob para transcodificação de vídeo. Quando um registro com "state":"waiting" é inserido no MongoDB, o ack-keda cria um Job para processar a tarefa e define o registro como "state":"finished" após a conclusão. Os Jobs finalizados são limpos automaticamente.
Pré-requisitos
Verifique os seguintes requisitos:
Um cluster ACK ativo e em execução
kubectlconfigurado para conexão ao clusterPermissões suficientes para criar namespaces e implantar charts Helm
Etapa 1: Implantar o ack-keda
Na página ACK Clusters, clique em nome do cluster. No painel de navegação à esquerda, escolha Applications > Helm.
Clique em Create. Localize e selecione ack-keda, escolha a versão mais recente do chart e conclua a instalação.
-
Verifique se o ack-keda está em execução:
kubectl get pods -n kedaTodos os pods devem estar com status
Runningantes de prosseguir.
Etapa 2: Implantar o exemplo de dimensionamento automático orientado a eventos com MongoDB
Criar namespaces de exemplo
Este exemplo usa o namespace mongodb para o banco de dados e mongodb-test para as configurações de dimensionamento automático.
kubectl create ns mongodb
kubectl create ns mongodb-test
Implantar o MongoDB
Se você já tem um serviço MongoDB, pule esta etapa.
-
Crie o arquivo
mongoDB.yaml.ImportanteEste serviço MongoDB destina-se apenas a demonstrações e não possui alta disponibilidade. Não o use em produção.
apiVersion: apps/v1 kind: Deployment metadata: name: mongodb namespace: mongodb spec: replicas: 1 selector: matchLabels: name: mongodb template: metadata: labels: name: mongodb spec: containers: - name: mongodb image: registry-cn-shanghai.ack.aliyuncs.com/acs/mongo:v5.0.0 imagePullPolicy: IfNotPresent ports: - containerPort: 27017 name: mongodb protocol: TCP --- kind: Service apiVersion: v1 metadata: name: mongodb-svc namespace: mongodb spec: type: ClusterIP ports: - name: mongodb port: 27017 targetPort: 27017 protocol: TCP selector: name: mongodb -
Implante o MongoDB.
kubectl apply -f mongoDB.yaml
Inicializar o banco de dados MongoDB
-
Obtenha o nome do pod do MongoDB.
MONGO_POD_NAME=$(kubectl get pods -n mongodb -l name=mongodb -o jsonpath='{.items[0].metadata.name}') echo "MongoDB pod name: $MONGO_POD_NAME" -
No banco de dados
test, crie o usuáriotest_usere a coleçãotest_collection.# Create user kubectl exec -n mongodb ${MONGO_POD_NAME} -- mongo --eval 'db.createUser({ user:"test_user",pwd:"test_password",roles:[{ role:"readWrite", db: "test"}]})' # Authenticate user kubectl exec -n mongodb ${MONGO_POD_NAME} -- mongo --eval 'db.auth("test_user","test_password")' # Create collection kubectl exec -n mongodb ${MONGO_POD_NAME} -- mongo test --eval 'db.createCollection("test_collection")'
Configurar TriggerAuthentication e ScaledJob
O ack-keda usa TriggerAuthentication para gerenciar credenciais de fontes de eventos com segurança. O ScaledJob define regras de dimensionamento, intervalos de verificação e o modelo de Job.
O arquivo a seguir combina três recursos: Secret, TriggerAuthentication e ScaledJob.
-
Crie o arquivo
keda-mongodb.yaml. O camposecretTargetRefemTriggerAuthenticationlê a string de conexão do Secret para autenticação no MongoDB. AquerynoScaledJobaciona a criação de Jobs quando documentos natest_collectioncorrespondem a{"type":"mp4","state":"waiting"}.apiVersion: v1 kind: Secret metadata: name: mongodb-secret namespace: mongodb-test type: Opaque data: # Base64-encoded value of: # mongodb://test_user:test_password@mongodb-svc.mongodb.svc.cluster.local:27017/test connect: bW9uZ29kYjovL3Rlc3RfdXNlcjp0ZXN0X3Bhc3N3b3JkQG1vbmdvZGItc3ZjLm1vbmdvZGIuc3ZjLmNsdXN0ZXIubG9jYWw6MjcwMTcvdGVzdA== --- apiVersion: keda.sh/v1alpha1 kind: TriggerAuthentication metadata: name: mongodb-trigger namespace: mongodb-test spec: secretTargetRef: - parameter: connectionString name: mongodb-secret key: connect --- apiVersion: keda.sh/v1alpha1 kind: ScaledJob metadata: name: mongodb-job namespace: mongodb-test spec: jobTargetRef: template: spec: containers: - name: mongo-update image: registry-cn-shanghai.ack.aliyuncs.com/acs/mongo-update:v6 args: - --dataBase=test - --collection=test_collection - --operation=updateMany - --update={"$set":{"state":"finished"}} env: - name: MONGODB_CONNECTION_STRING value: mongodb://test_user:test_password@mongodb-svc.mongodb.svc.cluster.local:27017/test imagePullPolicy: IfNotPresent restartPolicy: Never backoffLimit: 1 pollingInterval: 15 # Check MongoDB every 15 seconds maxReplicaCount: 5 # Run at most 5 concurrent Jobs successfulJobsHistoryLimit: 0 # Delete completed Jobs immediately failedJobsHistoryLimit: 10 # Keep the last 10 failed Jobs for debugging triggers: - type: mongodb metadata: dbName: test collection: test_collection query: '{"type":"mp4","state":"waiting"}' # Launch a Job for each matching document queryValue: "1" authenticationRef: name: mongodb-trigger -
Implante a configuração.
kubectl apply -f keda-mongodb.yaml
Etapa 3: Simular eventos e verificar o dimensionamento automático
-
Insira cinco registros de transcodificação pendentes no MongoDB.
MONGO_POD_NAME=$(kubectl get pods -n mongodb -l name=mongodb -o jsonpath='{.items[0].metadata.name}') # Insert 5 pending transcoding records kubectl exec -n mongodb ${MONGO_POD_NAME} -- mongo test --eval 'db.test_collection.insert([ {"type":"mp4","state":"waiting","createTimeStamp":"1610352740","fileName":"My Love"}, {"type":"mp4","state":"waiting","createTimeStamp":"1610350740","fileName":"Harker"}, {"type":"mp4","state":"waiting","createTimeStamp":"1610152940","fileName":"The World"}, {"type":"mp4","state":"waiting","createTimeStamp":"1610390740","fileName":"Mother"}, {"type":"mp4","state":"waiting","createTimeStamp":"1610344740","fileName":"Jagger"} ])' -
Monitore os recursos de Job no namespace
mongodb-test.watch kubectl get job -n mongodb-testEm um intervalo de verificação (15 segundos), cinco Jobs são criados e removidos após a conclusão:
NAME STATUS COMPLETIONS DURATION AGE mongodb-job-4wxgx Complete 1/1 3s 10s mongodb-job-9bs8r Complete 1/1 3s 10s mongodb-job-p6pnb Complete 1/1 3s 10s mongodb-job-pshkv Complete 1/1 4s 10s mongodb-job-t6fs8 Complete 1/1 4s 10s -
Confirme se todos os registros estão marcados como concluídos.
MONGO_POD_NAME=$(kubectl get pods -n mongodb -l name=mongodb -o jsonpath='{.items[0].metadata.name}')
kubectl exec -n mongodb ${MONGO_POD_NAME} -- mongo test --eval 'db.test_collection.find({"type":"mp4"}).pretty()'
Todos os registros mudam de
waitingparafinished. Isso confirma que cada Job processou sua respectiva tarefa.